近 7 天 Harness RSI 论文速览与 Exo 深度解析:把自我改进折叠进运行时,借鉴 Exokernel 重构 Agent Harness
盘点 2026 年 10 月 28 日至 11 月 4 日新公开的 10 篇 Harness RSI 论文,并深度拆解其中最具影响力的 UC Berkeley(Ion Stoica、Sylvia Ratnasamy)、a16z(Martin Casado)与 Braintrust(Ankur Goyal)联合工作 Exo(arXiv:2611.00463)及其开源实现。
在上一篇 Harness RSI 演进全景综述中,我们梳理了截至 2026 年 10 月下旬的 49 项代表性工作。而在刚刚过去的 7 天(2026 年 10 月 28 日至 11 月 4 日)里,arXiv 上又密集公开了十余篇围绕 Agent Harness 递归自我改进(Harness RSI) 的新论文,议题迅速从“离线刷榜”推向了运行时在线自修改、预计算元技能、跨任务持续演化的灾难性遗忘、兄弟 Harness 协同强化学习,以及安全护栏隐式退化。
在这些新工作中,最具代表性、在学术界与开源社区关注度最高的是由 UC Berkeley(Alexander Krentsel、Sylvia Ratnasamy、Ion Stoica)、Andreessen Horowitz / a16z(Martin Casado) 与 Braintrust(Ankur Goyal) 联合发布的 Exo: A Harness Architecture for Runtime Self-Improvement(arXiv:2611.00463,开源仓库 exoharness/exo 上线数日已获 1.6k+ Stars)。
大多数既有 Harness RSI 方法(如 Meta-Harness、DGM、GEPA、ModularRSI)都把优化器放在任务执行之外:先准备一套代表性 Benchmark,让候选 Harness 跑完几百道题,再根据得分回头改代码。Exo 针对这套离线范式在真实生产中的三项局限——75% 的受访生产团队没有评测集、长周期任务单次运行动辄数小时乃至数周、固定 Harness 无法在任务中途修正刚暴露的低效行为——借鉴操作系统中的 Exokernel(外核) 思想,把优化循环折叠进正在运行的任务中,通过“最小受保护机制层(Mechanism)+ 可自编辑策略层(Policy)”支持 Agent 在运行时边执行任务边修改自身的 Harness 代码。
下文先盘点近 7 天新公开的 10 篇 Harness RSI 代表作,随后结合论文全部图表与 exoharness/exo 的 Rust / TypeScript 源码,完整拆解 Exo 的控制论模型、安全契约、实验数据及面向 GUI Agent / 移动端自动化测试(Mobile QA)的落地启示。
目录
- 近 7 天(2026.10.28—11.04)Harness RSI 论文速览与选篇理由
- 背景与问题定义:为什么离线 Benchmark 驱动的 Harness 演化在生产环境失灵
- 核心思路:将外部优化循环折叠进运行时(Collapsing the Optimization Loop)
- 系统架构与安全契约:借鉴 Exokernel 的策略—机制分离
- 开源实现拆解:
exoharness/exo如何在 TypeScript 与 Rust 中落地自修改 - 实验结果全解析:从开放世界长周期博弈到软件工程基准
- 对 GUI Agent 与 APP 自动化测试 / Mobile QA 的启发
- 局限性与专家点评
- 总结
- 参考链接
1. 近 7 天(2026.10.28—11.04)Harness RSI 论文速览与选篇理由
检索 2026 年 10 月 28 日至 11 月 4 日期间首次提交到 arXiv 的 Agent Harness 与递归自我改进论文,可以筛出 10 篇紧扣 Harness 演化机制的代表性工作(按提交时间倒序排列):
| 提交日期 | 论文简称与链接 | 作者团队 / 机构 | 关注问题与核心机制 |
|---|---|---|---|
| 2026-11-03 | Meta² | UMD (Furong Huang 等)、UW、UIUC、Scale AI | 离线预计算元技能 + 在线任务内自修改:离线通过对比三组轨迹学习何时该改、何时不改的文本化 Meta-Skill ;在线每 步决定 KEEP 或 EVOLVE,且修改仅限当前任务内生效,在 Terminal-Bench 2.1 达 81.00%。 |
| 2026-11-03 | Harness-S | 上海交大 (Weinan Zhang 等)、小红书、CMU | 兄弟 Harness 救援与策略内化:指出 Harness 演化存在局部性、互补性与非平稳性;沿不同修复方向演化出 Sibling Harness Pool,在基础 Harness 全败时采样救援轨迹做 RL,把脚手架能力内化回单一模型策略。 |
| 2026-11-03 | DualEvolve | 推荐系统自演化团队 | 机制与编排双层共演化:内层修改推荐模型与训练代码,外层对实验过程本身打分并更新 Harness 与 Skill 规则。 |
| 2026-11-03 | Artifact-to-Capability | 受控环境诊断团队 | 能力形成断裂诊断:证明“产物变多、行为改变、指标上升”三项代理信号不足以说明真正形成了能力,在五子棋受控环境中揭示了 Reflexion、Voyager 与 DGM 的三类退化模式。 |
| 2026-11-02 | Continual Harness Forgetting | 清华 / 北大 (THU-Agent) | 持续演化中的灾难性遗忘实证:揭示现有方法在多任务顺序演化时存在严重遗忘——例如 Meta-Harness 在 SWE-Bench 上演化到 94.0% 后,继续在 FeatureBench 上演化 5 轮,原 SWE-Bench 准确率暴跌至 32.0%(相对下降 66%)。 |
| 2026-11-02 | EvoGroup | 中山大学 (Zibin Zheng 等) | 面向多人共享上下文的群组 Harness 演化:从 6 个基础工具冷启动出发,基于置信度与结果筛选轨迹,通过渐进披露分析更新群组记忆 Harness。 |
| 2026-11-01 | ParetoSaddler | Microsoft (Victor Rühle、Qingwei Lin、Chetan Bansal 等) | 质量—成本帕累托引导优化:将中间候选晋升与最终部署偏好解耦,用 Bayesian Bootstrap 帕累托支持度保留有潜力的中间分支,在 ClawMark 与 GAIA2 上同时提分并降本。 |
| 2026-11-01 | RSI-Env | 复旦大学 (Yanwei Fu 等)、上海 AI Lab | 模型—Harness 协同演化的开放环境:通过独立的 Host Controller 管理服务、评测与版本,让每一代被接受的模型+Harness 接管下一轮自改进。 |
| 2026-11-01 | Latent Harness | HKUST (Lei Chen 等) | 将外部 Harness 编译为激活偏移:把提示词契约或流程规范蒸馏进冻结骨干每层 Decoder 后的秩-8 激活偏移(仅占 0.03%–0.05% 参数),推理时零额外 Token 开销。 |
| 2026-10-30 | Exo | UC Berkeley (Ion Stoica、Sylvia Ratnasamy)、a16z (Martin Casado)、Braintrust (Ankur Goyal) | 运行时自改进系统架构:将外部优化循环折叠进正在执行的任务中;借鉴 Exokernel 划分可编辑策略层与受保护机制核(追加式历史、独立 Guardian 热替换、分层回滚),在开放世界游戏、AppWorld、SREGym 与 CLB 上最高砍掉 61%–82% 模型成本。 |
| 2026-10-28 | Masked Erosion | 安全准入研究团队 | 准入门禁下的冗余安全护栏侵蚀:通过 411 轮演化实验证明,当多道安全规则重叠时,删掉其中一道不会立即在当前强模型下触发违规,导致准入门禁因追求更低成本而悄悄删光冗余护栏,换用弱模型时即爆发凭证滥用。 |
为什么在近 7 天的这批论文里,Exo(arXiv:2611.00463) 最值得单拎出来精读?原因有三点:
- 作者团队的系统学底蕴与工业界号召力:Ion Stoica(UC Berkeley Sky Lab 主任,Spark、Ray、vLLM、Chatbot Arena 核心推手,Databricks 与 Anyscale 联合创始人)、Sylvia Ratnasamy(UC Berkeley 教授,现代网络系统奠基人之一)、Martin Casado(a16z 合伙人,SDN 与 OpenFlow 先驱)与 Ankur Goyal(Braintrust 创始人兼 CEO)联手,把原本偏算法刷榜的 Harness RSI 重新定义成了一个经典的计算机系统架构问题。
- 切中了离线 Harness 优化的致命软肋:它不再假设“先有一个现成的训练 Benchmark 和标准评分器”,而是直接回答:当 Agent 正在线上处理一个没见过的新故障或长达数小时的开放任务时,怎样在保证系统不自毁的前提下,当场改写自己的工具和上下文策略,并在同一个任务里把改代码的成本赚回来?
- 完整的工业级开源代码支撑:论文配套开源了约 20,000 行 Rust + TypeScript 核心运行时代码(
exoharness/exo),并在生产环境中承载了上万个任务与约 500 万条消息,直接与 OpenAI 的 Codex CLI 和开源标杆 Pi 做了同台真机对比。
2. 背景与问题定义:为什么离线 Benchmark 驱动的 Harness 演化在生产环境失灵
在 Exo 的定义中,Agent Harness 是包裹在语言模型外围的脚手架,负责两件事:组装模型的输入上下文(Context Assembly),以及在环境沙箱中执行动作并收集观察结果。所有控制模型如何使用状态、工具和环境的规则——包括工具实现与筛选、提示词、上下文拼装与压缩(Compaction)、记忆与技能检索、外部服务适配器,乃至决定何时以及如何发起自我改进的策略——统称为 Harness Policy(策略)。
过去一年里,以 Meta-Harness、GEPA、AlphaEvolve、SkyDiscover 为代表的自动优化工具,普遍采用“外部优化循环(External Optimization Loop)”:优化器在外部生成候选 Harness,放到评测集上跑完一批任务,根据得分修改下一版。Exo 指出,这套模式在走向真实生产环境时会撞上三道坎:
- 代表性评测集极难获取与维护:新业务领域往往拿不出覆盖度足够的 Benchmark 和高保真仿真环境。作者引用针对生产环境 Agent 团队的调研数据指出,高达 75% 的受访团队在没有标准 Benchmark 集的情况下评估自己的 Agent。即便费力建好了评测集,一旦外部服务接口或需求变动,离线搜出来的策略就会过时。
- 任务周期越长,完整重跑评估越贵:前沿 Agent 的单任务周期正在从几分钟拉长到几小时甚至几周(例如长周期软件构建或自动定理证明)。如果每次测试一个候选 Harness 都必须从头跑完整个任务,不仅算力账单难以承受,反馈也会严重滞后——哪怕 Agent 在前 10 分钟就已经暴露出某个明显低效的日志读取动作,外部优化器也必须等数小时任务跑完才能介入。
- 固定策略无法响应运行中暴露的新模式:哪怕线下优化得再好,一旦上线后固定不变,当 Agent 在执行过程中发现“每次诊断都要重复调 4 个命令查同一批 Pod 状态”或“某类诊断输出占满了上下文却毫无用处”时,它只能记一条被动笔记,却无法修改底层上下文拼装逻辑与工具集,同样的低效会在剩余几小时里反复重演。
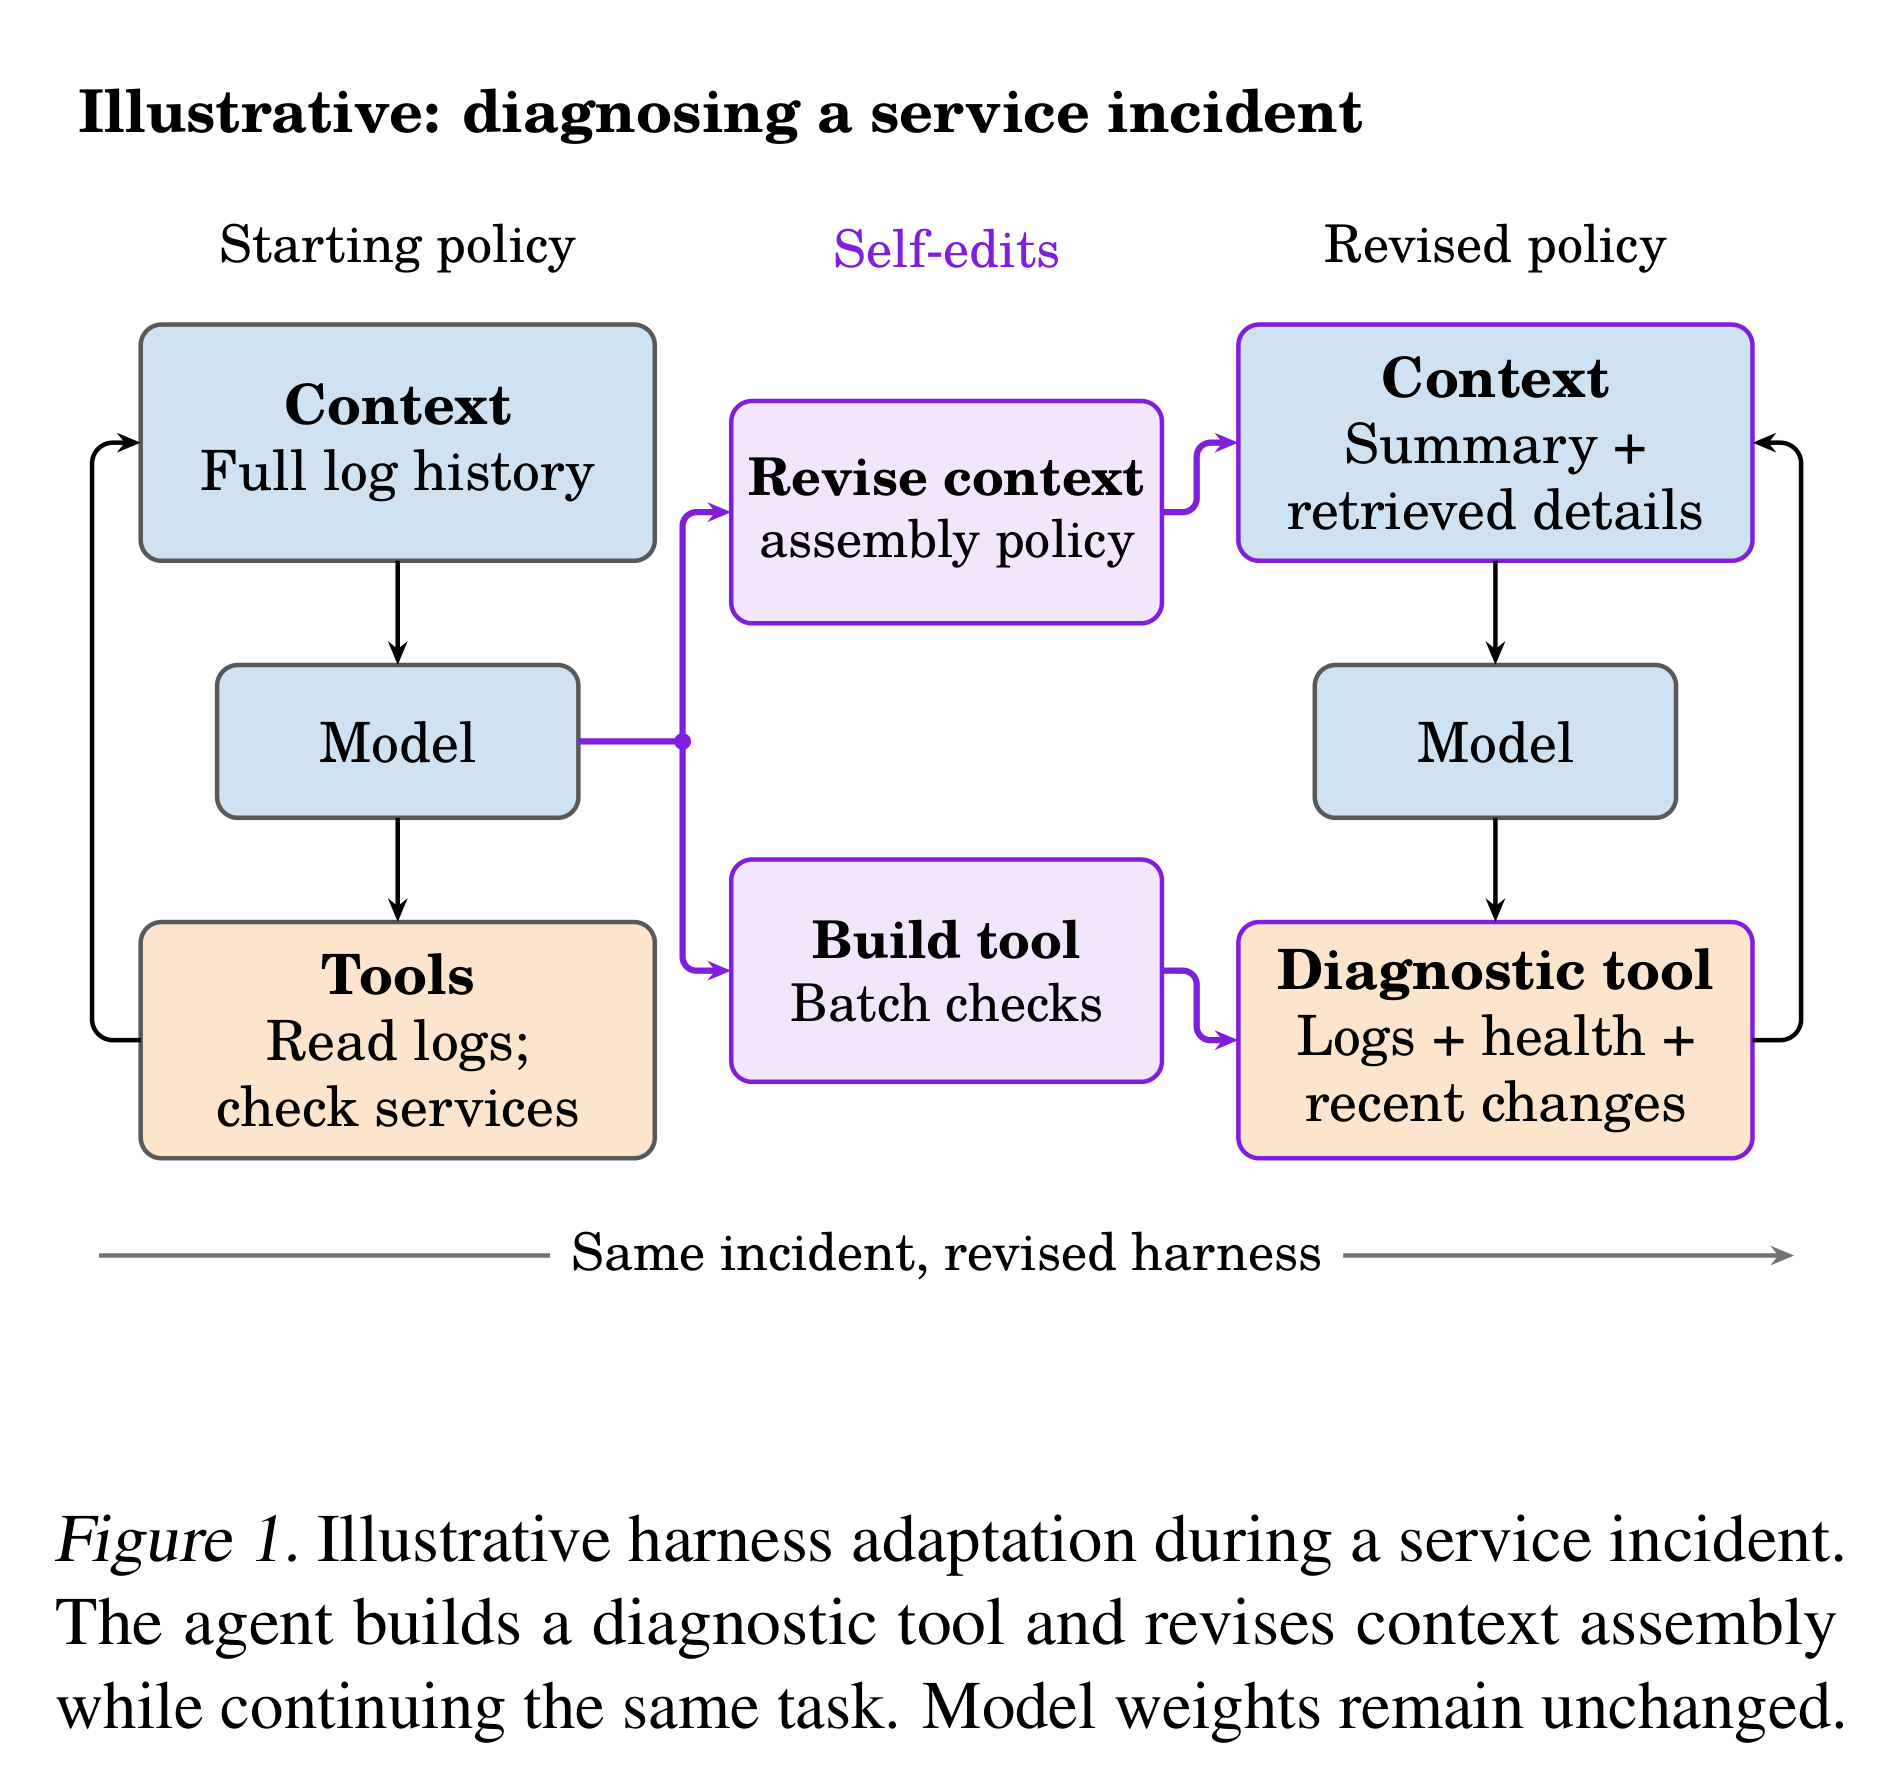
arXiv:2611.00463 Fig. 1)。模型权重保持不变,Agent 在处理同一场故障的过程中,一边将原本塞入全量日志历史的上下文策略改写为“摘要 + 按需检索明细”,一边现场编写批量检查工具(整合日志、健康状态与近期变更),随后用更新后的 Harness 继续完成当前故障排查。图 1 给出了 Exo 的直观工作方式:在排查一次线上服务故障时,初始策略(Starting policy)每次把完整日志历史塞进上下文,且只能逐条调命令读日志、查服务。Agent 在排查中途意识到这样既费 Token 又慢,于是直接发起两次自编辑(Self-edits):一是修改上下文拼装代码,改为只放摘要加按需检索;二是写一个组合诊断工具,一次调用批量拉取日志、健康检查与近期变更。修改完成后,Agent 不需要重启任务,直接用新版策略把同一场故障排查完。
3. 核心思路:将外部优化循环折叠进运行时(Collapsing the Optimization Loop)
如果用控制论(Control Theory)里的自适应控制模型来看待 Harness 演化,传统外部优化与 Exo 的区别可以用图 2 清楚对比。
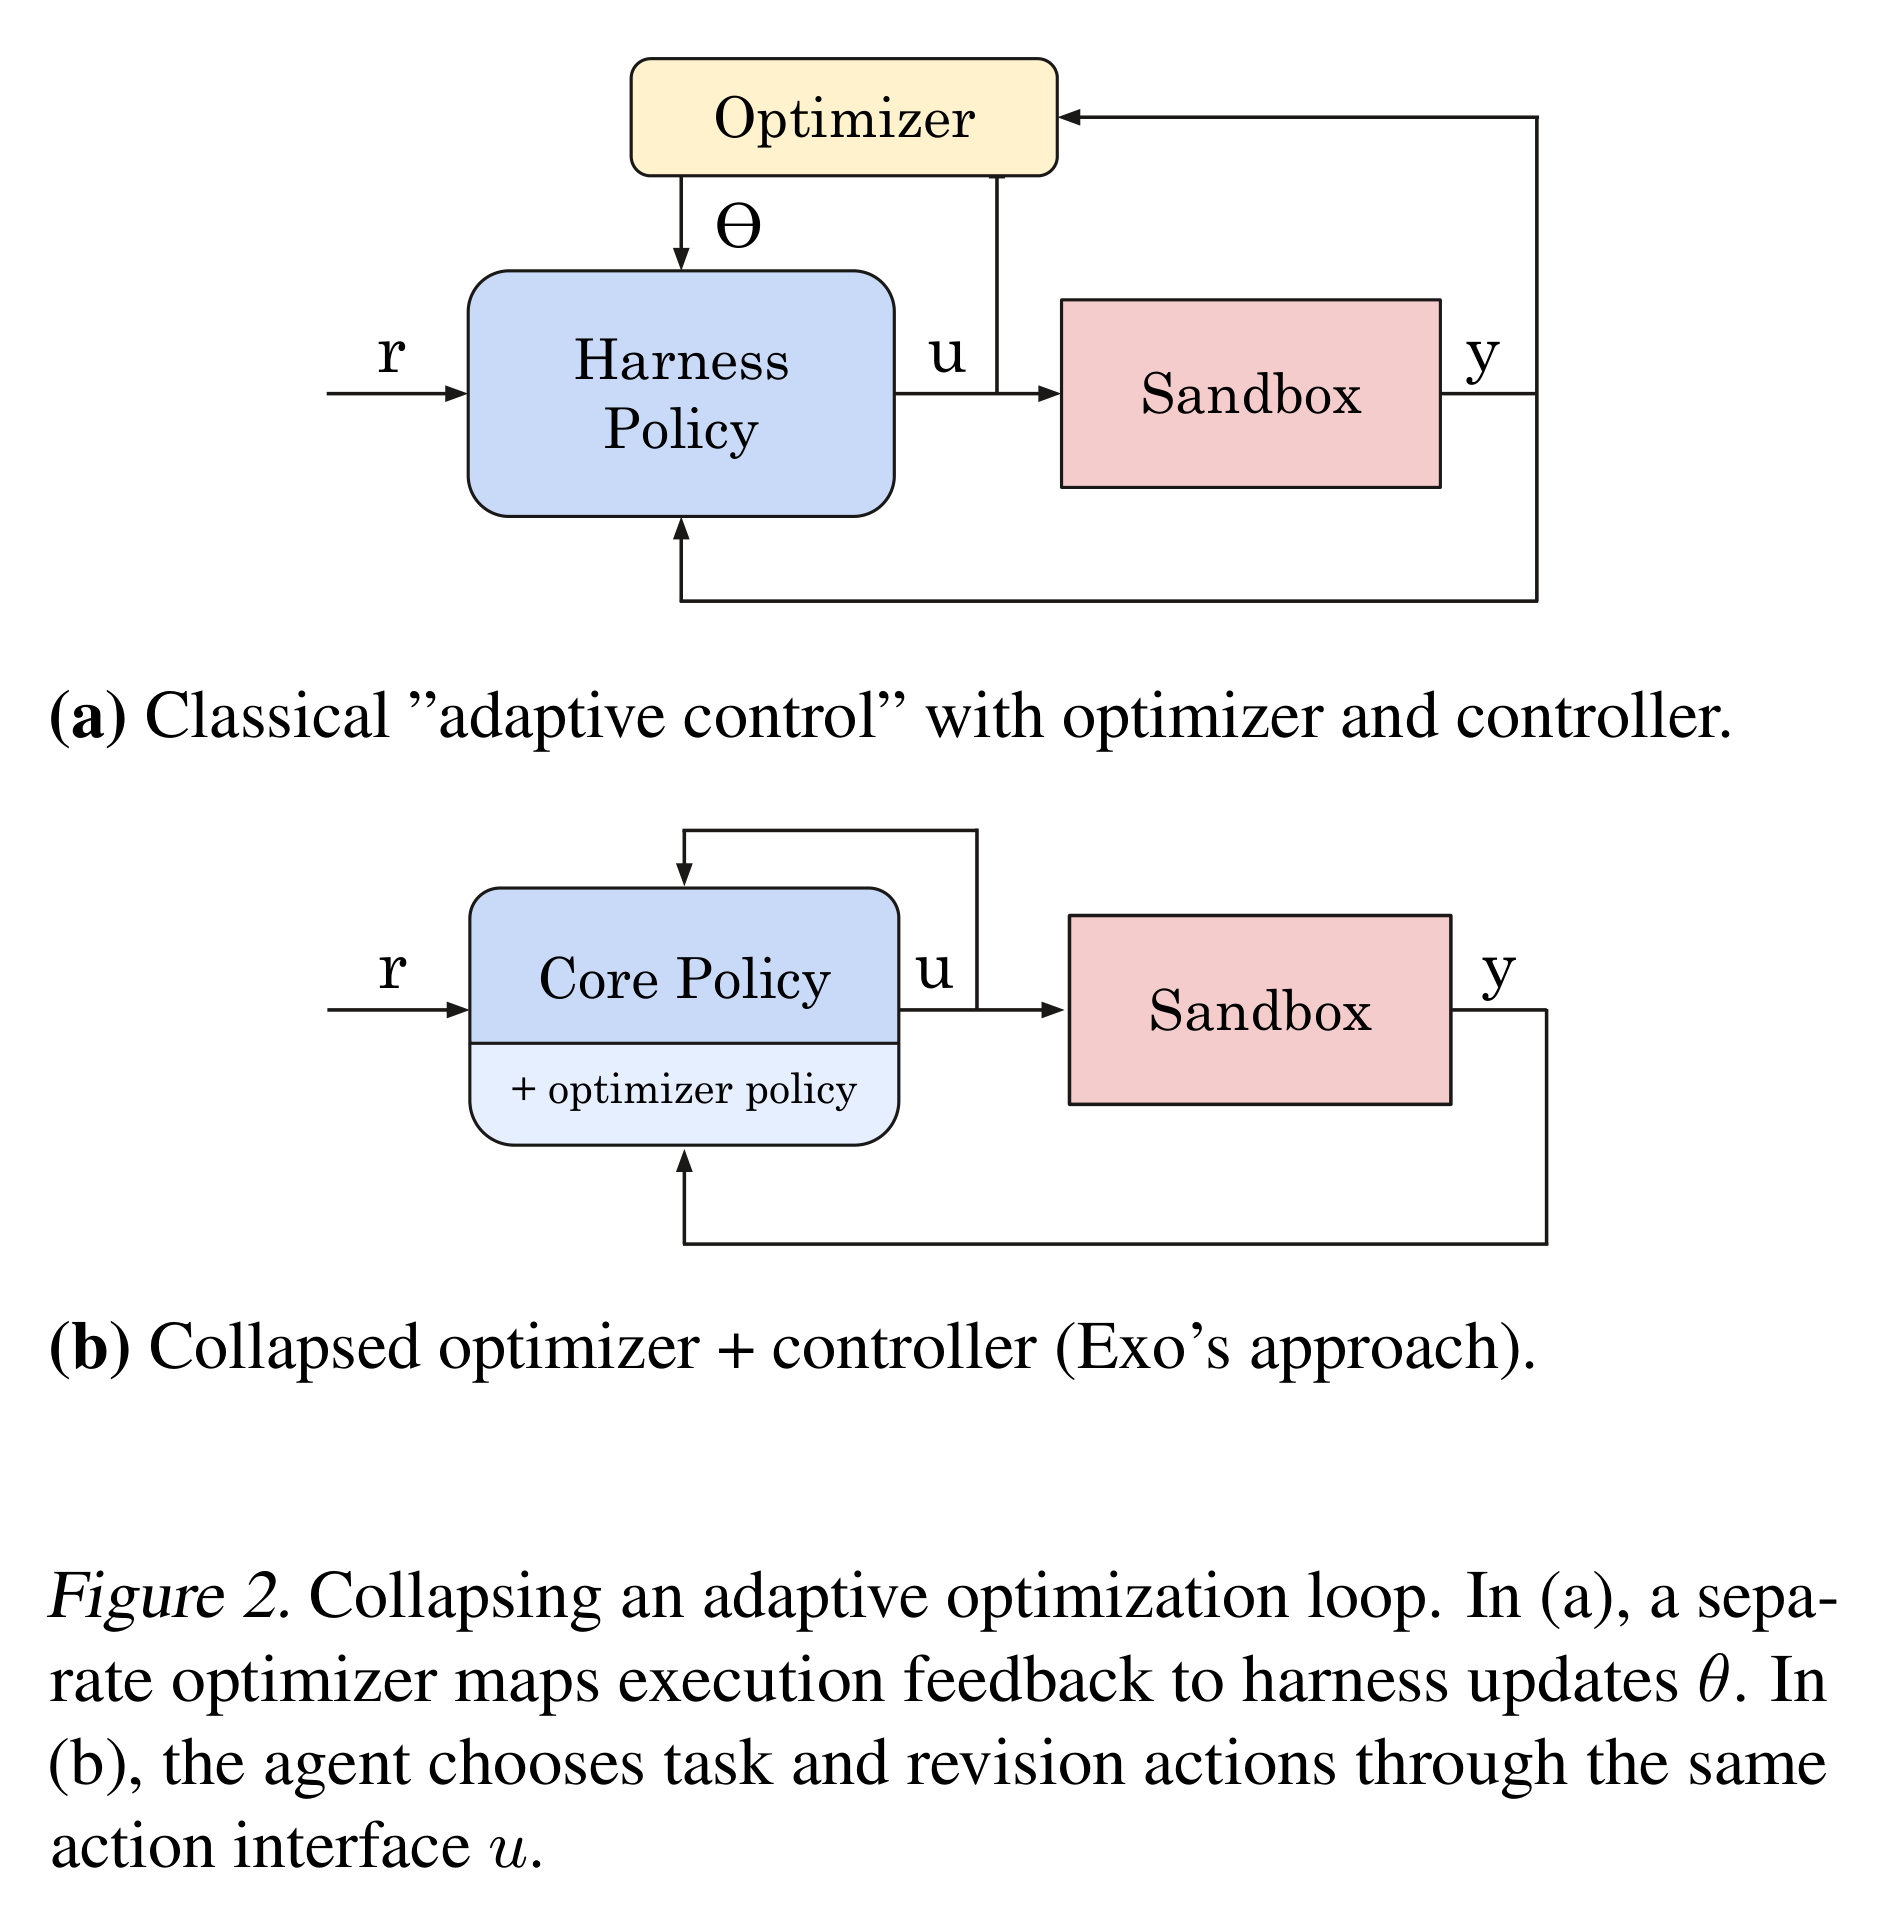
arXiv:2611.00463 Fig. 2)。(a) 传统方案中,独立的外部优化器观察沙箱执行反馈并下发参数更新 ;(b) Exo 将优化器策略并入核心策略,Agent 通过同一套动作接口 同时选择业务动作与修改自身 Harness 的动作。在图 2(a) 的经典自适应控制结构中,控制器(Harness Policy)接收任务目标 与环境观测 ,向沙箱输出业务动作 (工具调用);外部优化器(Optimizer)旁路观察交互过程,计算出策略更新 写回控制器。
Exo 提出,Agent Harness 具备两个独特的系统性质,使得外部优化器可以被直接折叠进核心策略内部,形成图 2(b) 的单循环结构:
- 优化器对称性(Optimizer Symmetry):对 Harness 的修改动作 ,完全可以通过与普通业务动作相同的动作空间 来完成。也就是说,Agent 平时用来干活的工具(查看源码、编辑文件、跑测试、请求激活),恰好就是修改自身 Harness 所需的全部工具。因此,“改自己的代码”和“执行一步业务操作”在决策层变成了并列的可选动作。
- 操作同像性(Operational Homoiconicity):借用编程语言里“代码即数据(Code as Data)”的同像性概念,Harness 的策略本身就是存放在文件系统里的源码文件,Agent 可以直接用自己的文件读写工具去观察和修改它。被优化的对象在优化器眼里就是沙箱里的普通数据文件。
当这两个性质同时成立时,不仅任务执行策略可以在运行时修改,决定“什么时候发起自改、根据什么指标自改”的优化策略(Optimizer Policy)本身也成了可编辑代码的一部分。每一代更新后的 Executor 都在继承任务进度的同时,保留并演化了继续改进自己的能力。
4. 系统架构与安全契约:借鉴 Exokernel 的策略—机制分离
把自编辑放进正在运行的系统里,立刻会引爆两个致命的系统工程问题:
- 命运共享(Fate-Sharing):当优化器逻辑和正在跑任务的逻辑住在同一个可编辑进程里时,一次写坏的代码修改(比如语法错误、死循环或把工具注册表改崩)会同时弄死业务 Agent 和它用来诊断、修复自己的逻辑——Agent 一旦无法执行,就永远失去了自救能力。
- 历史擦除(History Erasure):如果自编辑操作可以随便读写未受保护的运行时状态,一次错误修改就可能把之前积累的执行历史、记忆、中间产物甚至“刚才哪次自改失败了”的记录一并抹掉,导致进度清零、经验丢失。
4.1 形式化状态转移、存储契约与替换契约
为了在开放运行时自编辑的同时隔离上述两类风险,Exo 形式化定义了运行时状态与两项系统契约。
设第 步的运行时系统状态为 ,受保护的底层机制为 ,当前可替换的策略执行器(Executor)为 。当执行器选择动作 时,状态转移满足:
其中:
- 是持久数据(Durable Data),包含完整执行历史、记忆与版本化产物(Artifacts);
- 是环境沙箱状态(Sandbox Environment),包含沙箱文件、依赖包与运行进程;
- 是当前激活的策略执行器实现与配置。
为了保证 的代码修改不会破坏系统状态,机制层 强制执行两项契约(且 的实现位于 的编辑权限之外):
- 存储契约(Storage Contract)——历史只追加、版本可恢复:记 为规范执行历史(包含所有对话消息、工具调用与返回结果、以及策略替换事件)。存储契约要求对任意步 满足前缀关系(Prefix Relation):
已有记录不能被覆盖或删除;记忆与任务产物允许更新当前值,但必须保留历史版本以供恢复。论文附录 A 通过对状态转移的数学归纳法证明:只要初始状态满足契约且所有状态变更完全由 仲裁(Complete Mediation),在任意有限步操作与执行器替换之后,存储契约始终成立。
- 替换契约(Replacement Contract)——独立守卫者仲裁激活:执行器修改源码后会产生一个任意候选策略 (可能存在编译错误或运行时崩溃)。因此,将 提升为当前激活策略不能由策略层自己决定,而必须经过策略层之外的独立检查机制——守卫者函数(Guardian) :
当替换获批时,持久状态 与沙箱环境 原地保留,替换事件被追加写入 ;若 (例如构建失败),系统继续运行原策略 ,同时把替换请求与结果记入历史,供 Agent 后续排查。
4.2 借鉴 Exokernel 的双层划分与三大核心机制
在架构设计上,Exo 借鉴了操作系统领域的 Exokernel(外核) 架构(Engler et al., SOSP 1995):将保障安全所需的最小机制集合隔离在受保护层(类比 OS 内核态),并以尽可能低的抽象层级暴露原语接口,把策略逻辑留在上层可编辑空间中(类比用户态 Library OS)。
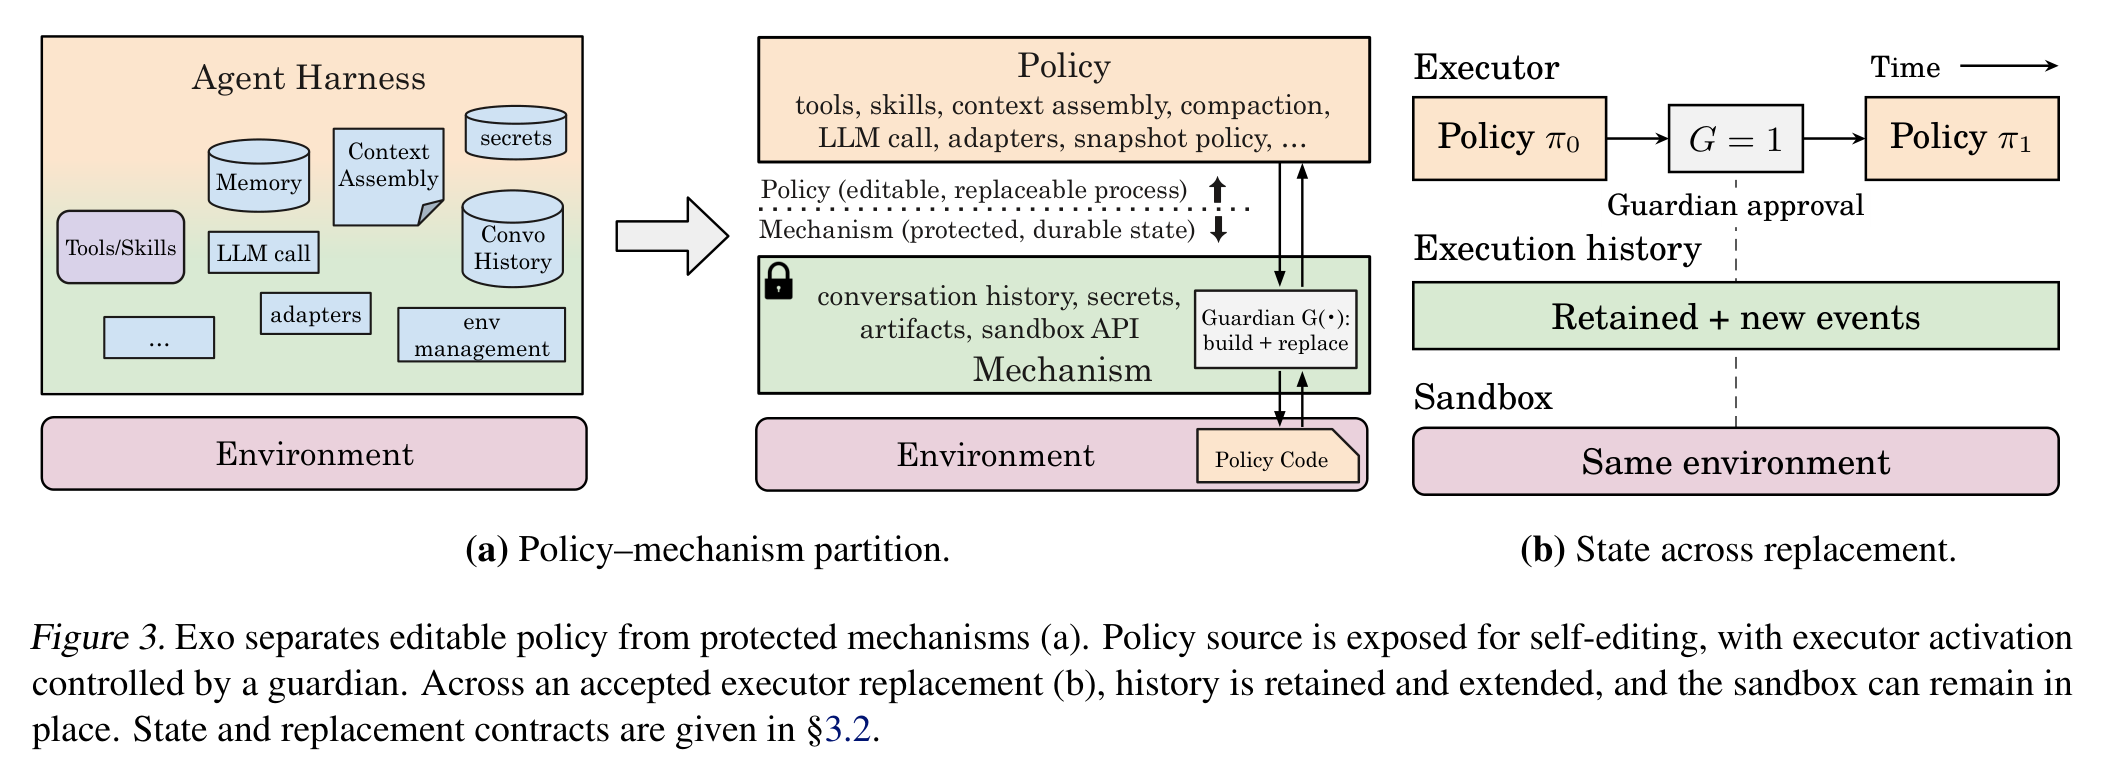
arXiv:2611.00463 Fig. 3)。(a) 将传统混杂的 Agent Harness 切分为上方的可编辑策略层(Policy,含工具、技能、上下文组装、压缩、模型调用、快照策略)与下方的受保护机制层(Mechanism,含只追加会话历史、密钥保险箱、版本化产物、沙箱 API 与独立 Guardian);(b) 当候选策略通过 Guardian 检查()并从 切换到 时,执行历史完整延续,沙箱环境保持原位。对照图 3,Exo 在机制层提供了三项关键支撑:
- 两步开启运行时自编辑:第一,把当前 Executor 的源码目录直接挂载到任务沙箱中,让 Agent 用日常读写代码的工具就能检查和修改自身实现;第二,暴露一个专用的替换请求工具,触发独立于 Executor 运行的 Guardian 完成编译校验与热切换。
- 三路独立回滚(Independent Rollback):因为执行器策略 、持久数据 和沙箱环境 被彻底解耦,它们可以各自独立回滚——Executor 回滚只需检出早期代码版本并重新通过 Guardian 激活;持久数据支持从早期事件节点分叉(Fork)或恢复旧版 Artifact;沙箱环境则通过独立的快照与恢复接口回退。最关键的是,即使回滚了代码或沙箱,只追加历史 依然保留着刚才那次失败尝试的全部记录,防止 Agent 失忆后重蹈覆辙。
- 内部可读性(Internal Legibility):Agent 要想在任务中途判断“我刚才改的上下文策略到底省没省钱、有没有破坏 KV Cache 命中率”,光看业务输出是不够的。Exo 在只追加历史里为每一条模型调用事件打上了精细的资源账单标注——包括 输入/输出 Token 数、缓存命中 Token 占比(Cached Input Share)、单步美元开销以及重复工具调用统计。哪怕早期对话已经被上下文压缩策略移出了当前 Prompt,Agent 依然可以通过查询工具随时调阅这些历史开销数据,形成密集的运行时自改进反馈信号。
5. 开源实现拆解:exoharness/exo 如何在 TypeScript 与 Rust 中落地自修改
为了看清第 4 节的形式化契约在工程上究竟怎么跑起来,我们直接检视 exoharness/exo 开源仓库(核心运行时约 20,000 行 Rust 与 TypeScript 代码,初始基础策略约 1,000 行代码)。图 4 梳理了源码中策略层与机制核的完整交互闭环:
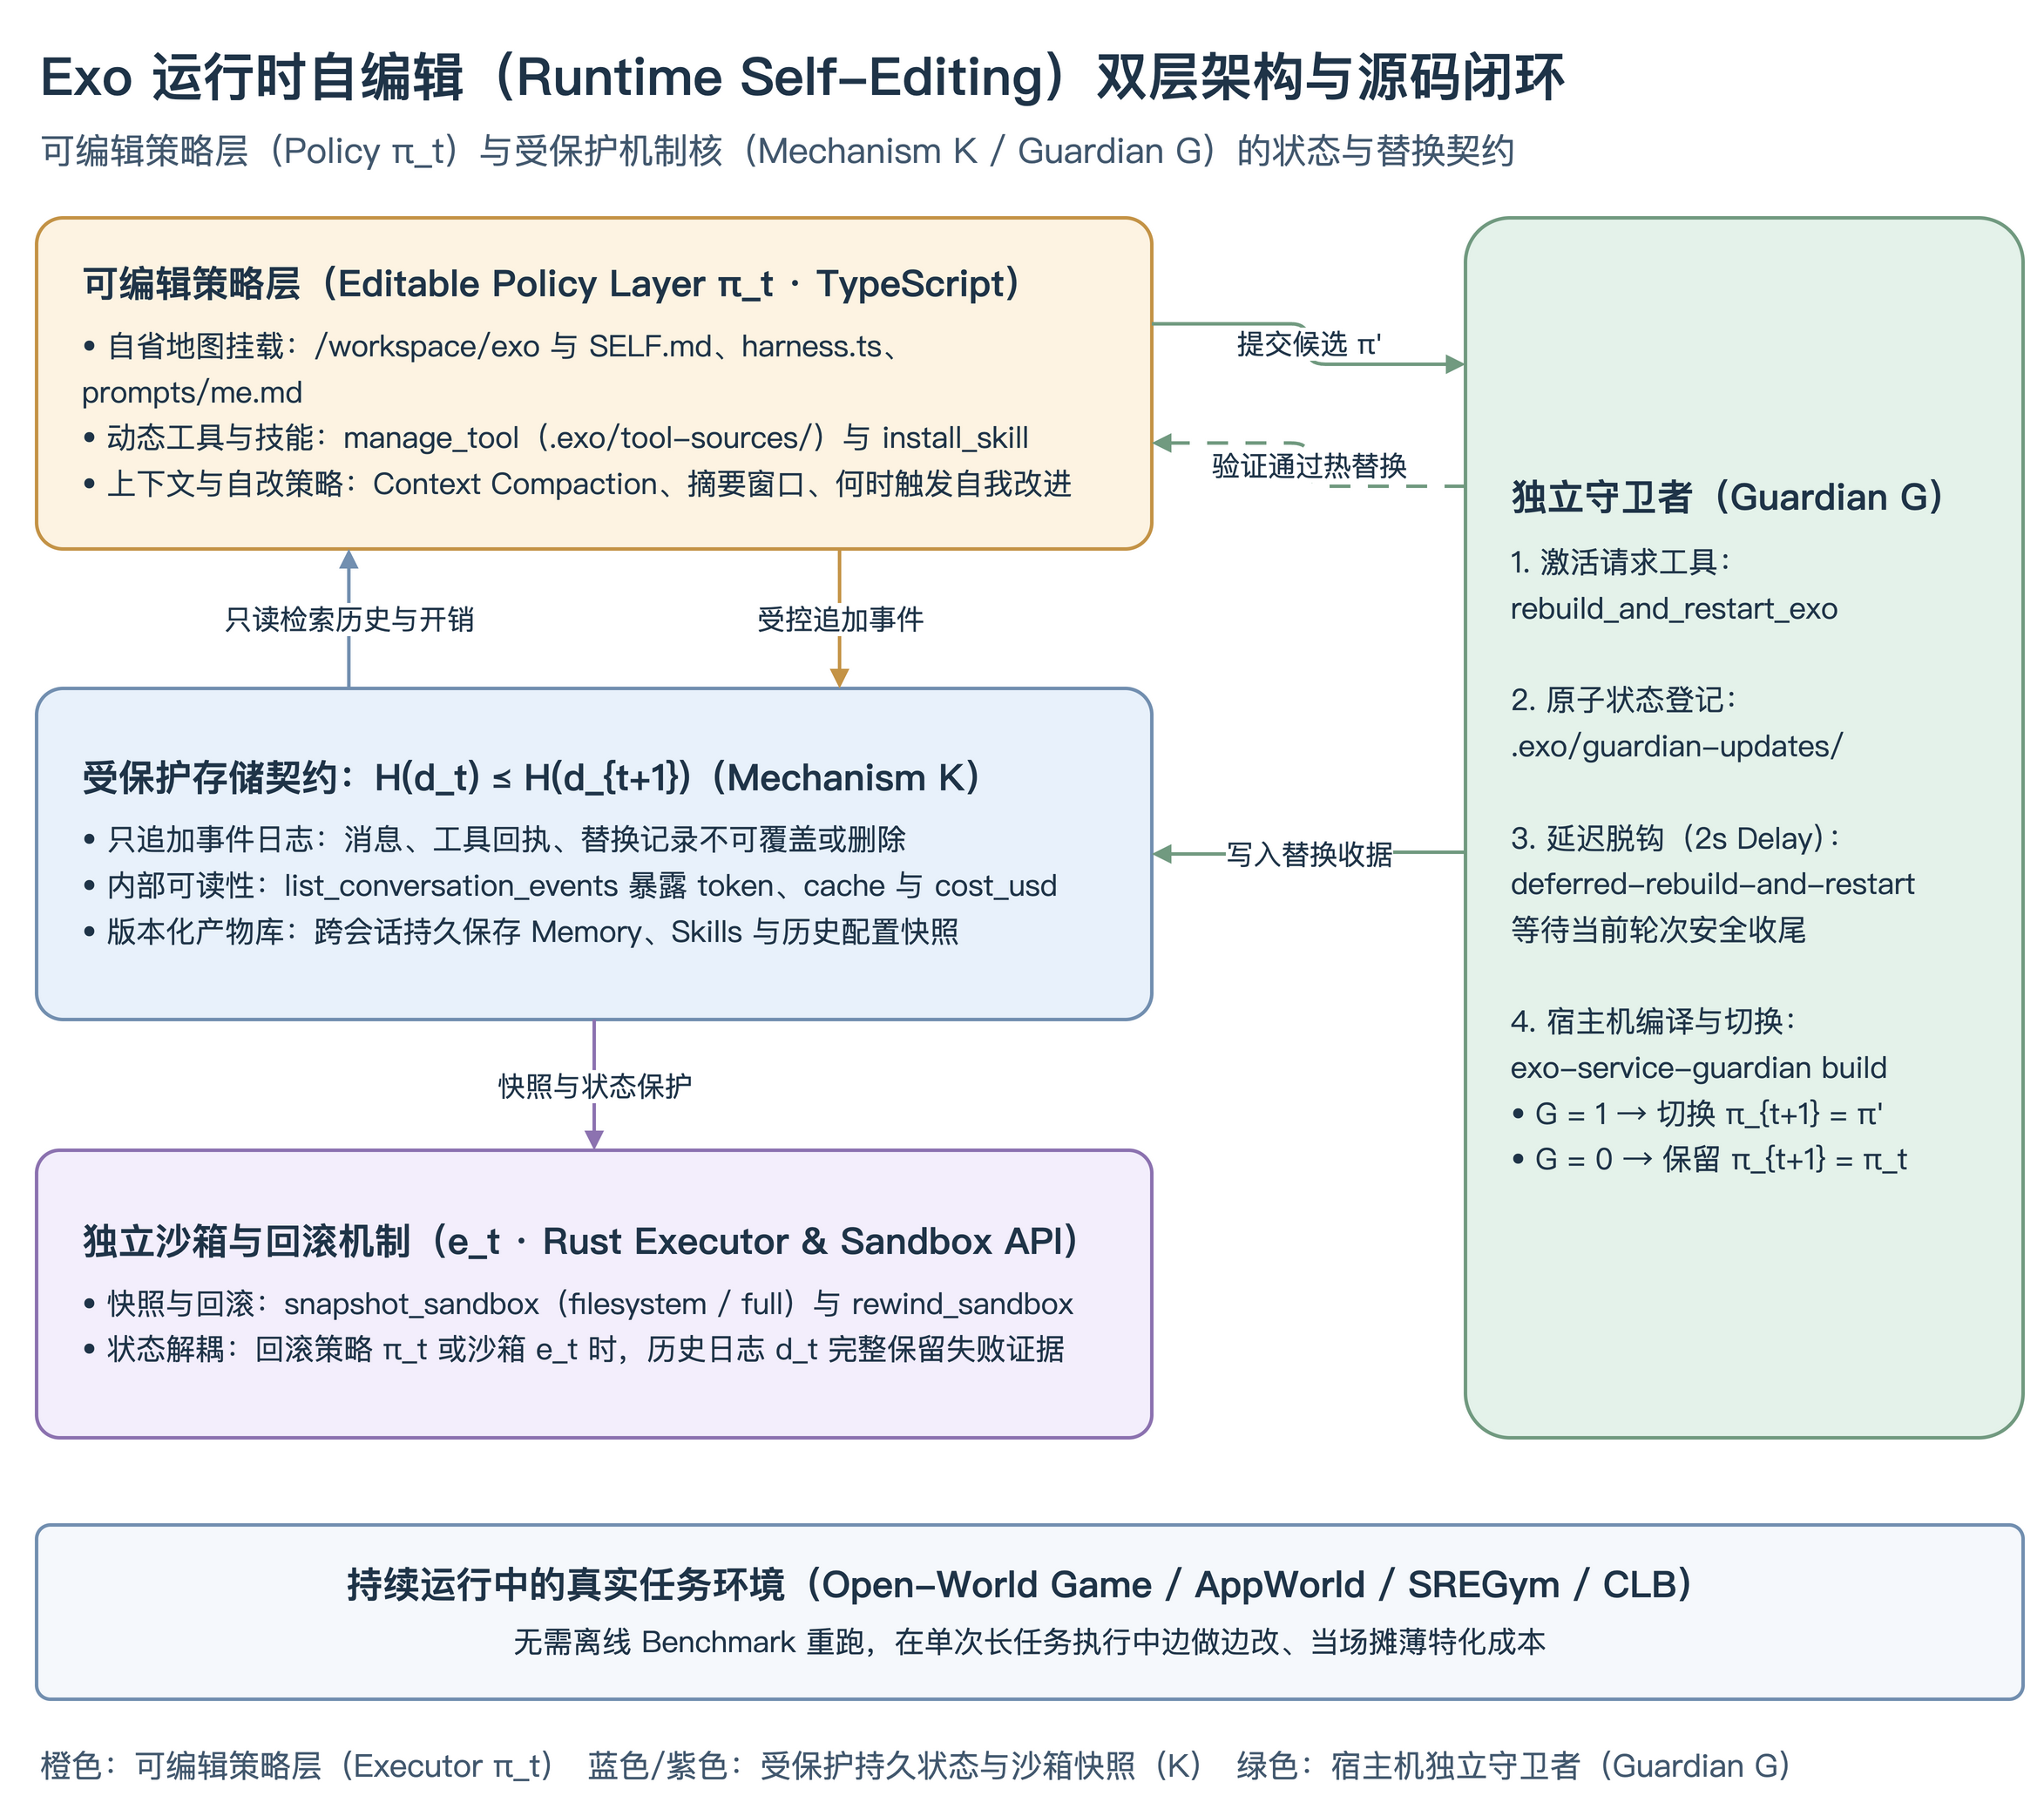
.drawio 源文件)。在 examples/self-improving-agent 与底层 crates/executor 中,论文里的四项抽象分别对应着非常干净的代码实现:
5.1 自省地图挂载:SELF.md 与 harness.ts
启动时,脚本将宿主机仓库挂载到容器沙箱的 /workspace/exo(环境变量 EXO_REPO)。在 examples/self-improving-agent/harness.ts 中,每一轮组装 Developer Instructions 时都会向模型注入自身的源码路径与自省入口:
const DEFAULT_EXO_REPO = "/workspace/exo";
const DEFAULT_EXO_SELF_MAP = `${DEFAULT_EXO_REPO}/examples/self-improving-agent/SELF.md`;

// 在 exoInstructions(context) 中注入自修改指引:
{
  role: "developer",
  content: `Your own source tree is mounted in the sandbox at ${repoPath}. Start with ${selfMapPath} when you need to inspect or modify Exo itself. Use rebuild_and_restart_exo to validate, build, and activate Exo changes, and include a short reason describing the change.`,
}
SELF.md 则是一份专门写给 Agent 自己看的“架构说明书”,明确列出了修改提示词组装去改 harness.ts、修改身份规则去改 prompts/me.md、动态注册本地 TypeScript 工具去写 .exo/tool-sources/<name>/exo-tool.json 并调用 manage_tool(下一轮模型调用立即生效,无需重启宿主进程),以及修改底层 Rust 工具时如何同步注册 TypeScript 声明并调用 rebuild_and_restart_exo。
5.2 Guardian 热替换与 2 秒延迟脱钩:guardian-tools.ts
当 Agent 修改了核心 Harness 代码并请求激活时,最棘手的工程细节是:如果工具调用当场杀死当前进程重启,当前这一轮模型调用的返回收据就会丢失,导致状态机卡死。
看 examples/self-improving-agent/tools/guardian-tools.ts 是如何用 原子状态文件 + 2 秒延迟分离进程(Deferred Detached Spawn) 解决这个问题的:
const DEFERRED_RESTART_DELAY_SECONDS = 2;

function queueRebuildAndRestart(
  reason: string | null,
  execution: ToolExecutionContext,
): ToolResult {
  const { agent, conversation } = execution.context.exoharness.current;
  const updateId = randomUUID();
  const outcomePath = join(UPDATE_DIR, `${updateId}.json`);
  mkdirSync(UPDATE_DIR, { recursive: true });
  // 1. 原子写入更新请求收据(先写 .tmp 再 rename)
  writeJsonAtomically(outcomePath, {
    updateId,
    operation: "rebuild_and_restart_exo",
    status: "queued",
    requestedAt: new Date().toISOString(),
    reason,
    agentId: agent.record.id,
    conversationId: conversation.record.id,
  });
  // 2. 启动脱离父进程组(detached + unref)的延迟构建守护脚本
  const result = runGuardianDeferredWithOutcome(
    ["restart-all", "--build"],
    updateId,
    outcomePath,
    reason,
  );
  // 3. 立即返回排队成功,让当前模型 Turn 在 2 秒窗口内正常收尾落盘
  return {
    ok: true,
    updateId,
    status: "queued",
    deferred: true,
    reason,
    delaySeconds: DEFERRED_RESTART_DELAY_SECONDS,
    outcomePath,
  };
}
随后,脱离了当前执行器进程树的宿主机脚本 deferred-rebuild-and-restart 等待 2 秒(让当前 Turn 完整写回只追加日志),再调用宿主机侧的 exo-service-guardian build。只有编译与校验全部通过(),Guardian 才会写入 .exo/exo-control.restart 标记重启子进程,并将最终构建结果(updateId、status、exitCode、reason)作为一条 rebuild_and_restart_exo 事件写回会话日志。
5.3 内部可读性与独立快照回滚:introspection-tools.ts 与 sandbox-tools.ts
在 introspection-tools.ts 中,只读工具 list_conversation_events 向策略层暴露了底层事件账本:默认返回生命周期与自更新事件(如 session_started、error、sandbox_snapshotted、rebuild_and_restart_exo),也可以传入 kinds: ["messages"] 检索每轮对话附带的 usage 账单标注(含 Token 数与 cost_usd)。而在 sandbox-tools.ts 中,snapshot_sandbox(支持仅文件系统 filesystem 或含内存/进程的 full 模式)与 rewind_sandbox 提供了沙箱回滚原语,确保沙箱状态回退与对话历史账本互不干扰。
6. 实验结果全解析:从开放世界长周期博弈到软件工程基准
Exo 的实验设计紧扣两个核心问题:
- 单次长任务内的即时收益(Standalone Specialization):在一个没有任何历史积累的新任务里,花钱改自己的工具和上下文策略,能不能在同一个任务结束前把前期的“特化投资”赚回来?
- 跨任务迁移复用(Transfer & Graded Benchmarks):学到的工具和上下文策略迁移到新账号或留出测试集(Held-out Tasks)上,能省多少成本和时间?
6.1 开放世界长周期评测(RuneScape):同台对比 Codex 与 Pi
作者首先选择了一个动态性极强、单任务耗时数小时的开放世界多人在线游戏环境 RuneScape(通过统一的 RS-SDK 接口操作,全部模型统一使用 gpt-6.1-sol,中等推理强度),将 Exo 与工业界广泛使用的两个强基线——OpenAI Codex CLI 和开源极简脚手架 Pi(可参考本站此前对 Pi 架构 与 SoL-Pi 的源码拆解)放到同一个游戏世界里同台竞技。其中 Combat(战斗满级)在有 1,200–1,500 名真实玩家与机器人的公共服上运行,Money-making(8 小时赚金币)与 Crafting(从零采集并锻造高难度的 Adamant Platebody 胸甲,禁止直接购买成品)在共享私服上运行。
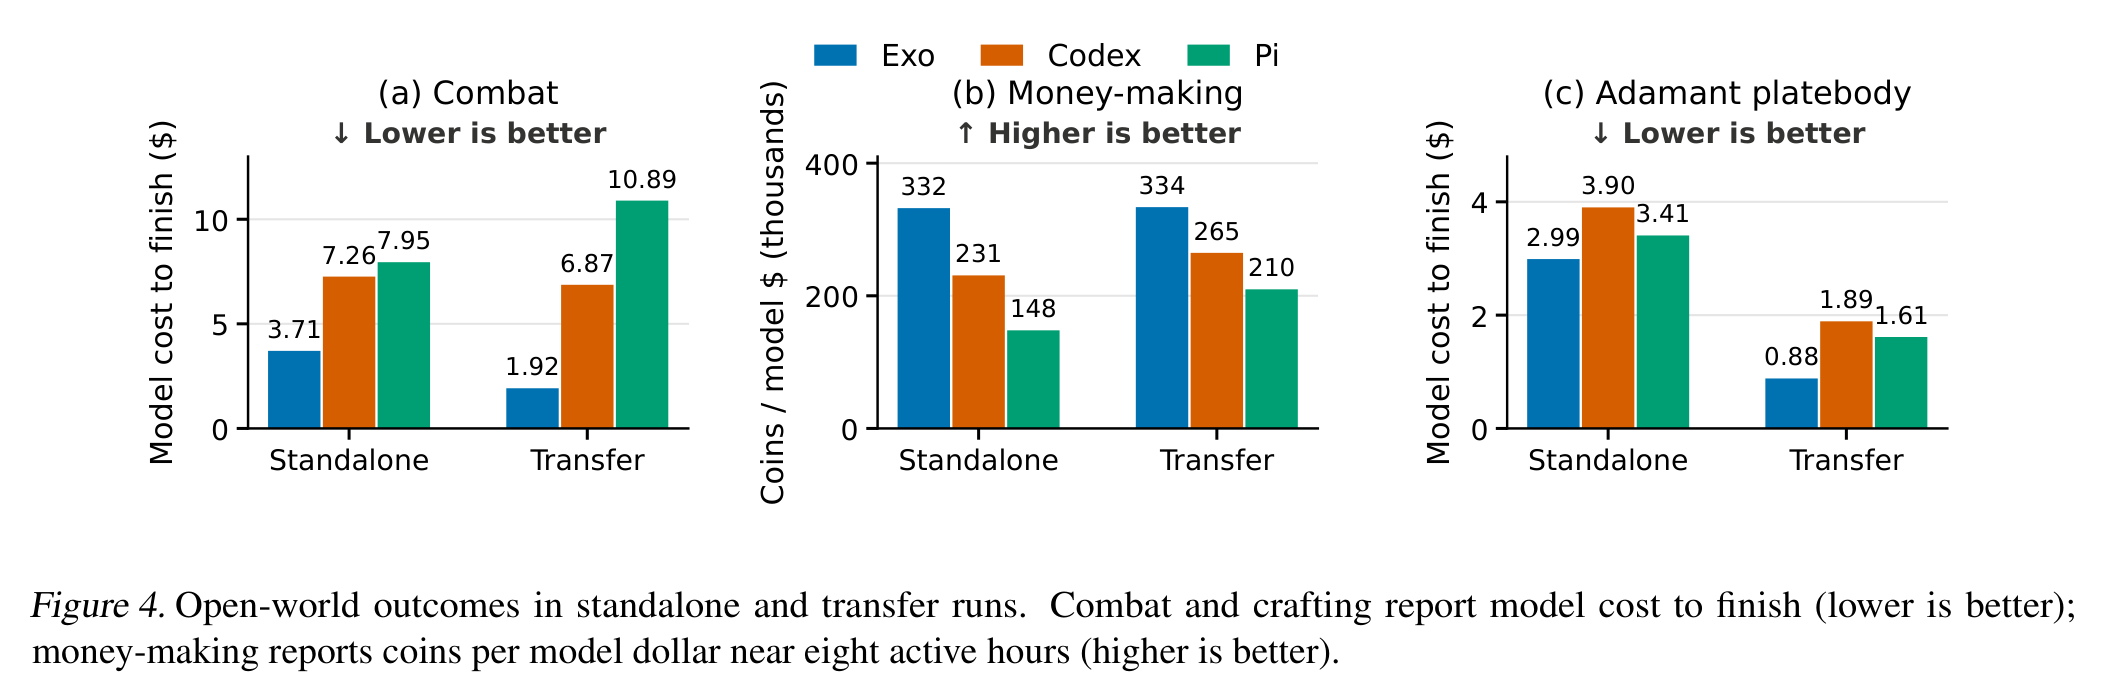
arXiv:2611.00463 Fig. 4)。(a) 战斗满级所需模型成本(越低越好);(b) 8 小时内每美元模型开销赚取的金币数(越高越好);(c) 锻造 Adamant Platebody 所需模型成本(越低越好)。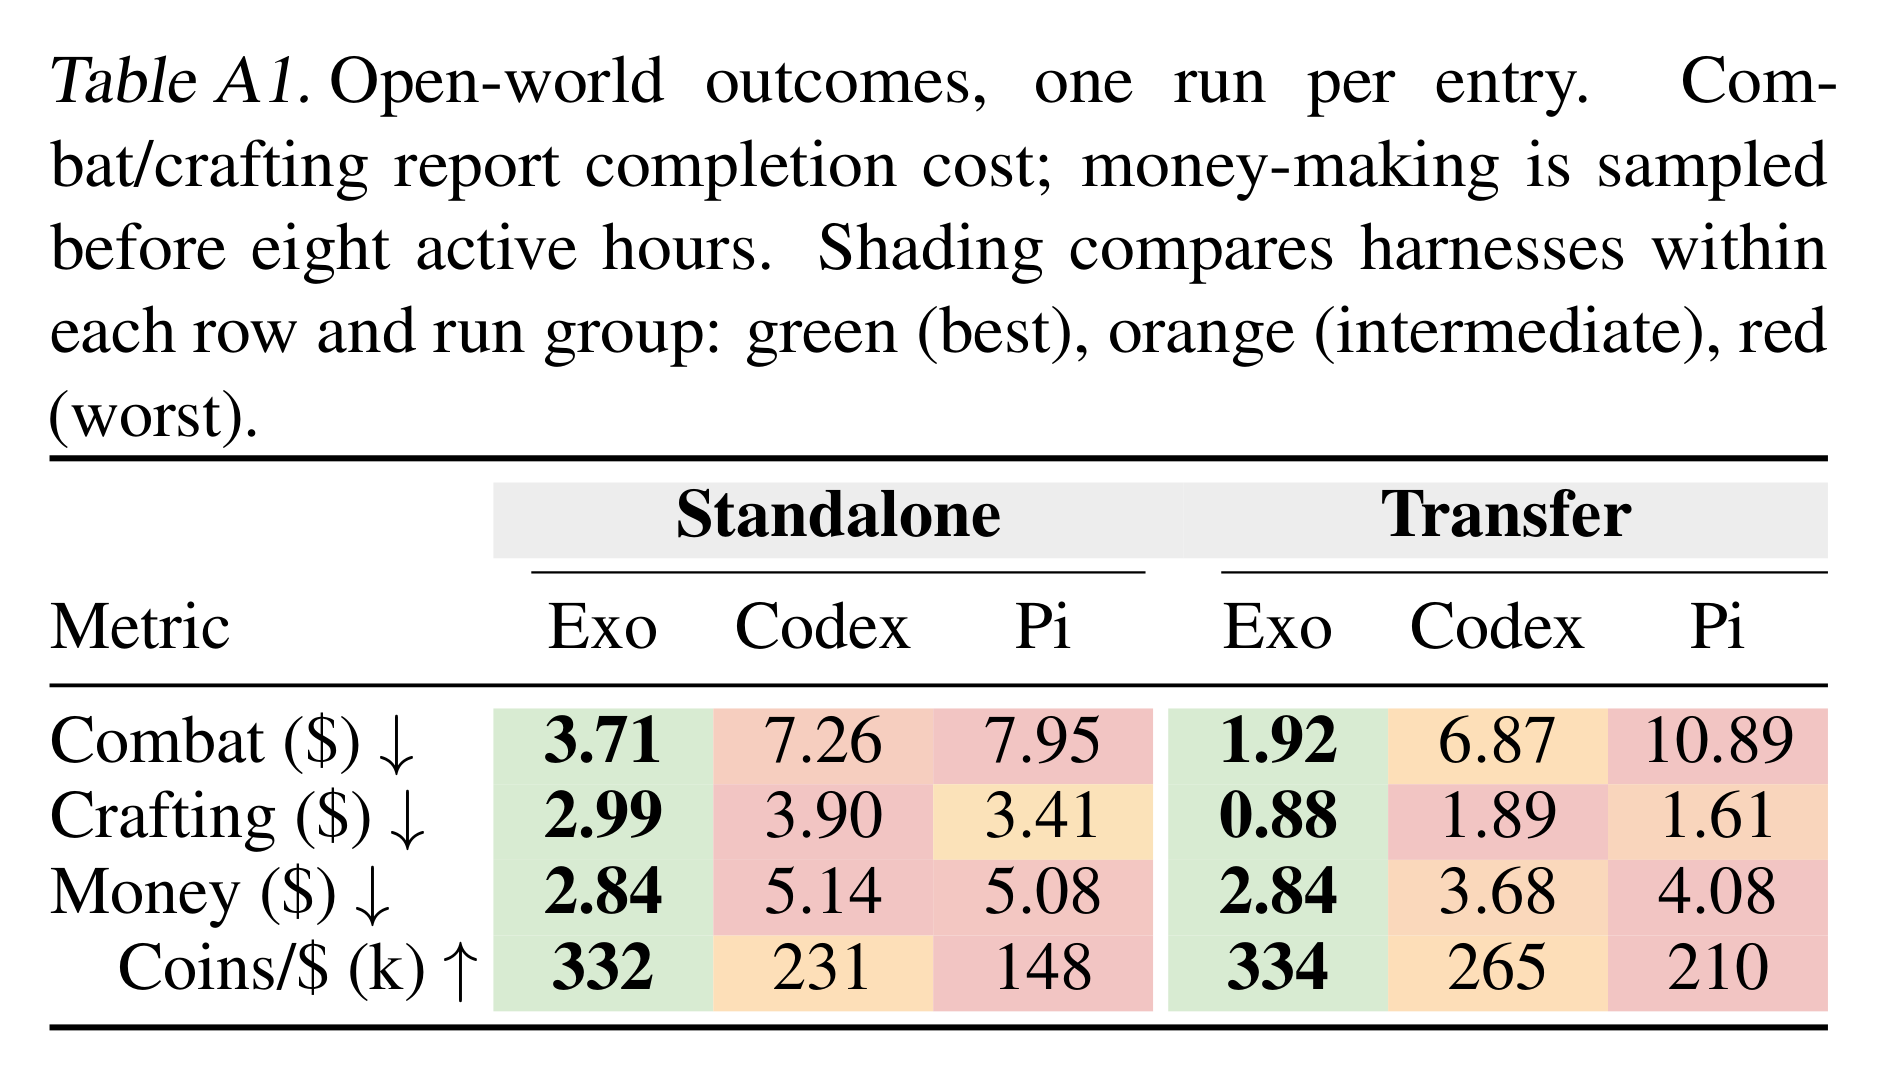
arXiv:2611.00463 Table A1)。绿色代表同组最佳,橙色次之,红色最差。结合图 5 与图 6(Table A1),主要实验结果如下:
- 单次运行(Standalone,零初始经验):三个框架全部完成了有限目标,但 Exo 在战斗任务上花费 $3.71(Codex 花费 $7.26,Pi 花费 $7.95);在锻造任务上花费 $2.99(Codex 为 $3.90,Pi 为 $3.41),单次运行降低 12%–53% 的模型成本。在 8 小时赚金币任务中,Exo 每美元模型调用赚取 33.2 万枚金币,而 Codex 和 Pi 分别为 23.1 万和 14.8 万枚,每美元金币产出高出 44%–125%。
- 跨账号迁移(Transfer,保留各自积累的经验/代码,换全新零级账号重跑):三个框架都保留了第一轮的历史与沙箱状态,但只有 Exo 额外保留了对自身 Harness 的代码修改。结果 Exo 的战斗成本进一步从 $3.71 降至 $1.92(Codex 为 $6.87,Pi 升至 $10.89,Exo 成本比两者低 72%–82%);锻造成本从 $2.99 降至 $0.88(Codex 为 $1.89,Pi 为 $1.61,成本低 45%–53%)。原因在于:Codex 和 Pi 虽然留着历史文件,但每一步仍然要靠模型推理去回忆和管理环境脚本;而 Exo 已经把成熟动作流程写进了 Harness 工具与上下文策略里,新账号可以直接调用。
6.2 拆解“特化成本(Specialization Cost)”与 16 次运行时自修改
为什么 Exo 能在单次运行里就比不改代码的 Codex 和 Pi 省下一半成本?图 7(论文 Fig. 5)展示了 5 小时战斗任务的分阶段轨迹。
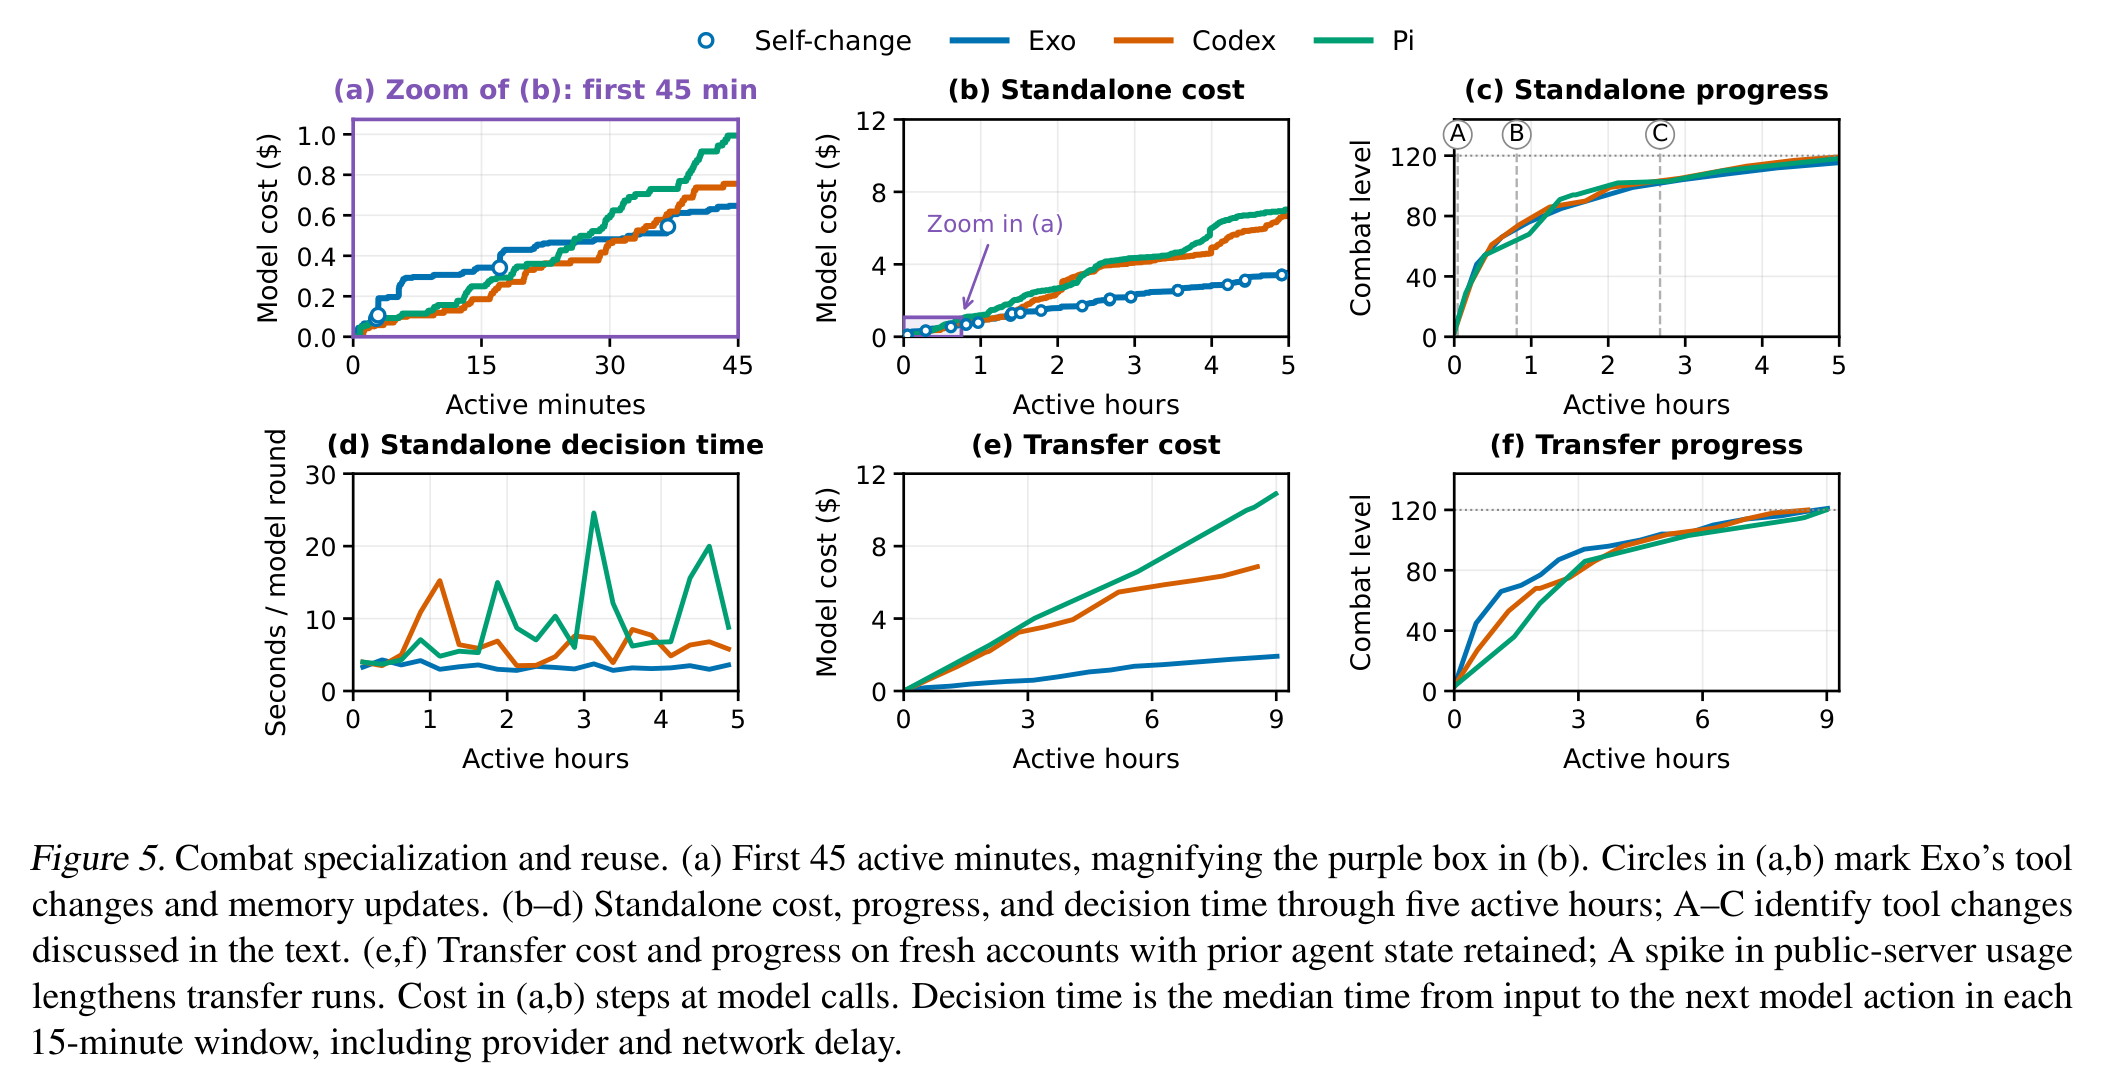
arXiv:2611.00463 Fig. 5)。(a) 前 45 分钟放大图,圆圈标记 Exo 发起工具修改与记忆更新的时刻;(b–d) 5 小时内的累计模型成本、战斗等级进度与每轮中位决策耗时,A、B、C 对应三次关键工具演化;(e, f) 新账号迁移运行时的成本与进度曲线。图 7(a) 和 (b) 展示了论文定义的**特化成本(Specialization Cost)**及其回收过程:
- 前 10 分钟的前期投入:在开局第 10 分钟,Exo 已花费 $0.31,高于 Codex($0.12)和 Pi($0.16)。此时 Codex 和 Pi 直接推进任务目标,而 Exo 把早期开销花在了编写可复用战斗工具和修改上下文组装策略上。
- 25 分钟与 86 分钟的成本交叉点:随着自修改生效,Exo 的花费增速明显放缓——第 25 分钟,Pi 的累计开销超过 Exo;第 86 分钟,Codex 的累计开销也超过 Exo。此后直到第 5 小时任务结束,Exo 的单步决策耗时(图 7d)始终保持在较低水平,而 Pi 多次出现每轮 20 秒以上的延迟波动。
- A、B、C 三次真实代码自修改:在整场运行中,Exo 一共对自身发起了 16 次自编辑。图 7(c) 标出了其中三次代表性修改:
- 节点 A:创建
train_combat工具,将近战攻击动作打包批处理,并汇总输出获得的经验值与周围观测,减少逐回合模型调用; - 节点 B:在多次遇到攻击目标卡死后,修改
train_combat源码,加入跳过卡死目标与提前撤退逻辑; - 节点 C:构建高级工具
combat_cycle,自动挑选当前未满级的最低近战技能、持续训练 180 秒、拾取附近资源并在低血量时停止;随后又修改 Context Assembly 策略,只保留最近 4 轮的回合摘要,将更早的策略留存在持久记忆中。
- 节点 A:创建
反例边界:非重复性任务何时难以收回特化成本? 作者专门测试了第四类目标——完成尽可能多的一次性剧情任务(Quests)。每个剧情任务只执行一次,步骤、道具和地点差异很大,几乎没有重复结构。在每组 3 次运行的平均结果下,Exo 每获得 1 个任务点花费 $0.28,高于 Codex($0.24)和 Pi($0.21)。尽管 Exo 在过程中编写了可复用的对话工具,但任务本身的特异步骤占比过高,前期投入的特化成本无法在后续步骤中摊薄。这说明对于缺乏重复结构的工作负载,不做自省与自改的 Harness 运行成本更低。
6.3 AppWorld、SREGym 与 CLB 三大评分基准:成本砍半、诊断提速 35%
为了隔离框架差异,作者在三个评分基准(统一使用 gpt-5.6-sol,禁网防止作弊)上进行了对照实验:将 Exo 与 Control(使用相同的初始策略、代码工具、Shell、子任务规划和记忆工具,仅禁用“编辑自身 Harness 策略”权限) 进行对比。结果汇总在图 8、图 9 与图 10(Table 1)中:
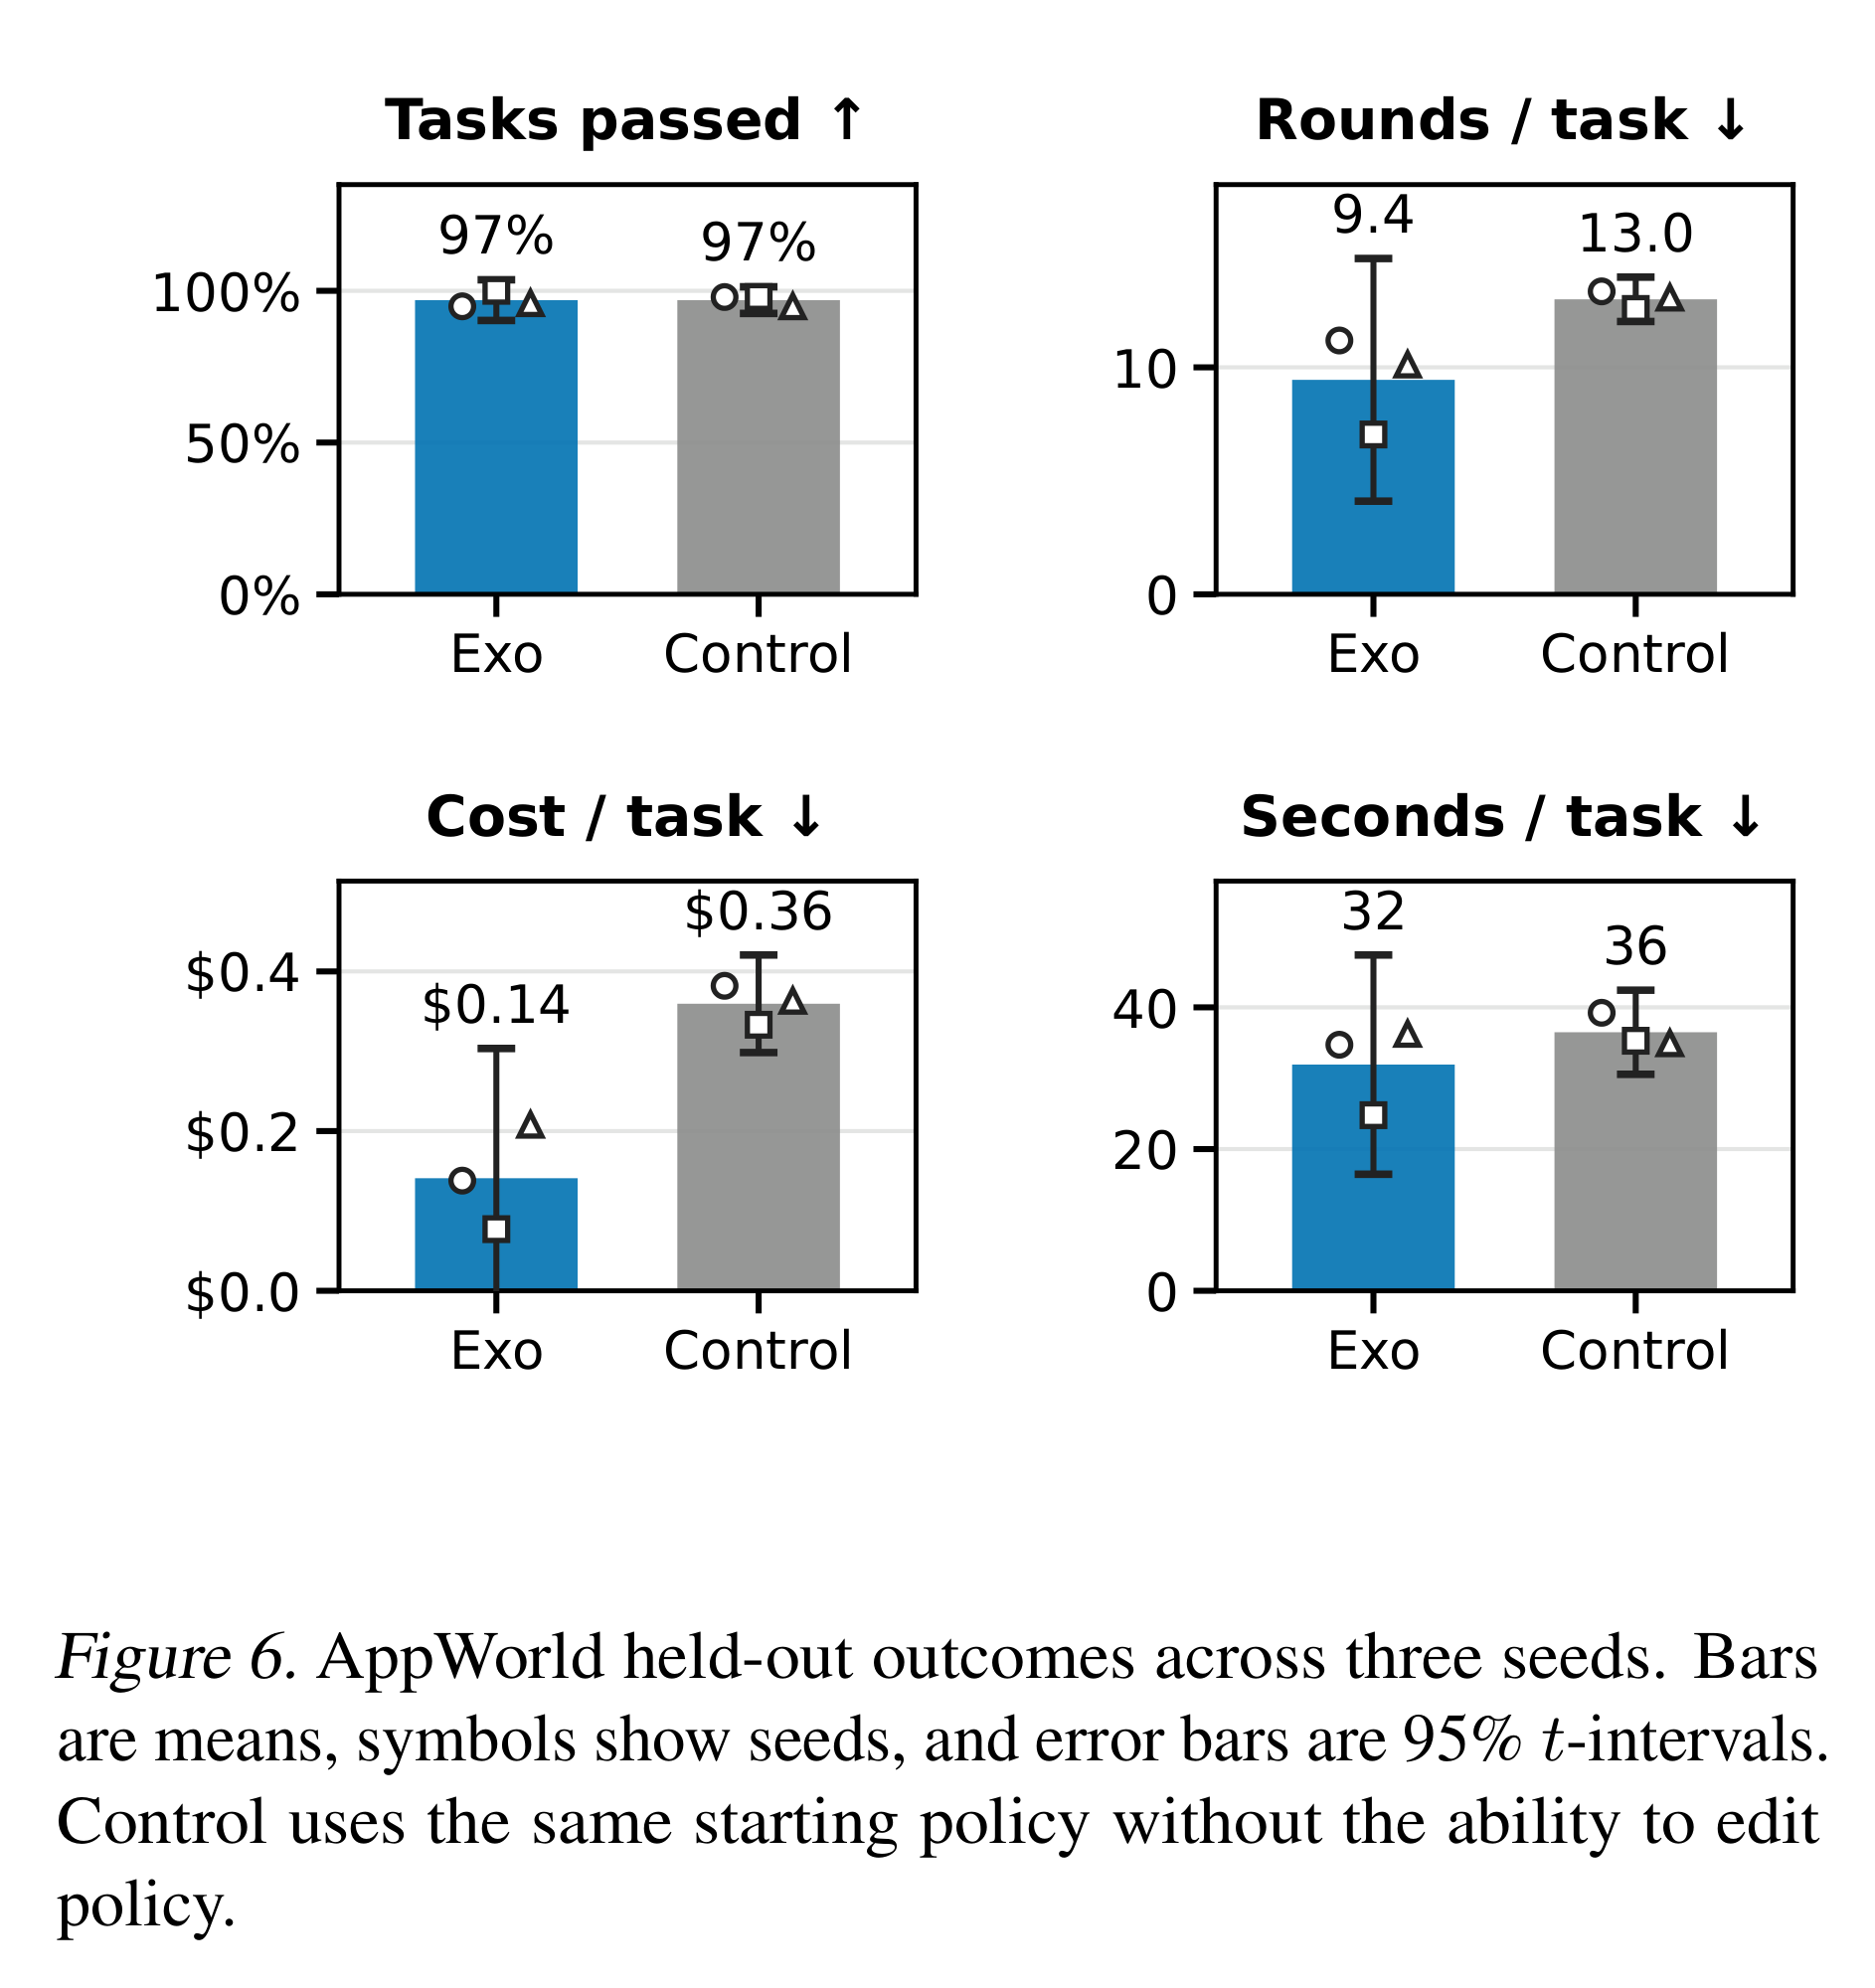
arXiv:2611.00463 Fig. 6)。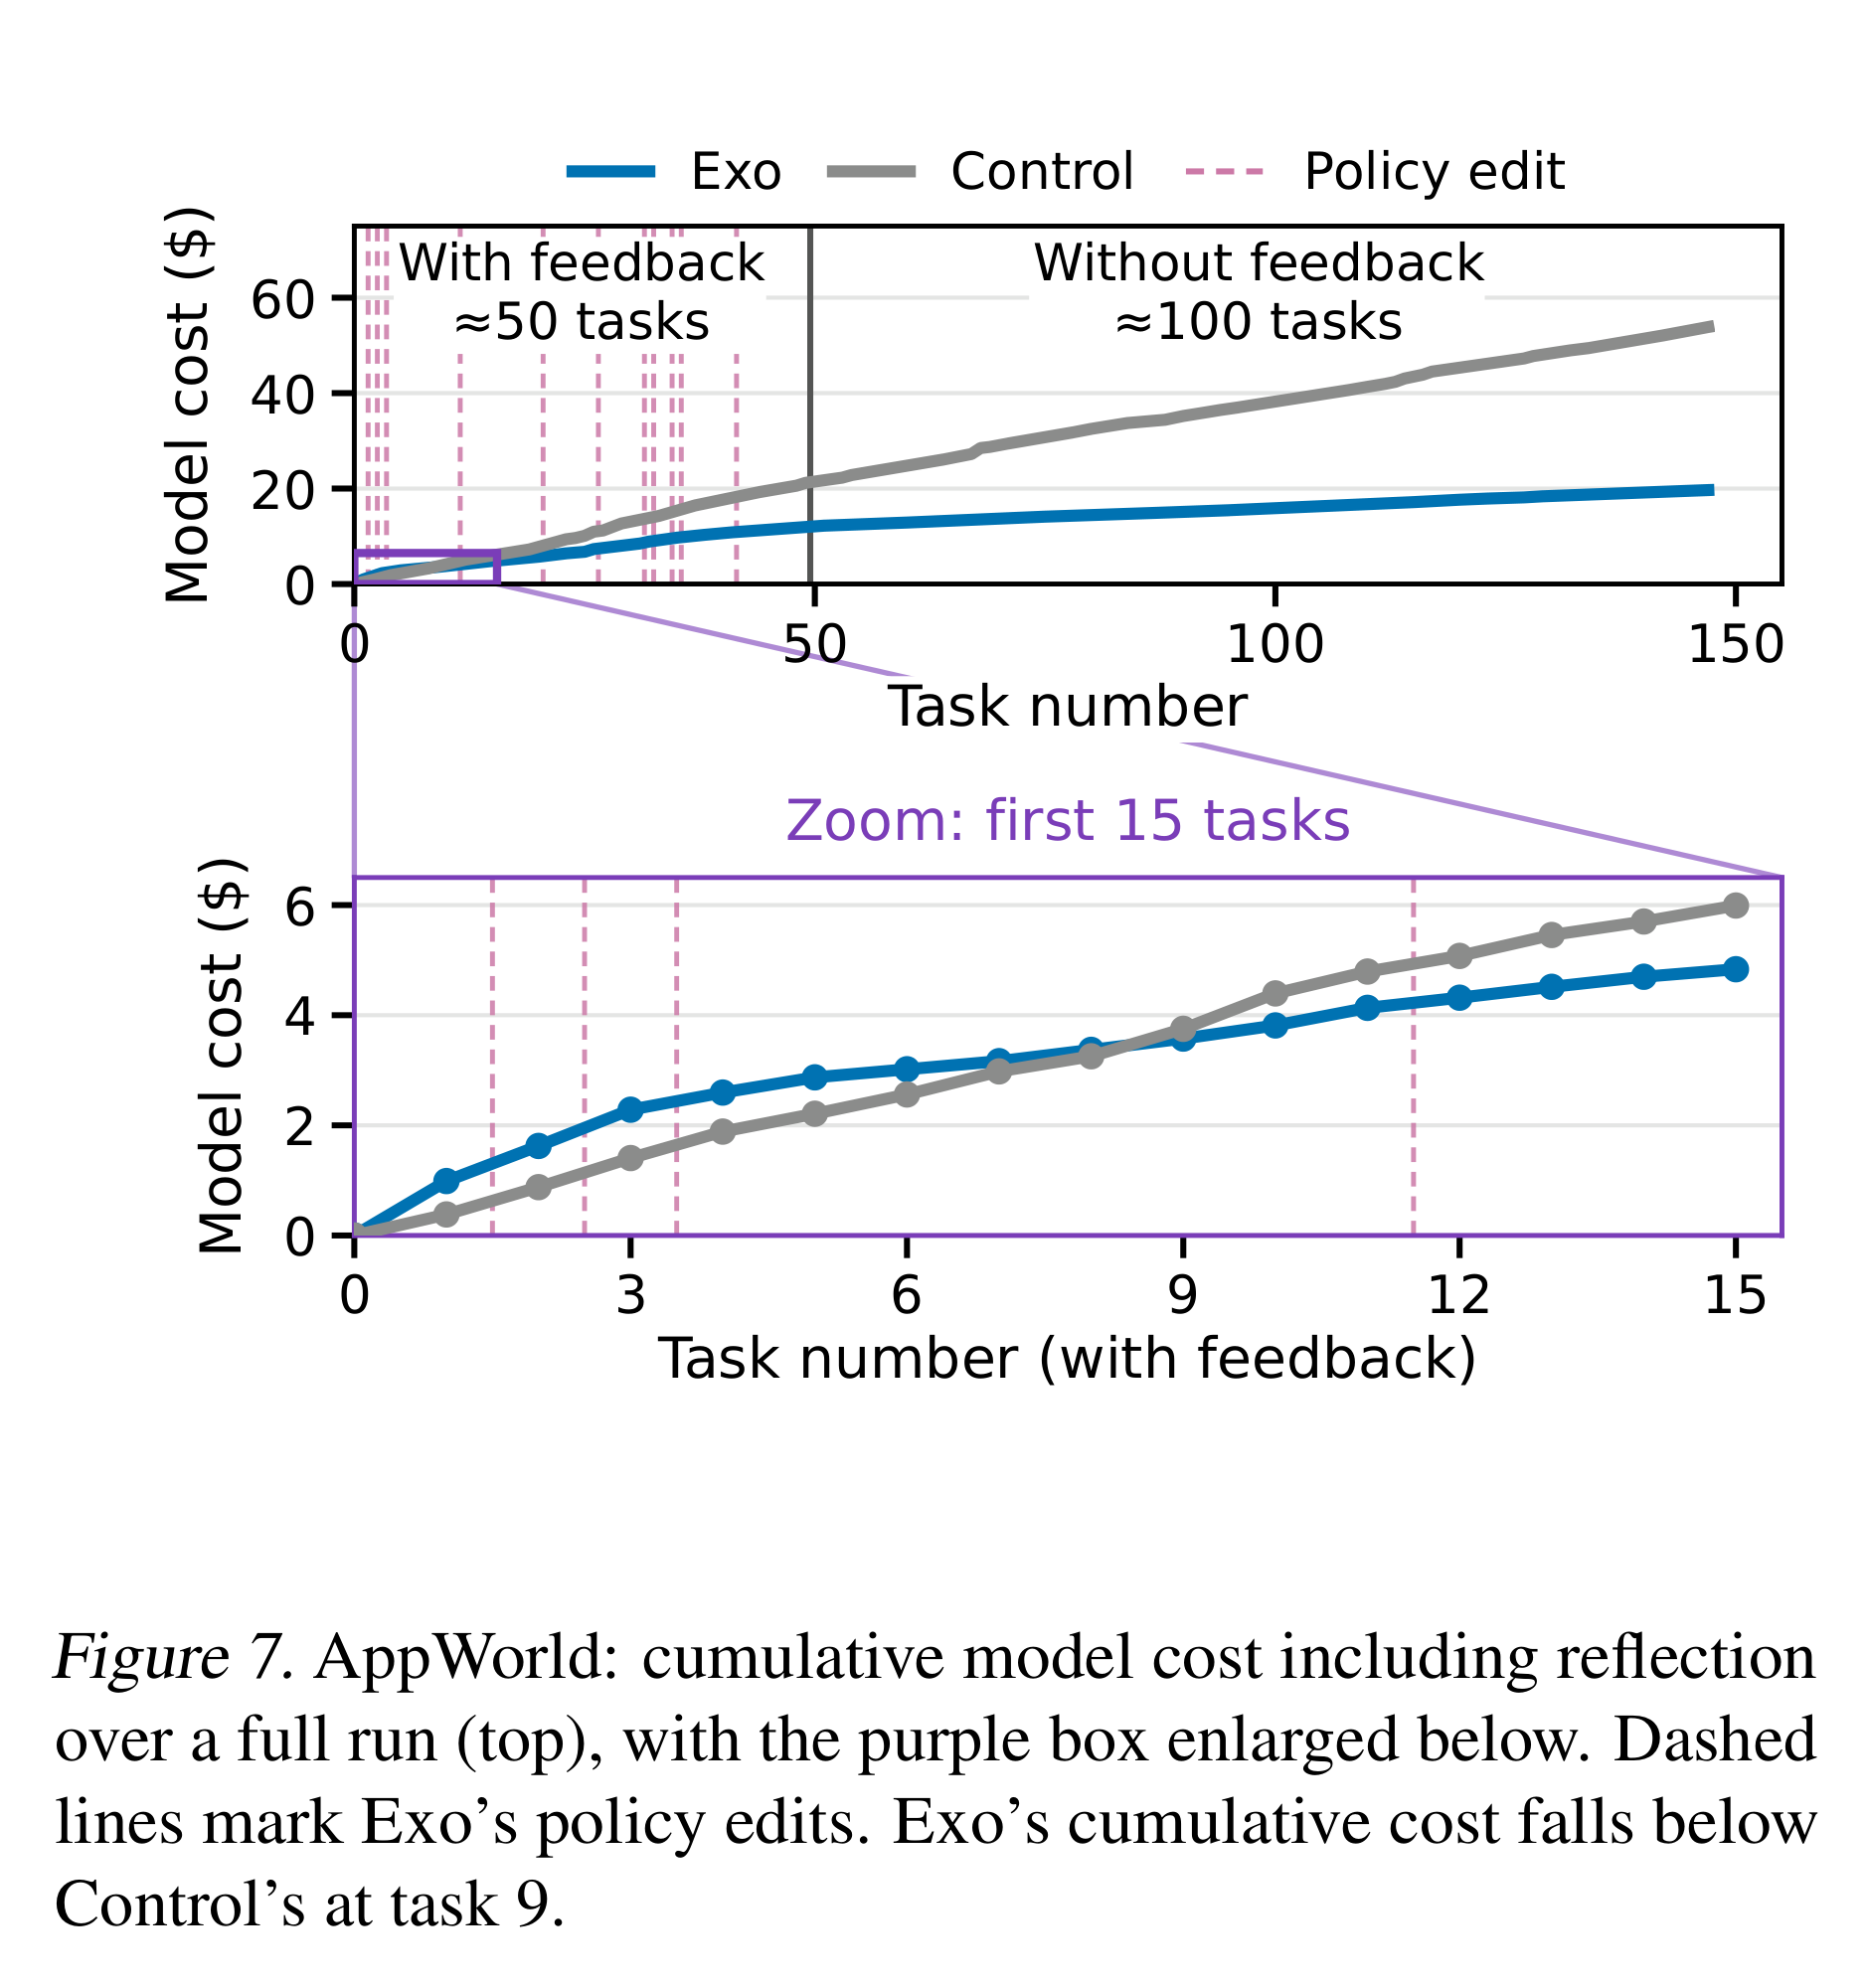
arXiv:2611.00463 Fig. 7)。粉色虚线标记 Exo 修改自身策略的时刻;下方放大图显示,到第 9 个任务时,Exo 包含反思与自改在内的总累计成本已低于 Control。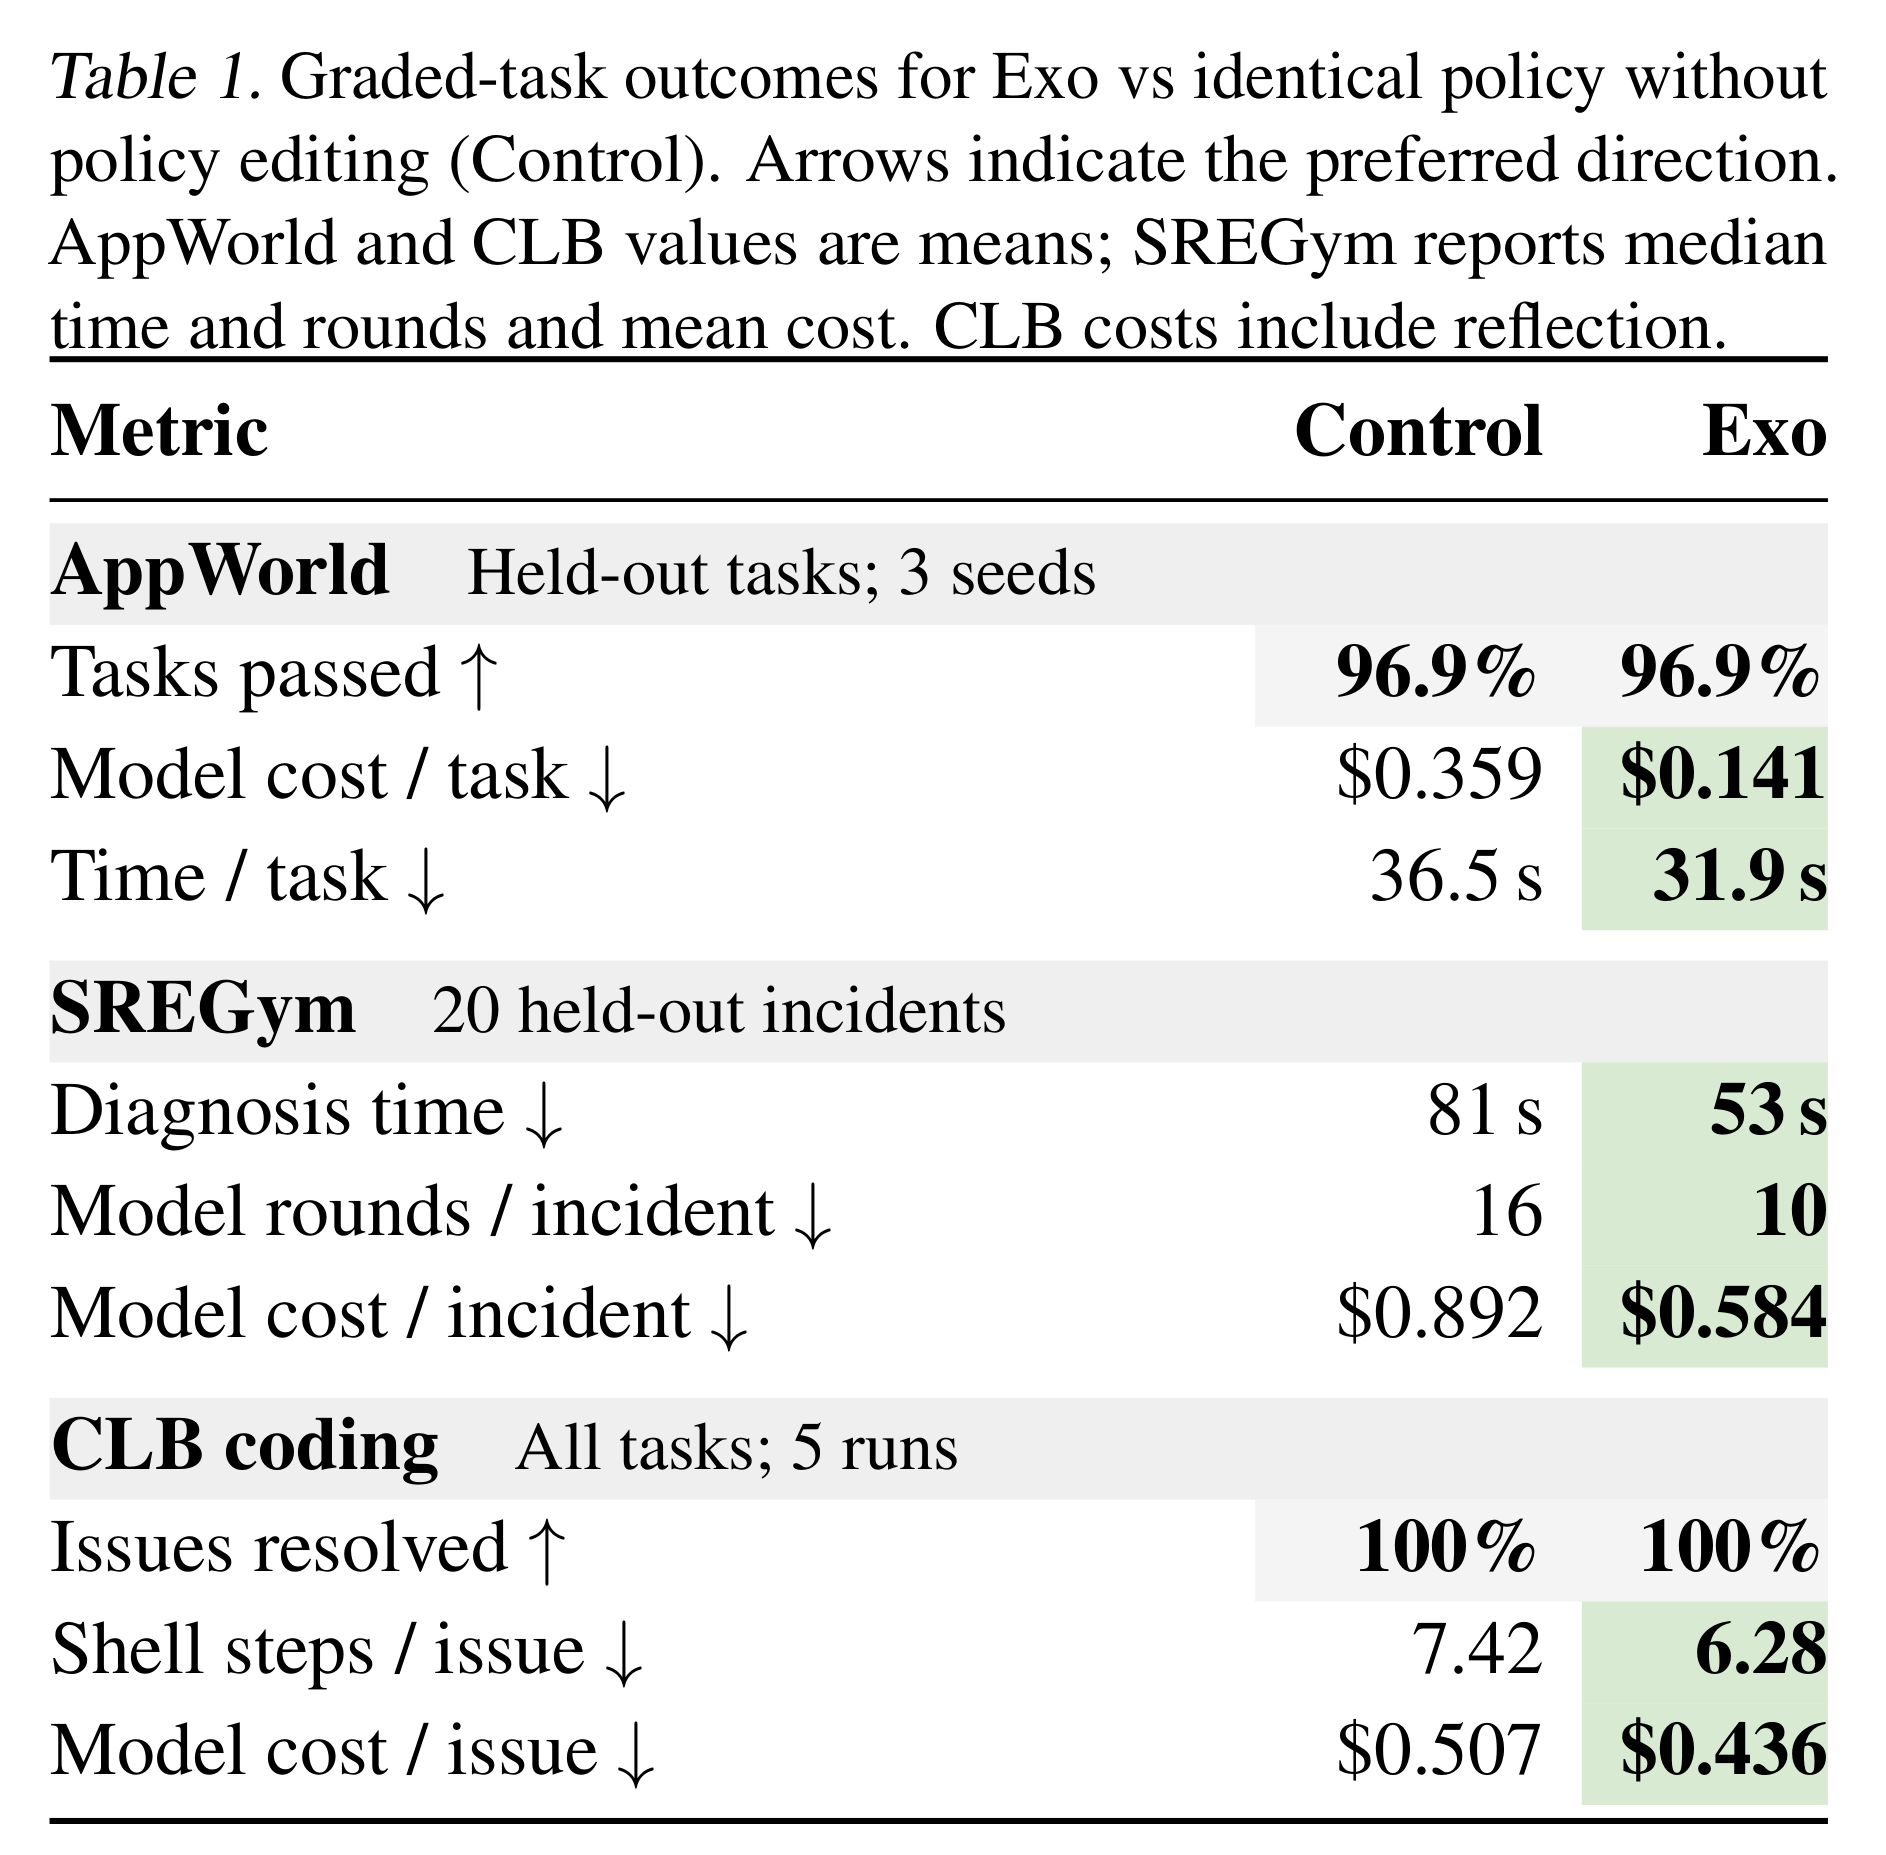
arXiv:2611.00463 Table 1)。三个基准的具体表现如下:
- AppWorld(跨 9 个日常应用的复杂 API 交互,50 题带反馈学习 + 100 题无反馈留出测试,3 Seeds):
- 在留出集通过率一致(均为 96.9%)的前提下,Exo 将留出集单任务平均成本从 $0.359 降至 $0.141(降低 61%),模型调用轮次从 13.0 轮降至 9.4 轮(-27%),单任务耗时从 36.5 秒降至 31.9 秒(-13%)。
- 将前 50 题学习与反思的开销计入后,全流程 150 题的平均总成本从 $57.36 降至 $32.70(降低 43%)。如图 9 下方放大图所示,在 Seed 2 中,Exo 在前 3 个任务后各修改了一次 Harness,到第 9 个任务时累计总花费就已低于 Control。
- 具体策略变更:一是编写了
appworld_api_docs工具,单次调用即可拉取多个相关 API 的精简文档,避免反复检索;二是将频繁变动的任务列表移出常驻系统提示词并重构上下文拼装逻辑,使缓存输入占比(Cached Input Share)从 57.5% 提升至 86.1%。同时,3 个随机种子学到了不同的实现路径(Seed 1 和 2 偏向构建通用工具,Seed 3 构建了更多场景专用工具),但均在留出集上降低了成本。
- SREGym(运行服务故障注入诊断,21 个带反馈学习故障 + 20 个不同应用上的未见留出故障):
- 在 20 个未见留出故障上,Exo 将中位诊断耗时从 81 秒缩短至 53 秒(降低 35%),中位模型交互轮次从 16 轮降至 10 轮(-38%),单次故障平均模型成本从 $0.892 降至 $0.584(降低 35%)。
- 在学习阶段,Exo 创建并先后 5 次修订了故障快照工具
incident-snapshot——把异常 Pod 列表、版本与模板异常、可疑日志行一次性打包采集,并在留出故障排查的第一步直接调用,替代了原本需要多次执行的 Shell 检查命令。此外它还构建了 5 个针对特定调查方向的辅助工具。
- Continual Learning Bench(CLB 持续代码修复,连续处理
tablib与tenacity的 19 个 GitHub Issue,5 Runs):- 两组均 100% 解决全部 Issue。Exo 通过在 Issue 之间编辑工具与技能,将平均每个 Issue 的 Shell 步数从 7.42 步降至 6.28 步(-15%),含反思在内的单题模型成本从 $0.507 降至 $0.436(降低 14%)。
6.4 能力下限(Intelligence Floor):小模型在自编辑上的局限
作者在 §5.4.3 末尾报告了一组补充实验:当把 AppWorld 实验的底座模型换成较小的 gpt-5-mini 时,3 个随机种子仅发起了少量 Harness 修改,且在进入留出集后没有复用自己创建的工具,最终总成本($6.63 vs. $6.73)与通过率(59% vs. 55%)与 Control 相近。
这说明运行时 Harness 自演化存在一道模型能力下限(Intelligence Floor):只有当底座模型具备足够的诊断、抽象与工具复用能力时,开放自编辑权限才能带来净收益。
7. 对 GUI Agent 与 APP 自动化测试 / Mobile QA 的启发
将 Exo 的架构放到 GUI Agent 与移动端自动化测试(Android / iOS / H5 / Hybrid App 端到端回归、探索性测试与 UI 巡检)的场景下审视,可以从四个方面借鉴其设计:
7.1 把长链路真机回归做成“前 10 步特化、后 90 步复用”的折叠循环
在移动端 QA 中,跑一套覆盖“商品搜索—筛选—详情页规格切换—领券—加购—结算台凑单—地址管理—订单校验”的百步级回归或长周期探索性巡检,往往耗时数十分钟。传统 GUI Agent 框架在整个任务期间固定使用同一套 click(x, y) / swipe / dump_hierarchy 基础原子工具,在同一个 App 里反复遇到相同的半屏弹窗、懒加载骨架屏或商详页结构时,每次都要重新截屏、拉取几十 KB 的无障碍树(Accessibility Tree)让 VLM 从头推理。
借鉴 Exo 的运行时折叠思路:
- 允许测试 Agent 在进入某个业务域的前几个测试场景(或前 10 分钟探索)时,将高频重复的多步 UI 交互(如“关闭首页青少年模式与营销弹窗并等待首屏 Feed 稳定”“在混合 WebView 容器中等待 Bridge 注入并提取商品 SKU 状态”)现场封装成业务级复合工具(类似 Exo 在 SREGym 里迭代 5 次的
incident-snapshot与 AppWorld 里的第 9 题回本曲线); - 在同一批次剩余的同业务域回归用例中,直接调用刚合成的复合工具,减少中间步骤的逐帧 VLM 视觉推理。
7.2 复刻 Exo 的“策略—机制分离”,隔离自修复脚本与测试账本
在 UI 自动化脚本中引入“自愈(Self-Healing)”时,常见风险是脚本污染测试环境或覆盖失败现场。Exo 的双层边界为移动测试平台提供了一套清晰的职责划分:
- 受保护机制层(Protected Mechanism K):真机/模拟器设备池管理、
adb/WDA底层通道、完整录制轨迹(每一步的截图、View Hierarchy 快照、网络抓包、logcat/ Crash 堆栈)的只追加事件账本(),以及业务断言(Oracle)与 Guardian 激活门禁。 - 可编辑策略层(Editable Policy ):控件定位与 Grounding 策略、动态等待与重试逻辑、控件树裁剪过滤规则(Context Compaction)、页面恢复子程序。
- 独立回滚:当 Agent 修改某个页面等待或定位插件失败时,通过类似
rewind_sandbox(在移动端对应应用数据快照恢复、deeplink 重置或测试账号状态回滚)恢复设备状态,同时在只追加日志里完整保留失败修改的轨迹,避免重复尝试同一无效补丁。
7.3 引入“内部可读性(Internal Legibility)”:把 Token 账单、耗时与前缀缓存命中率暴露给 Agent
Exo 在 AppWorld 上把单任务成本降低 61% 的一个重要原因,是 Agent 观察到自身的 cached input share 只有 57.5%,进而主动把频繁变动的任务列表移出常驻系统提示词,使缓存命中率提升到 86.1%。
在多模态 GUI Agent 测试中,每一步的截图 Token、长 XML 树和动态设备状态栏(电量、时间、网络信号强度)如果不加区分地拼在 Prompt 前部,会导致前缀缓存失效、调用成本上升。移动测试 Harness 可以像 Exo 的 list_conversation_events 一样,把每一轮调用的 输入 Token 构成、KV Cache 命中率、页面等待耗时与重复动作次数 实时暴露给策略层,让 Agent 能够重写 XML 属性过滤规则(例如剥离动态时间戳或无关布局属性),在运行中提高缓存复用率。
7.4 明确“特化回本边界”与“模型能力下限”,不在一次性短任务或小模型上盲目开启自改
Exo 的两项负面与边界实验同样明确了适用前提:
- 一次性短任务不开启自编辑:正如 RuneScape 的一次性剧情任务(Quests)中 Exo 单点成本($0.28)高于 Codex($0.24)与 Pi($0.21),如果只是运行单条一次性冒烟测试,或者页面缺乏可复用结构,直接用固定轻量 Harness(如 Pi 或确定性 Maestro 脚本)执行成本更低;只有面对长周期巡检、同模块批量回归或长期驻留的诊断 Agent 时,才适合开启运行时自编辑。
- 端侧小模型只消费现成 Harness,不负责自编辑:正如
gpt-5-mini在 AppWorld 上未能从自编辑中获益,如果移动端测试平台采用 4B–8B 级轻量 VLM 执行点击动作,不应让小模型直接修改 Harness 源码;更合理的分工是由强模型演化并固化工具与上下文策略,再交由轻量模型在冻结后的 Harness 下执行。
8. 局限性与专家点评
站在 Agent Harness 与 GUI Agent 系统工程视角,可以从以下三方面评估 Exo 的贡献与边界:
8.1 真正贡献:把 Harness RSI 从“离线搜索算法”转化为“运行时系统架构”
此前多数 Harness 演化工作聚焦于离线搜索算法设计。Exo 的核心推进在于将视角转向运行时系统架构:指出只要满足优化器对称性与操作同像性,优化循环就可以折叠进任务执行过程;同时通过 Exokernel 式的策略—机制分离(、只追加历史契约 、独立守卫者 ),给出了保障运行时自修改安全的系统原语,并用“特化成本(Specialization Cost)”量化了在线自改进的回本条件。
8.2 需要注意的局限性
- 默认 Guardian 仅检查构建成功(Build Success):在当前实现中,默认守卫者 仅验证候选代码能否通过编译构建。正如论文附录 A 与近期
Masked Erosion(arXiv:2610.38392)、Continual Harness Forgetting(arXiv:2611.03219)所指出的:构建成功既不保证任务正确性,也不保证安全护栏完好。如果 Agent 在运行中为了降低 Token 消耗而删改了必要的安全检查或边界校验,仅靠编译级 Guardian 无法拦截。 - 外部副作用无法通过沙箱快照回滚:作者在附录 A 说明,容器快照只能恢复沙箱内部状态(且 Docker 镜像快照不包含进程内存与宿主机挂载源码),无法撤销已经发往外部系统的副作用(例如已发出的外部通知、已修改的远端数据库记录或已执行的写操作)。
- 开放世界实验的单次样本量与环境波动:在 RuneScape 实验中(Table A1),由于单次运行长达 5–9 小时,每个配置仅包含单次 Standalone/Transfer 配对运行,且公共服务器存在真实玩家并发波动(导致 Transfer 阶段总耗时延长)。相比之下,AppWorld(3 Seeds,150 题)和 CLB(5 Runs)提供了更充分的多次运行统计证据。
8.3 可复现与工程落地建议
如果要将 Exo 的设计引入现有 Agent 运行时,可以按以下三步分阶段落地:
- 第一步(内部可读性与只追加账本):在现有 Agent 框架的事件流中记录每轮调用的
cost_usd、cached_tokens和耗时统计,并提供只读查询工具; - 第二步(受控工作区工具合成):开放类似
.exo/tool-sources/+manage_tool的受限工具注册接口,要求通过 JSON Schema Strict Mode 校验,让 Agent 能在长任务中将高频 Shell/API 组合封装为单步工具,暂不开放主循环源码编辑; - 第三步(策略层自编辑 + 强化 Guardian):挂载
SELF.md与策略层源码,配置带延迟脱钩的宿主机 Guardian,并在构建检查之外加入核心冒烟用例回归与关键安全规则静态检查。
9. 总结
近 7 天的 Harness RSI 研究显示,领域重心正在从静态基准上的离线搜索转向运行时自适应与持续演化治理。UC Berkeley、a16z 与 Braintrust 联合提出的 Exo 借鉴操作系统 Exokernel 的“策略与机制分离”原则,通过只追加历史账本、独立沙箱快照与宿主机 Guardian 激活门禁三项受保护机制,支持 Agent 在长周期任务运行过程中安全地修改自身工具集与上下文策略,在单次任务内收回前期的特化投入,并将学到的策略沉淀为可跨任务复用的显式代码。
10. 参考链接
- Exo 论文预印本:Exo: A Harness Architecture for Runtime Self-Improvement (
arXiv:2611.00463) - Exo 开源仓库与官方网站:
github.com/exoharness/exo·exoharness.ai - 近 7 天(2026.10.28—11.04)同批重要 Harness RSI 论文:
- Meta²: Precomputing Reusable Knowledge for Online Harness Evolution in Long-Horizon Agents (
arXiv:2611.05139) - Harness-S: Learning from Sibling Harnesses for Generalizable Agent Training (
arXiv:2611.04277) - Can Coding Agents Sustain Continual Evolution without Forgetting? (
arXiv:2611.03219) - ParetoSaddler: Pareto-Guided Optimization of Agent Harnesses for Quality and Cost (
arXiv:2611.02079) - RSI-Env: An Open-Ended Environment for Recursive Self-Improvement of Agents (
arXiv:2611.01736) - Latent Harness: Compiling Agent Behaviors into Post-Block Activation Shifts (
arXiv:2611.01415) - Masked Erosion: How Acceptance Gates Lose Redundant Safeguards in Self-Improving Agents (
arXiv:2610.38392)
- Meta²: Precomputing Reusable Knowledge for Online Harness Evolution in Long-Horizon Agents (
- 本站相关延伸阅读: