RSIHub 源码与论文拆解:把 Agent 演化策略装进受保护的评测与血统框架
结合 NeurIPS 2026 Meta-Agents Workshop 论文与 simple-agent-lab/RSIHub 源码,拆解 Select–Rollout–Analyze–Mutate–Guardrail–Evaluate–Absorb 七阶段循环、九类算子契约、三划分评测隔离与防篡改归档账本。
做 Agent 自我演化(Self-Improvement / Agent Evolution)实验时,各家方法改的对象其实不一样:有的只改系统提示词,有的改多文件 Skill,有的改整个 Agent Harness,还有的连“怎么修改 Agent 的元算子(Meta-Agent)”一起改。
麻烦的是,每换一种演化思路,研究者往往要重新搭一遍底层脚手架:怎么切分训练与测试任务、怎么拉起容器跑轨迹、怎么防止候选 Agent 顺手把评分脚本改了、断电中断后怎么恢复、每一代到底改了哪几个文件又拿了多少分。一旦各家方法把这套基建和自己的演化策略揉在一起,不仅复现费劲,横向对比也很难排除评测器和运行环境的干扰。
Simple Agent Lab 开源的 RSIHub(论文 RSIHub: A Composable Framework for Agent-Evolution Methods,已被 NeurIPS 2026 Meta-Agents Workshop 接收)试图解决的就是这个问题:把“怎么改 Agent 的演化策略”拆成可插拔的算子(Operator)和配方(Recipe),同时把“变异护栏、干净快照评测与血统账本”锁在框架受保护层里。 在不改动一行框架核心源码的前提下,作者在同一套评测契约下实例化并对比了 AHE、Hyperagents、A-Evolve 和 GEPA 四种代表性演化方法。
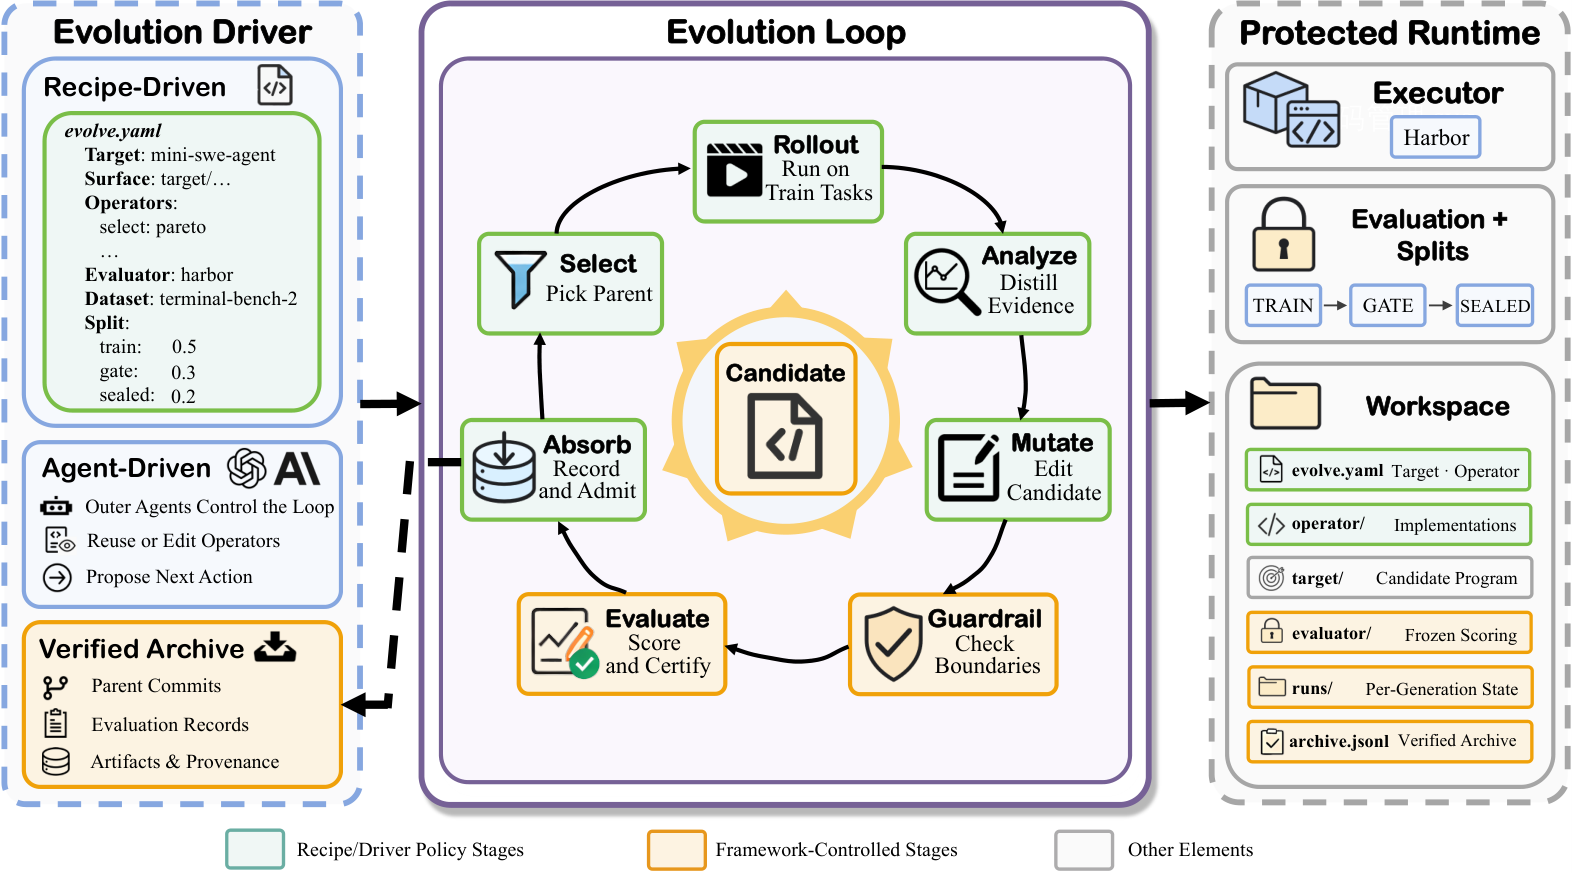

docs/assets/architecture.svg)。绿色框是 Recipe 控制的策略阶段,橙色框是框架独占的护栏与评测阶段。从图 1 可以直接看出 RSIHub 的核心边界:左侧是实验驱动入口(既可以由研究者编写静态 evolve.yaml,也可以由外层 Agent 在代际之间调整算子配置),中间是围绕候选程序运转的七阶段主循环,右侧则是受保护运行时(Protected Runtime)。策略可以决定怎么选父代、怎么看轨迹、怎么改代码;但改出来的文件有没有越界、打分环境干不干净、成绩怎么写进 archive.jsonl,全部由框架接管。
下文基于 simple-agent-lab/RSIHub 的 d655429 提交(对应包版本 0.1.0)和论文 arXiv:2610.32253v1 展开,代码与测试核查时间为 2026 年 10 月 29 日。
1. 先看一个直观案例:把 12 行的最小 Skill 演化成可过检的海报生成器
在进入源码细节前,先看仓库自带的一个本地演化案例(evals/skills/make-paper-poster/)。任务是让同一个 Codex 模型根据论文内容生成学术海报 SVG。评测器设定了两道硬性确定性门槛(Hard Gates):SVG 必须自包含可渲染(renderable_self_contained_svg),且不能出现文字裁切、重叠或越出画布边界(geometry_integrity);版式美观度与论文还原度则作为评审的建议性文字反馈留给变异阶段。
初始种子(Gen 0)只有一个 12 行的最小 SKILL.md:只规定了页面尺寸和字体,没有任何排版计算或自检脚本。跑完 LoRA、Attention、CLIP、Segment Anything 四篇论文后,Gen 0 在 3 篇上触发了文字越界,通过率只有 1/4。经过两代演化(Gen 2),Skill 包把指令、参考布局和校验脚本一起补齐,四篇论文的确定性门控通过率达到 4/4。记录快照见 docs/results/paper-poster-skill-evolution.json。
| Gen 0 · 仅 12 行的初始种子 Skill | Gen 2 · 演化后的编排型 Skill |
|---|---|
 |  |
硬门控失败:14 个文本元素溢出 SVG viewBox(reward: 0.0)。 | 硬门控通过:通过可渲染性与几何边界检查(reward: 1.0)。 |
图 2:仓库中的 Paper2Poster Skill 演化对比。左图来源:docs/assets/paper-poster-lora-gen0.png;右图来源:docs/assets/paper-poster-lora-gen2.png。


这个例子能帮我们建立对 RSIHub 的第一层直觉:演化的对象是一棵受 Git 追踪的文件树(这里是一个完整的 Skill 目录),而决定它能不能留存的,是目录外面那个冻结的评测器。
2. 试金石原则:什么必须冻结,什么允许演化?
一旦允许 Agent 修改代码,甚至修改演化算子本身(比如 Hyperagents),系统最容易掉进的坑就是“刷分(Reward Hacking)”——候选程序哪怕不直接改分数,只要顺手改一下评测脚本的超时判定、放宽测试集过滤条件,或者往归档文件里塞一条伪造的高分记录,实验结论就失效了。
src/evolve/frozen/__init__.py 在文件开头的 docstring 里写明了一条非常干脆的试金石(Litmus Test):
"""FROZEN — the irreducible immutable core that keeps the fitness signal honest.

Litmus test for what belongs here: *if evolution rewrote this to cheat, would a
score become a lie?* If yes, it is frozen. Everything else — including the
evolution logic itself (the operators) — is evolvable.
"""
按照这条标准,RSIHub 把不可变核心放在两个物理位置:
- 机制侧冻结环(
src/evolve/frozen/):在工作区初始化时被 vendor 进.evolve/,负责定义算子抽象基类、返回载荷校验、声明式配置 Schema 以及 SDK 通信契约。 - 实验侧冻结区(
<workspace>/evaluator/与archive.jsonl):保存当前实验的评测器、数据集划分清单splits.json以及带哈希收据的归档记录。
初始化一个实验工作区后,目录边界切得很清楚(见 docs/concepts/design.md):
<workspace>/
├─ target/                  # 候选 Agent(提示词、Skill、Harness 源码)
├─ operators/               # 当前 Recipe 选定并冻结的算子脚本
├─ library/                 # 算子依赖的运行时辅助模块
├─ evaluator/               # 冻结评测器、runtime.pin 与 splits.json
├─ .evolve/                 # Vendored 框架核心与启动器
├─ evolve.yaml              # 归一化后的实验配置与 surface 声明
├─ archive.jsonl            # 只追加的代际演化账本
└─ .evolve-eval-receipts.jsonl # 框架评测事件的 SHA-256 防篡改收据与此同时,src/evolve/surface.py 写死了四条隐式排除规则 IMPLICIT_EXCLUDES:
IMPLICIT_EXCLUDES = ("evaluator/**", "archive.jsonl", ".evolve/**", "evolve")无论 Recipe 的 surface.include 写得多宽(哪怕写成 ["**"]),只要候选修改触碰到了 evaluator/**、archive.jsonl 或 .evolve/**,check_paths() 都会直接判定越界并拒绝提交。
这套架构约束不是写在文档里靠自觉遵守的。docs/ARCHITECTURE.md 登记了 src/evolve/ 下全部 80 多个源码模块的单文件行数预算(总预算 27,290 行)与依赖方向,并由 tests/test_coherence.py 在 CI 中强制检查:新增未登记模块、模块超出行数上限、在 src/ 下遗留测试桩(EVOLVE_FAKE_*),或者在 archive.py 之外重复定义 STAMPED_FIELDS,测试都会直接报错。
3. 七个阶段与九个算子槽位:主循环是怎么转起来的
在 README 和论文里,同时出现了 7 个阶段(Phases) 和 9 个算子槽位(Stages) 两组词。对照 src/evolve/frozen/interfaces.py 和 src/evolve/driver.py 来看,它们的关系其实很清楚:7 个 Phase 描述的是一次代际事务(Candidate Transaction)的生命周期,其中有 3 个 Phase 内部挂载了不止一个算子槽位,而 evaluate 阶段不挂载任何外部算子。
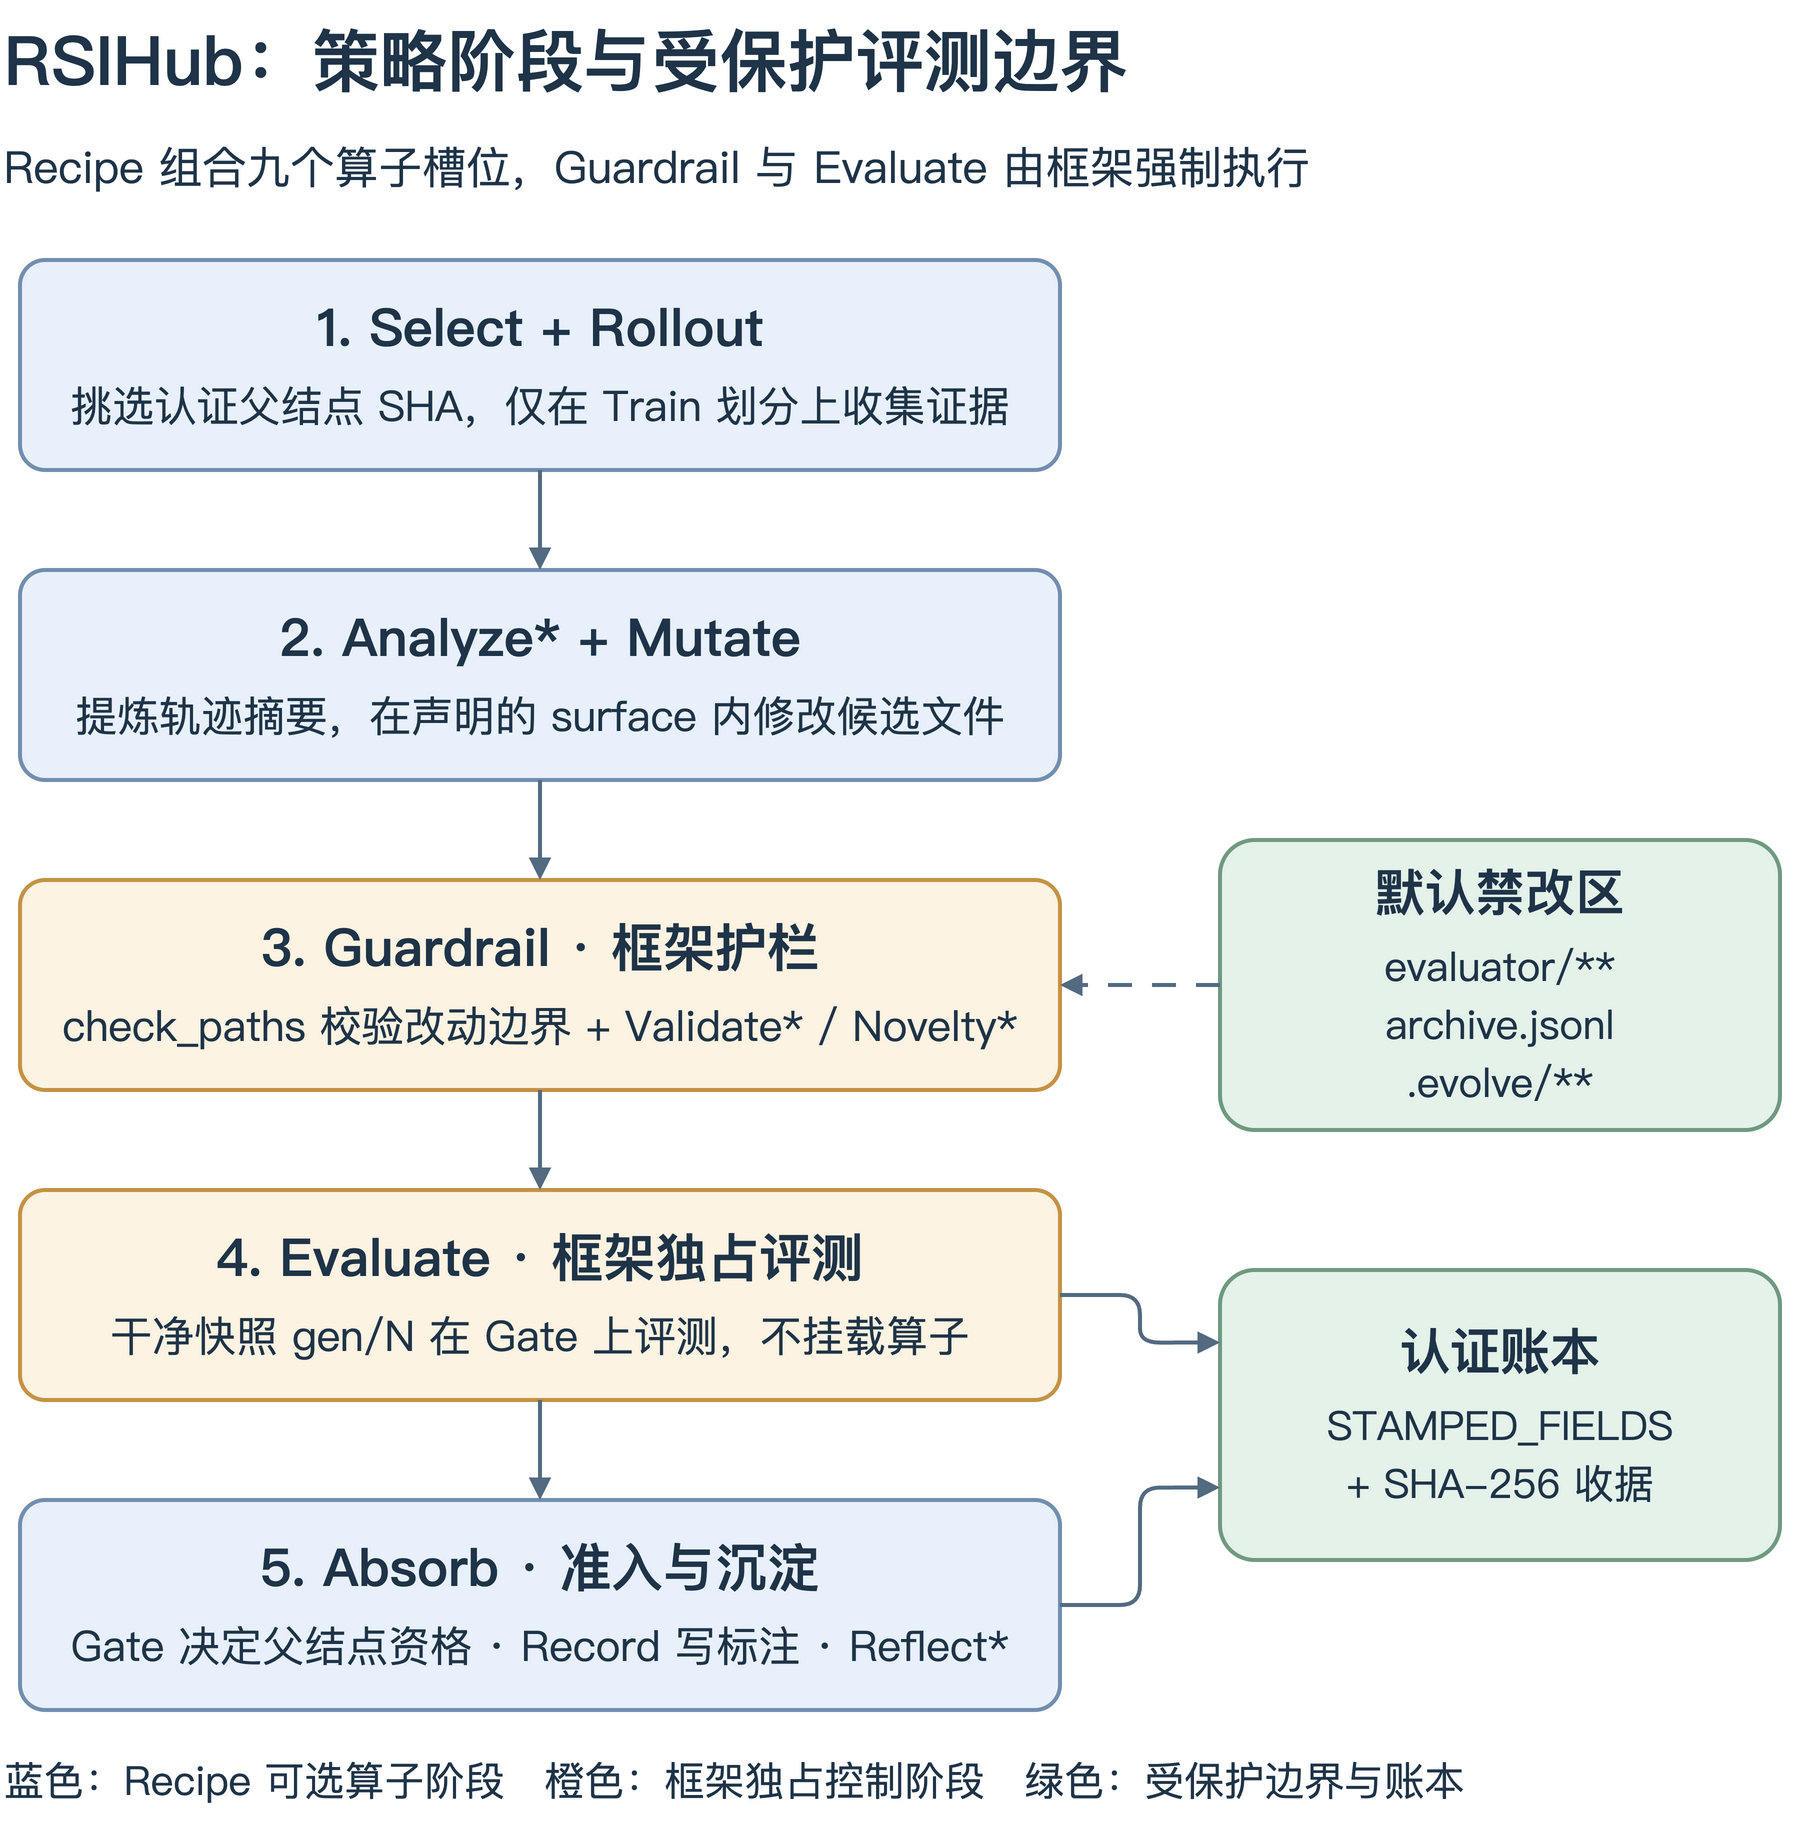
driver.py 与 interfaces.py 整理的代际执行主链路。蓝色阶段由 Recipe 配置的算子执行,橙色阶段由框架强制控制,绿色部分为不可越界的保护区与认证账本。src/evolve/frozen/interfaces.py 中的 OPERATORS 注册表是全仓唯一的算子契约权威来源,一共定义了 5 个必选槽位和 4 个可选槽位(标 *):
OPERATORS: tuple[OperatorSpec, ...] = (
    OperatorSpec("select", SelectOperator, SelectResult, "pick", True),
    OperatorSpec("rollout", RolloutOperator, RolloutResult, "rollout", True),
    OperatorSpec("analyze", AnalyzeOperator, AnalyzeResult, "analyze", False),
    OperatorSpec("mutate", MutateOperator, MutateResult, "mutate", True),
    OperatorSpec("validate", ValidateOperator, ValidateResult, "validate", False),
    OperatorSpec("novelty", NoveltyOperator, NoveltyResult, "assess", False),
    OperatorSpec("gate", GateOperator, GateResult, "decide", True),
    OperatorSpec("record", RecordOperator, RecordResult, "annotate", True),
    OperatorSpec("reflect", ReflectOperator, ReflectResult, "reflect", False),
)
把这 9 个槽位放进 driver.py 的 _run_child()(对应论文 Algorithm 1 的 EvolveOne),就能看清每一代候选从检出到入库的完整动作:
3.1 子进程隔离:框架绝不在进程内 import 算子
在看具体阶段前,先注意一个关键实现细节:src/evolve/operators.py 中的 run_operator() 永远通过 subprocess.Popen 启动独立子进程来运行 operators/<name>.py,并通过环境变量(EVOLVE_GENID、EVOLVE_RUN_DIR、EVOLVE_WORKSPACE 等)和 --config 传递 JSON 参数。
这样设计有两个工程收益:一是算子崩溃、超时(TimeoutExpired)或内存泄漏不会拖垮主驱动进程,驱动器可以直接捕获非零退出码并记一笔 operator_failed;二是在 Hyperagents 这类允许修改 operators/** 的实验里,每一阶段都能精确从指定检出目录(source_checkout)加载对应版本的算子脚本,不会受到 Python sys.modules 进程内缓存的污染。
3.2 从 select 到 guardrail:在未提交的工作树上提案与拦截
select(挑选父代):读取ArchiveView.valid_parents(),按策略返回合格父代 ID。随后fork_child()检出父代建立独立 Git worktree。注意driver.py里的注释特意强调:检出时使用的是认证评测记录里的精确parent_commitSHA,而不是可变的 tag 名,防止 tag 被移动导致代码与分数错位。rollout与analyze*(收集与提炼证据):rollout在train划分上执行父代(或像parent_evaluation算子那样直接复用父代已有的训练评测记录),analyze将长轨迹压缩成故障模式、分类摘要或待修组件卡片。在进入mutate之前,驱动器调用write_feedback_bundle()把可公开给变异器的证据打包。mutate(执行修改):通常由容器内的 Codex 或 MiniSWE 变异 Agent 多轮运行,在工作树上直接修改target/**(或包含operators/**),输出改动路径列表、修改说明和开销统计。guardrail(框架护栏 +validate*+novelty*):这是候选被提交进 Git 之前的最后一道关卡。driver.py先对比工作树相对parent_commit的真实文件 diff:
mutated_paths = working_tree_changed_paths(child, parent_commit)
if not mutated_paths:
    _append_candidate_rejected(..., status="no_proposal", reason="no changes to commit")
    return
include, exclude = surface_patterns(workspace)
violations = check_paths(mutated_paths, include, exclude)
if violations:
    _append_candidate_rejected(..., status="invalid_proposal", violations=violations)
    return
注意它检查的是 Git 工作树的实际改动(working_tree_changed_paths),而不是轻信 mutate 算子自己上报的 changed 列表。通过表面边界检查后,如果 Recipe 配置了 validate(例如语法检查,或 GEPA 的小批量样本改进验证 minibatch_improvement)和 novelty(例如 diff_similarity 过滤掉与历史改动近似重复的提案),它们会依次在这棵未提交的工作树上运行。任何一步拒绝,当前代直接以 rejected_validation 或 rejected_duplicate 结案,省下昂贵的正式评测预算。
3.3 evaluate 与 absorb:干净快照评测与准入分离
通过护栏后,commit_child() 使用临时 Git 索引文件构造快照、提交 commit 并打上 gen/<id> 标签(见 src/evolve/candidate/snapshot.py)。接着进入框架独占的 evaluate()(见 src/evolve/evaluation/execution.py):
candidate_commit = git_stdout(workspace, "rev-parse", f"{tag}^{{commit}}")
evaluator_fingerprint = evaluator_tree(workspace, tag)
if evaluator_fingerprint != evaluator_tree(workspace, "gen/0"):
    raise RuntimeError(f"evaluator tree for {tag} differs from gen/0")
这里做了两件很严密的事:第一,再次断言当前标签下的 evaluator/ Git tree 哈希与初始 gen/0 完全一致;第二,在 runs/evaluation-worktrees/ 下新建一个与变异工作树完全隔离的干净 checkout,在上面运行 Harbor 评测。
评测拿到 benchmark_complete 结果后,才进入 absorb 阶段:
gate:根据认证后的分数决定该候选能否成为后续代际的合法父结点(输出verdict: "keep" | "discard"与valid_parent: bool)。record:补充实验方法自定义的备注字段(如note、predicted_fixes)。reflect*:读取更新后的归档历史,往独立的 Playbook 追加跨代经验条目(如reflect/credit),且即使失败也不会回滚已记录的代际结果。
还有一个很关键的细节:当 operators/** 本身处于可修改范围时,到底运行哪个版本的算子? 从 _run_child() 与 _run_gate_and_record() 可以确认:在 commit_child() 之前,算子从子代工作树加载,因此如果 mutate 修改了 validate 或 novelty,当轮就会生效;而 gate 和 record 则是从已提交的 gen/<id> 快照中检出运行;至于对 select、rollout、analyze、mutate 的修改,则要等到该候选通过 gate 并在后续代际被选为父结点时才会生效。
4. 三层数据划分与防篡改账本:如何防止过拟合与改分?
很多演化实验跑着跑着就会变成“针对测试集调参”:变异 Agent 看多了某几道题的报错日志,写出一堆只对这几道题生效的特判规则,整体跑分上去了,换一批同分布的新题却不升反降。同时,如果外部脚本或算子直接手改 archive.jsonl,还会污染种群选择。
RSIHub 用 Train / Gate / Sealed 三层数据划分 和 带收据的归档判定谓词 来应对这两个问题。
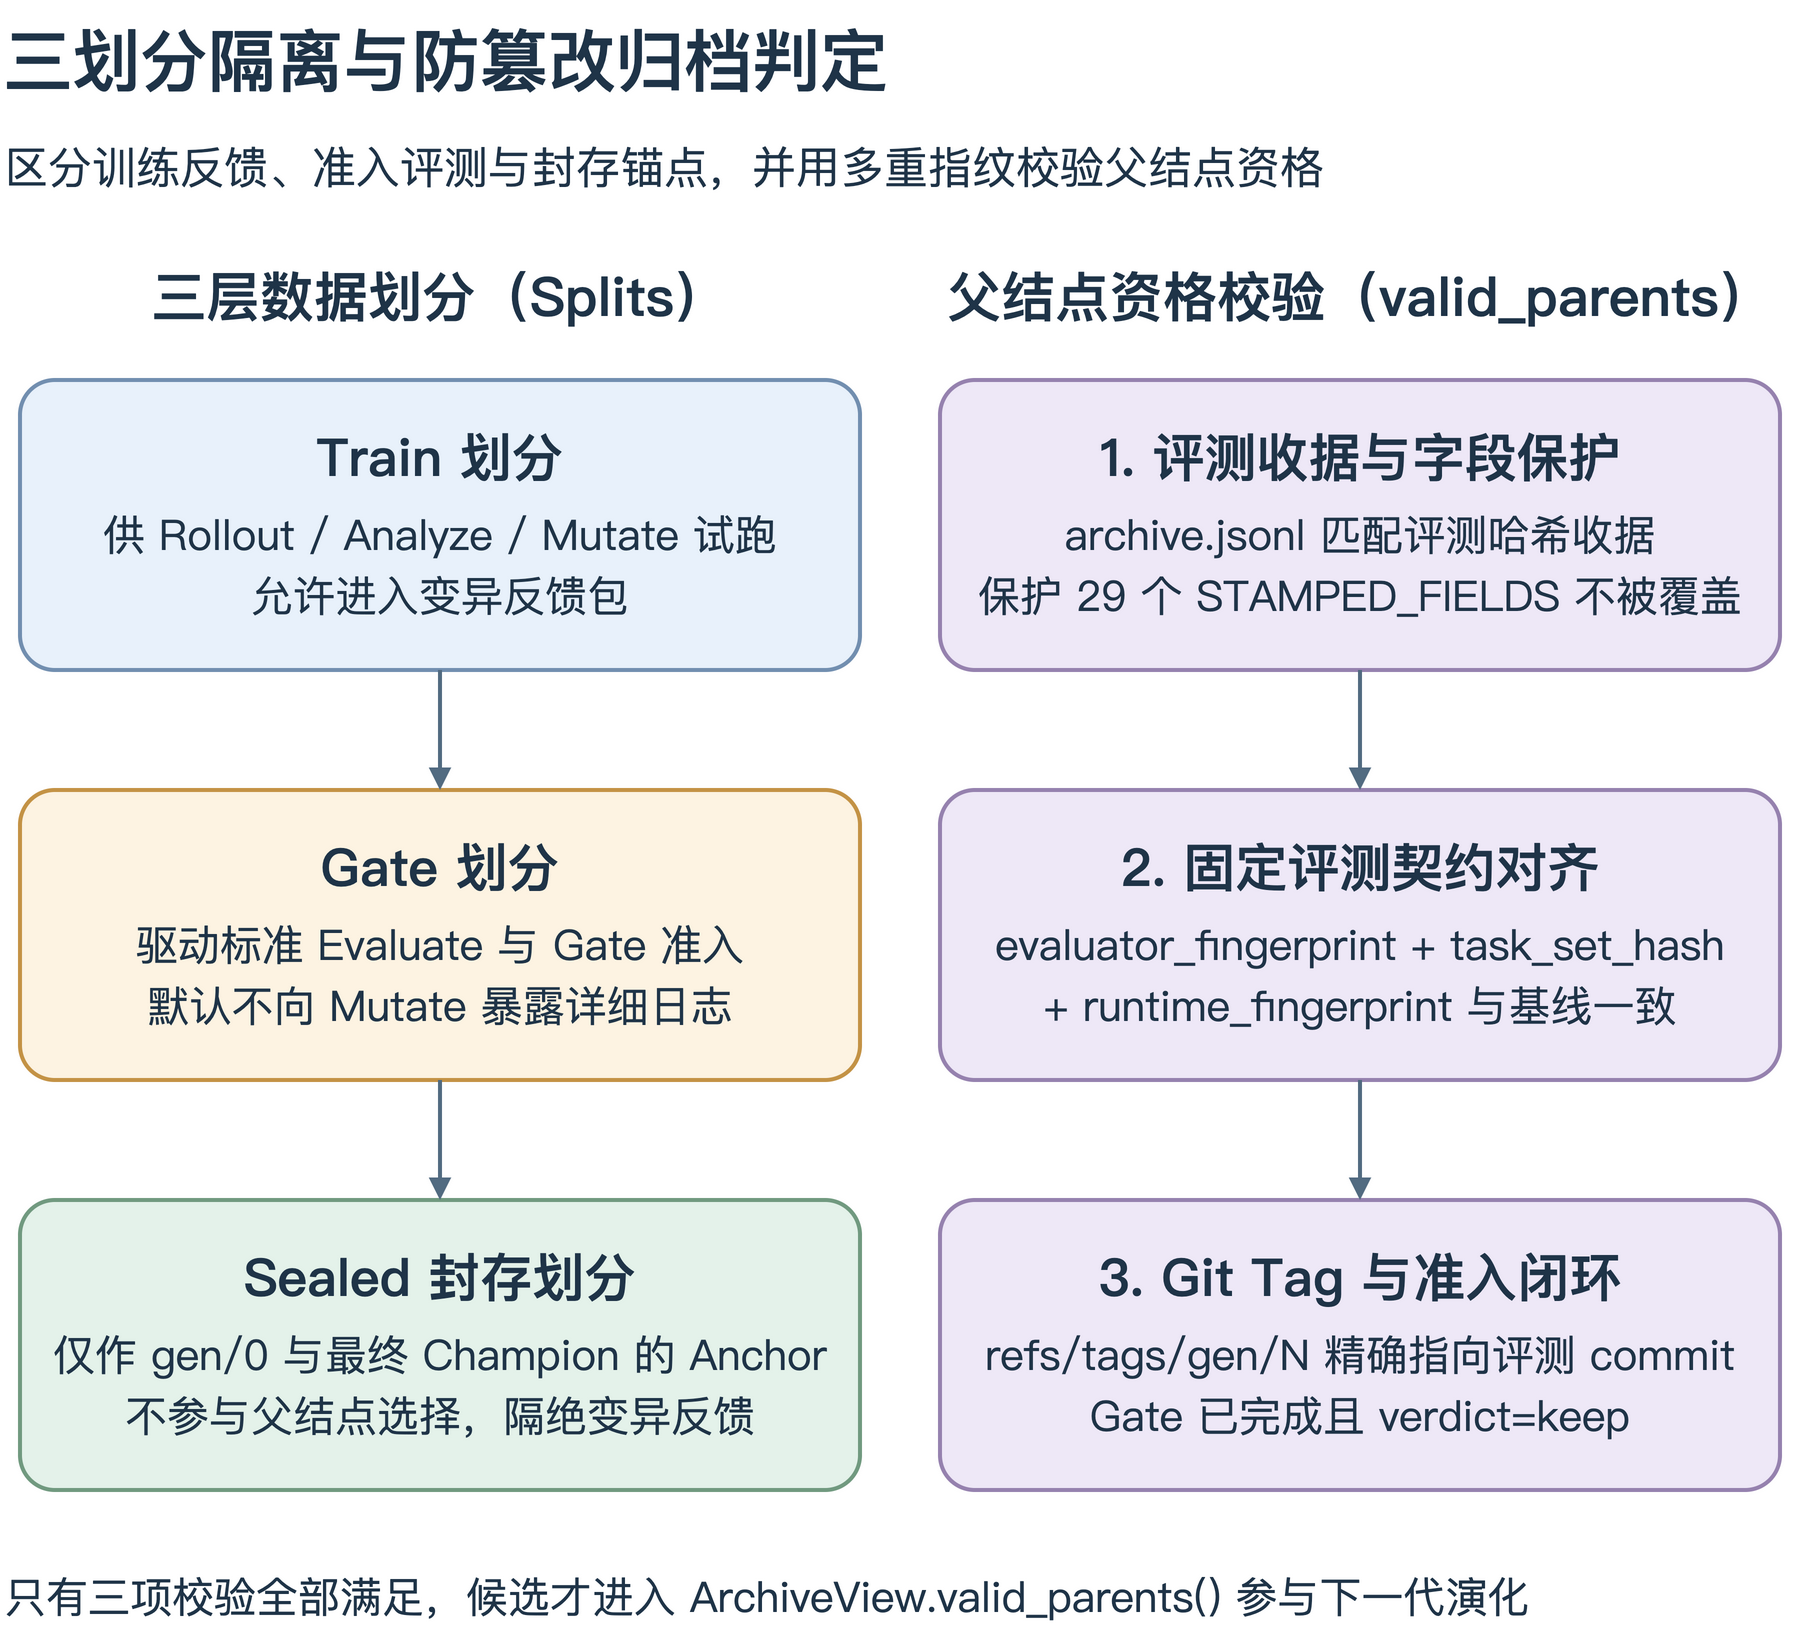
splits.py、archive.py 与 population.py 整理的划分隔离与父结点资格判定图。4.1 Train / Gate / Sealed 各自对谁可见?
在 evolve init 阶段,src/evolve/splits.py 会把数据集按固定比例和随机种子切分成三个互不重叠的集合,并把每个任务目录的文件路径、字节内容、文件类型和权限计算成确定性 SHA-256 摘要写进 evaluator/splits.json:
train(训练划分):供rollout、analyze和mutate阶段试跑并提取轨迹证据。变异反馈包只允许投影训练角色的数据。gate(门控划分):用于正式的evaluate阶段打分,决定候选能否通过gate算子准入成为父结点。默认配置下(expose_gate_data: false),Gate 任务的详细验证日志不会暴露给mutate算子。sealed(封存划分):留出用于最终泛化报告的保留集。在evolve run启动时,框架会先在gen/0上跑一次sealed评测作为基准锚点(Anchor);在全部代际跑完后,若anchor.final: true,再对最终胜出的 Champion 跑一次sealed评测。
查看 driver.py 的 _maybe_final_anchor() 可以看到,Sealed 评测写入归档时被标记为 purpose="anchor"、kind="anchor",并由 archive.py 合并到辅助字段 evals["anchor:<hash>"] 下,既不进入 mutate 的反馈包,也永远不会通过 is_parent_record() 成为可选父代。
4.2 29 个盖章字段与 .evolve-eval-receipts.jsonl
为什么说算子或人工手改 archive.jsonl 没法欺骗 RSIHub?答案在 src/evolve/archive.py 与 src/evolve/population.py 里。
首先,archive.py 定义了 29 个受保护的盖章字段 STAMPED_FIELDS(包括 score、outcome、trials、task_vector、evaluator_fingerprint、task_set_hash、contract_id、candidate_commit 等)。只有框架自己的 append_evaluation_record() 会打上内部标记 _evolve_mechanism_eval: True,并在写入 archive.jsonl 的同时,把整条 JSON 事件的 SHA-256 哈希写入同目录的 .evolve-eval-receipts.jsonl,同时在 ~/.evolve/mirrors/ 下维护一份镜像。
当后续阶段或 record 算子追加事件时,_merge_event_fields() 会拦截对已存在 STAMPED_FIELDS 的覆盖;而 driver.py 中的 _strip_record_fields() 只允许 record 算子写入白名单内的辅助标注字段(note、predicted_fixes、verified_fixes)。
更重要的是,下一代 select 调用 ArchiveView.valid_parents() 时,population.py 的 is_parent_record() 会同时校验 10 项条件:
def is_parent_record(row: dict[str, Any], expected: dict[str, str], workspace: Path | None = None) -> bool:
    score = row.get("score")
    return (
        workspace is not None
        and row.get("outcome") == "benchmark_complete"
        and row.get("purpose") in {"candidate", "genesis"}
        and row.get("selection_eligible") is True
        and row.get("pending_gate_record") is False
        and row.get("valid_parent") is True
        and row.get("verdict") == "keep"
        and row.get(RECEIPT_CERTIFIED_FIELD) is True
        and all(row.get(field) == value for field, value in expected.items())
        and isinstance(score, (int, float))
        and not isinstance(score, bool)
        and math.isfinite(float(score))
        and tag_matches_candidate(workspace, row)
    )
这里面有三重硬约束:
- 收据匹配(
RECEIPT_CERTIFIED_FIELD):事件在合并时必须能在.evolve-eval-receipts.jsonl中找到对应的 SHA-256 收据;手工往archive.jsonl塞一行高分记录,因为没有匹配收据(或修改分数破坏了哈希),合并时拿不到认证标记。 - 评测契约一致(
expected):候选记录的evaluator_fingerprint、task_set_hash和runtime_fingerprint必须与基线完全一致。中途偷改数据集或运行环境,旧分数和新分数无法混选。 - Git 标签对齐(
tag_matches_candidate):调用git rev-parse refs/tags/gen/<id>^{commit}检查当前 Git 仓库里的标签是否仍然指向记录中的candidate_commit。如果有人事后移动了 Git tag,该候选立即失去父代资格。
5. 四种演化方法如何用同一套算子拼装出来?
有了前面这套固定的阶段槽位,我们就能看懂 RSIHub 是怎么在不改框架源码的前提下,把四篇代表性论文的方法写成声明式 YAML 配方的。
我们可以直接在本地运行 RSIHub 的 CLI 检查工具,验证内置算子库和四个核心 Recipe:
$ evolve operator list
analyze/ahe
analyze/artifact_rubric
analyze/failure_patterns
analyze/gepa
analyze/trace_browser
analyze/trajectory_only
gate/ahe_artifact_valid
gate/hillclimb
gate/parent_eligible
mutate/aevolve
mutate/ahe
mutate/gepa
mutate/hyperagents
novelty/accept_all
novelty/diff_similarity
record/gepa
record/hyperagents
record/jsonl
reflect/credit
rollout/failure_focused
rollout/harbor
rollout/noop
rollout/parent_evaluation
select/ahe_latest
select/greedy
select/newest
select/pareto
select/random
select/score_child_prop
select/score_weighted
validate/hyperagents
validate/minibatch_improvement
validate/node_check

$ for r in ahe hyperagents aevolve gepa; do evolve recipe check recipes/$r/evolve.yaml; done
recipe check: valid (6 operators)
recipe check: valid (7 operators)
recipe check: valid (6 operators)
recipe check: valid (7 operators)
对比 recipes/ 下四个核心目录的 evolve.yaml 和论文 Table 6(接入工程量统计),它们的差异全部落在了 surface.include 和各阶段绑定的算子名上:
| 方法 Recipe | 可修改范围 surface.include | select 算子 | rollout 算子 | analyze 算子 | mutate 算子 | validate 算子 | gate 算子 | Recipe 行数 / 新增算子代码行数 |
|---|---|---|---|---|---|---|---|---|
ahe | target/** | ahe_latest | parent_evaluation | ahe(并发 Debugger 诊断) | ahe | — | ahe_artifact_valid | 47 行 / 1,087 行 |
hyperagents | target/**, operators/** | score_child_prop | parent_evaluation | trace_browser | hyperagents | hyperagents | parent_eligible | 48 行 / 216 行 |
aevolve | target/**(仅演化 prompt 与 skills) | greedy | harbor(子集抽样) | trajectory_only | aevolve | — | hillclimb(严格提升) | 57 行 / 684 行 |
gepa | target/**(轮询组件) | pareto | harbor(每代混洗) | gepa | gepa(round_robin) | minibatch_improvement | parent_eligible | 61 行 / 745 行 |
这张表把四种方法的实质区别摆得很清楚:
- AHE(Agentic Harness Engineering) 重在“可观测性诊断”:它的
rollout直接复用父代评测结果(parent_evaluation),但在analyze阶段启动最多 10 并发的 Debugger Agent 深入排查失败任务,生成结构化诊断报告再交给mutate修改整个target/**;因此它的新算子代码最多(1,087 行),但复用了框架的评测与归档。 - Hyperagents 的特点是“元演化(Meta-Evolution)”:它的
surface.include同时打开了target/**和operators/**,允许变异 Agent 一边改目标 Agent,一边修改工作区里的演化算子脚本,并通过score_child_prop综合考虑节点分数与后代繁衍情况来挑选父代。 - A-Evolve 走的是“严格爬山 + 面向持久状态”路线:用
greedy选当前最高分父代,mutate只改提示词与target/skills,gate使用hillclimb(strict=True)要求子代分数严格高于父代才准入。 - GEPA 则强调“多目标帕累托前沿 + 小批量预筛”:
select用pareto从非支配解集中采样,mutate按round_robin轮流修改system_prompt和task_execution_skill,并且在正式进evaluate之前,先用validate/minibatch_improvement在小批量样本上做严格检验,没提升就直接拦截。
这四个方法在接入 RSIHub 时,对框架核心源码的修改均为 0 个文件(Framework files changed = 0),各自只写了 47~61 行 YAML 配置并复用了已有算子。如果你想做一个控制变量消融实验——比如看“把 A-Evolve 的 greedy 父代选择换成 GEPA 的 pareto 会怎样”——只需要改一行 evolve.yaml 的 operators.select,底层容器执行、任务划分和评分账本完全保持不变。
6. 实验查看器与外层 Agent 驱动模式
除了命令行跑批,RSIHub 还提供了两个实用的工程能力:evolve view 只读实验查看器,以及 evolve agent 外层 Agent 驱动模式。
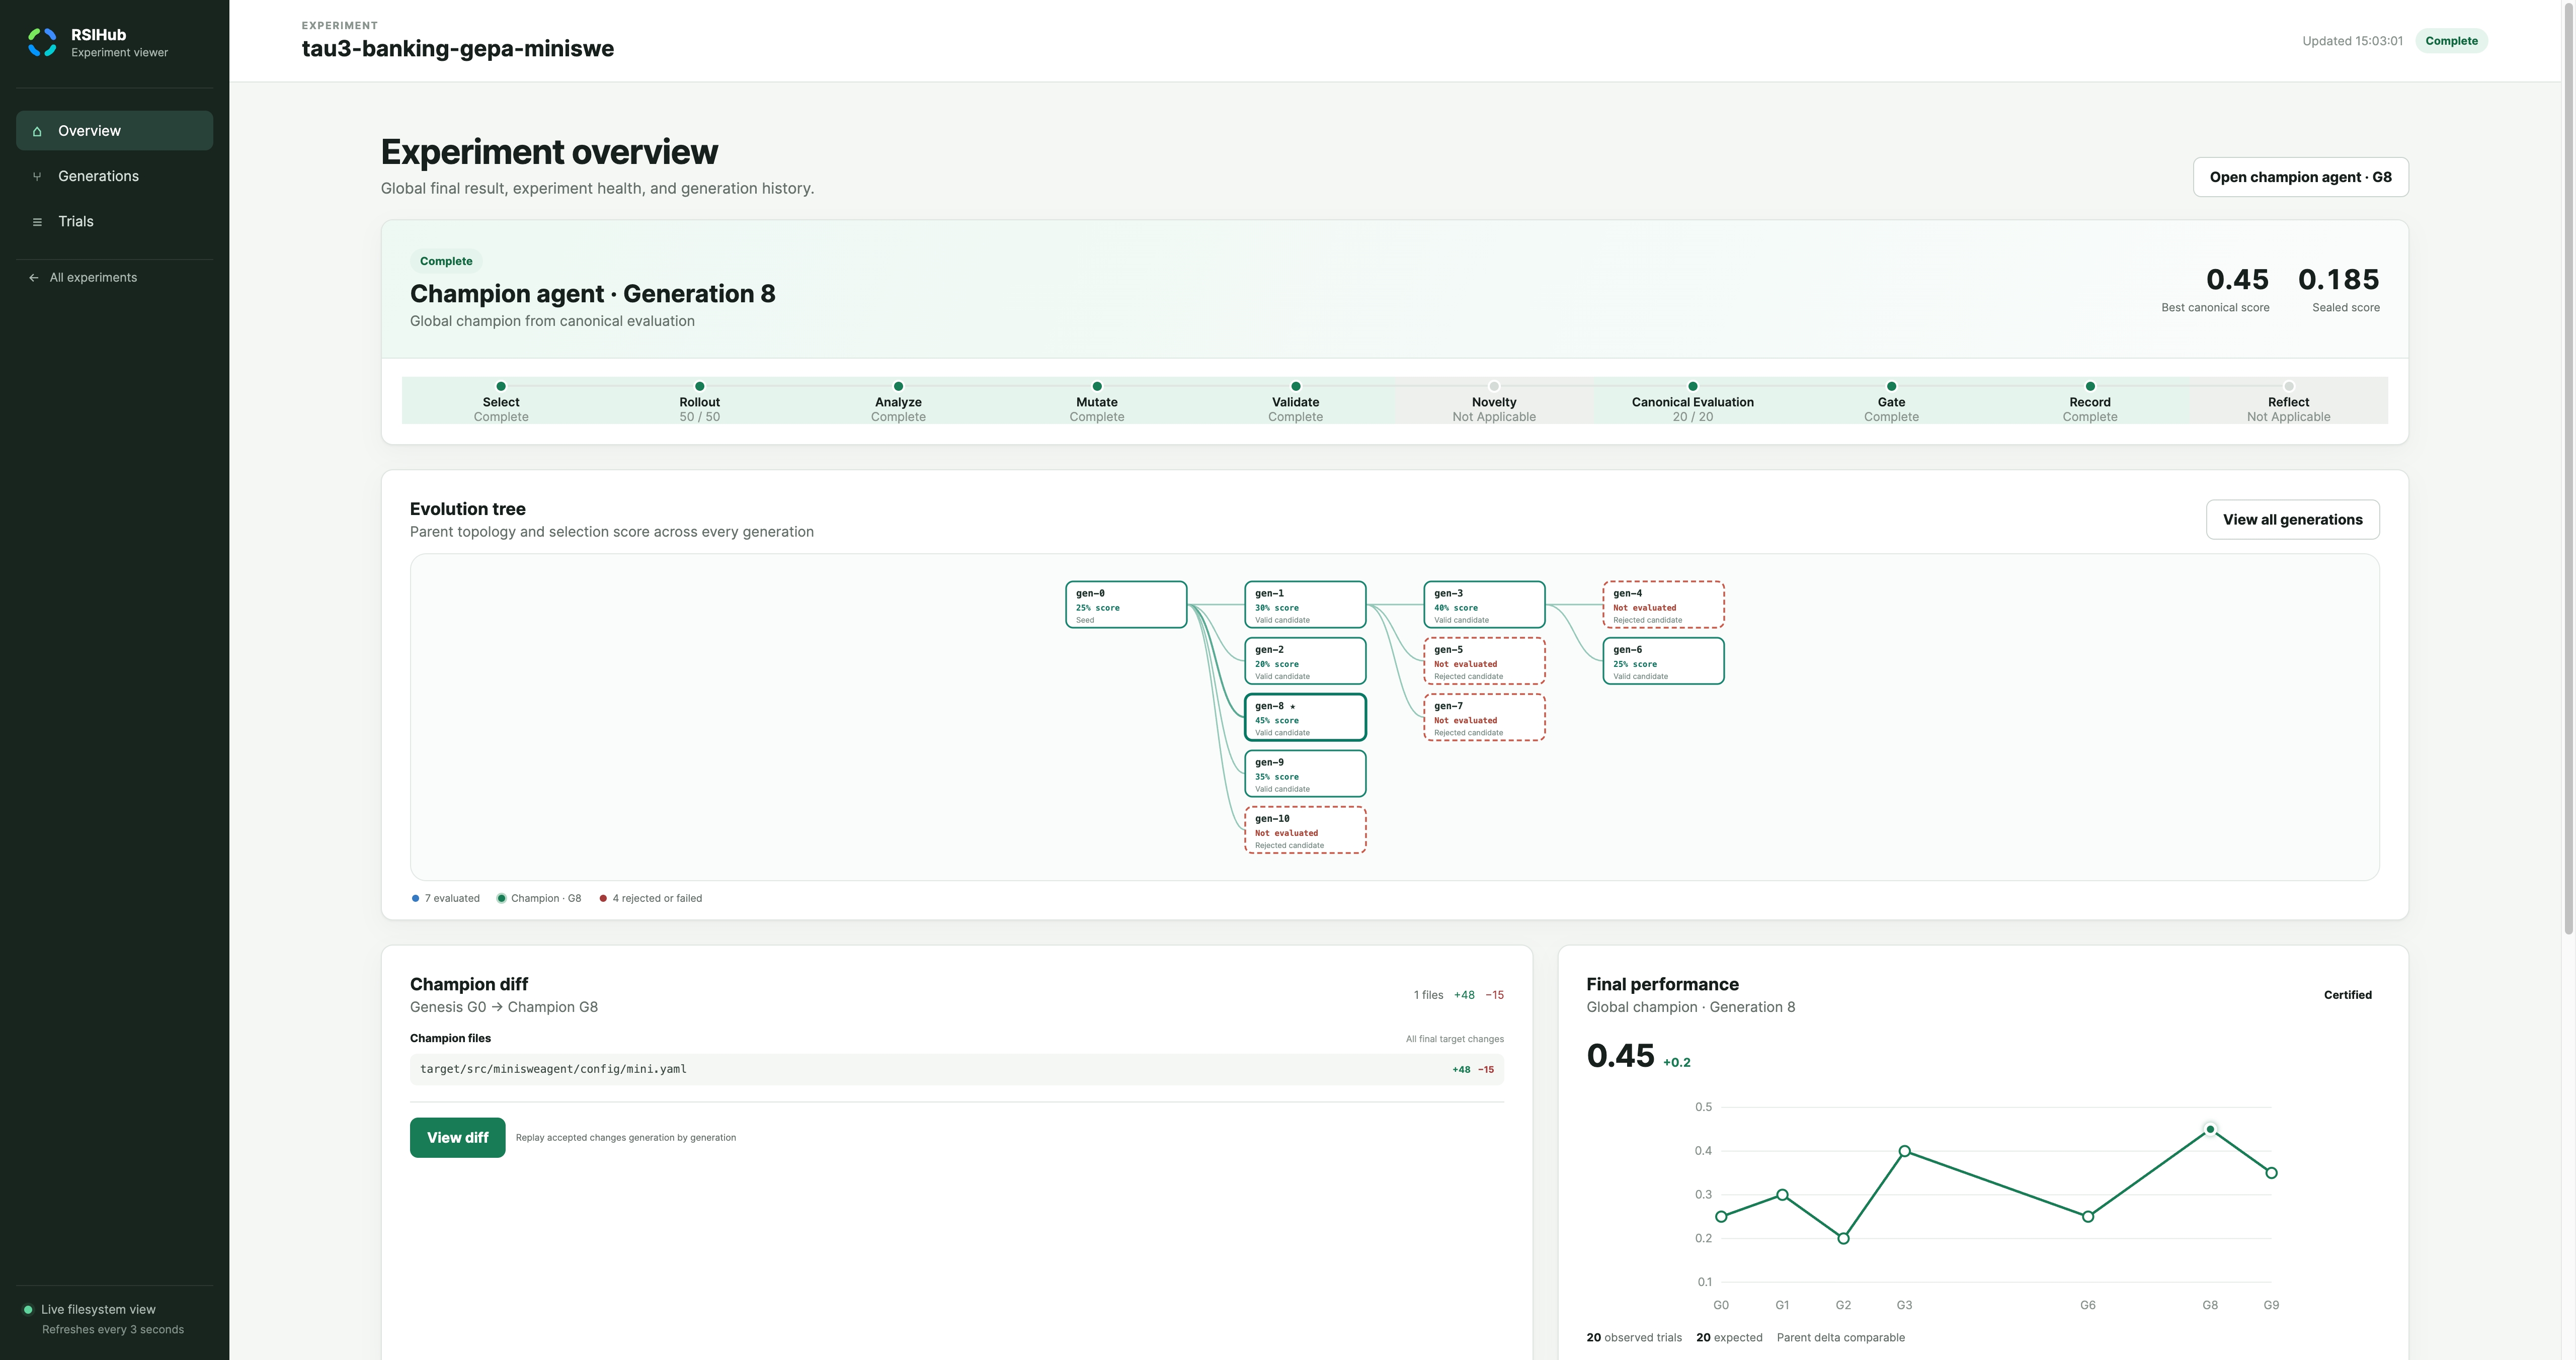
evolve view 只读实验查看器。来源:arXiv:2610.32253v1 Figure 2。如图 5 所示,在实验运行期间或结束后执行 evolve view /path/to/experiment,本地服务会读取 archive.jsonl、阶段产物和 Harbor 轨迹目录(源码位于 src/evolve/viewer/):
- 顶部状态栏显示当前全局 Champion(图中为 Generation 8,主划分得分
0.45,封存划分得分0.185)以及当前代际在 9 个阶段槽位上的完成进度。 - 中间 Evolution tree 展示完整的种群分支拓扑:绿框实线是完成评测的合法父代(如
gen-0分出了gen-1、gen-2、gen-8、gen-9),红框虚线则是被validate或护栏提前拦截、未进入正式评测的候选(如gen-4、gen-5、gen-7、gen-10显示Not evaluated / Rejected candidate)。这直接印证了前文 3.2 节中 Guardrail 提前省下评测预算的机制。 - 底部面板对比 Champion 相对初始种子
G0的累计代码改动(图中仅修改了target/src/minisweagent/config/mini.yaml的+48 -15行),右侧绘制各代认证得分曲线。
而在 Agent-Driven 模式(src/evolve/agent_driver.py)下,外层研究 Agent 可以通过 evolve agent 持续会话来操控实验:它先用 evolve agent prepare 认证初始开发基线,然后在每一代结束后根据公开反馈(src/evolve/public_feedback.py 过滤掉了私有评测器日志与 sealed 数据)调整下一代的算子绑定或超参数。在研究会话结束前,sealed 集始终不参与中间候选的筛选;直到外层 Agent 显式结束研究并提交最终候选时,框架才在同一个冻结 sealed 划分上对初始基线和最终候选做一次性验收对比。
7. 论文实验结果:哪些方法有效,哪些提升没能泛化?
作者在两个基准集上测试了上述四种演化 Recipe(每种方法最多演化 10 代,每代 1 个子代):
- Terminal-Bench 2:共 89 个真实命令行任务,划分为 50 train / 19 gate / 20 sealed。
- Banking:来自 -Knowledge 的银行领域知识对话与工具操作基准,共 97 个任务,划分为 50 train / 20 gate / 27 sealed。
- 种子 Agent 与模型配置:测试了 MiniSWE(2.4.5)和 Codex(0.143.0)两个起始 Agent;所有实验统一使用 GPT-5.4(high reasoning effort) 作为目标 Agent 模型,使用 GPT-5.4(xhigh reasoning effort) 驱动的 Codex 作为
mutate变异模型。
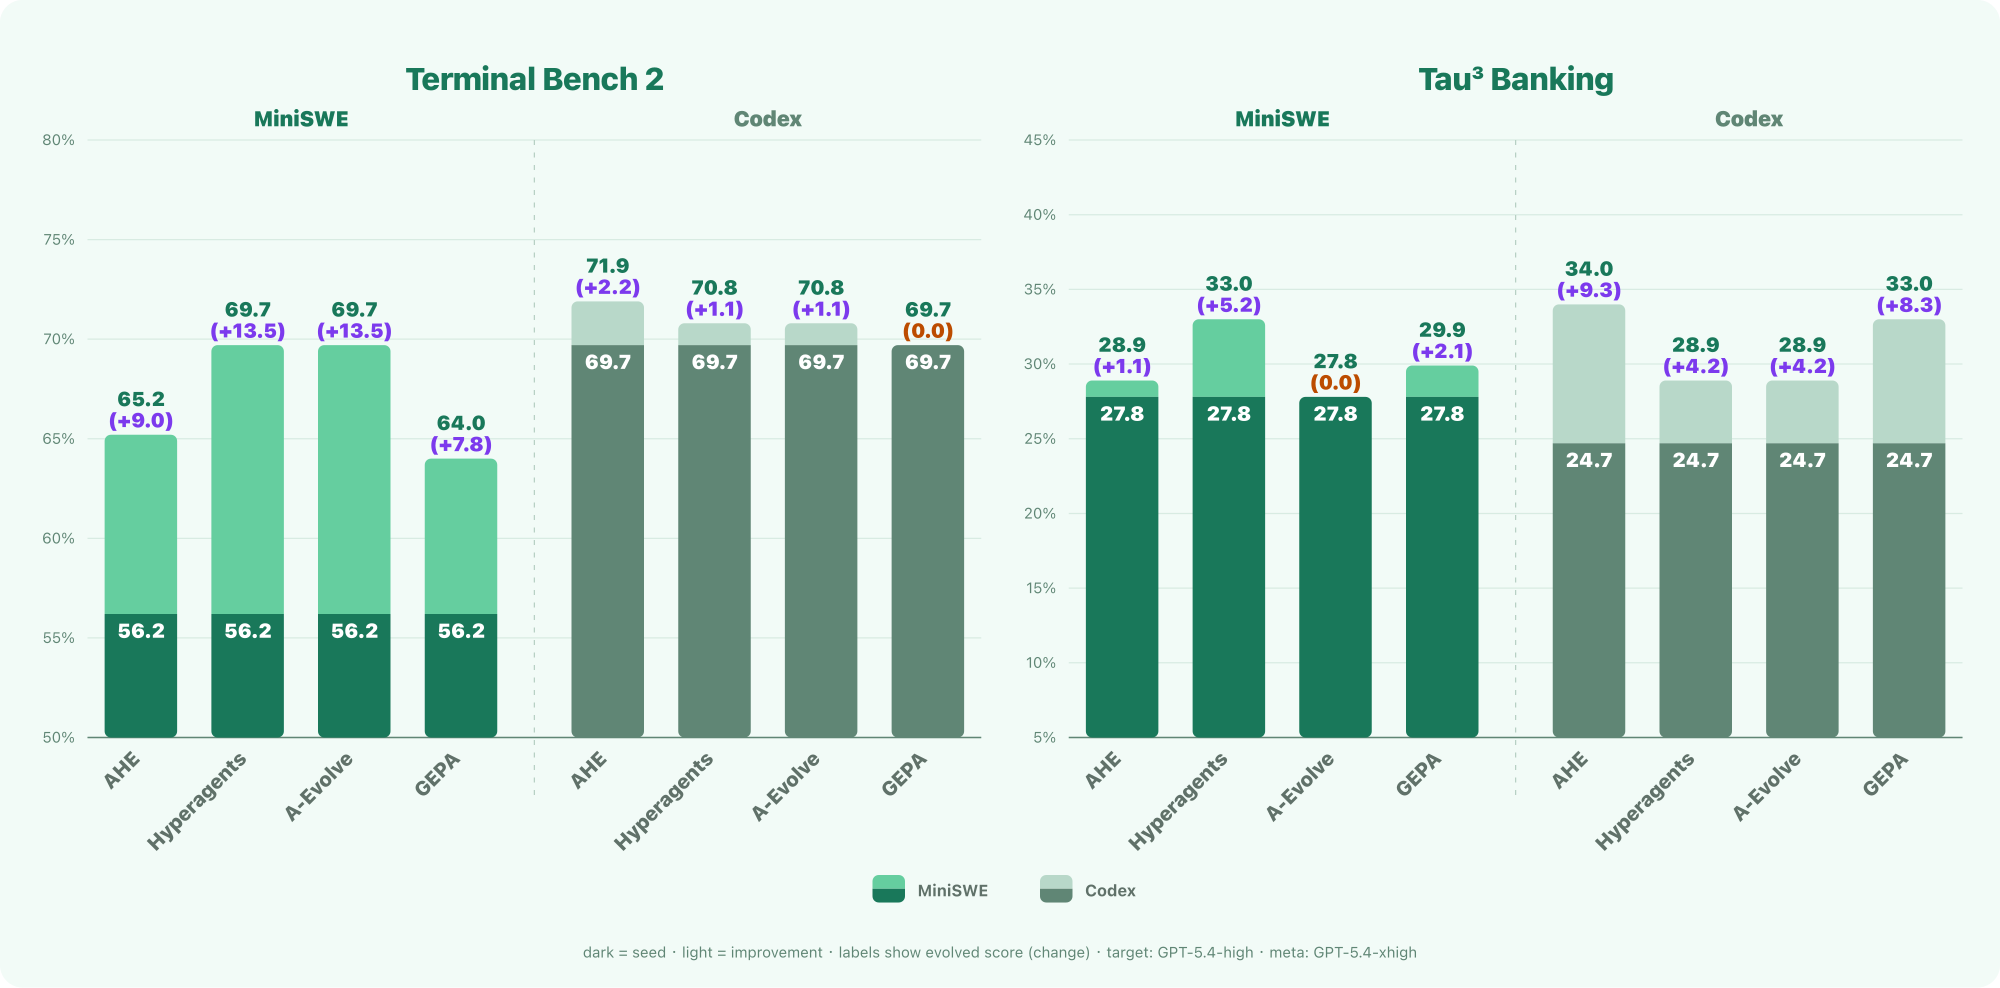

docs/assets/benchmark-results-rsihub-v2.svg。图 6 展示的是整体分数的提升,最亮眼的是在 Terminal-Bench 2 上,Hyperagents 和 A-Evolve 把 MiniSWE 的全量 pass@1 从 56.2% 提升到了 69.7%(+13.5 个百分点);在 Banking 上,AHE 把 Codex 从 24.7% 提升到了 34.0%(+9.3 个百分点)。
但如果把论文 Table 1 中 Train / Gate / Sealed 三个划分对总分的贡献拆开看,能读出更有价值的工程真相(注:表中各划分数值为该划分通过任务数占全集总任务数的百分比 ,三列相加等于 Overall):
| 基准集 | 种子 Agent | 方法 | Train 贡献 | Gate 贡献 | Sealed(封存集)贡献 | 全集 Overall pass@1 |
|---|---|---|---|---|---|---|
| Terminal-Bench 2 | MiniSWE | Seed | 32.6% | 12.4% | 11.2% | 56.2% |
| AHE | 37.1% (+4.5) | 12.4% (+0.0) | 15.7% (+4.5) | 65.2% (+9.0) | ||
| Hyperagents | 36.0% (+3.4) | 16.9% (+4.5) | 16.9% (+5.6) | 69.7% (+13.5) | ||
| A-Evolve | 40.5% (+7.9) | 12.4% (+0.0) | 16.9% (+5.6) | 69.7% (+13.5) | ||
| GEPA | 36.0% (+3.4) | 12.4% (+0.0) | 15.7% (+4.5) | 64.0% (+7.8) | ||
| Terminal-Bench 2 | Codex | Seed | 39.3% | 15.7% | 14.6% | 69.7% |
| AHE | 42.7% (+3.4) | 12.4% (-3.4) | 16.9% (+2.2) | 71.9% (+2.2) | ||
| Hyperagents | 41.6% (+2.3) | 13.5% (-2.2) | 15.7% (+1.1) | 70.8% (+1.1) | ||
| A-Evolve | 40.5% (+1.1) | 15.7% (+0.0) | 14.6% (+0.0) | 70.8% (+1.1) | ||
| GEPA | 39.3% (+0.0) | 15.7% (+0.0) | 14.6% (+0.0) | 69.7% (+0.0) | ||
| Banking | MiniSWE | Seed | 12.4% | 6.2% | 9.3% | 27.8% |
| AHE | 16.5% (+4.1) | 7.2% (+1.0) | 5.2% (-4.1) | 28.9% (+1.1) | ||
| Hyperagents | 17.5% (+5.1) | 8.2% (+2.0) | 7.2% (-2.1) | 33.0% (+5.2) | ||
| A-Evolve | 12.4% (+0.0) | 6.2% (+0.0) | 9.3% (+0.0) | 27.8% (+0.0) | ||
| GEPA | 11.3% (-1.1) | 11.3% (+5.1) | 7.2% (-2.1) | 29.9% (+2.1) | ||
| Banking | Codex | Seed | 16.5% | 5.2% | 3.1% | 24.7% |
| AHE | 17.5% (+1.0) | 8.2% (+3.0) | 8.2% (+5.1) | 34.0% (+9.3) | ||
| Hyperagents | 15.5% (-1.0) | 6.2% (+1.0) | 7.2% (+4.1) | 28.9% (+4.2) | ||
| A-Evolve | 15.5% (-1.0) | 7.2% (+2.0) | 6.2% (+3.1) | 28.9% (+4.2) | ||
| GEPA | 16.5% (+0.0) | 9.3% (+4.1) | 7.2% (+4.1) | 33.0% (+8.3) |
从这张拆分表里可以提炼出三个在单方法论文里很少被同时摆上台面的结论:
- 没有任何一种演化策略能在不同底座 Agent 和基准上通吃。 在 Terminal-Bench 2 + MiniSWE 上,Hyperagents 和 A-Evolve 领先(+13.5%);换成起点更高的 Codex,四套方法的增益立刻收窄到 0.0%~+2.2%;到了 Banking + Codex,表现最好的又变成了 AHE(+9.3%)和 GEPA(+8.3%)。
- 总分上涨可能掩盖保留集(Sealed)上的倒退。 最典型的是 Banking 上的 MiniSWE:Hyperagents 的总分涨了 5.2 个百分点(从 27.8% 到 33.0%),看起来效果最好,但拆开看,它的提升全来自 Train(+5.1)和 Gate(+2.0),在从未见过的 Sealed 任务上反而倒退了 2.1 个百分点;AHE 更是出现了 Train +4.1、Sealed -4.1 的明显过拟合。如果没有 Train / Gate / Sealed 的严格隔离与分项记账,这种过拟合就会被总分掩盖。
- 框架自身的运行时开销极低,且故障恢复与越界拦截在 420 次注入测试中全部通过。 论文 Table 3 与 Table 5 报告:在两个基准集上针对“变异中途强杀、评测中途强杀、收据写入后强杀、篡改
evaluator/、写超surface范围、偷读sealed证据、伪造archive.jsonl分数”共 7 类场景各跑 30 次故障注入(总计 420 次试验),RSIHub 100% 恢复到一致状态或拒绝非法状态;而框架自身的工作区快照、边界检查与归档校验开销,仅占单代端到端耗时的 0.019%~0.02%(中位数毫秒级),时间主要花在模型推理与容器任务执行上。
8. 边界条件与工程借鉴
把源码和论文结合起来看,RSIHub 有几处工程设计非常值得在做 Agent 评测与自演化系统时借鉴,同时也有明确的适用边界:
值得直接借鉴的三个设计:
- 用实际 Git 工作树 diff 代替 Agent 自报改动:
mutate阶段不管 Agent 声称自己改了什么,框架一律用git status / diff对照parent_commit检查真实改动路径,并用IMPLICIT_EXCLUDES锁死评测器与账本。 - 把“评测打分(Evaluate)”和“准入决策(Gate)”拆开:评测是客观事实记录,必须先盖章写进
archive.jsonl并生成.evolve-eval-receipts.jsonl收据,此时状态记为pending_gate_record: True;随后再跑策略层的gate算子决定它能不能当父代。这样就算进程在评测刚跑完的那一刻崩溃,重启后_resume_tagged_child()也能直接接着跑gate,不用重跑昂贵的容器评测。 - 用测试守护架构文档(
test_coherence.py):把每个模块的一句话职责和行数预算写进docs/ARCHITECTURE.md,用单测防膨胀,这在多人或 Coding Agent 协作维护基础设施仓库时非常实用。
需要注意的局限与边界:
- 防篡改收据防的是“算子误写与实验逻辑越界”,不是对抗性宿主机安全沙箱。 正如论文第 6、7 节所坦承的,
.evolve-eval-receipts.jsonl存放在同一工作区(及~/.evolve/mirrors/)下,使用的是无密钥 SHA-256 摘要而非外部硬件签名。如果恶意代码拿到了宿主机文件系统写权限,它可以同时重算收据。因此它保障的是实验流程的归因可靠性(Provenance),不能替代容器/VM 级安全隔离。 - 单次演化的随机波动不小。 论文 Table 2 的执行保真度对照实验(Direct-A vs. RSIHub Gen 0 vs. Direct-B)显示,即便是完全不演化的同一个种子 Agent,两次直接运行(D–D)在单任务级别也有 12.0%~18.9% 的不一致率。因此,面对 1~2 个百分点的微弱提升(比如 Codex 在 Terminal-Bench 2 上的 +1.1%),不能只凭单次演化运行就下定论,必须结合多次重复实验和分项划分综合判断。
9. 源码阅读索引与参考资料
如果你想基于 RSIHub 写一个新的演化算子或复现实验,建议按下面这条最短路径读代码:
src/evolve/frozen/__init__.py与src/evolve/frozen/interfaces.py:先看冻结环定义、9 个算子的 ABC 接口、输入上下文OperatorContext以及ArchiveView。src/evolve/surface.py与src/evolve/candidate/snapshot.py:理解可变表面路径匹配和基于临时索引的干净 Git 快照构建。src/evolve/driver.py:重点读_run_locked()、_run_child()、fork_child()、commit_child()和_run_gate_and_record(),这是整个七阶段生命周期的调度核心。src/evolve/evaluation/execution.py:看标准评测如何校验evaluator/树哈希、如何拉起隔离的evaluation-worktrees并生成评测契约。src/evolve/archive.py与src/evolve/population.py:看STAMPED_FIELDS、.evolve-eval-receipts.jsonl收据校验以及is_parent_record()的 10 个准入条件。recipes/与library/:对照ahe、hyperagents、aevolve、gepa的evolve.yaml和对应的算子实现,看具体策略如何落地。tests/test_coherence.py与tests/test_operator_config_schema.py:看框架如何用测试锁死模块预算与配置契约。
项目与论文链接:
- GitHub 仓库:simple-agent-lab/RSIHub(本文核查提交:
d655429,Apache-2.0 许可证) - 论文:RSIHub: A Composable Framework for Agent-Evolution Methods (arXiv:2610.32253)
- 官方文档站点:https://simpleagentlab.com/RSIHub/
- 本文补充图表的可编辑源文件:代际生命周期与边界(
.drawio)、三划分隔离与归档判定(.drawio)、原始图表来源说明。