Harness RSI 演进脉络与近三个月(2026.08–10)24 项工作全拆解
梳理 2023 年 9 月至 2026 年 11 月 2 日 Agent Harness 递归自我改进(Harness RSI)的四阶段演进脉络,按主线、元改进与联合优化三层边界建立坐标,并逐篇拆解近三个月(2026 年 8 月至 10 月)全部 24 项算法工作与 4 项工程框架/综述。
当同一个底座模型在不同 Agent 框架里跑出十几到几十个百分点的差距时,决定上限的往往不再只是模型权重 ,而是包裹在模型外面的那层可执行软件——Agent Harness :系统提示词、Agent Loop 控制流、工具接口、观察值过滤与分页、上下文压缩策略、子代理路由以及完成态判定。
过去两年里,围绕这层软件形成了一条清楚的研究主线:Harness 递归自我改进(Harness Recursive Self-Improvement, Harness RSI)。它的核心想法很直接:既然 Coding Agent 已经能读日志、改代码、跑测试,那为什么不让它根据任务执行轨迹去修改自己的 Harness,甚至进一步修改“负责改进 Harness 的优化器代码”?
截至 2026 年 11 月 2 日,按论文首次公开提交日期(以 arXiv v1 或原始公开日期为准,不用会议年份或修订版日期)排列,这一方向已经积累了近 50 篇代表性论文与多个开源工程平台。特别是在 2026 年 8 月至 10 月这短短三个月内,社区密集公开了 24 篇相关算法论文和 4 项重要工程框架/综述,研究重心从早期的“整包重写代码刷榜”,迅速转向模块解耦、防过拟合正则化、搜索与运行 Token 降本、受验证的优化器自进化,以及跨模型/模型权重协同更新。
下文先划清 Harness RSI 的三层范围边界与四阶段发展脉络,再按六个具体工程问题将近三个月(2026 年 8—10 月,并以 7 月中旬的 RHI 作为过渡锚点)的全部相关工作逐篇拆开,最后给出阅读优先级与面向 GUI Agent / 移动端自动化测试(Mobile QA)的落地建议。文末附完整时间线总表;表中概括的是各论文的方法贡献与报告结果,不代表已逐一独立复现实验。
目录
- 边界定义:什么是 Harness RSI,它的三层作用面怎么分
- 2023.09—2026.10:Harness RSI 的四阶段发展脉络
- 近三个月(2026.08—10)全景:整包自改撞墙后的六条支流
- 支流一:改哪里才不耦合?——模块化、面向对象继承与经验编译
- 支流二:怎么防止刷榜过拟合?——正则化、分层数据隔离与参考轨迹对齐
- 支流三:有限预算下怎么搜、怎么跑?——免奖励搜索、组合 Bandit 与运行时砍 Token
- 支流四:优化器自己怎么变强?——受验证元进化、递归深度与失败经验共享
- 支流五:换模型或训模型怎么办?——跨模型共享 Harness 与权重交替训练
- 支流六:走出代码台能落到哪?——推理数据合成、具身机器人与多轮可视化
- 单独关注的工程平台与理论综述:Dream-RSI、GEAR、PenguinHarness、RSIHub 与 Self-Evolving Agent Harness
- 阅读优先级:面对四个核心疑问,先读哪几篇
- 对 GUI Agent 与 APP 自动化测试 / Mobile QA 的启发
- 附录:截至 2026 年 11 月 2 日 Harness RSI 代表性工作完整清单
1. 边界定义:什么是 Harness RSI,它的三层作用面怎么分
如果把智能体在环境 中的一次执行记作 ,评测器或验证信号记作 ,那么不同的自我改进方法,本质区别在于到底允许哪个变量随历史轨迹发生变化。
“Harness RSI”在文献里还没有单一的严格边界。为了避免把所有带“Self-Improving”字样的论文混作一谈,这里按更新对象划出三层范围:
- 主线(Executor Harness 优化):保持模型权重 冻结,直接修改 Agent 的工具定义、执行循环(Agent Loop)、观察值裁剪、上下文管理或完整 Harness 源码 。
- 元改进(Meta-Improvement):不仅修改执行任务的 ,还进一步修改“负责诊断失败、提议修改、选择分支或编排改进工作流的机制”(即优化器 / Evolver / Meta-Agent 自身)。
- 相关与联合优化(Related & Co-optimization):一类是只演化 Prompt、Contextual Playbook、Skills 或多节点工作流图,不直接碰底层执行器代码;另一类是打破“权重冻结”假设,让 Harness 与模型权重 (通过 SFT 或 RL)交替或联合更新。
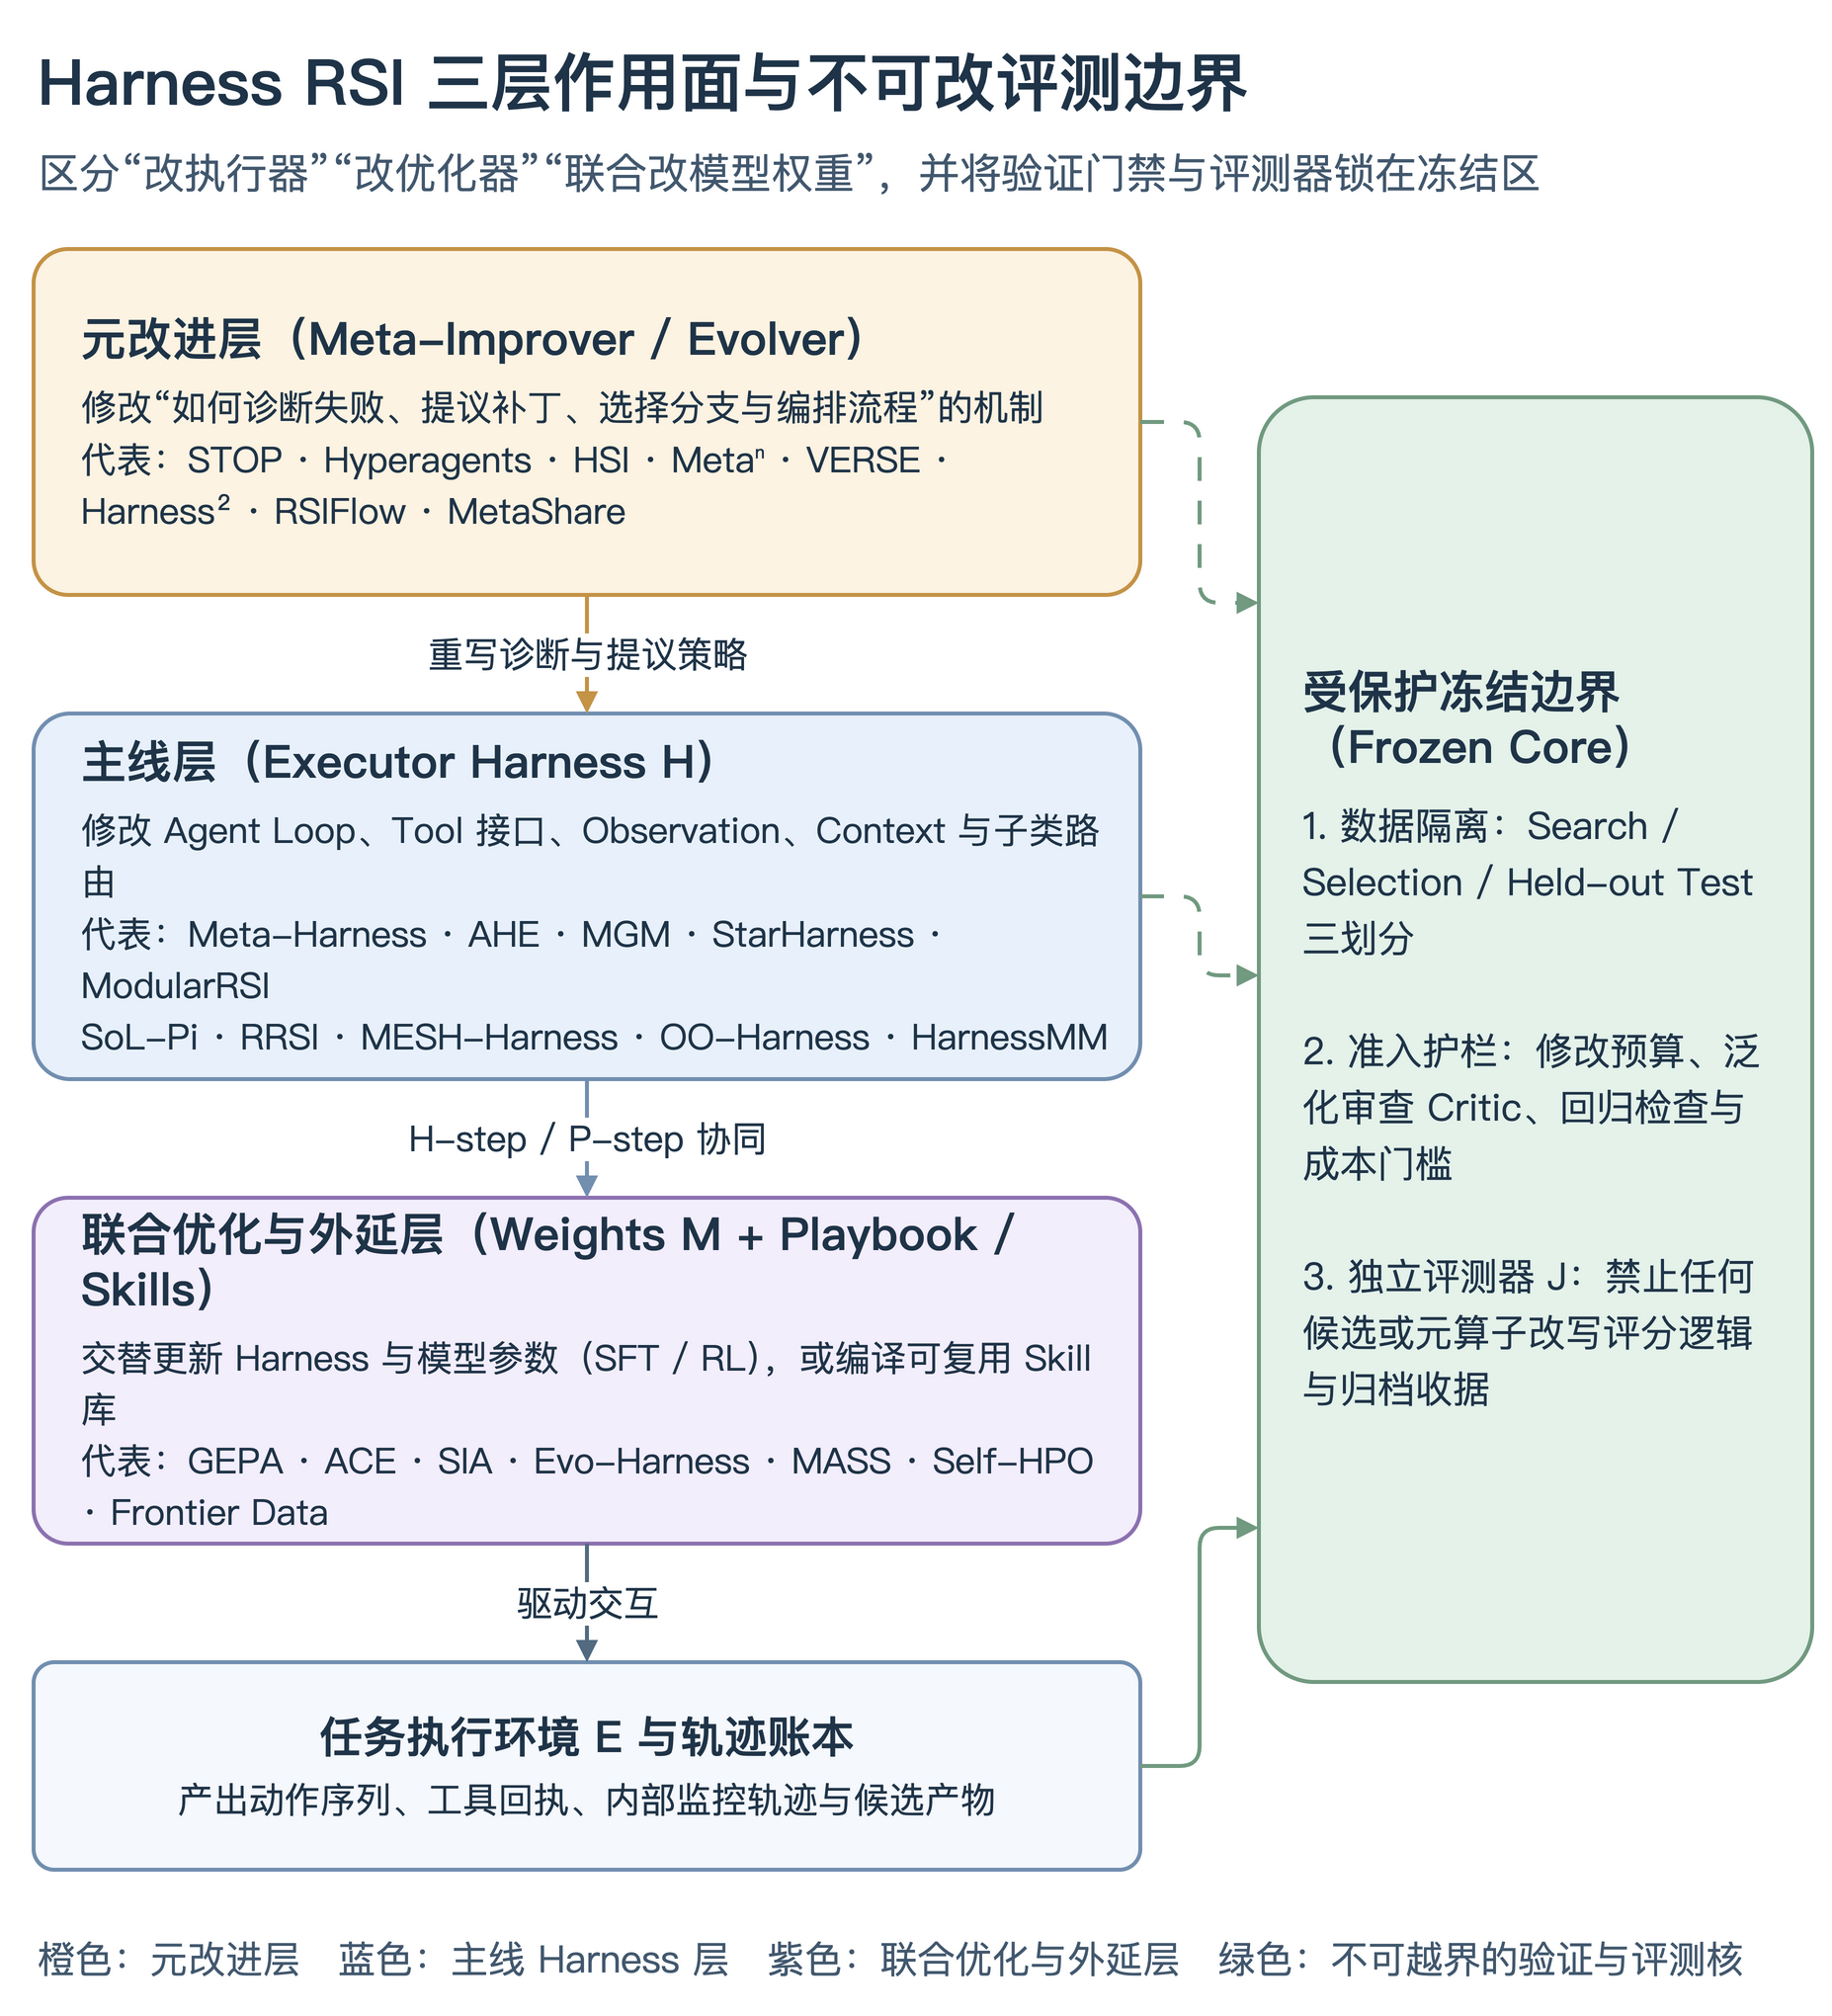
图 1 右侧的绿色框是近半年该领域最重要的一条工程共识:无论主线层还是元改进层开放多大的代码编辑权限,数据划分(Search / Selection / Held-out Test)、准入护栏(修改预算、泛化审查、回归门控)以及最终评测器 必须锁在不可编辑的冻结区里。一旦允许候选 Agent 或元算子触碰评测脚本与归档账本,所谓的“自我改进”很容易退化成针对评分漏洞的 Reward Hacking。
2. 2023.09—2026.10:Harness RSI 的四阶段发展脉络
把 2023 年底到 2026 年 10 月的代表性工作按首次公开日期排成一条线,可以清楚看到四次阶梯式的迁移。
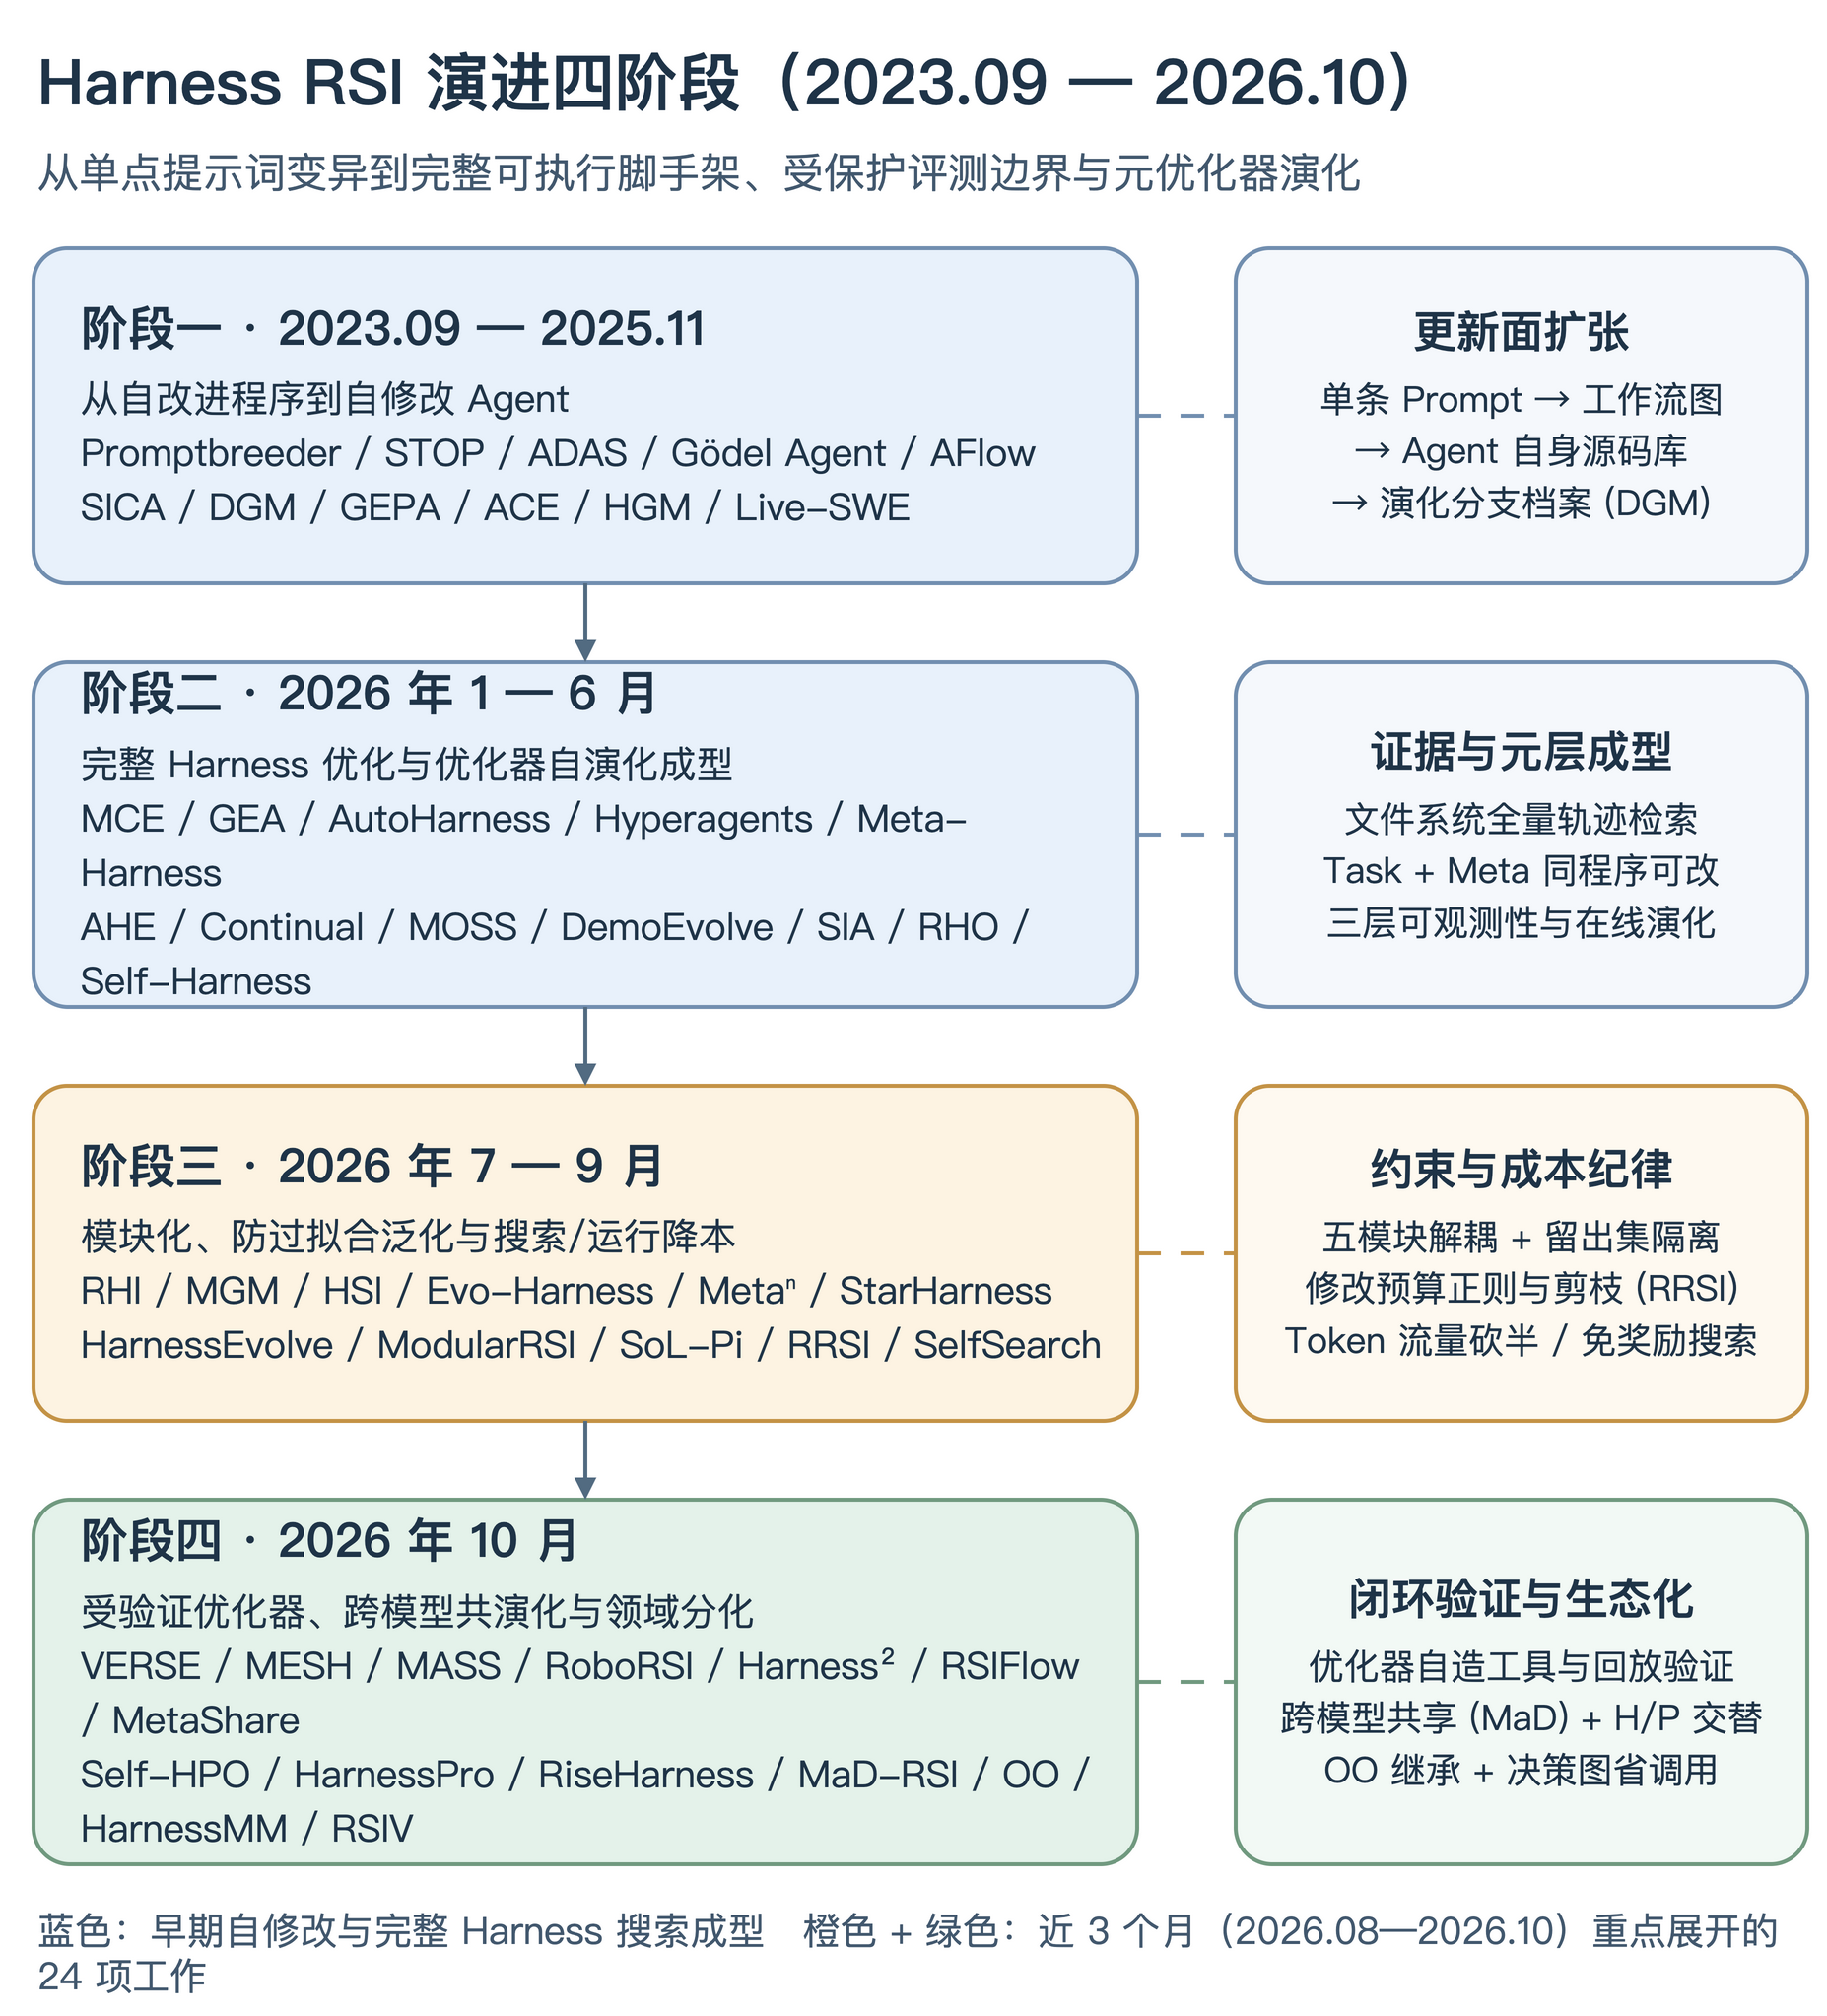
2.1 第一阶段(2023.09—2025.11):从自改进程序,到自修改 Agent
这一阶段完成了从“改提示词”到“改工作流代码”,再到“Agent 直接编辑自身代码库并保留演化树”的跨越:
- 早期元改进雏形(2023.09—2023.10):Promptbreeder(2023-09-28)同时演化任务 Prompt 和负责变异的 Mutation Prompt,是“改进改进机制”的早期代表;五天后的 STOP(Self-Taught Optimizer)(2023-10-03)从一个调用 LLM 的程序优化器出发,让优化器直接修改并优化自己的代码。
- 代码化工作流与自引用框架(2024.08—2024.10):ADAS(2024-08-15)用 Meta Agent Search 根据历史档案不断编写新 Agent 代码,覆盖提示词、工具调用与工作流;Gödel Agent(2024-10-06)提出自引用(Self-Referential)框架,让 Agent 依据目标与反馈在运行时修改自身逻辑;AFlow(2024-10-14)则把代码表示的工作流作为搜索对象,用蒙特卡洛树搜索(MCTS)与执行反馈迭代修改工作流。
- Coding Agent 自编辑与演化分支树(2025.04—2025.11):
- SICA(2025-04-21)迈出了主线关键一步:让 Coding Agent 利用执行反馈自主编辑自己的代码库,通过代码更新改善能力。
- DGM(Darwin Gödel Machine)(2025-05-29)指出“只沿着最新一版迭代”很容易卡进局部最优,改为同时保存多条 Agent 演化分支,通过自修改和 Benchmark 验证不断扩大 Agent 档案。
- 与此同时,上下文与提示词演化也在升级:GEPA(2025-07-25)读取完整执行轨迹做反思变异,并用 Pareto 候选集合组合互补经验;ACE(Agentic Context Engineering)(2025-10-06)用“生成—反思—整理”流程持续维护 Contextual Playbook,改变上下文知识而非执行器代码。
- 到了 2025 年秋,HGM(Huxley-Gödel Machine)(2025-10-24)修正了 DGM 的分支选择标准——“当前任务得分高”不等于“后续自改进潜力高”,改用后代生产力估计(Clade-Metaproductivity)指导演化分支选择;而 Live-SWE-agent(2025-11-17)证明 Agent 可以从最小的 Bash Scaffold 出发,在解决软件问题的单次运行过程中动态合成并演化自己的工具与脚手架。
2.2 第二阶段(2026 年 1—6 月):完整 Harness 优化与优化器自演化成型
进入 2026 年上半年,“Agent Harness”正式成为独立研究对象。研究者不再满足于零散地加一个工具或改一段提示词,而是开始把整套 Harness 放进端到端搜索循环,并打通了在线连续更新、无标准答案回放以及模型权重联合优化:
- 双层上下文与群体经验共享(2026.01—2026.02):MCE(Meta Context Engineering)(2026-01-29)采用双层演化,底层更新 Context Artifacts,元层更新负责提取上下文的 Skills;GEA(Group-Evolving Agents)(2026-02-04)以 Agent 群体作为演化单位,跨分支共享探索经验,打破了 DGM 各分支之间的信息隔离;AutoHarness(首次公开 2026-02-10)根据环境反馈自动合成代码 Harness 来拦截非法动作,甚至把完整策略直接编译为代码。
- Hyperagents 与 Meta-Harness 双核确立(2026.03):
- Hyperagents / DGM-H(2026-03-19)把 Task Agent 与 Meta-Agent 放进同一个可编辑程序,让“生成未来改进的机制”本身也能被修改和遗传。
- Meta-Harness(2026-03-30)确立了自动化 Harness 工程的标准形态:Coding Proposer 通过文件系统直接查阅所有历史候选的源码、评分和原始执行轨迹(单轮可检索高达 10M tokens 的历史上下文,远超人工或摘要式优化器),端到端搜索完整 Harness 代码。
- 可观测性、生产回放与稀疏反馈(2026.04—2026.05):
- AHE(Agentic Harness Engineering)(2026-04-28)拒绝盲目试错,用组件、经验和决策三层可观测性组织演化,要求每次修改先提出可检验的预测,再核对实际运行结果。
- Continual Harness(2026-05-11)在不重置环境的连续交互流中,在线更新 Prompt、Subagents、Skills 和 Memory,并探索了与模型的共同学习扩展。
- MOSS(2026-05-21)面向生产环境,根据线上失败证据进行源码级重写,通过候选镜像回放、版本切换和自动回滚控制风险。
- DemoEvolve(2026-05-23)针对长周期任务反馈过于稀疏的问题,引入专家示范辅助 Harness 演化,补足单纯成功/失败二元信号的信息缺口。
- SIA(Self Improving AI with Harness & Weight Updates)(2026-05-26)由 Feedback-Agent 同时更新任务 Agent 的 Harness 与底层模型权重。
- 无标准答案自偏好与单模型自适配(2026.06):
- RHO(Retrospective Harness Optimization)(2026-06-04)从历史轨迹中挑选困难任务重新执行,通过自验证、自一致性与成对自偏好(Pairwise Self-Preference)选择更新,摆脱了对外部标准答案评分的依赖。
- Self-Harness(2026-06-08)让同一个基础模型自己完成弱点挖掘、最小修改提议和回归验证,重点解决“通用 Harness 不适配特定模型自身失败模式”的问题。
3. 近三个月(2026.08—10)全景:整包自改撞墙后的六条支流
到了 2026 年 7 月中旬,RHI(Recursive Harness Self-Improvement)(2026-07-17)尝试把复杂的 Agent Loop 压缩表示为轻量级的 Prompt 规范,利用历史版本之间的成对反馈做快速迭代。紧接着在 2026 年 8 月至 10 月,整个领域迎来了一次密集的反思与分化。
为什么会出现这次分化?因为前两个阶段的“整包代码自修改”在走向真实业务和大规模评测时,同时撞上了四堵墙:
- 信用分配(Credit Assignment)模糊:一条 100 步的长轨迹失败了,把整份 Harness 源码交给 Proposer 重写,往往分不清到底是工具接口写错了、上下文压缩太激进了,还是完成态检查漏了,改一处常坏三处。
- 评测集过拟合(Benchmark Overfitting):如果在测试集或其子集上反复迭代,Agent 很容易写出一堆只针对特定题目特征的硬编码规则,在训练集上暴涨,换到分布外(OOD)基准立刻失效甚至倒退。
- 搜索与运行成本失控:每验证一个候选就要在几百道题上跑一轮完整 Rollout,搜索账单动辄数千美元;而且演化出来的 Harness 往往喜欢靠“无限加长提示词、增加反思轮次”来提分,导致推理时 Token 消耗翻倍。
- 单模型强耦合与优化器上限:针对模型 A 搜出来的 Harness 换到模型 B 就水土不服;如果负责改代码的 Optimizer 自身工具和诊断逻辑是写死的,演化很快就会触顶。
围绕这四堵墙,2026 年 8 月至 10 月的 24 项工作分化出了六条非常清晰的工程支流(见图 3):
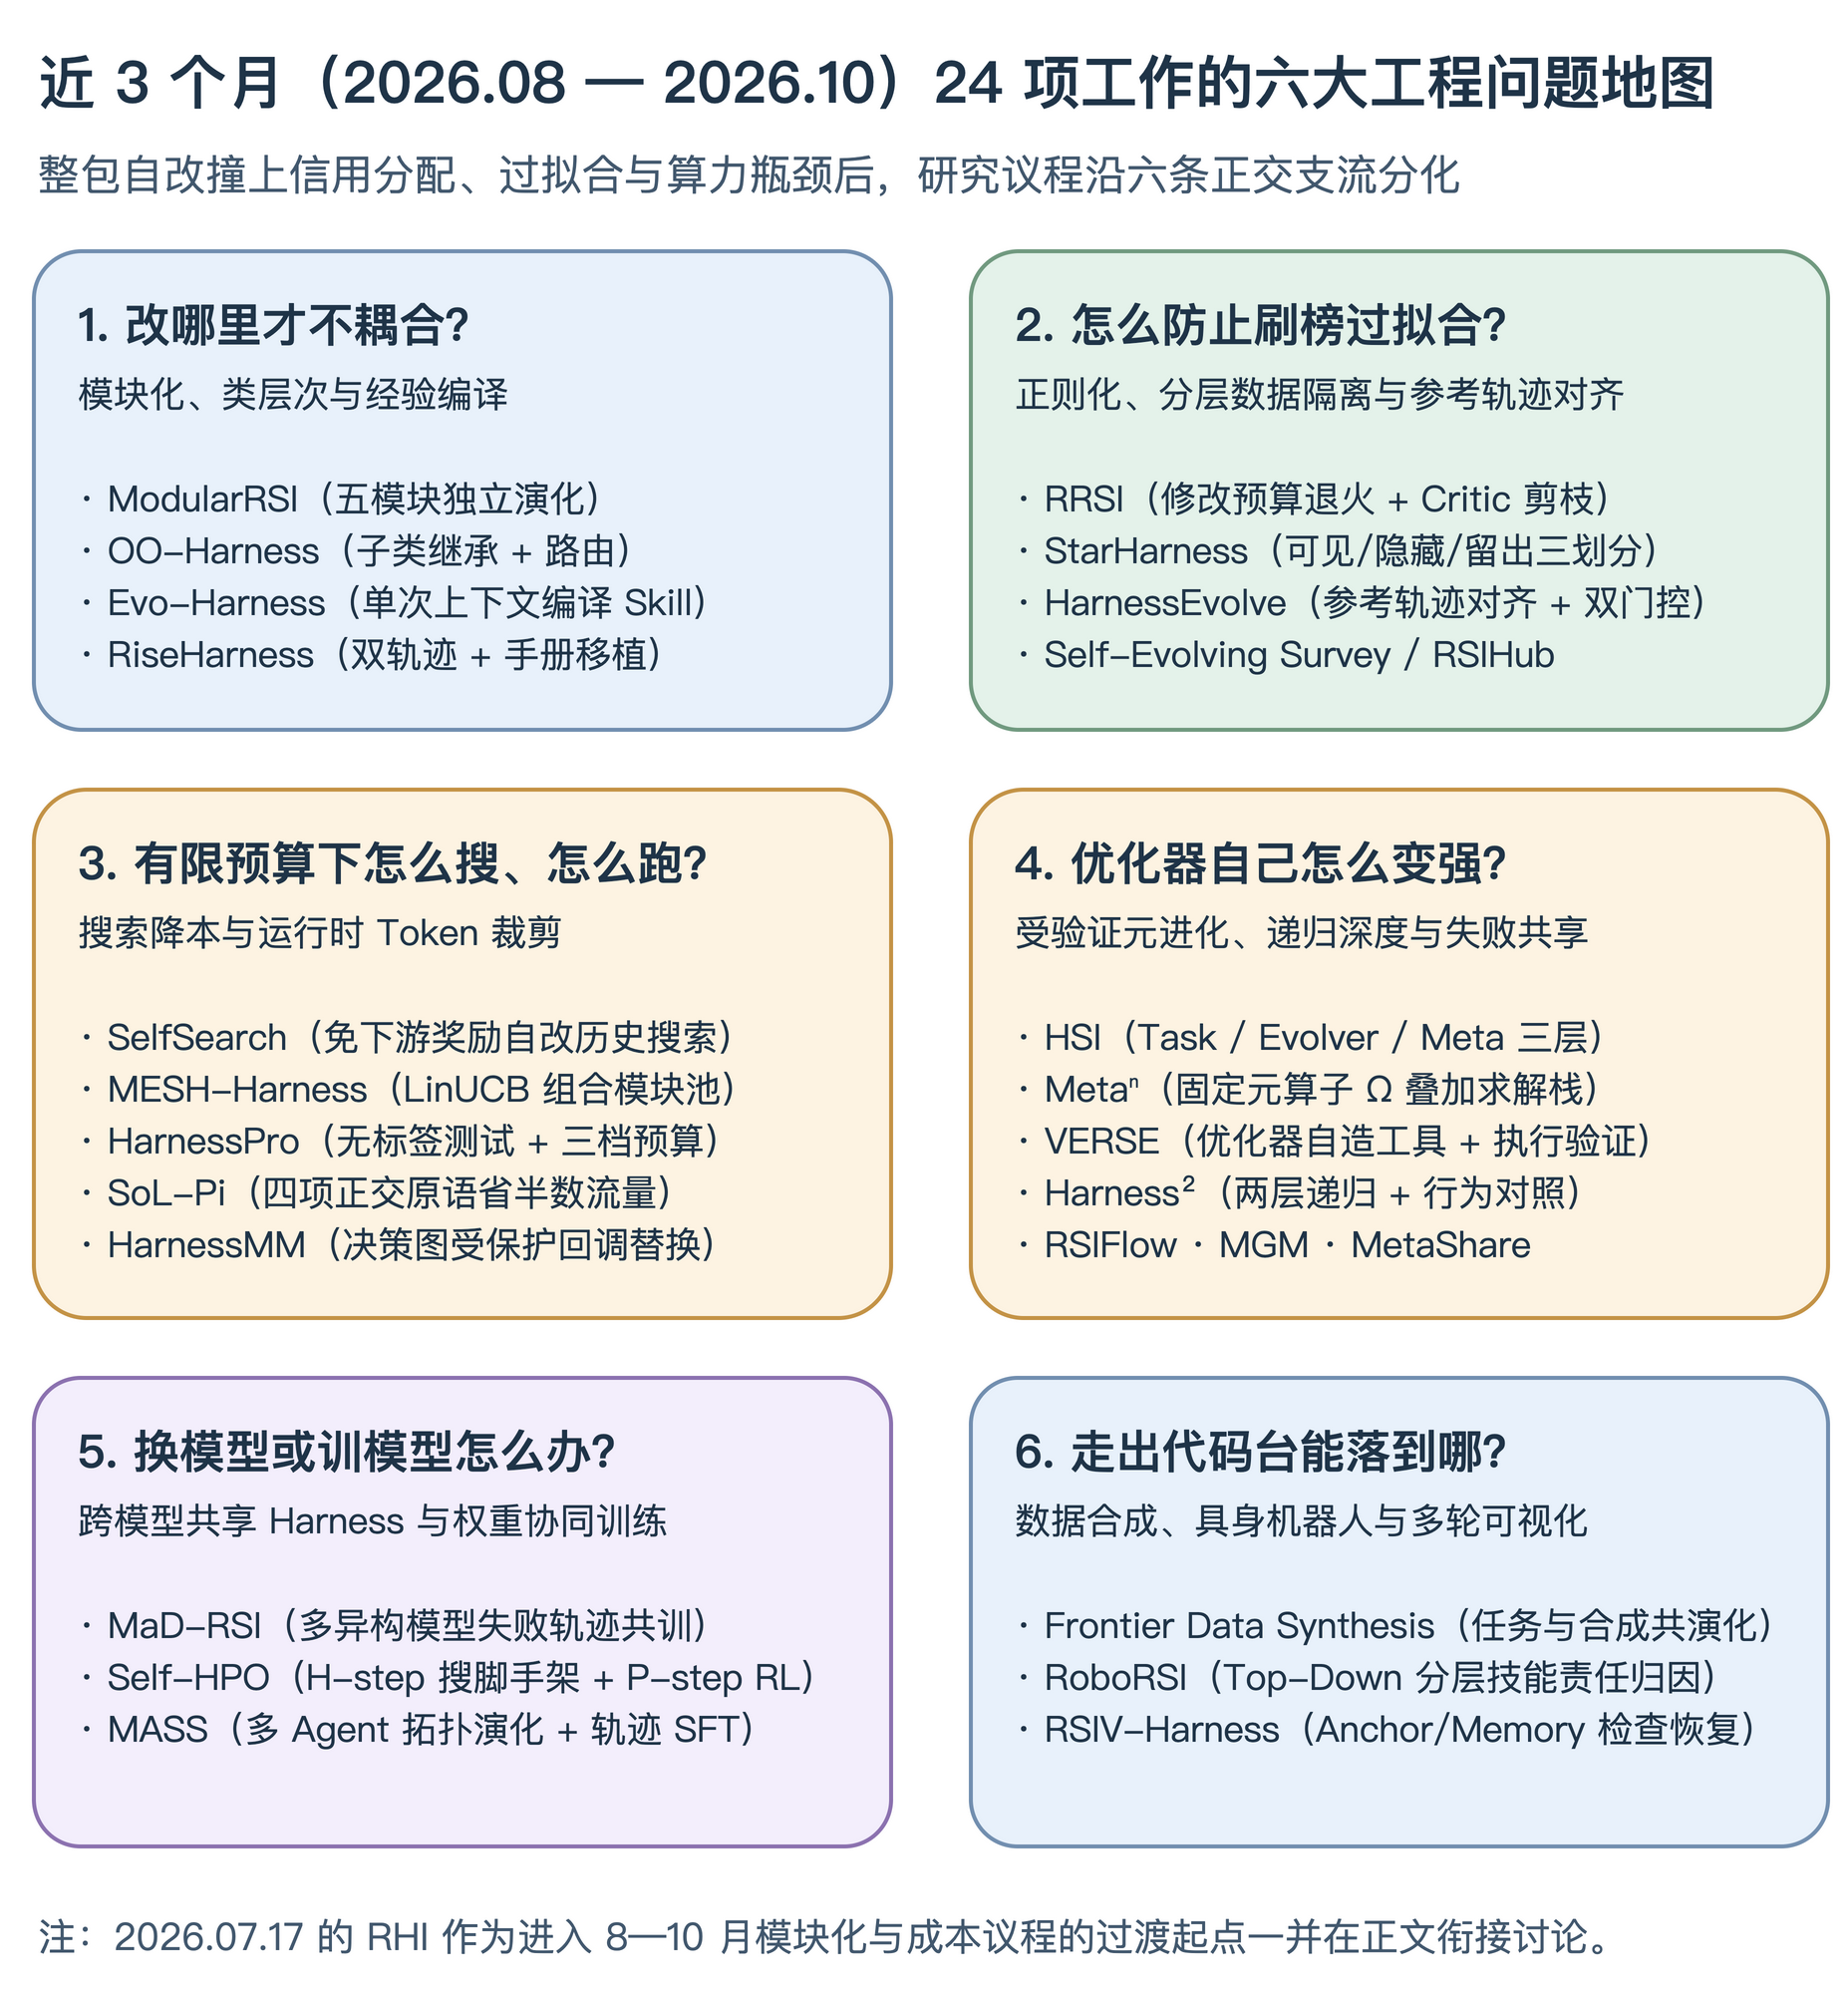
下面按这六个问题逐一展开这 24 篇论文的具体设计与实验结论。
4. 支流一:改哪里才不耦合?——模块化、面向对象继承与经验编译
当整块重写(Monolithic Rewrite)难以归因时,最直接的工程解法就是缩小单次修改的作用域,并为不同任务建立结构化的复用与路由机制。这一支流包含 4 篇代表作:
4.1 Evo-Harness:把单次噪声轨迹编译成跨任务 Skill Harness(2026-08-15)
- 论文:Evo-Harness: Context-to-Harness Skill Compilation for Self-Evolving Agents
- 范围:相关(在线经验编译与 Skill Harness 演化)
- 要解决的痛点:真实环境里很多新任务只有一次尝试机会(One-shot)。单次执行留下的轨迹极其嘈杂,既包含值得跨领域复用的通用排障技巧,又混杂着当前任务特有的临时路径和死胡同。如果直接把原始轨迹或简单摘要塞进记忆库,很容易污染后续任务。
- 核心机制:将在线自改进形式化为 Context-to-Harness Skill Compilation(上下文到脚手架的技能编译)。每完成一个任务,编译器从嘈杂的单次轨迹中剥离实例级细节,提炼出结构化、可复用的 Skill Harness,按主题级(Topic-level)与跨领域层级挂载到后续执行中。
- 验证范围:在 Terminal-Bench 2、SWE-bench、CL-Bench、-bench 和 WebArena-Infinity 五个真实基准上验证了单次经验编译的在线适应能力,并系统消融了哪些上下文信号真正驱动了后续性能提升。
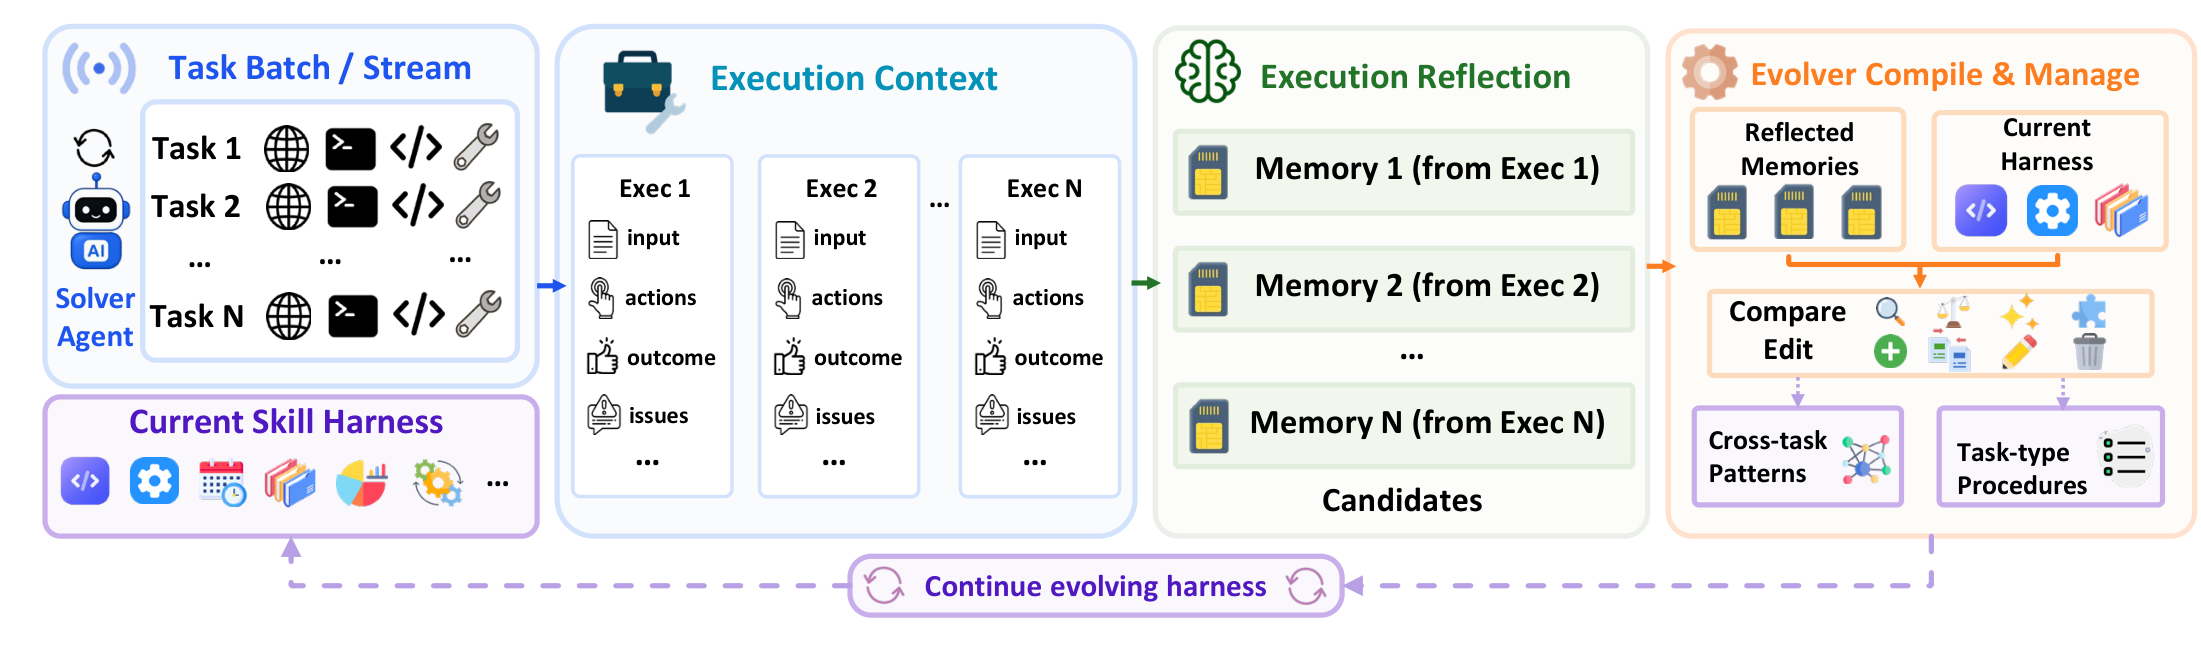
arXiv:2608.15071 Fig. 2)。系统从单次任务轨迹中抽取通用与领域信号,编译为结构化的 Skill Harness 供后续任务挂载。4.2 ModularRSI:五模块解耦演化与 2,000 题外部演化池(2026-09-14)
- 论文:ModularRSI: Modular and Generalizable Recursive Harness Self-Improvement
- 范围:主线
- 要解决的痛点:第一,直接在评测基准或其子集上演化无法区分“真正学会了通用机制”与“背下了评测集套路”;第二,单条失败轨迹无法区分系统性缺陷与偶然推理失误;第三,整包修改会把互不相关的组件拧在一起。
- 核心机制:
- 五模块显式解耦:把可演化 Harness 严格拆成五个功能模块——Agent Loop(主循环控制)、Tool Use(工具调用)、Observation Management(观察值管理)、Context Management(上下文管理) 和 Task Completion Detection(任务完成态检测)。每个模块只能在受限作用域内独立演化,最后通过专门的 Integration 阶段合并并消解模块间冲突。
- 同任务成对轨迹对比 + 跨任务聚合:对同一个任务对比成功轨迹与失败轨迹,再跨任务聚合高频出现的行为缺陷,避免被单次偶然错误带偏。
- Benchmark-Disjoint 演化集:专门从外部数据源清洗构建了 2,000 个可执行演化任务,与下游评测集完全物理隔离。
- 实验结论:在完全不接触目标评测集的前提下,演化出的 Harness 在 Terminal-Bench 2.0 和 SWE-bench Verified 上取得稳定的域内与跨域提升,并且可以直接迁移到未参与演化的其他基座大模型上。
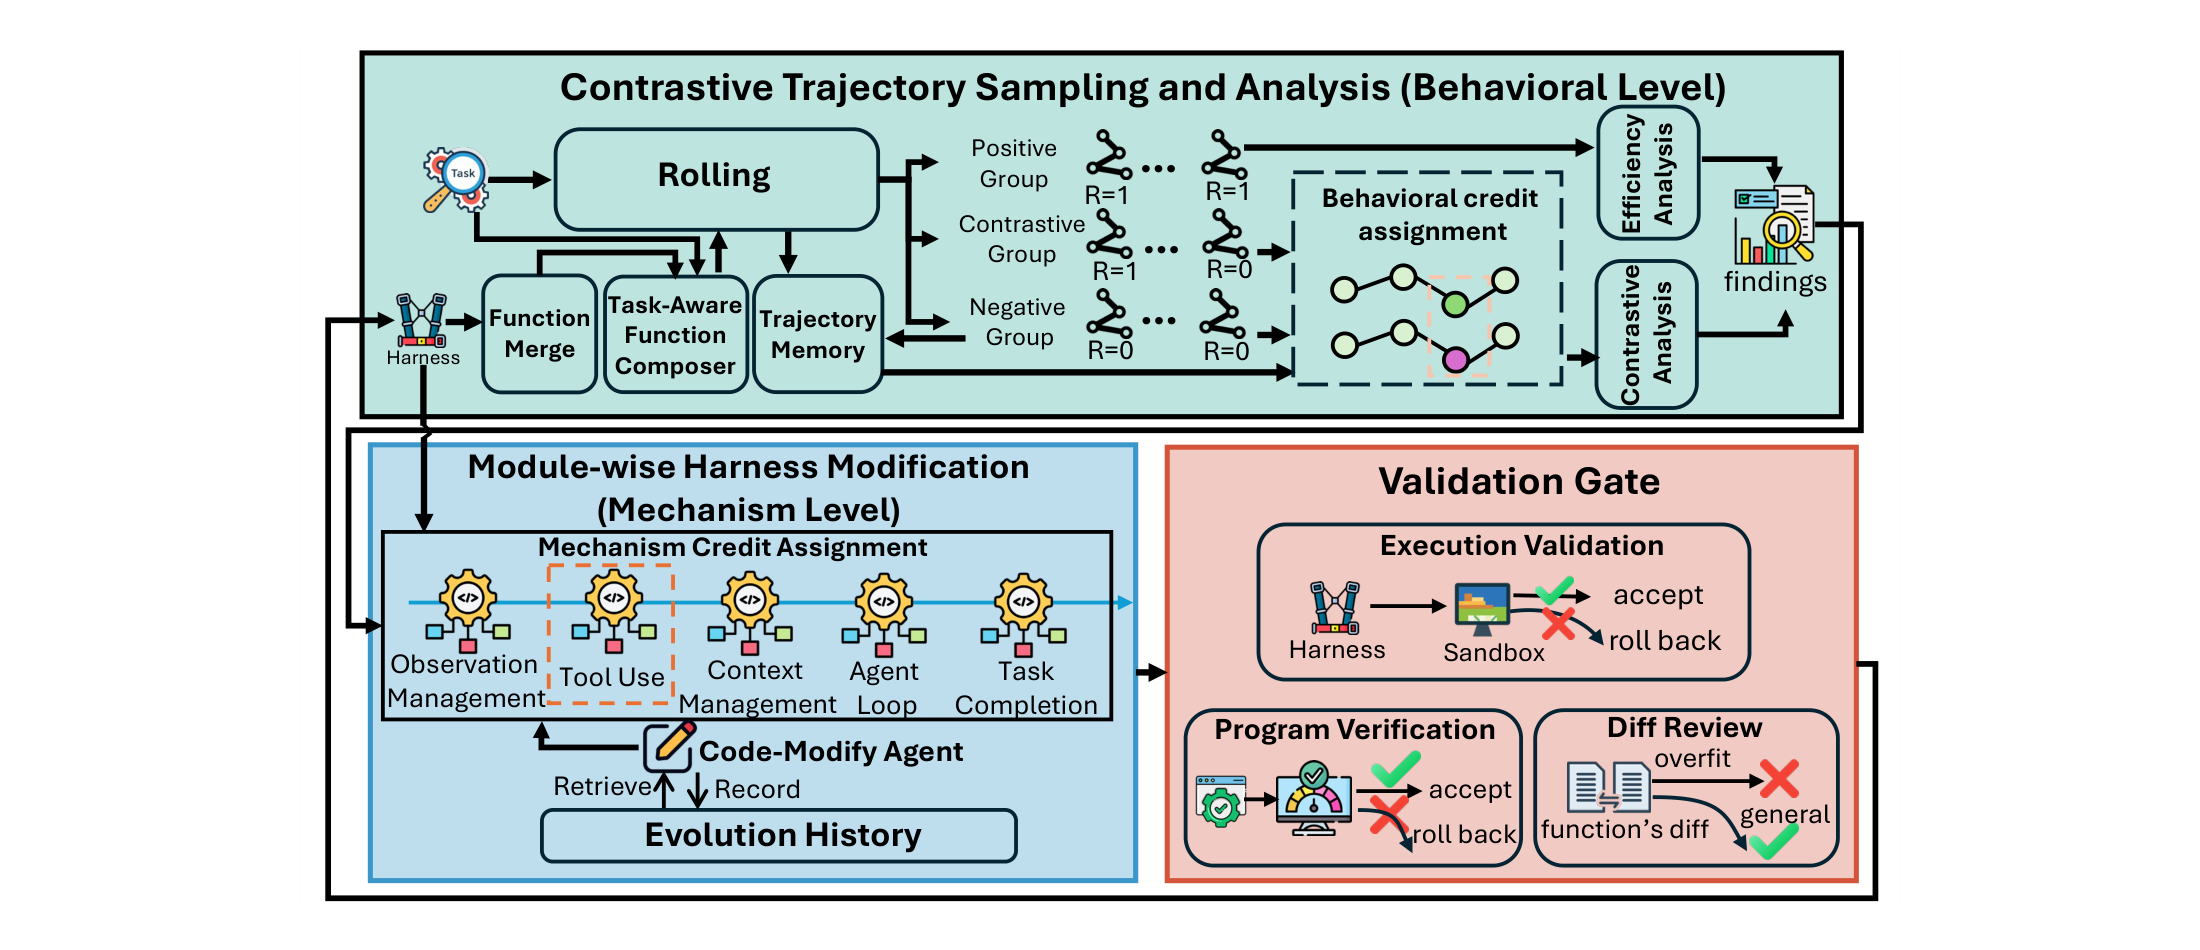
arXiv:2609.14857 Fig. 2)。在与评测集物理隔离的演化任务上,五个功能模块分别依据成对轨迹对比独立演化,再统一集成验证。4.3 RiseHarness:结合内部运行时监控轨迹,跨框架“抄作业”(2026-10-20)
- 论文:Harness Self-Evolution for Long-Horizon Terminal Agents
- 范围:主线
- 要解决的痛点:长周期终端 Agent 经常出现“同一配置跑 5 次,1 次过、4 次挂”的不稳定现象(Unstable / Flipping Tasks)。而且只看模型输出的对话轨迹,看不见 Harness 内部究竟是怎么截断输出、怎么判定超时的;更麻烦的是,让模型从零闭门造车想新机制,搜索空间太大。
- 核心机制:
- 瞄准 Flipping Tasks 做同配置参考对齐:专门挑出在同一配置下既有成功运行又有失败运行的任务,拿自身的成功运行作为对照基准。
- Agent 轨迹 + Harness 内部监控轨迹联合诊断:运行时监控器(Runtime Monitor)同时采集模型动作轨迹与 Harness 内部执行状态,通过一份 Harness Handbook 将故障现象精确映射到 Harness 源码模块(命令执行、反馈处理、上下文管理、完成决策)。
- 跨框架检索与移植:定位到机制短板后,RiseHarness 不靠凭空瞎猜,而是去检索其他开源 Harness 框架的现成实现,将其作为设计参考适配到当前模型与执行协议中,经行为检查与多次重复评测通过后合入主干。
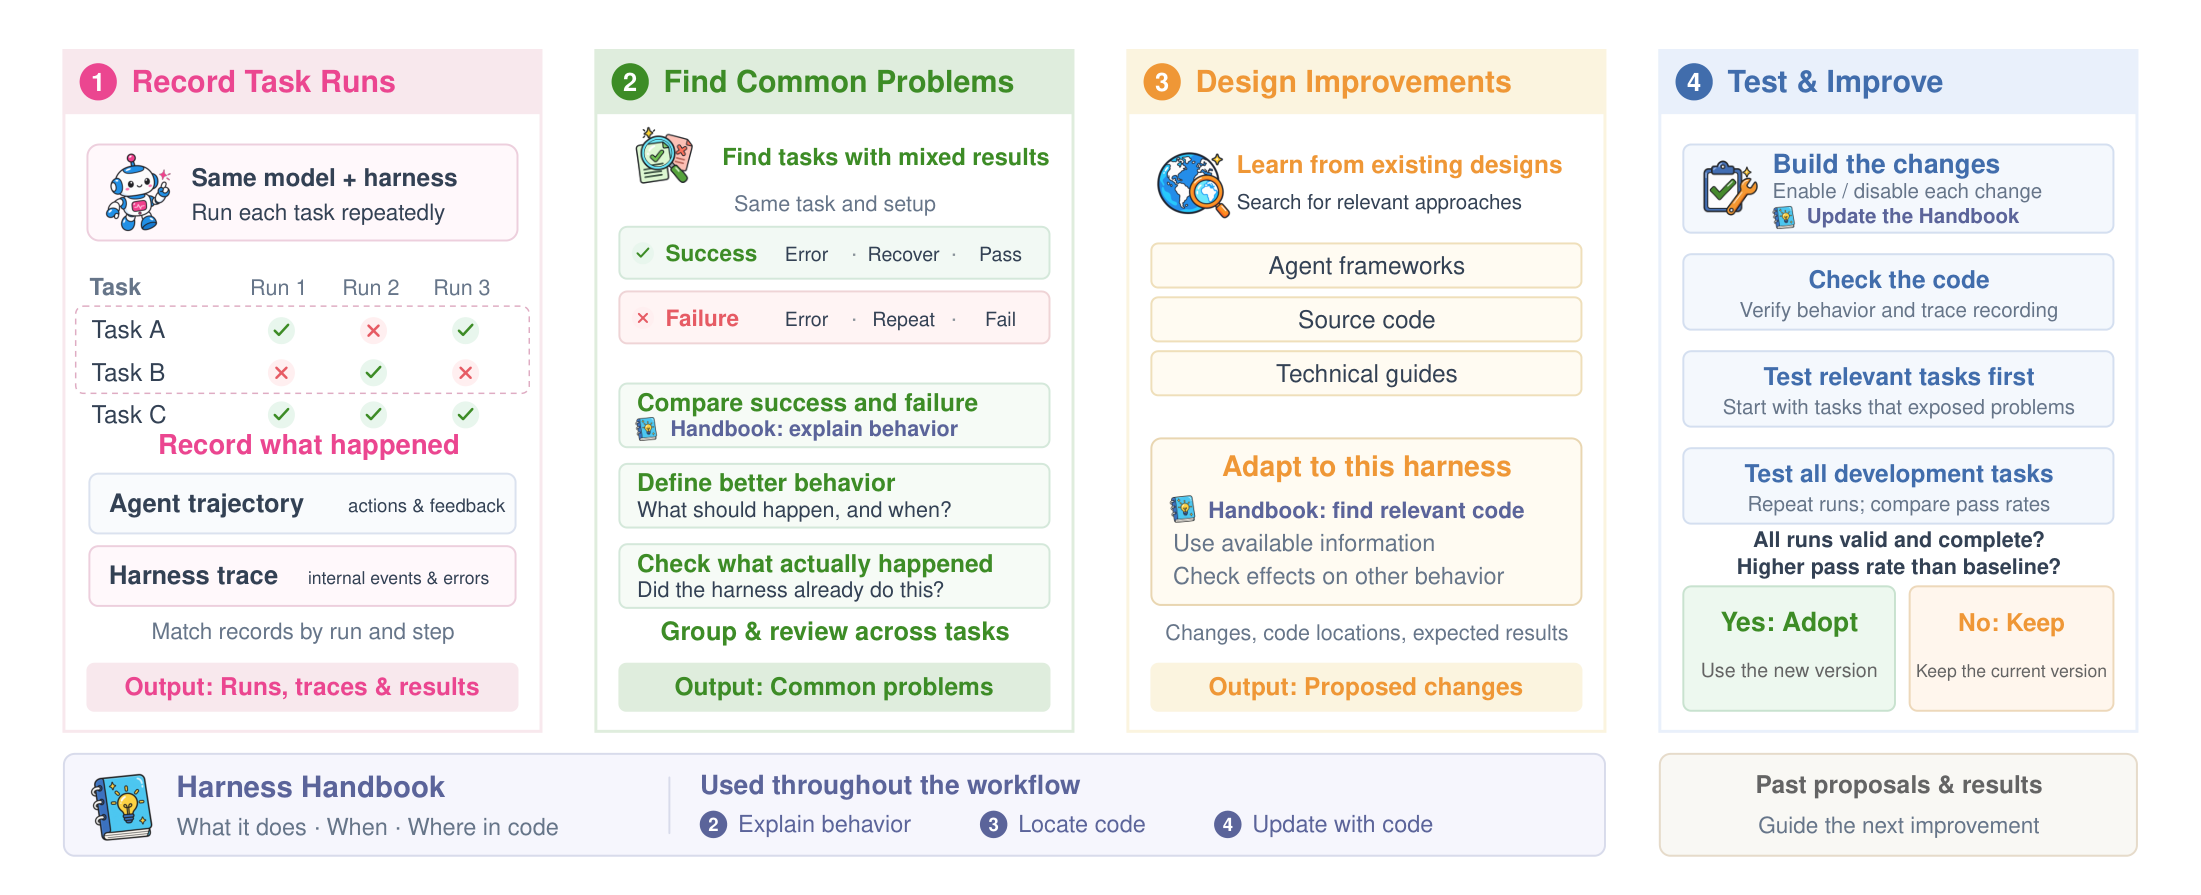
arXiv:2610.27435 Fig. 2)。通过联合分析 Flipping Tasks 的模型轨迹与 Harness 内部运行时日志定位缺陷模块,并从外部参考框架库中检索机制进行适配移植。4.4 OO-Harness:用面向对象继承管理特化 Harness,运行时动态路由(2026-10-20)
- 论文:Object-Oriented Harness: Evolving Agent Harnesses through Object-Oriented Design
- 范围:主线
- 要解决的痛点:试图用唯一一份全局 Harness 应付所有异构任务本身就是伪命题——修 Bug、做数据分析、跑企业审批流需要的上下文策略和验证循环截然不同。把所有规则塞进同一个全局 Harness,必然导致指令打架。
- 核心机制:把软件工程里的面向对象(Object-Oriented)继承体系引入 Harness 演化:
- 训练期构建类层次树(Class Hierarchy):演化 Agent 根据执行记录,以 Base Harness 为基类,通过子类继承(Subclassing & Overriding)不断派生出针对特定任务簇的特化 Harness 子类,既复用父类公共脚手架,又在子类中重写特定钩子。
- 测试期 Router 动态分发:同时积累路由经验(Routing Lessons),在测试时由 Harness Router 为新任务实时挑选最匹配的子类实例执行。
- 实验结论:在横跨企业业务流、工作区操作与复杂工具调用的三个长周期基准上,OO-Harness 相比基础全局 Harness 取得了最高 +15 个百分点的绝对提升。
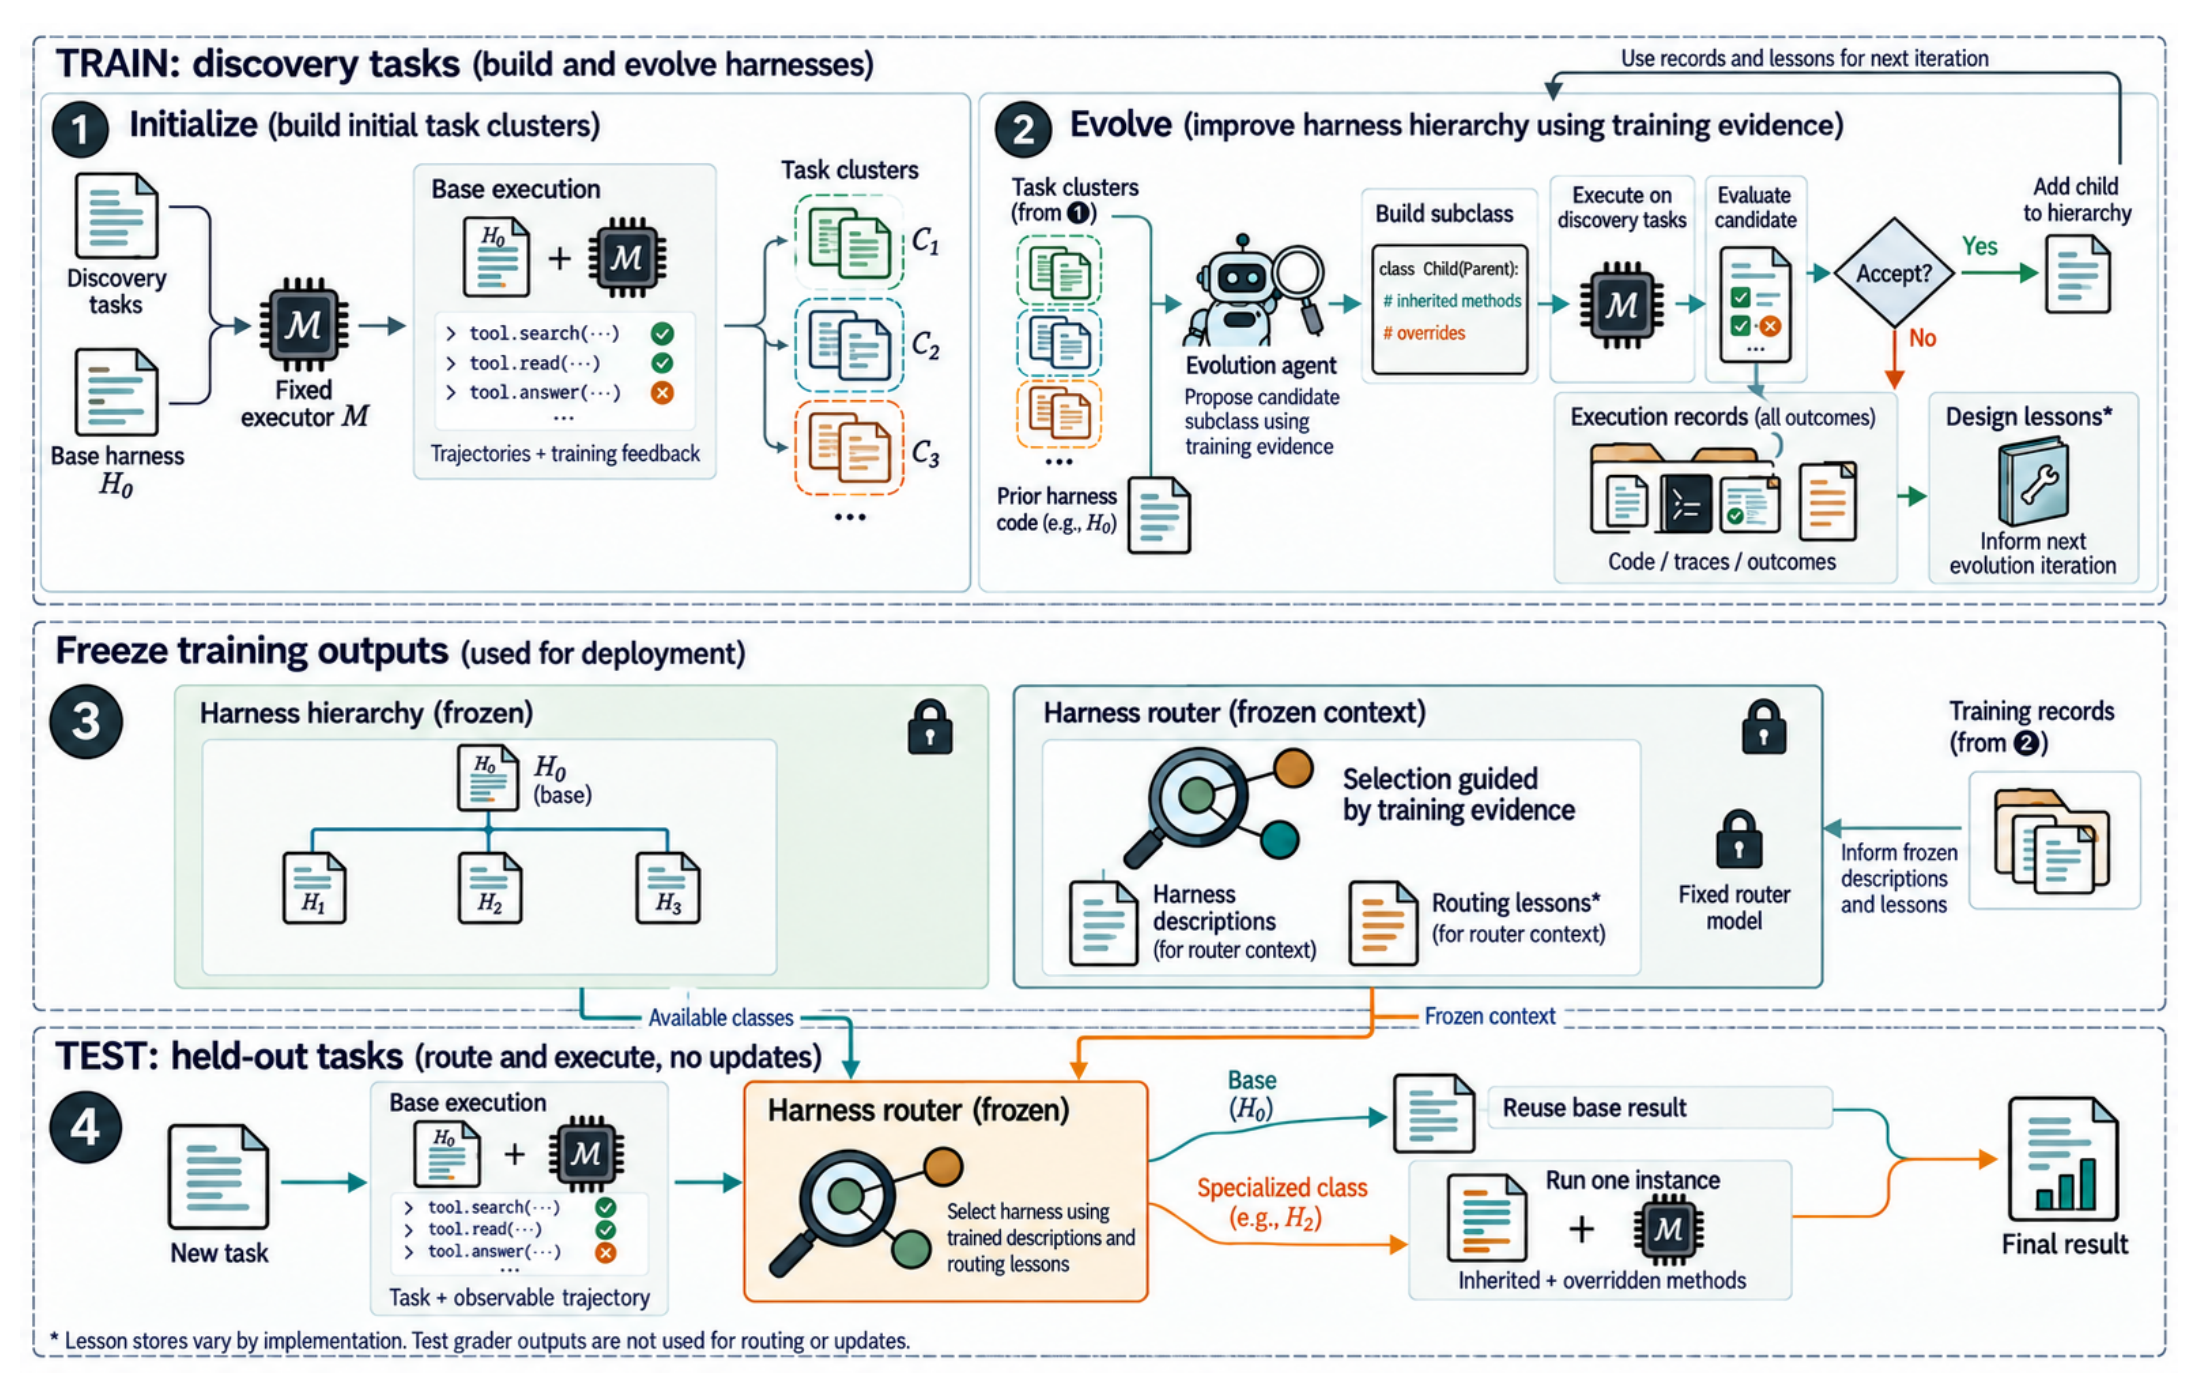
arXiv:2610.28380 Fig. 2)。左侧对比扁平全局重写与面向对象继承树演化,右侧展示训练期派生子类与测试期 Router 动态路由。5. 支流二:怎么防止刷榜过拟合?——正则化、分层数据隔离与参考轨迹对齐
当“自动改代码提分”变得容易后,怎么证明涨的分数不是过拟合出来的假象,成了 2026 年 8—9 月最核心的方法论争论。这组工作从数据划分、参考轨迹对齐和显式正则化三个角度立下了规矩:
5.1 StarHarness:面向企业环境的三层隔离搜索(2026-08-25)
- 论文:StarHarness: Evolving Harnesses with Stratified Search for Enterprise Environments
- 范围:主线
- 核心机制:针对工具极其密集的企业环境(演化范围涵盖 Prompt、工具接口、Skills、MCP Providers、Subagents 与 Agent Loop),StarHarness 提出了按基线失败模式分层抽样(Stratified Search)与三层任务可见性隔离:
- Proposer-Visible 搜索集:提议 Agent 可以读取详细失败轨迹并据此写补丁;
- Proposer-Hidden 选择集:提议 Agent 看不到这批任务及其轨迹,只用来给候选补丁打分筛选,防止 Proposer 针对可见题目写特判;
- Held-out 最终测试集:全程密封,仅用于最终泛化报告。
- 实验结论:在 ITBench SRE、EnterpriseOps-Gym ITSM 和 AutomationBench Finance 三个企业基准上,每个环境仅需接受 4–12 次修改,就能比默认 Harness 提升 20–35 个百分点。更重要的是,这些收益不仅在留出集上保持稳定,还能无需重新演化、直接跨 GPT 与 Qwen 模型家族迁移。轨迹分析表明,主要收益来自修复工具接口歧义、固化环境操作惯例以及减少误报诊断。
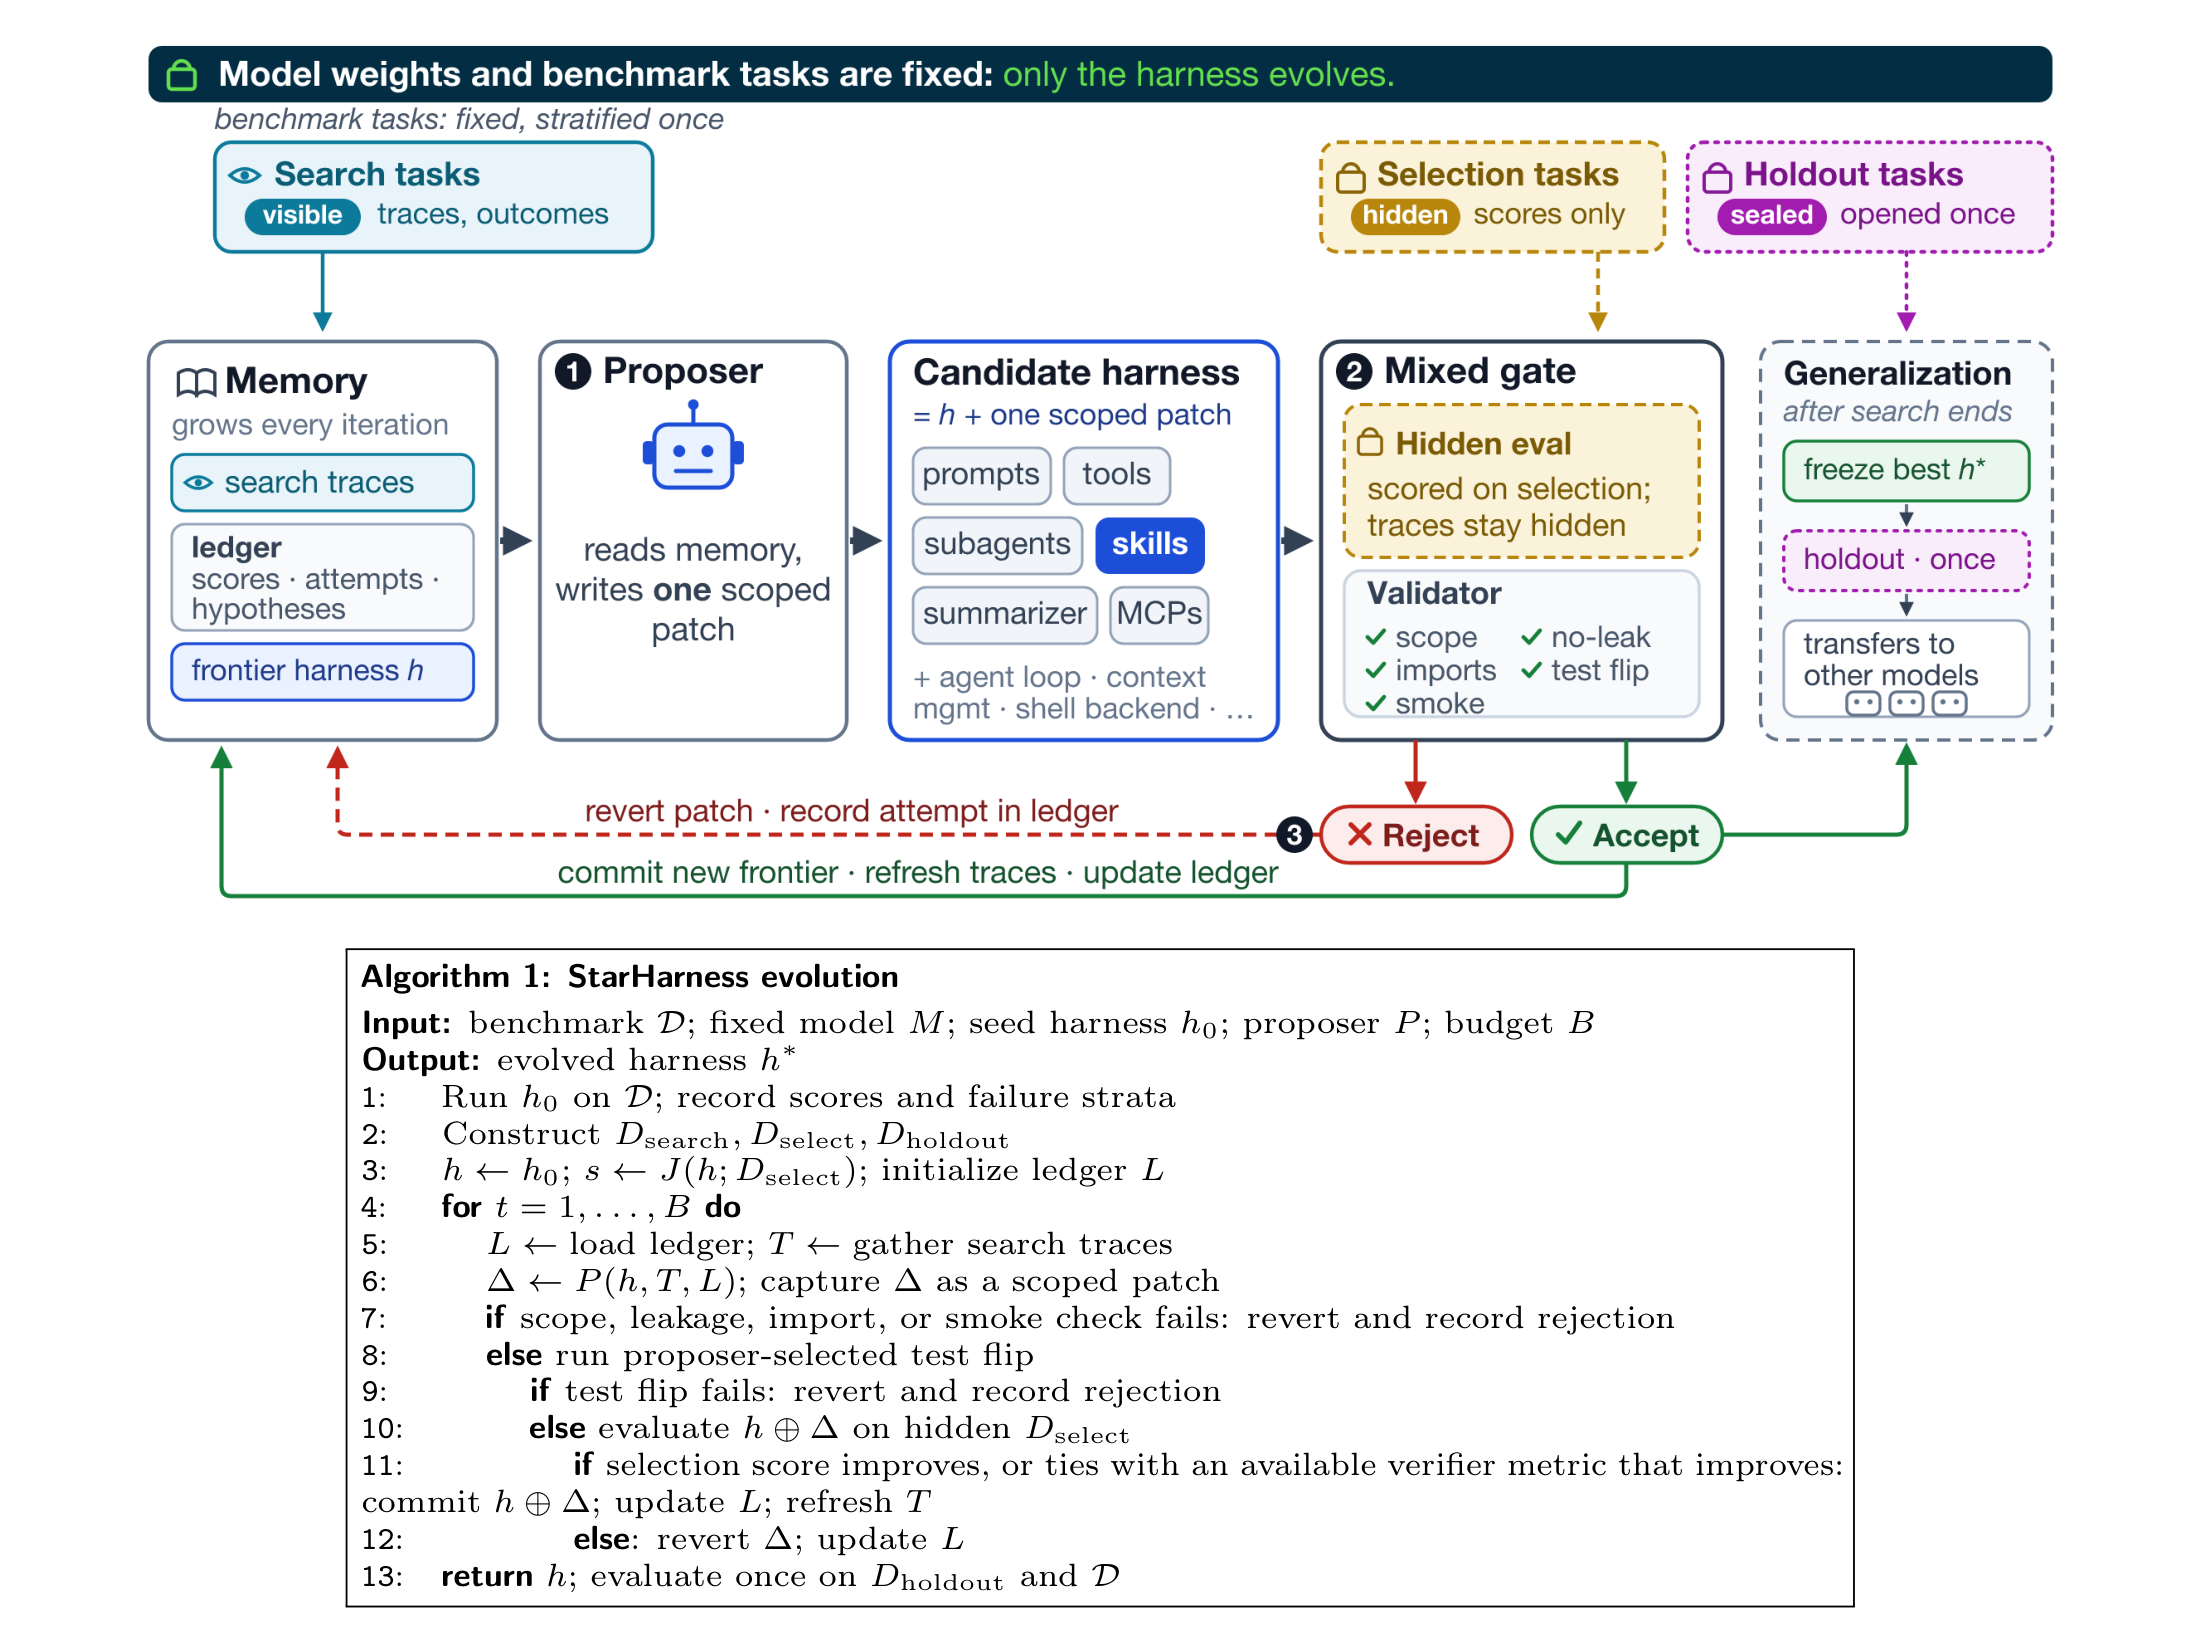
arXiv:2608.24804 Fig. 1)。严格分离 Proposer-Visible 诊断集、Proposer-Hidden 筛选集与 Held-out 测试集,在企业工具、MCP 与子智能体接口上执行分层演化。5.2 HarnessEvolve:用带答案生成的参考轨迹解决信用分配与遗忘(2026-09-01)
- 论文:HarnessEvolve: Learning from Reference Trajectories for Reliable Agent Self-Evolution
- 范围:主线
- 要解决的痛点:长轨迹末尾只有一个成功/失败信号时,信用分配失灵;同时无保护的修改容易引发捷径学习(Shortcut Learning)和灾难性遗忘(Catastrophic Forgetting)。
- 核心机制:
- 角色四分离:将执行(Execution)、评估(Evaluation)、优化(Optimization)和准入(Gating)拆给四个相互独立的模块。
- 参考轨迹对齐(Reference Trajectory Alignment):在训练阶段,先把标准答案提供给系统生成“参考执行轨迹”,再将失败轨迹与参考轨迹逐段对齐,提取精确的误差信号并聚类出系统性故障模式。
- 双门控准入(Quality Gate + Performance Gate):候选修改必须先过质量门控(过滤数据泄漏、硬编码答案和提示词无意义膨胀),再过性能门控(要求在当前批次上有提升,且在最近的历史批次上不退化),最后在每个 Epoch 结束时用独立验证集选出最佳快照。
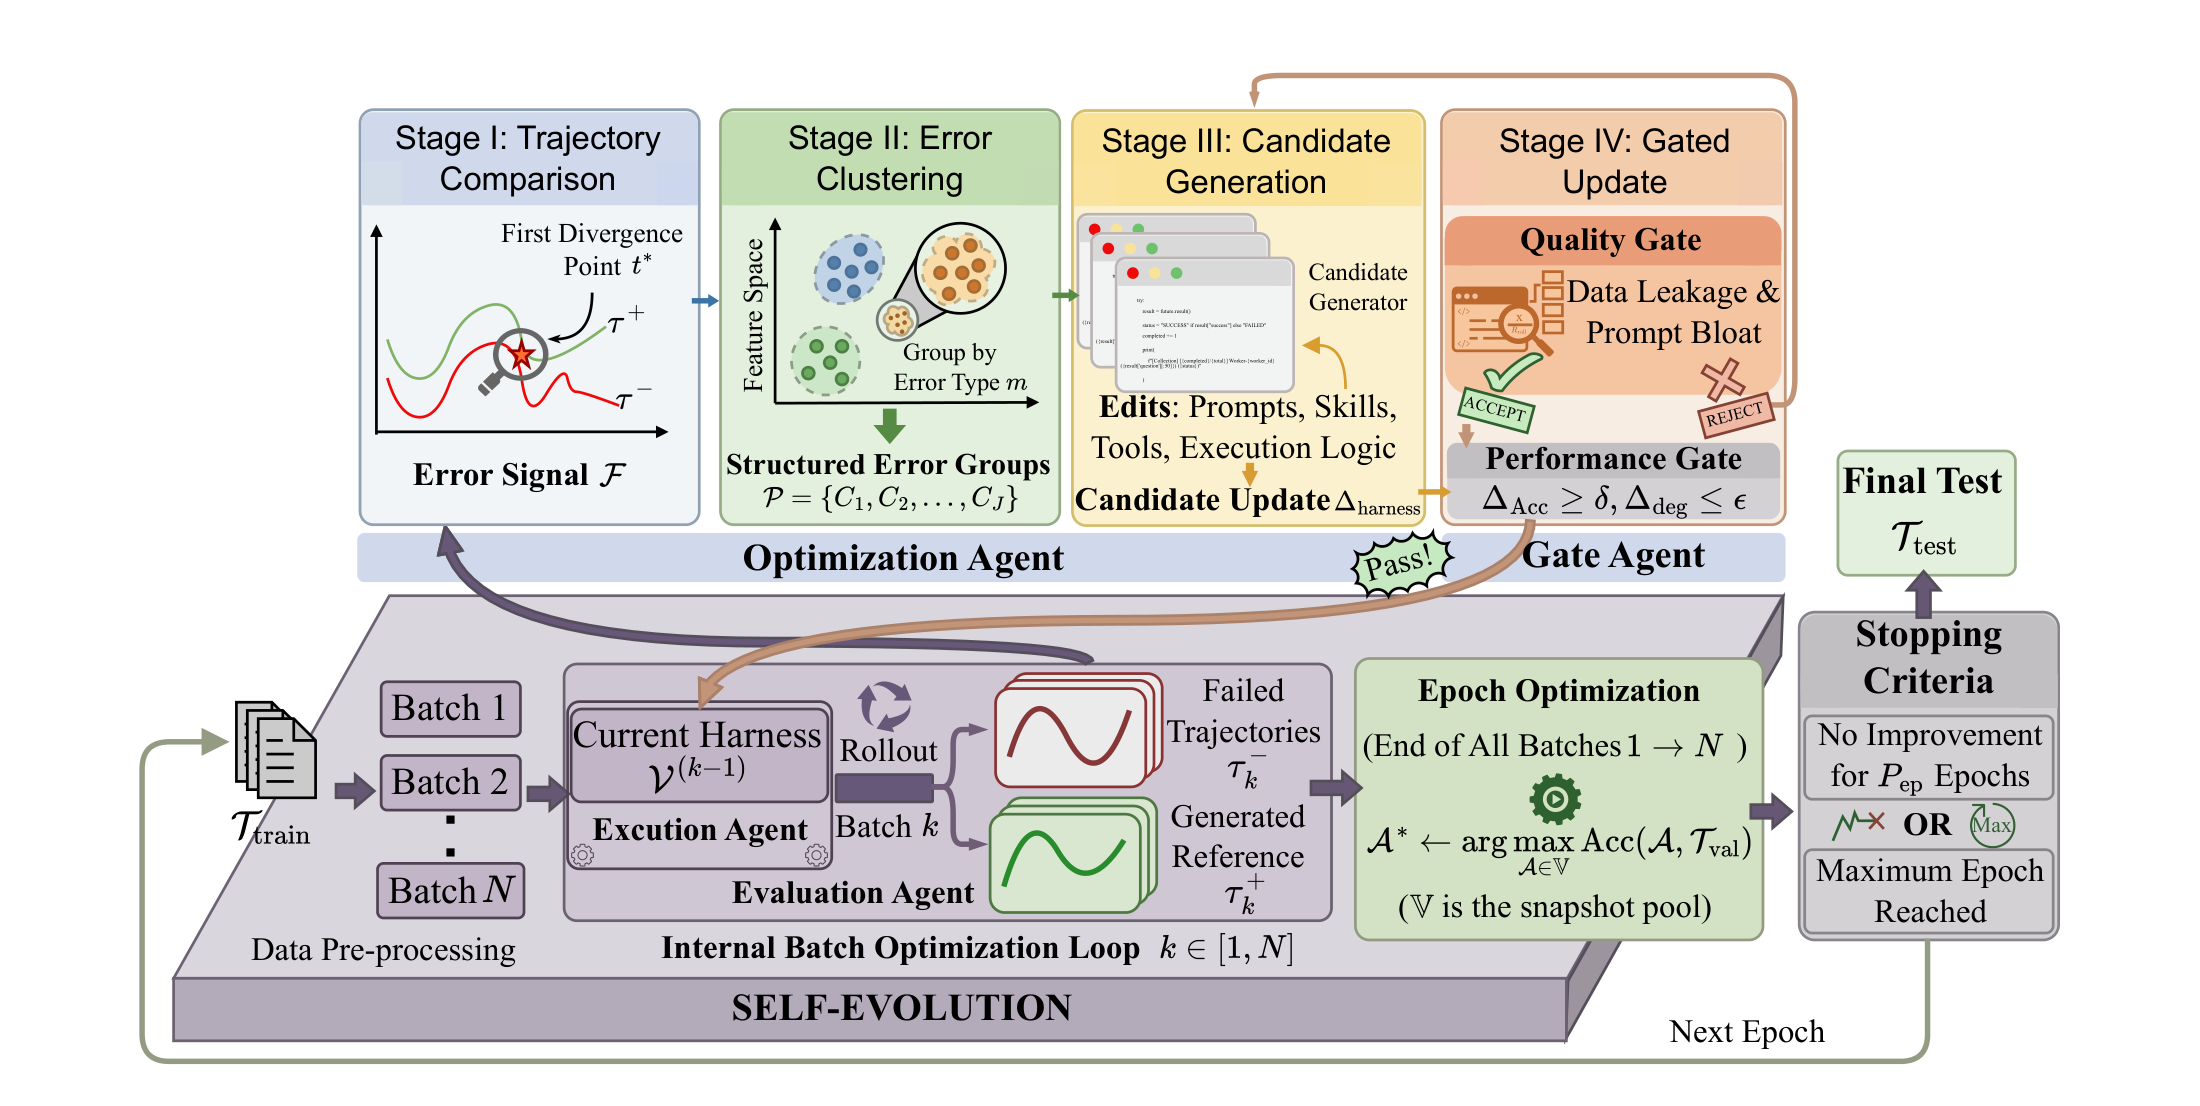
arXiv:2609.00829 Fig. 1)。利用标准答案引导生成参考轨迹并与失败轨迹逐段比对,配合 Quality Gate 与 Performance Gate 拦截捷径作弊与历史回归。5.3 RRSI:给 Harness 演化加上退火预算、防刷榜 Critic 与剪枝器(2026-09-21)
- 论文:RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
- 范围:主线
- 要解决的痛点:无约束的 Harness RSI 在演化集上往往涨分猛烈,但一到分布外(OOD)基准上增益就大幅缩水甚至归零,同时留下一堆冗长昂贵的无用规则。
- 核心机制:首次将机器学习中的**正则化(Regularization)**系统引入 Harness 演化,同时约束 Proposer 与 Selector:
- 时间退火修改预算(Temporally Annealed Budget):限制单次候选能打包的编辑数量,随迭代推进逐步收紧预算,并根据演化历史鼓励探索尚未覆盖的轨迹方向。
- 防特化审查器(Critic):在准入阶段专门审查并拦截那些只对当前 Benchmark 特有格式或题型生效的狭隘修改。
- 减法剪枝器(Pruner):定期移除那些增益低于噪声门槛、Token 开销过高或已被后续机制替代的冗余修改。
- 实验结论:在涵盖代码、工作区操作与工程设计的 8 个基准上,RRSI 在演化集上提升最高 +6.0 分,在 5 个完全未见过的 OOD 基准上提升最高 +4.3 分,同时生成的 Harness 比无正则化演化节省了 30% 的策略 Token。
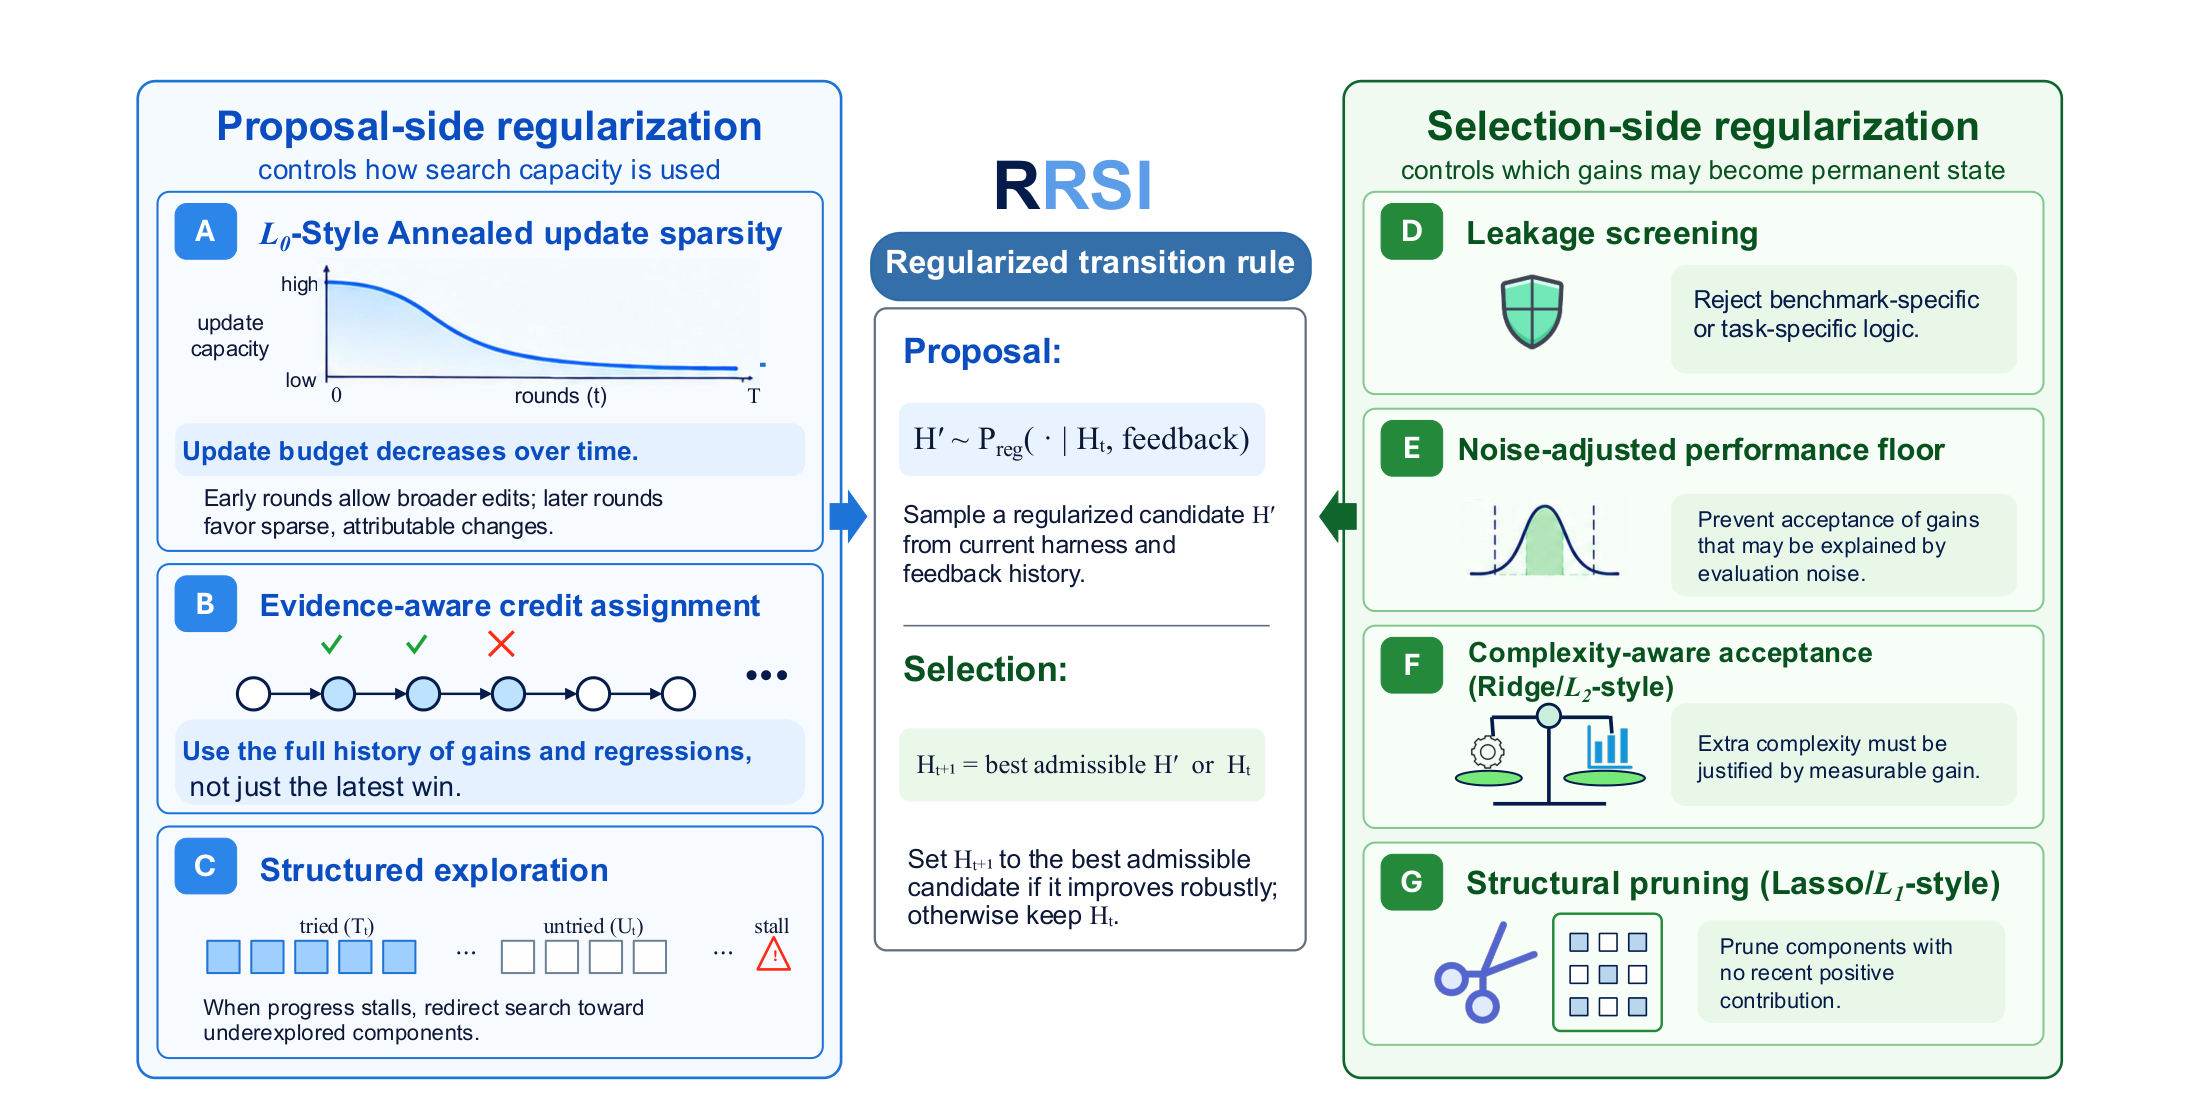
arXiv:2609.24972 Fig. 1)。将正则化引入 Proposer(修改预算退火与探索引导)和 Selector(防特化 Critic、噪声门槛与减法剪枝器),抑制评测集过拟合。6. 支流三:有限预算下怎么搜、怎么跑?——免奖励搜索、组合 Bandit 与运行时砍 Token
无论是搜索阶段的数千次评测,还是部署阶段翻倍的上下文开销,成本都是阻碍 Harness RSI 落地的一道硬门槛。近三个月有 5 篇主线工作专门从“砍搜索成本”和“砍运行时 Token”两个方向给出了定量方案:
| 工作 | 首次日期 | 优化阶段 | 核心降本手段 | 代表性量化收益 |
|---|---|---|---|---|
| SoL-Pi | 2026-09-17 | 运行时流量 | 535 环境自动研究筛出四项正交原语(同轮融合、观察值句柄化、带逐字节校验的日志委派、基于缓存负债方程的边界压缩) | EdgeBench 保留 93.7%–94.3% 得分,Token 流量降 44.7%–49.0%,API 成本相对 Codex/Claude Code 降 50.0%–54.3% |
| SelfSearch | 2026-09-29 | 搜索阶段 | 免下游奖励(Reward-Free)搜索:利用过往自修改过程的推理与操作记录直接指导新修改,搜索期不反复跑下游评测 | 仅花 $4.03 搜索成本,在 Terminal-Bench 2.1(DeepSeek V4 Flash)达到 82.0%(追平榜首 Codex);SWE-bench Multilingual +5.0 分且执行成本降 38.5% |
| MESH-Harness | 2026-10-04 | 搜索 + 运行 | 模块化候选池 + 全协方差 LinUCB Bandit + 混合起点坐标上升,避免枚举指数级模块组合空间 | 同评测预算下比 Meta-Harness 高 2.00–7.01 分;测试期开销低 44.2%,含搜索总成本低 14.6% |
| HarnessPro | 2026-10-19 | 搜索 + 多档部署 | LLM 生成测试做无标签评估;按归一化加权平方距离输出 lite / medium / heavy 三档预算配置 | GPT-5.5 + Codex 下,Heavy 模式比 RHO 平均通过率高 2.0 个百分点,单任务成本降 26.1% |
| HarnessMM | 2026-10-23 | 运行时推理 | 可执行决策图(Executable Decision Graphs)+ 受保护决策复用(Guarded Decision Reuse),用原生接口替换重复的慢模型回调 | HumanEval 上 Codex 保持 90.82% 成功率、Token 降 29.54%;DeepSeek Harness 成功率从 71.43% 升至 85.71%、Token 暴降 87.93% |
下面具体看这五项工作里的关键设计:
6.1 SoL-Pi:用大规模 Auto-Research 搜出四项正交降本原语(2026-09-17)
- 论文:SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness(本站已有单篇源码级深度拆解)
- 核心设计:NVIDIA、NTU 与 MIT 团队在 535 个隔离环境中对 152 个假设做广度—深度搜索,要求候选必须先过“能力不退化门禁”再过“效率提升门禁”。最终留存的四项机制全部做成零侵入 Pi 宿主代码的扩展:
- Action Fusion:在
edit/write工具上挂载then_run参数与双重 SHA-256 校验,省掉“改完文件再单独发一轮请求跑测试”的空转轮次; - ObservationPack:只保留最近 2 轮大体积工具输出,更早的输出在
context投影层原地替换为短句柄(如obs_xxxx),按字节偏移分页召回,既省重放又不破坏 Prompt Cache 前缀; - Evidence-Preserving Reducer:用廉价小模型提取长诊断日志中的报错行,但强制执行
body.includes(quote)逐字节子串核验,校验不过立即回退原日志,杜绝小模型幻觉; - Online Context Compact:只在子任务完成边界触发压缩,且显式计算 Prompt Cache 重写负债(
cacheWriteReadRatio)与剩余请求视野的盈亏平衡方程,确认真能省钱才动手压缩。
- Action Fusion:在
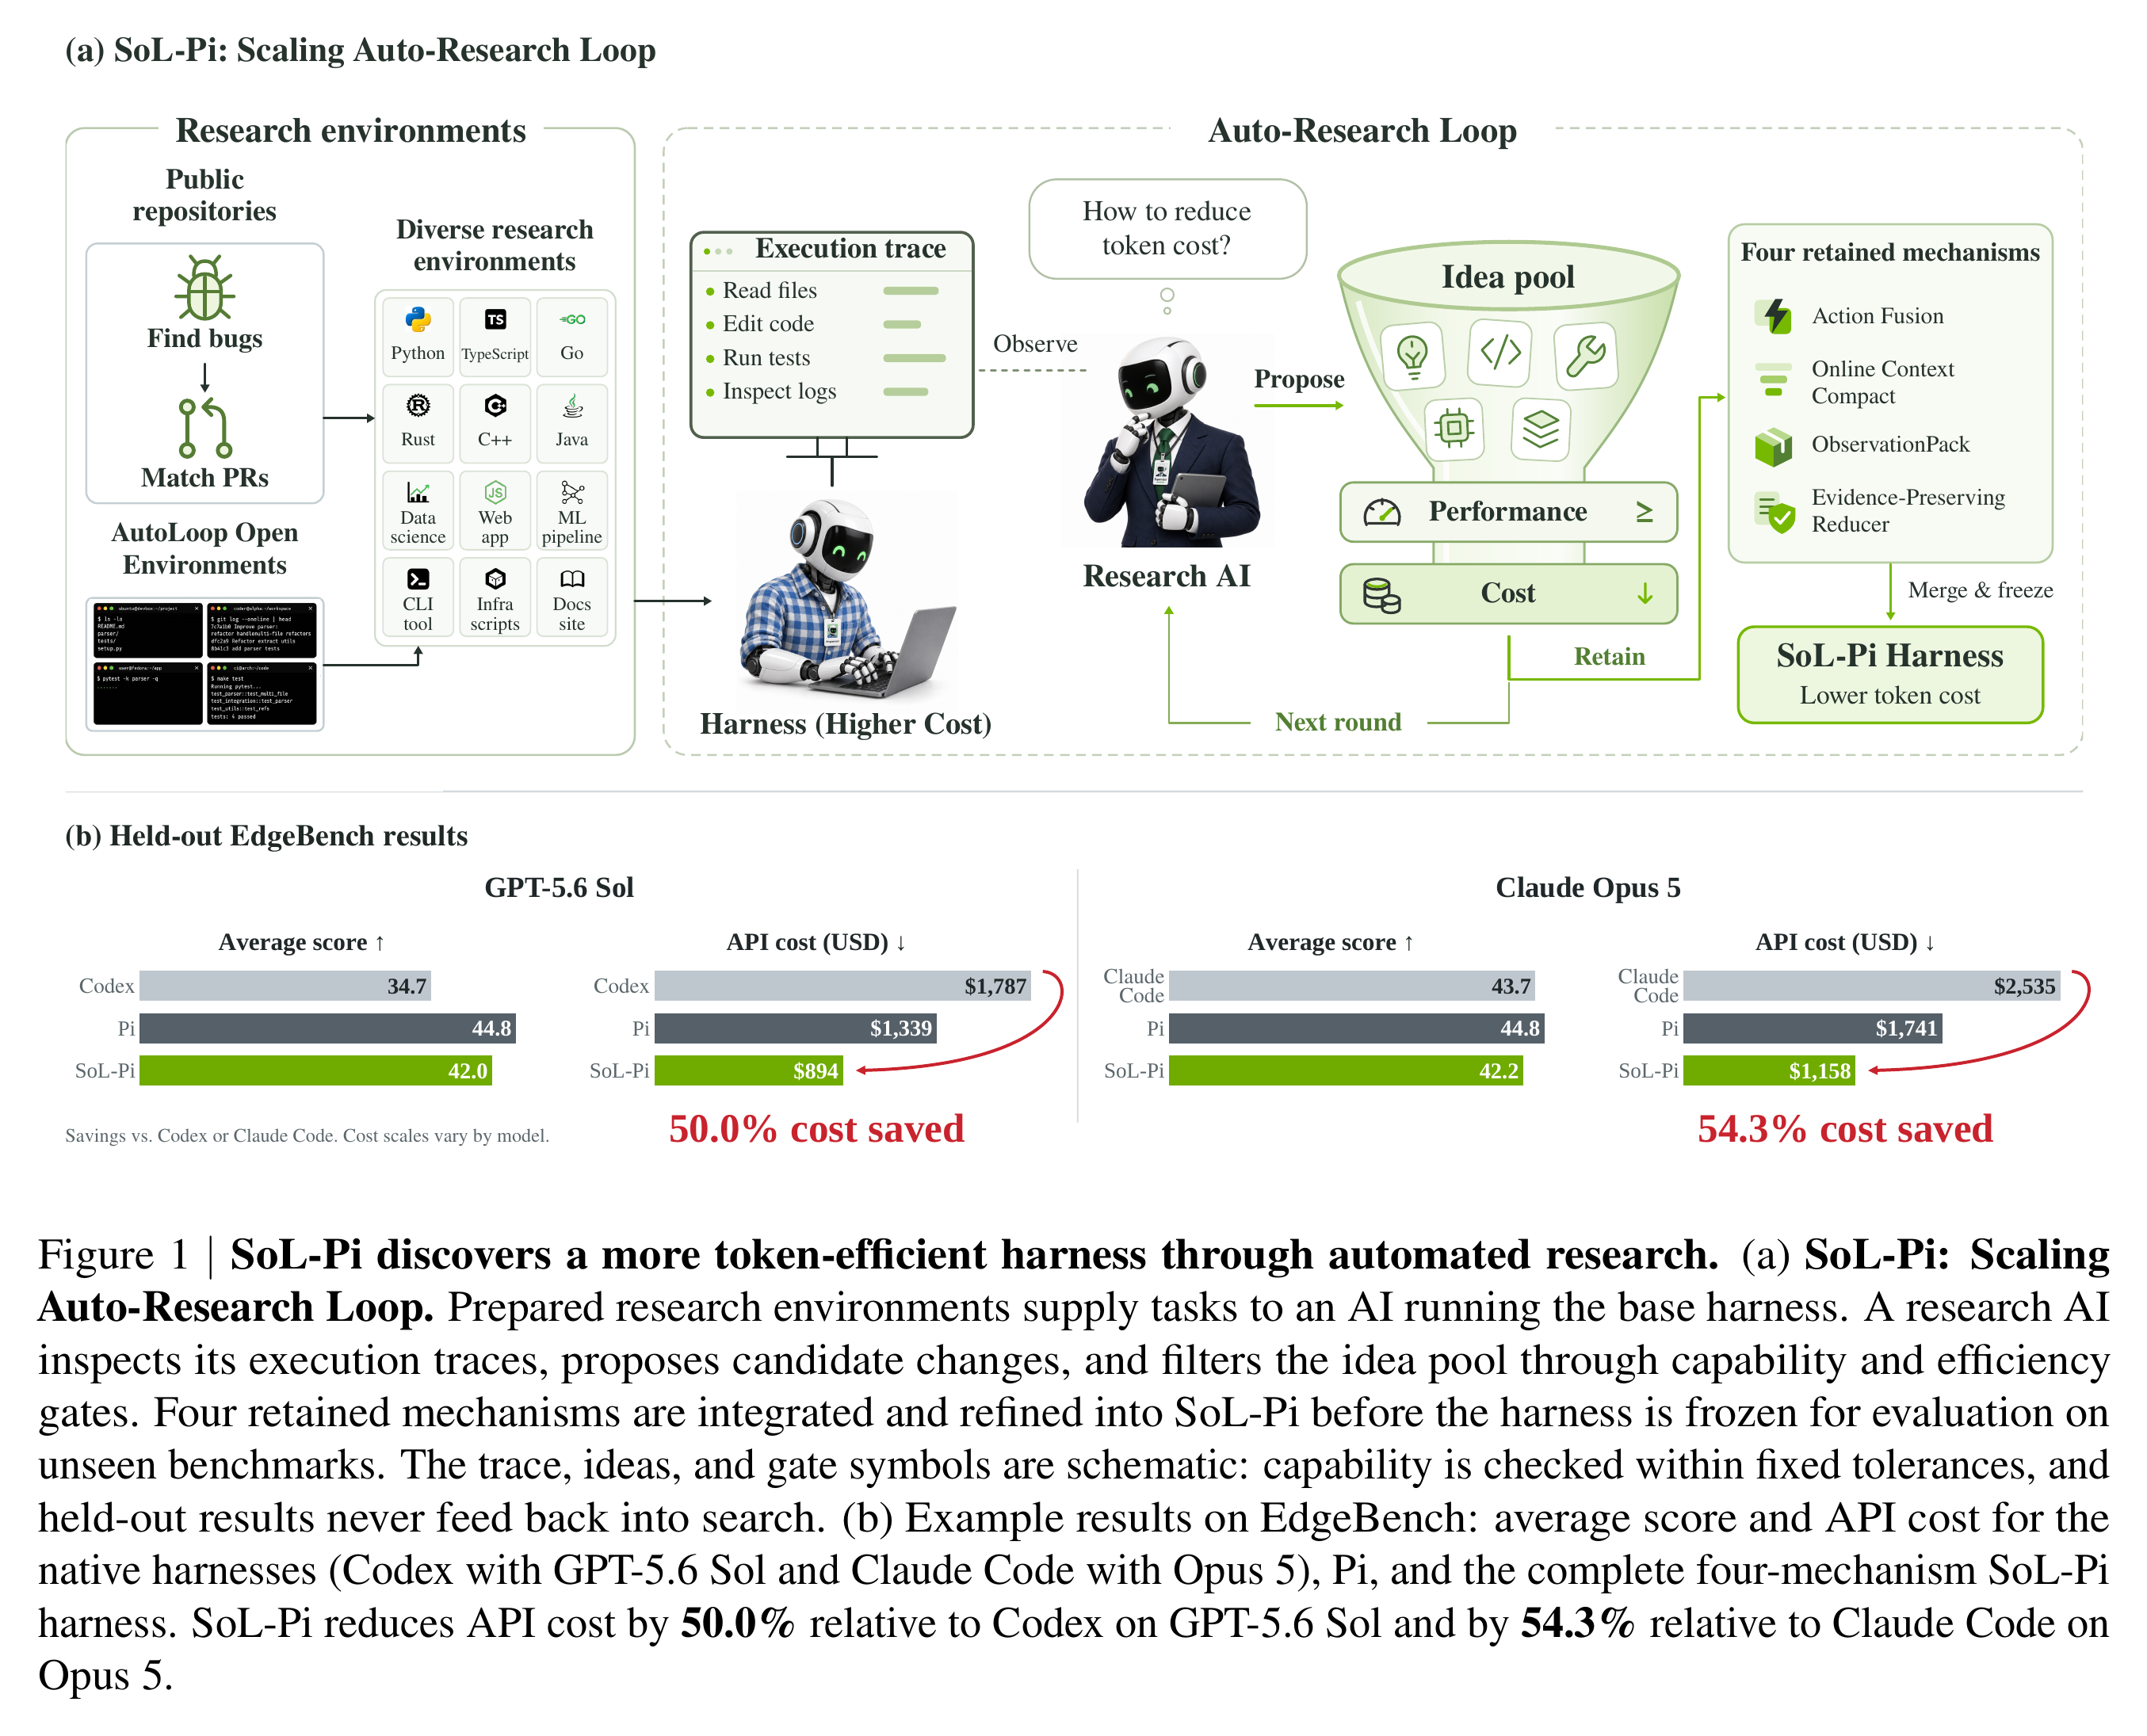
arXiv:2609.20519 Fig. 1)。在 535 个隔离环境中对 152 个优化假设进行递归广度—深度搜索,通过能力保底与效率门禁筛出四项正交降本扩展。6.2 SelfSearch:只花 4 美元搜索费的免奖励自修改(2026-09-29)
- 论文:SelfSearch: Reward-Free Search for Self-Improving Agents
- 核心洞察:现有方法之所以贵,是因为每改一次代码就要去下游 Benchmark 上跑一轮完整评测拿 Reward。SelfSearch 提出了一种反直觉的 Reward-Free Search:在搜索阶段完全不调用下游任务奖励,而是让 Agent 读取“过去自修改尝试的完整过程记录(包含当时为什么这么改、调用了什么工具、改出了什么结果)”,直接依靠自修改经验迭代种群。
- 实验结论:在全部 6 个“模型—基准”组合中,SelfSearch 的种群平均成功率均超过初始 Agent,在 Terminal-Bench 2.1 上单 Agent 最高提升 +11.2 个百分点。最夸张的是成本对比:仅凭 $4.03 的搜索开销,它为 DeepSeek V4 Flash 搜出的 Harness 在公开 9-Harness 对比协议下解决了 82.0% 的 Terminal-Bench 2.1 任务,直接追平当时得分最高的原生 Codex Harness。
arXiv:2609.37968 Fig. 1)。对比传统奖励引导搜索(左)与 SelfSearch 免下游奖励搜索(右):搜索阶段直接复用过往自修改过程的推理与操作记录迭代种群。6.3 MESH-Harness:把整包搜索拆成模块池 + Bandit 组合优化(2026-10-04)
- 论文:MESH-Harness: Self-Improving Agent Harnesses via Bandit-Guided Compositional Evolution
- 核心机制:如果一个 Harness 有 5 个功能角色、每个角色有 5 个候选实现,穷举组合就是 3,125(即 )次评测。MESH-Harness 给每个功能模块定义严格的角色接口,维护固定容量的角色候选池(Role-specific Pools),并用共享模块表征 + 全协方差 LinUCB(Full-Covariance LinUCB Bandit) 预测任意模块组合的表现与探索价值,配合混合起点坐标上升(Mixed-start Coordinate Ascent)挑出最有潜力的完整配置去实测,再用验证轨迹指导局部代码微调。在同等评测预算下,它在文本、检索增强数学推理、代码生成和交互式科学任务上全面击败 Meta-Harness(高出 2.00–7.01 分),同时把测试期成本压低了 44.2%。
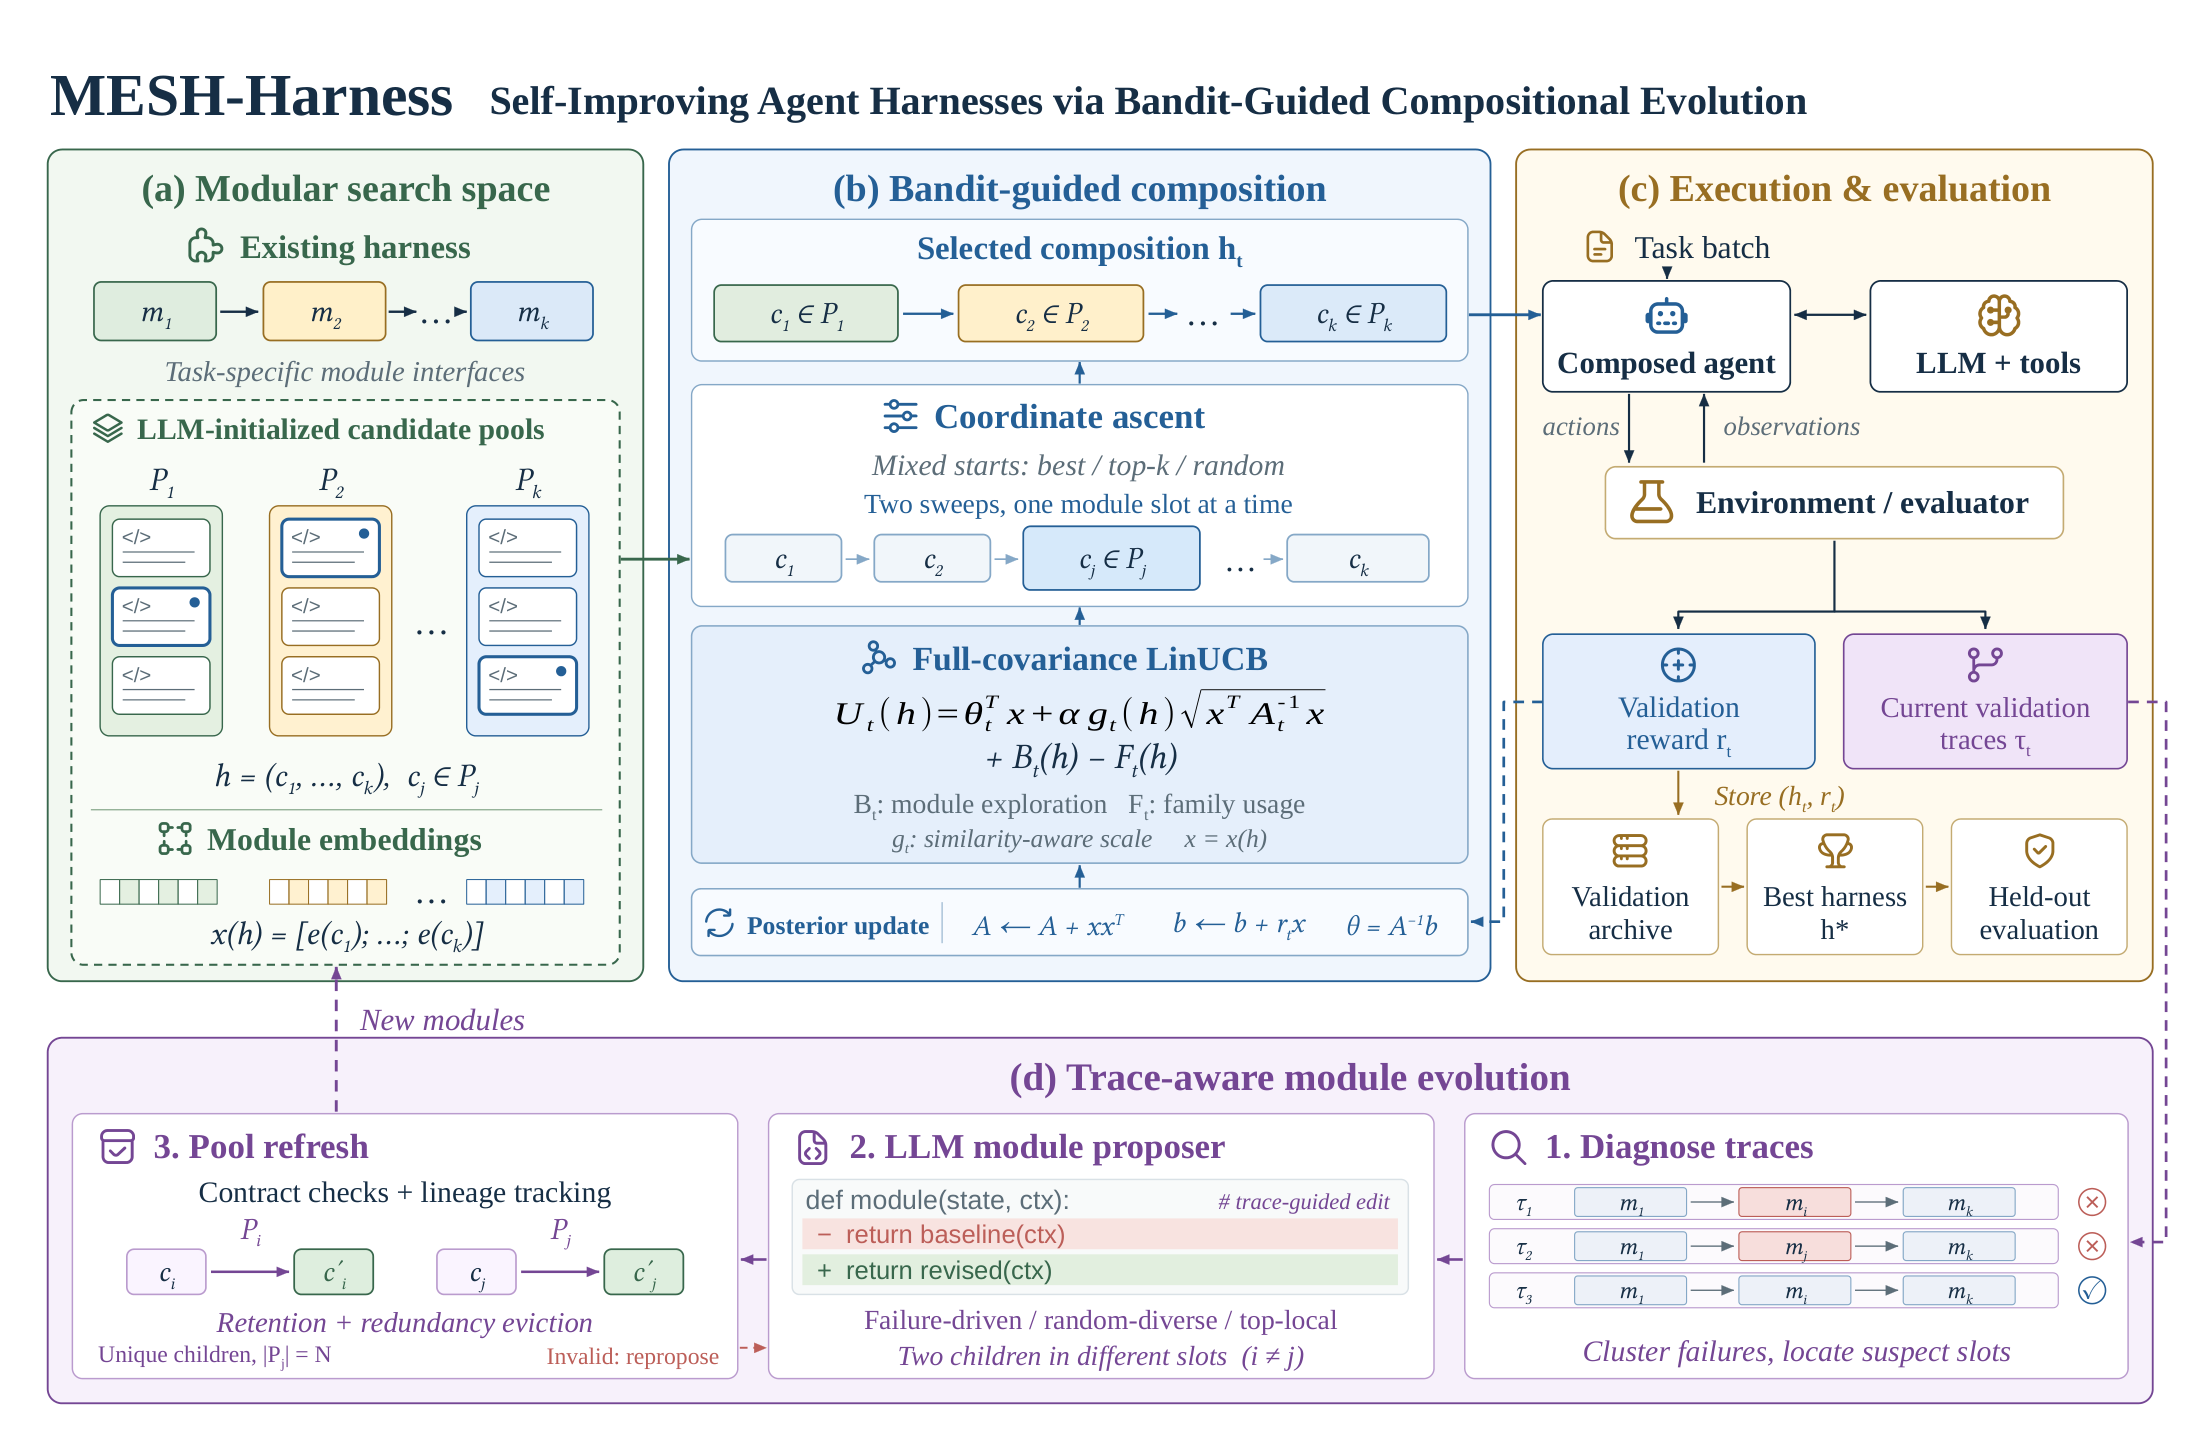
arXiv:2610.05300 Fig. 1)。通过角色候选池、共享模块表征与全协方差 LinUCB Bandit 搭配混合起点坐标上升,在受限评测预算下做模块组合搜索与局部精炼。6.4 HarnessPro:无标签测试评估 + 帕累托三档预算输出(2026-10-19)
- 论文:HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
- 核心机制:解决两个现实部署问题:第一,线上没有标准答案和官方单测怎么办?HarnessPro 用 LLM 自动生成的测试用例做无标签候选评估;第二,不同业务对账单的敏感度不同,为什么只输出一个 Harness?它用多智能体分别按不同性能—成本倾向提议修改,并通过归一化加权平方距离选择,一次性输出
lite(省钱优先)、medium(均衡) 和heavy(性能优先) 三档配置供按需部署。
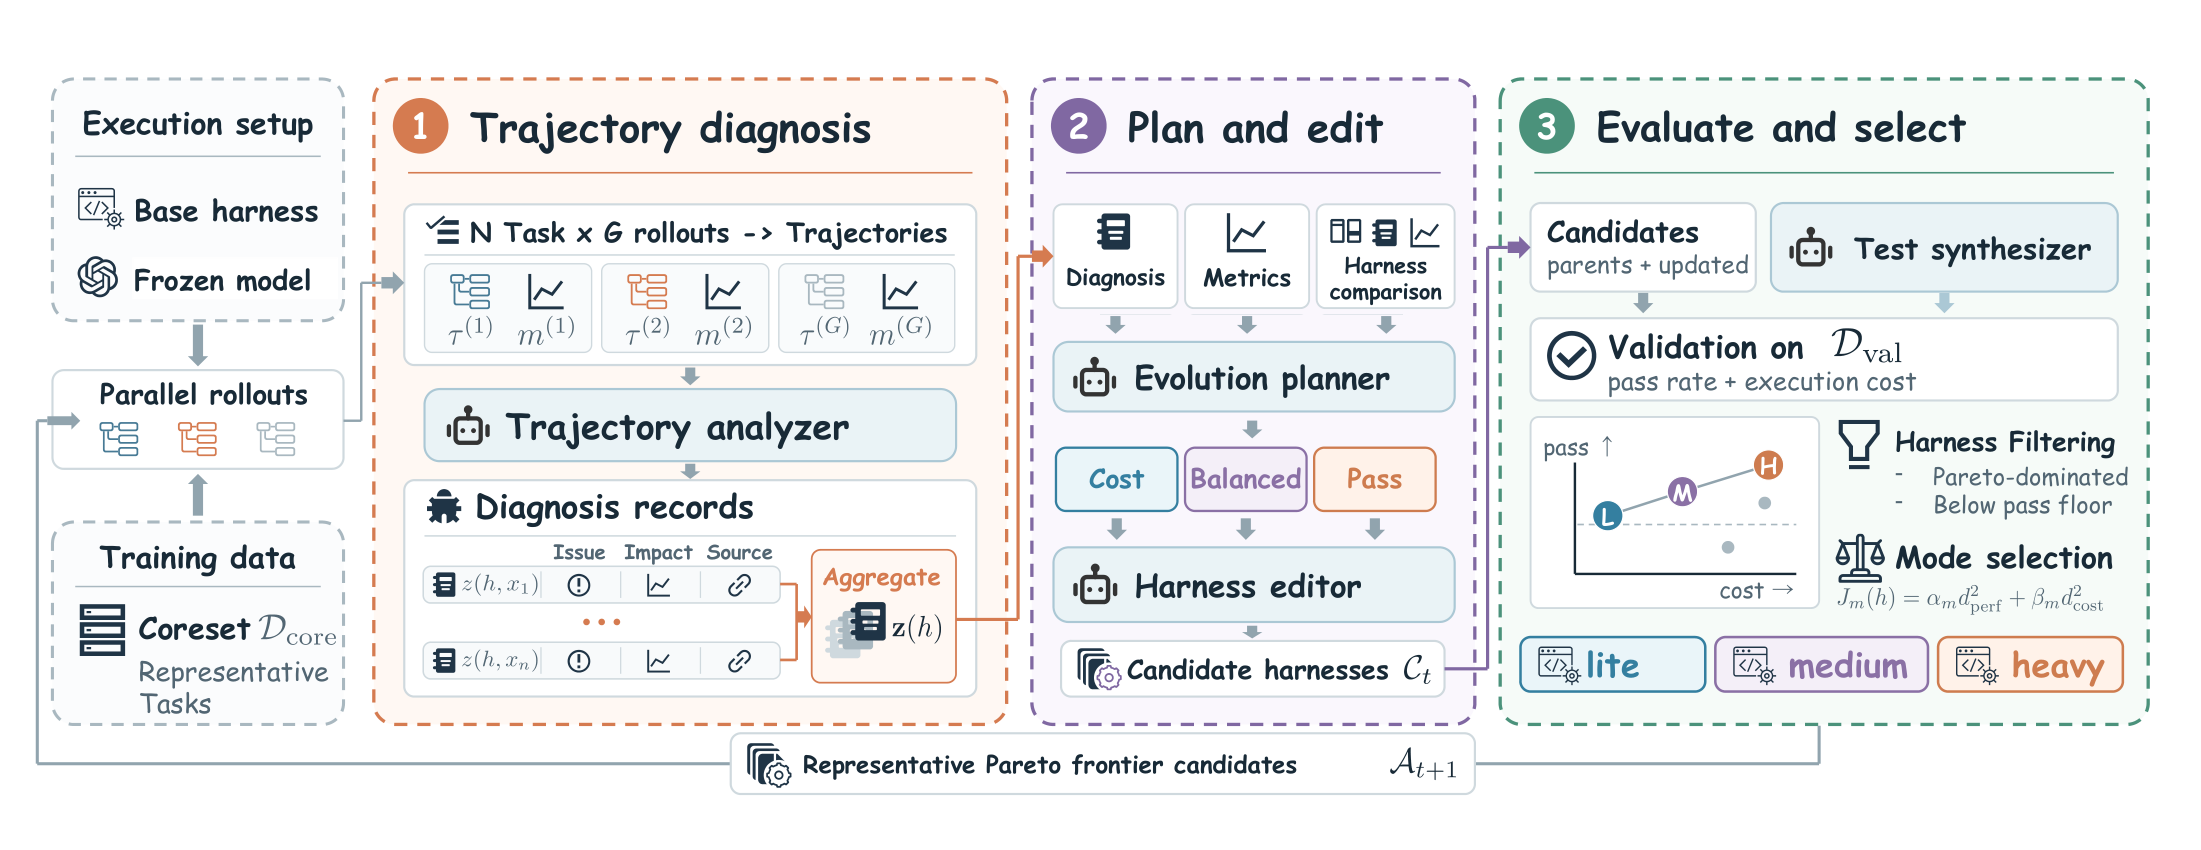
arXiv:2610.26770 Fig. 2)。结合模型自生成测试的无标签评估与帕累托多目标选择,一次性产出 lite、medium、heavy 三档预算配置。6.5 HarnessMM:用受保护的可执行决策图省掉重复推理回调(2026-10-23)
- 论文:HarnessMM: Recursive Self-Improvement for Harness Token Efficiency
- 核心机制:Agent 在收到工具返回后,哪怕下一步动作其实在更早的调用里就已经完全确定了,传统 Harness 还是会把整段上下文发回给大模型再做一次慢速推理回调(Slow Callback)。HarnessMM(Harness Minus Minus)在模型与工具边界之间加了一个控制器,用 Executable Decision Graphs(可执行决策图) 存储精确动作、字面参数、因果依赖与公共守卫条件(Public Guards)。运行时只要观察到的工具回执满足守卫条件,就通过 Certified Callback Substitution 直接复用已确定的决策并注销慢回调;一旦遇到新语义分支或证据不足,立即无缝回退给原模型。在 DeepSeek Harness 上,这一机制把单任务 Token 从 96.28k 砍到了 11.62k(节省 87.93%),成功率反而从 71.43% 升至 85.71%。
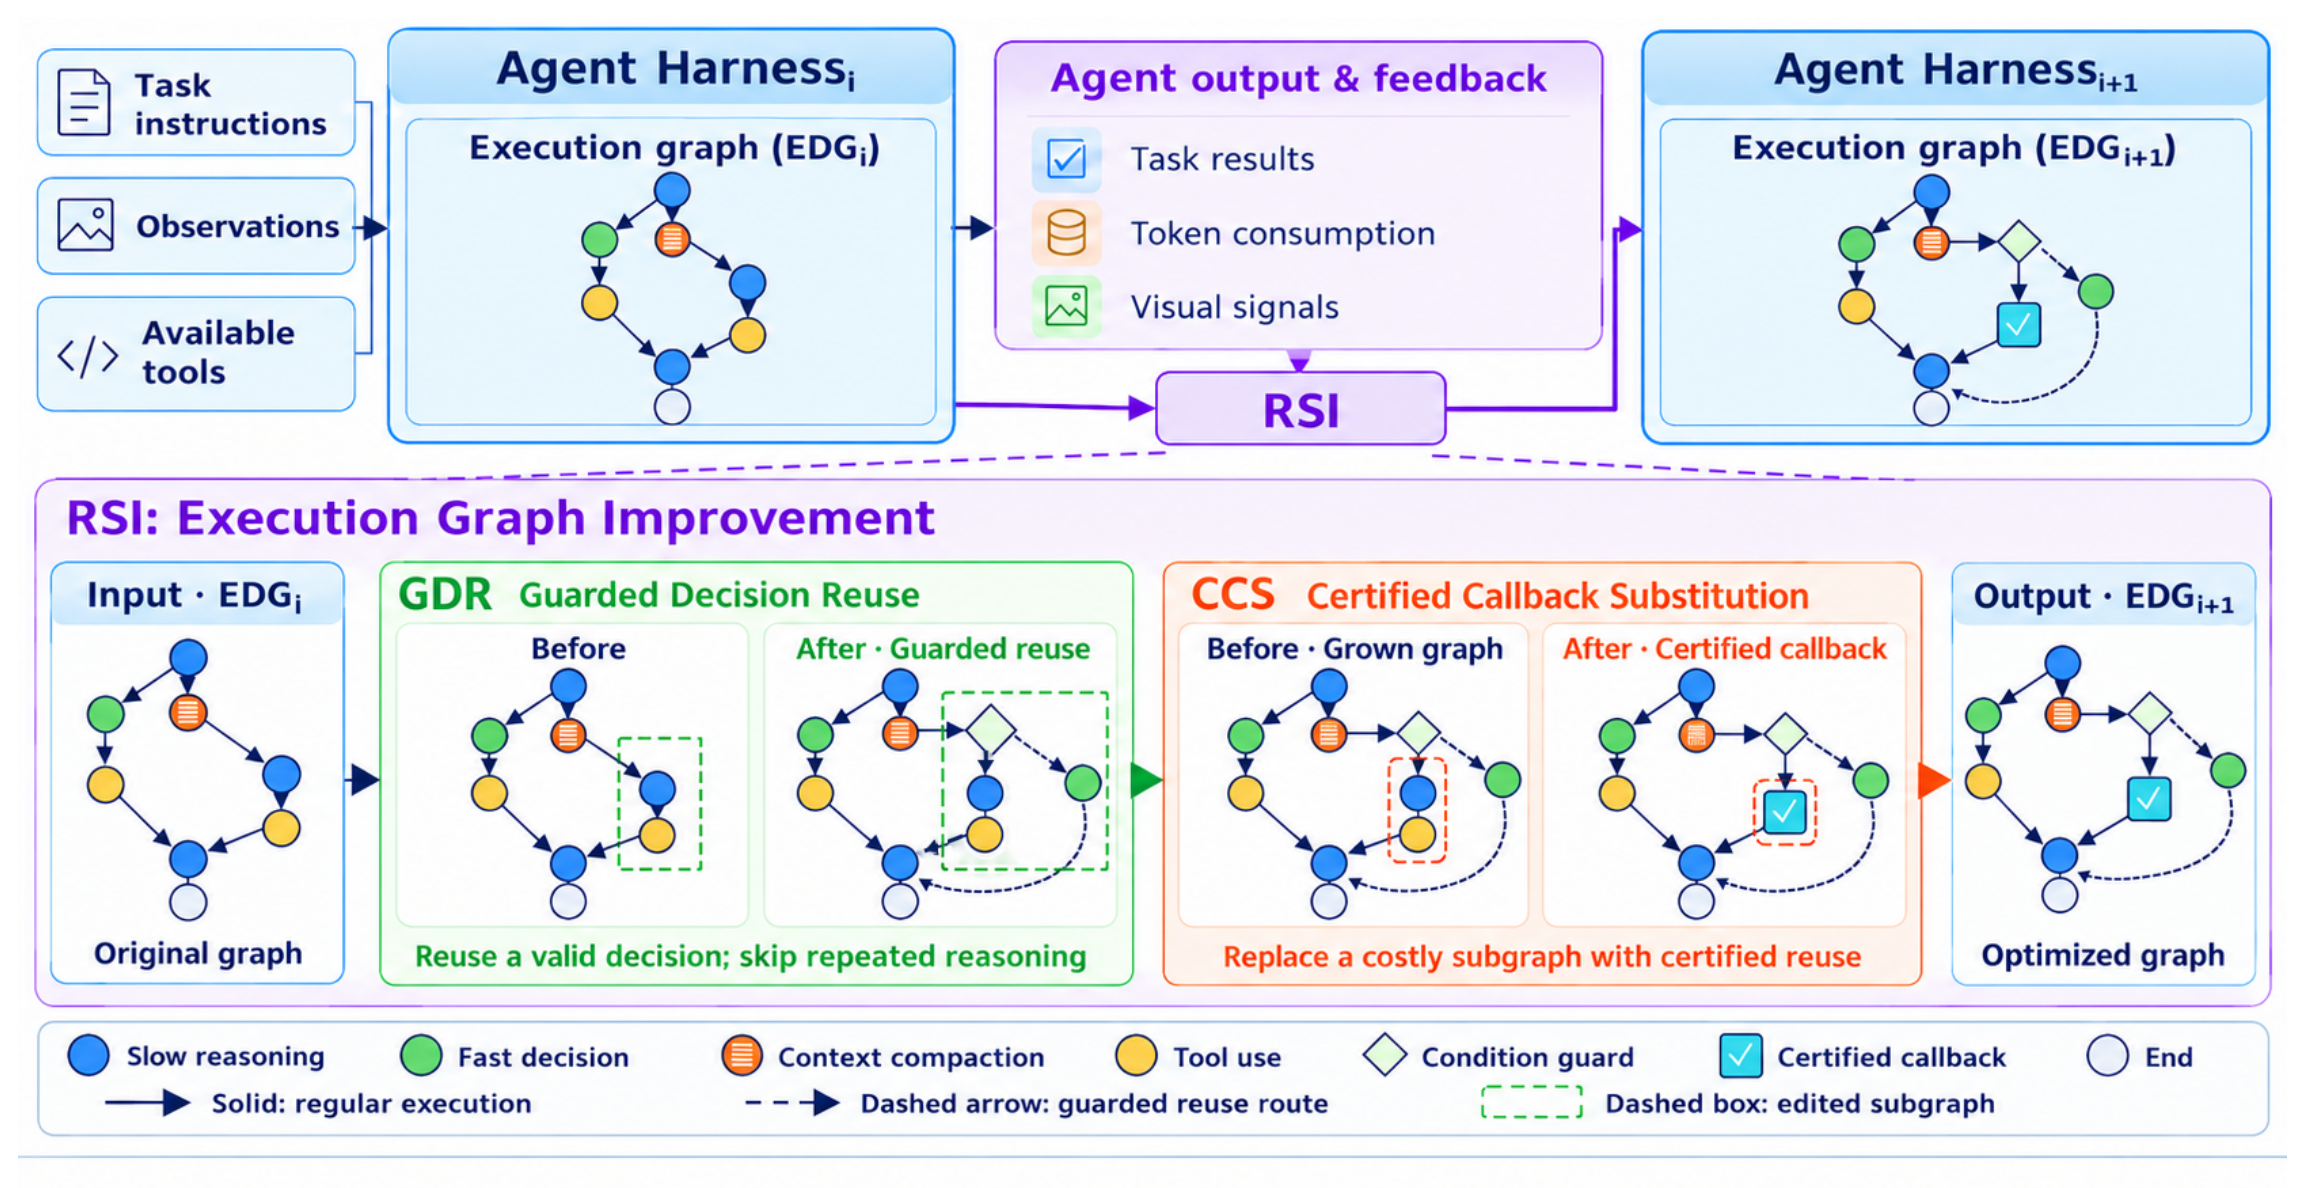
arXiv:2610.32813 Fig. 1)。通过演化可执行决策图(EDG),在满足公共守卫条件时执行受保护决策复用(GDR)与认证回调替换(CCS),跳过重复的慢速推理回调。7. 支流四:优化器自己怎么变强?——受验证元进化、递归深度与失败经验共享
如果只改任务执行器 ,负责改代码的优化器(Optimizer / Meta-Agent)自身仍是死板的,那么这只能算“一阶自动调参”。近三个月里,围绕**“递归究竟体现在哪里、怎样让优化器自己也安全进化”**,诞生了 7 篇极具代表性的工作:
7.1 MGM:告别单轨迹闭门造车,引入孟德尔跨任务与跨分支杂交(2026-08-07)
- 论文:Mendel Gödel Machine: Recursive Self-Improving Coding Agents via Comparative Evolution
- 范围:主线(演化算子升级)
- 核心机制:早期的 DGM 每次自修改基本只盯着单条失败轨迹做无性克隆变异(Clonal Mutation),浪费了档案库里丰富的对比信号。MGM 借鉴孟德尔遗传学,新增了两类对比自修改算子:
- 反应规范变异(Reaction-Norm Mutation):同时读取同一 Agent 在多个任务上的轨迹,识别系统性行为模式后再动手修改;
- 跨谱系杂交(Cross-Lineage Hybridization):当当前分支在某任务上失败时,引入另一条演化分支在同一任务上的参考轨迹进行杂交重组。理论证明与 SWE-bench / Polyglot 实验均表明,对比演化显著加快了收敛速度并提升了泛化能力。
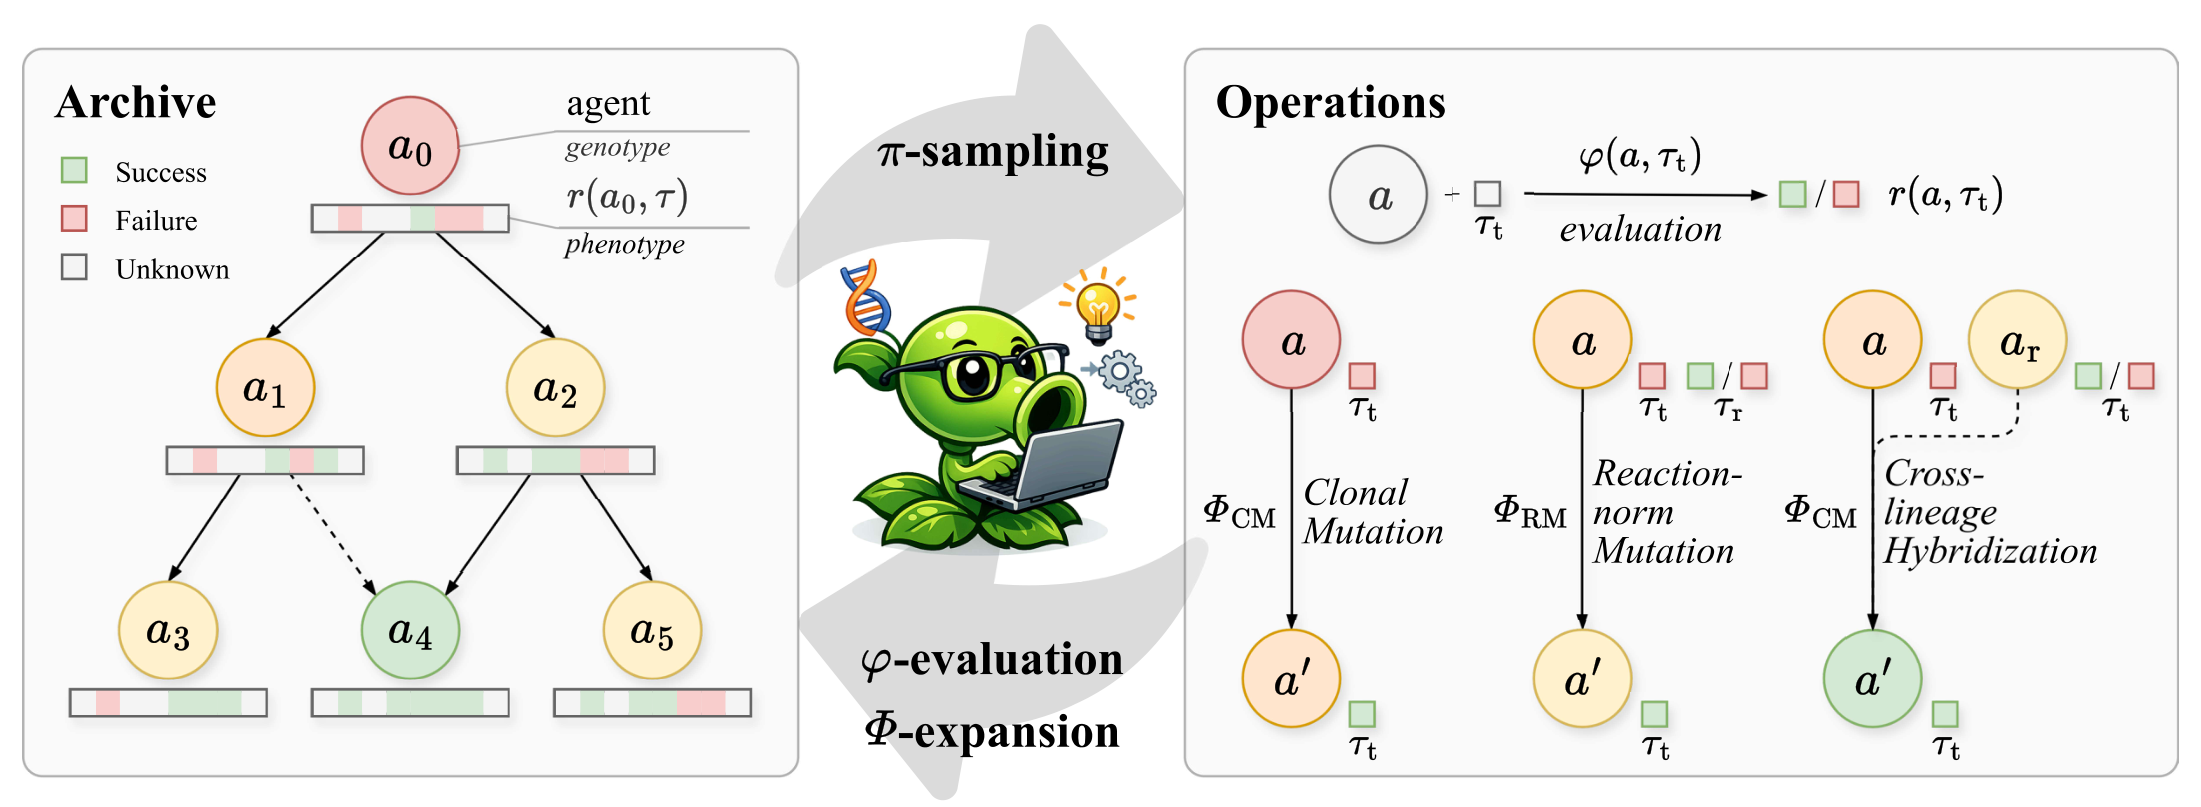
arXiv:2608.07645 Fig. 2)。在单轨迹克隆变异之外引入跨任务反应规范变异与跨谱系杂交算子,充分利用档案库中的对比轨迹信号。7.2 HSI:单模型三层作用域与“执行关思考、修改开思考”解耦(2026-08-09)
- 论文:Hierarchical Self-Improvement: A Framework for Task-Specific Evolvable Agent Harnesses
- 范围:元改进
- 核心机制:用同一个冻结大模型 驱动三层嵌套作用域:底层是按任务族热插拔的 Task Harness ,中层是重写 的 Evolver,顶层是在冻结外部锚点下重写 Evolver 策略代码的 Meta-Evolver。
- 非常巧妙的实验设计:为了严格剥离“模型自己推理变强”和“Harness 演化立功”的贡献,作者采用了 Thinking-off / Thinking-on 机制——在执行下游任务时强制关闭模型的思考链(Reasoning),而在修改 Harness 和 Evolver 时开启思考。在 BALROG 基准(DeepSeek-V4-Flash-Preview)上,HSI 在中等难度任务上大幅提升(BabyAI +39.3%、Crafter +33.0%、TextWorld +25.0%、MiniHack +15.0%),同时作者也诚实界定了两条物理边界:反馈保真度边界(Feedback-Fidelity Bound)与基座能力边界(Backbone Capability Bound,如在完全超出模型能力的 NetHack NLE 上提升为 0)。
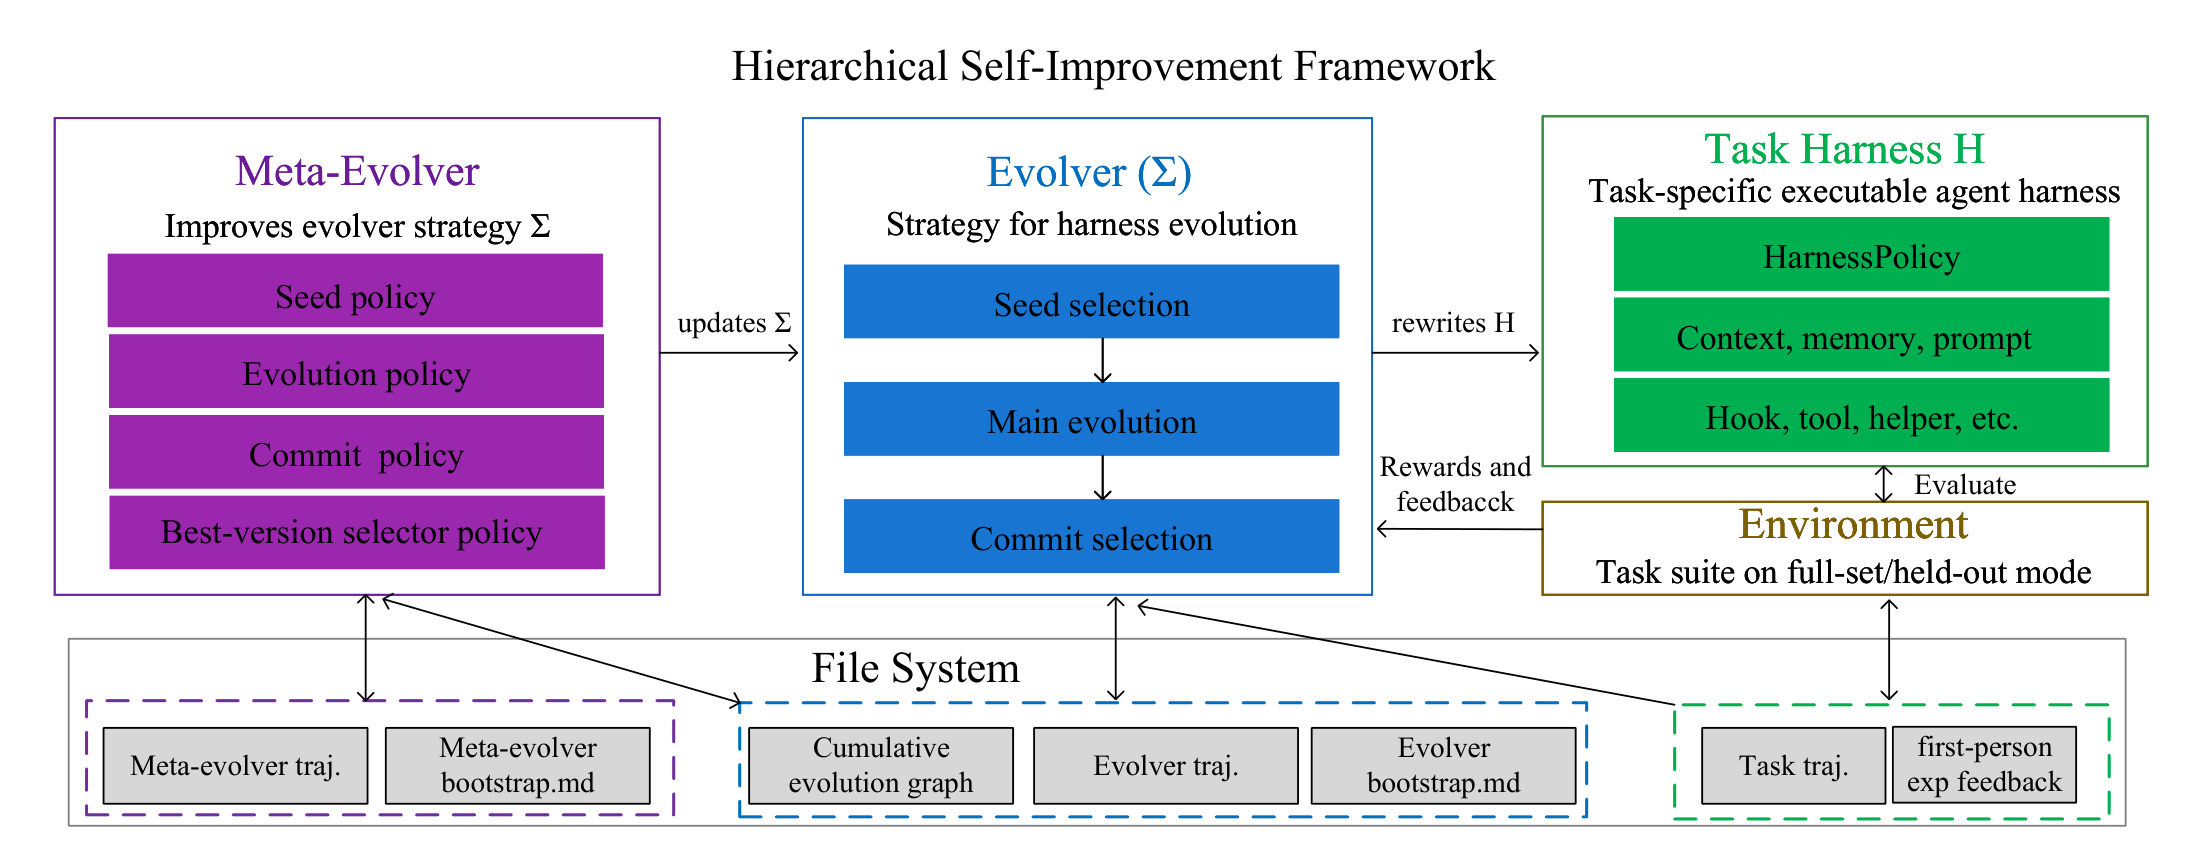
arXiv:2608.08466 Fig. 2)。通过文件系统串联 Task Harness、Evolver 与 Meta-Evolver 三层作用域,在冻结外部评测锚点下同时演化脚手架与演化策略自身。7.3 Metaⁿ:不改元算子以保稳定,靠递归叠加 Solver Stack 涌现深度(2026-08-25)
- 论文:Meta: Recursive Self-Improvement through Emergent Depth
- 范围:元改进
- 核心洞察:如果让元层直接修改自己的编辑代码,系统很容易在多层自改后彻底崩溃(因此既往工作实际深度很难超过 2 层)。Meta 换了一个思路:保持元算子 完全固定,改为在它的输入栈上做无限递归。
- 核心机制:元算子 反复作用于它自己上一轮的产物——读取下方整个 Solver Stack 的源码与执行轨迹,向上新写一层“战略预处理层 + 可调用辅助函数库”。因为 本身不变,系统永远不会自毁;而因为输入栈严格增长,每一层都在比上一层更高的抽象视角上推理,递归深度由收敛情况自动决定。在全部 8 个基准家族上 Meta 均击败既往自改进方法;尤其在专门防技能死记硬背的 ARC-AGI-2 上,它是对比方法中唯一得分大于 0 的系统,且不同层级在没有提示词规定的情况下自发涌现出了不同的分工角色。
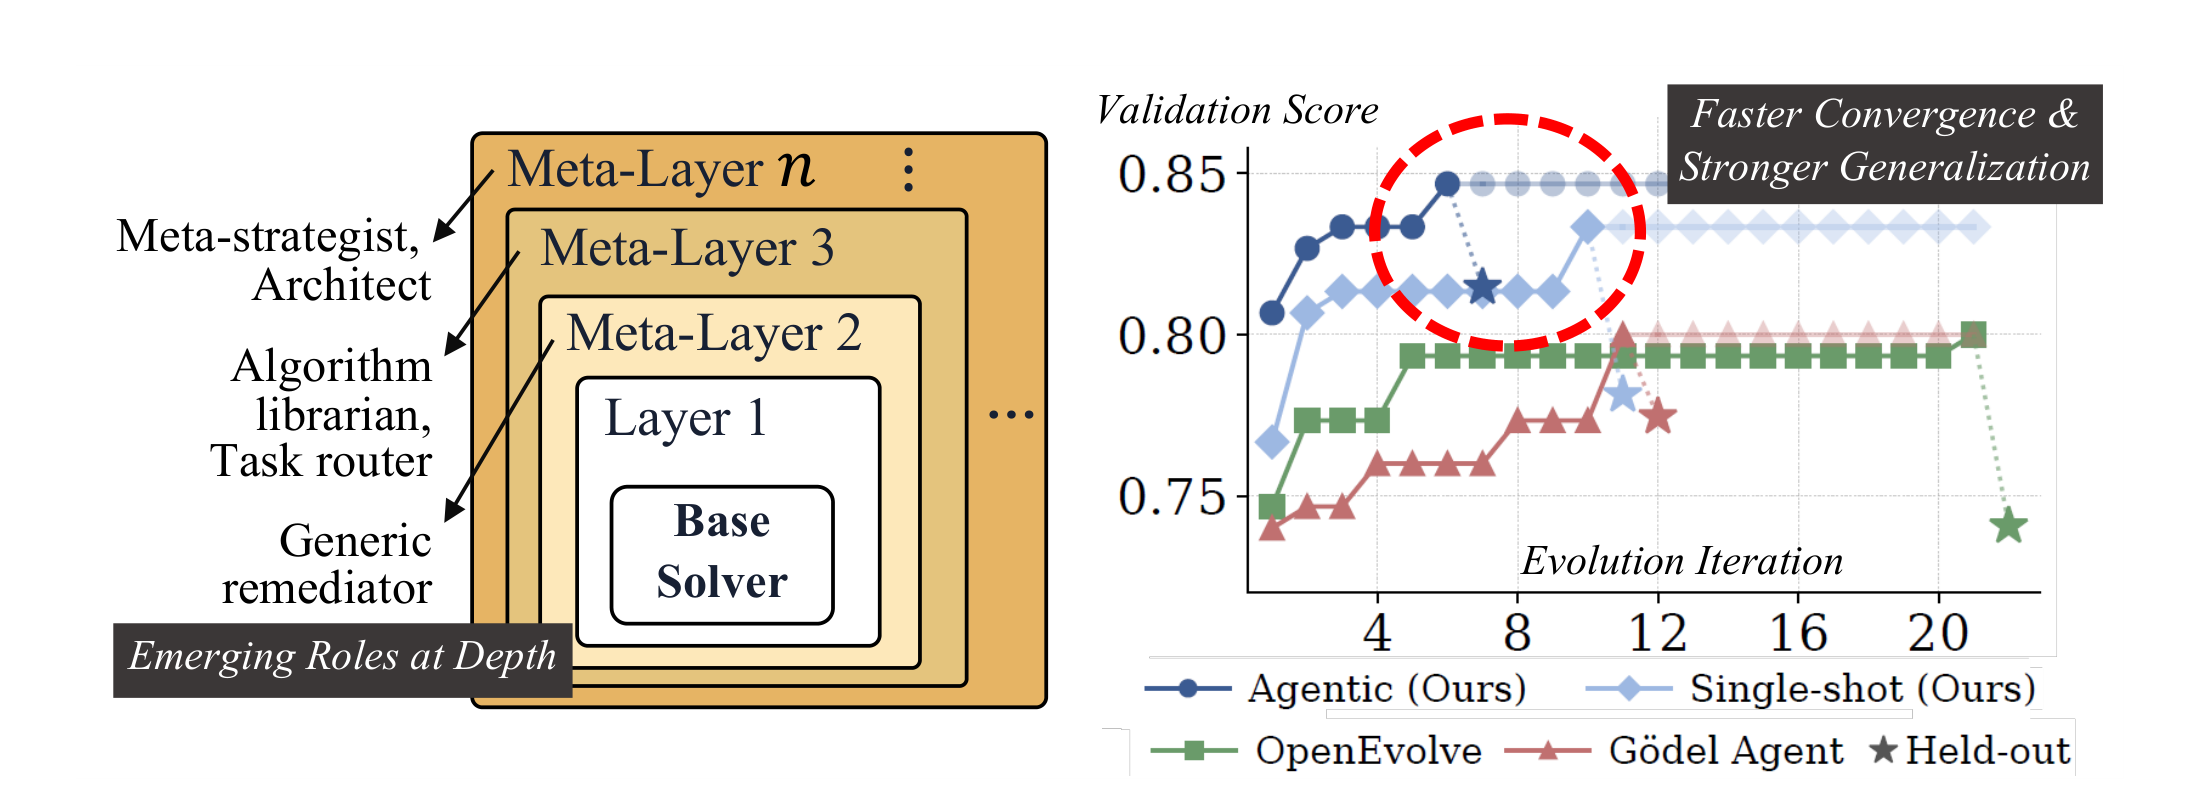
arXiv:2608.24735 Fig. 1)。保持元算子固定、逐层叠加 Solver Stack,使不同深度自发涌现修复器、算法库管理与架构师等角色。7.4 VERSE:为什么优化器自进化必须绑死“执行验证”(2026-10-02)
- 论文:VERSE: Verified Self-Evolving Optimizer for Agent Harnesses
- 范围:元改进
- 核心发现(全篇最关键的对照结论):作者先做了一个受控实验,问了一个尖锐问题:让 Optimizer 修改自己的提示词和工具,到底有没有用? 答案是:如果没有基于执行的验证(Execution-based Verification),优化器自进化完全无法提升性能;但一旦配上执行验证,它立刻取得了全场最高分。
- 核心机制:在 VERSE 中,Optimizer 不仅修改 Executor Harness,还持续修改自己的 Prompts、Skills、Tools、Hooks 和 Notes。在正式提交任何候选修改前,Optimizer 必须先在草稿状态下运行验证、回放历史失败案例、对可疑步骤施加扰动测试(Perturb Suspected Steps),并跨轮次追踪修复与回归。在训练过程中,Optimizer 甚至自己写出了用于失败聚类、验证审计和工作流控制的专属小工具。在共享协议下,VERSE 将全部 4 种基线优化器在 SWE-rebench 留出集和 5 语言 OOD 任务上的最高准确率分别从 39.2% / 29.3% 推高到 42.3% / 37.7%。
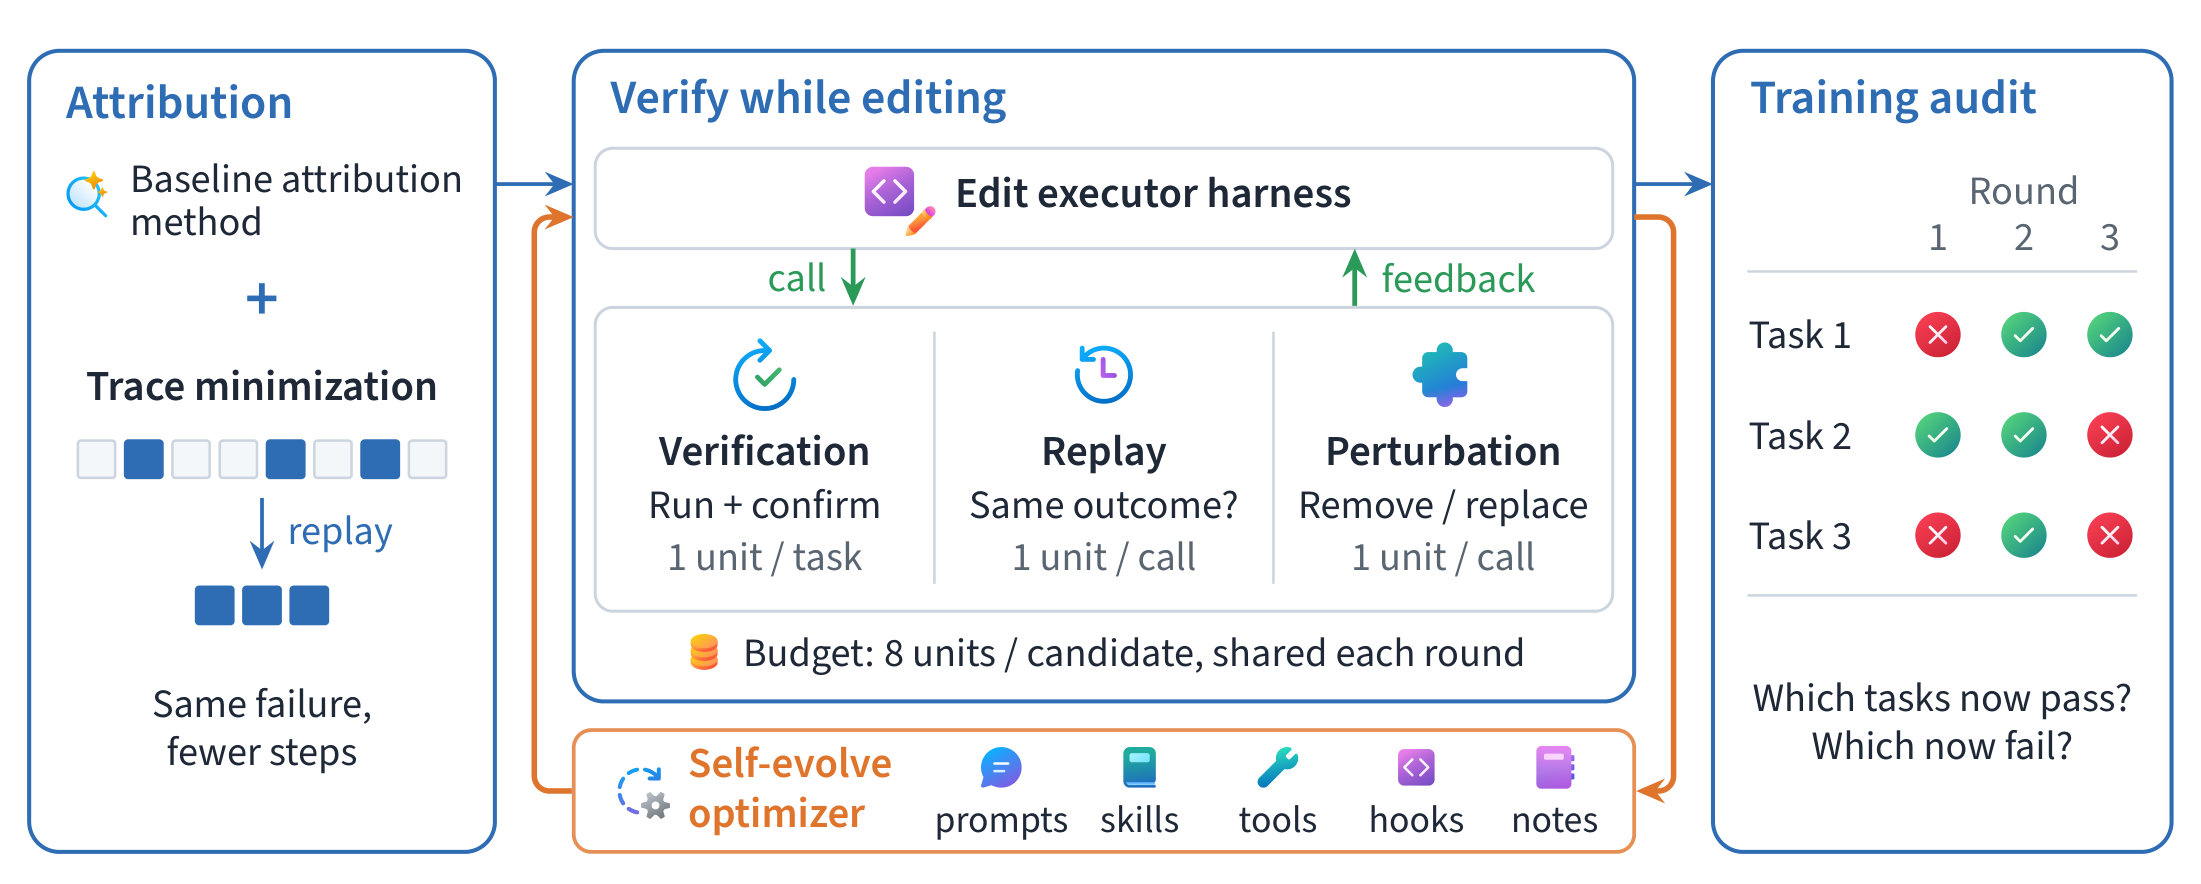
arXiv:2610.02616 Fig. 1)。自进化优化器在编辑 Executor Harness 与自身工具/技能时,通过轨迹最小化、编辑期验证/回放/扰动以及跨轮训练审计保障修改有效。7.5 Harness²:面向开放世界的两层递归与无标准答案行为对照(2026-10-09)
- 论文:Harness: Recursive Agent Harnessing for an Open World(本站已有单篇源码级深度拆解)
- 范围:主线 / 元改进
- 核心机制:开放世界任务在测试期往往是全新的,既没有标准答案 Verifier,也不能直接把上一个任务的系统提示词硬塞给下一个任务。Harness² 把过程拆成两层相互连接的递归:
- 任务级递归(Task-level Recursion):在当前任务上执行对比式的 Propose–Probe–Compose——提出候选配置后在同一任务上试跑(Probe),不靠外部判分器,而是直接对照“配置差异 + 两侧实际执行轨迹与产物”来组合配置;
- 改进级递归(Harnessing-level Recursion):任务结束后,将有明确行为证据支撑的修改提炼进跨任务经验库,更新“持续改进 Harness(Continual Improvement Harness)”,指导未来任务如何诊断和提议修改。在 WorkBuddy-Bench、JobBench 和 Harvey LAB 法律基准上,仅单步递归就带来最高 +11.5、+4.5 和 +11.8 个百分点的提升。
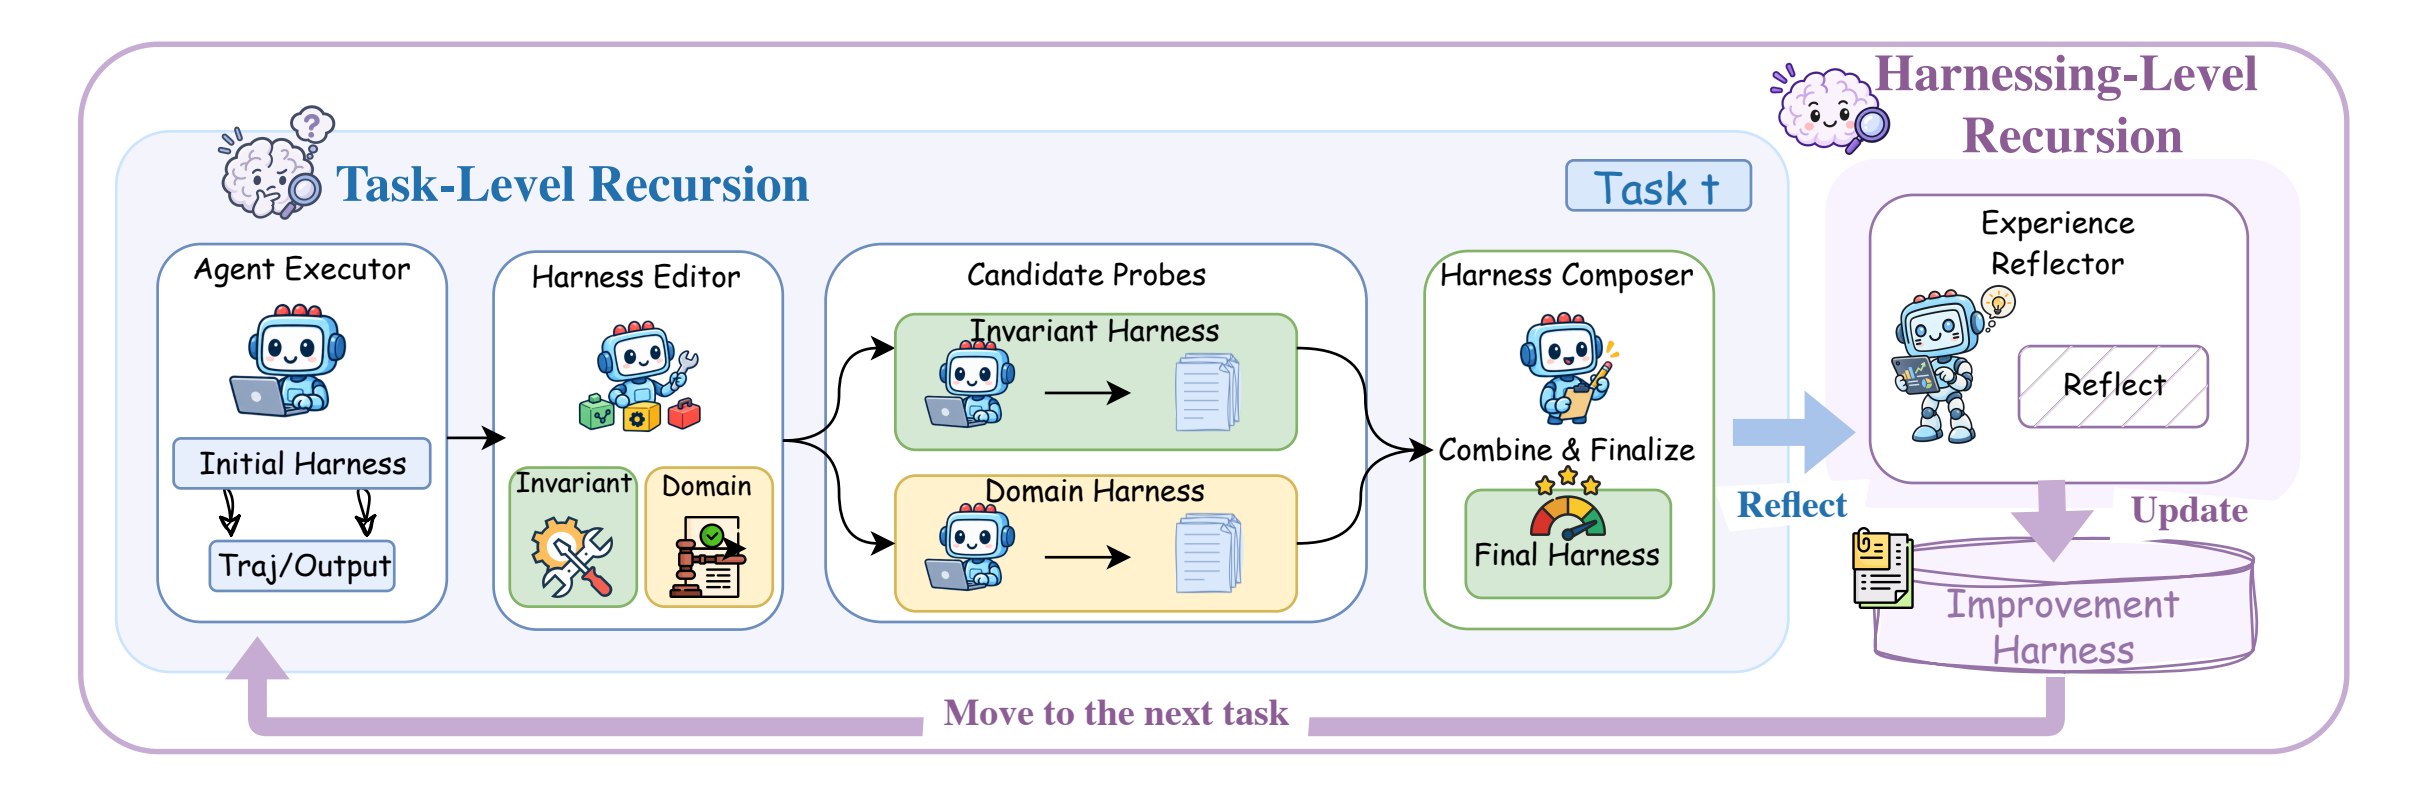
arXiv:2610.14224 Fig. 2)。内层通过 Propose–Probe–Compose 在无标准答案的开放任务上做行为对照组合,外层跨任务沉淀诊断与修改经验。7.6 RSIFlow:按瓶颈动态切换改进工作流,并沉淀为元原则(2026-10-15)
- 论文:RSIFlow: Adaptive Self-Improvement Workflows with an Evolving Meta-Agent
- 范围:元改进
- 核心机制:随着演化推进,Agent 的短板是动态转移的(早期可能是工具不会用,中期变成多跳推理断链,后期变成上下文噪声)。RSIFlow 让 Meta-Agent 先从任务轨迹与环境反馈中诊断当前的性能瓶颈,动态选择针对特定组件的改进工作流;随后再把工作流的执行效果提炼为 Meta-Agent 自身的组件级 Skills 和跨组件原则,反过来升级下一轮的工作流编排能力。
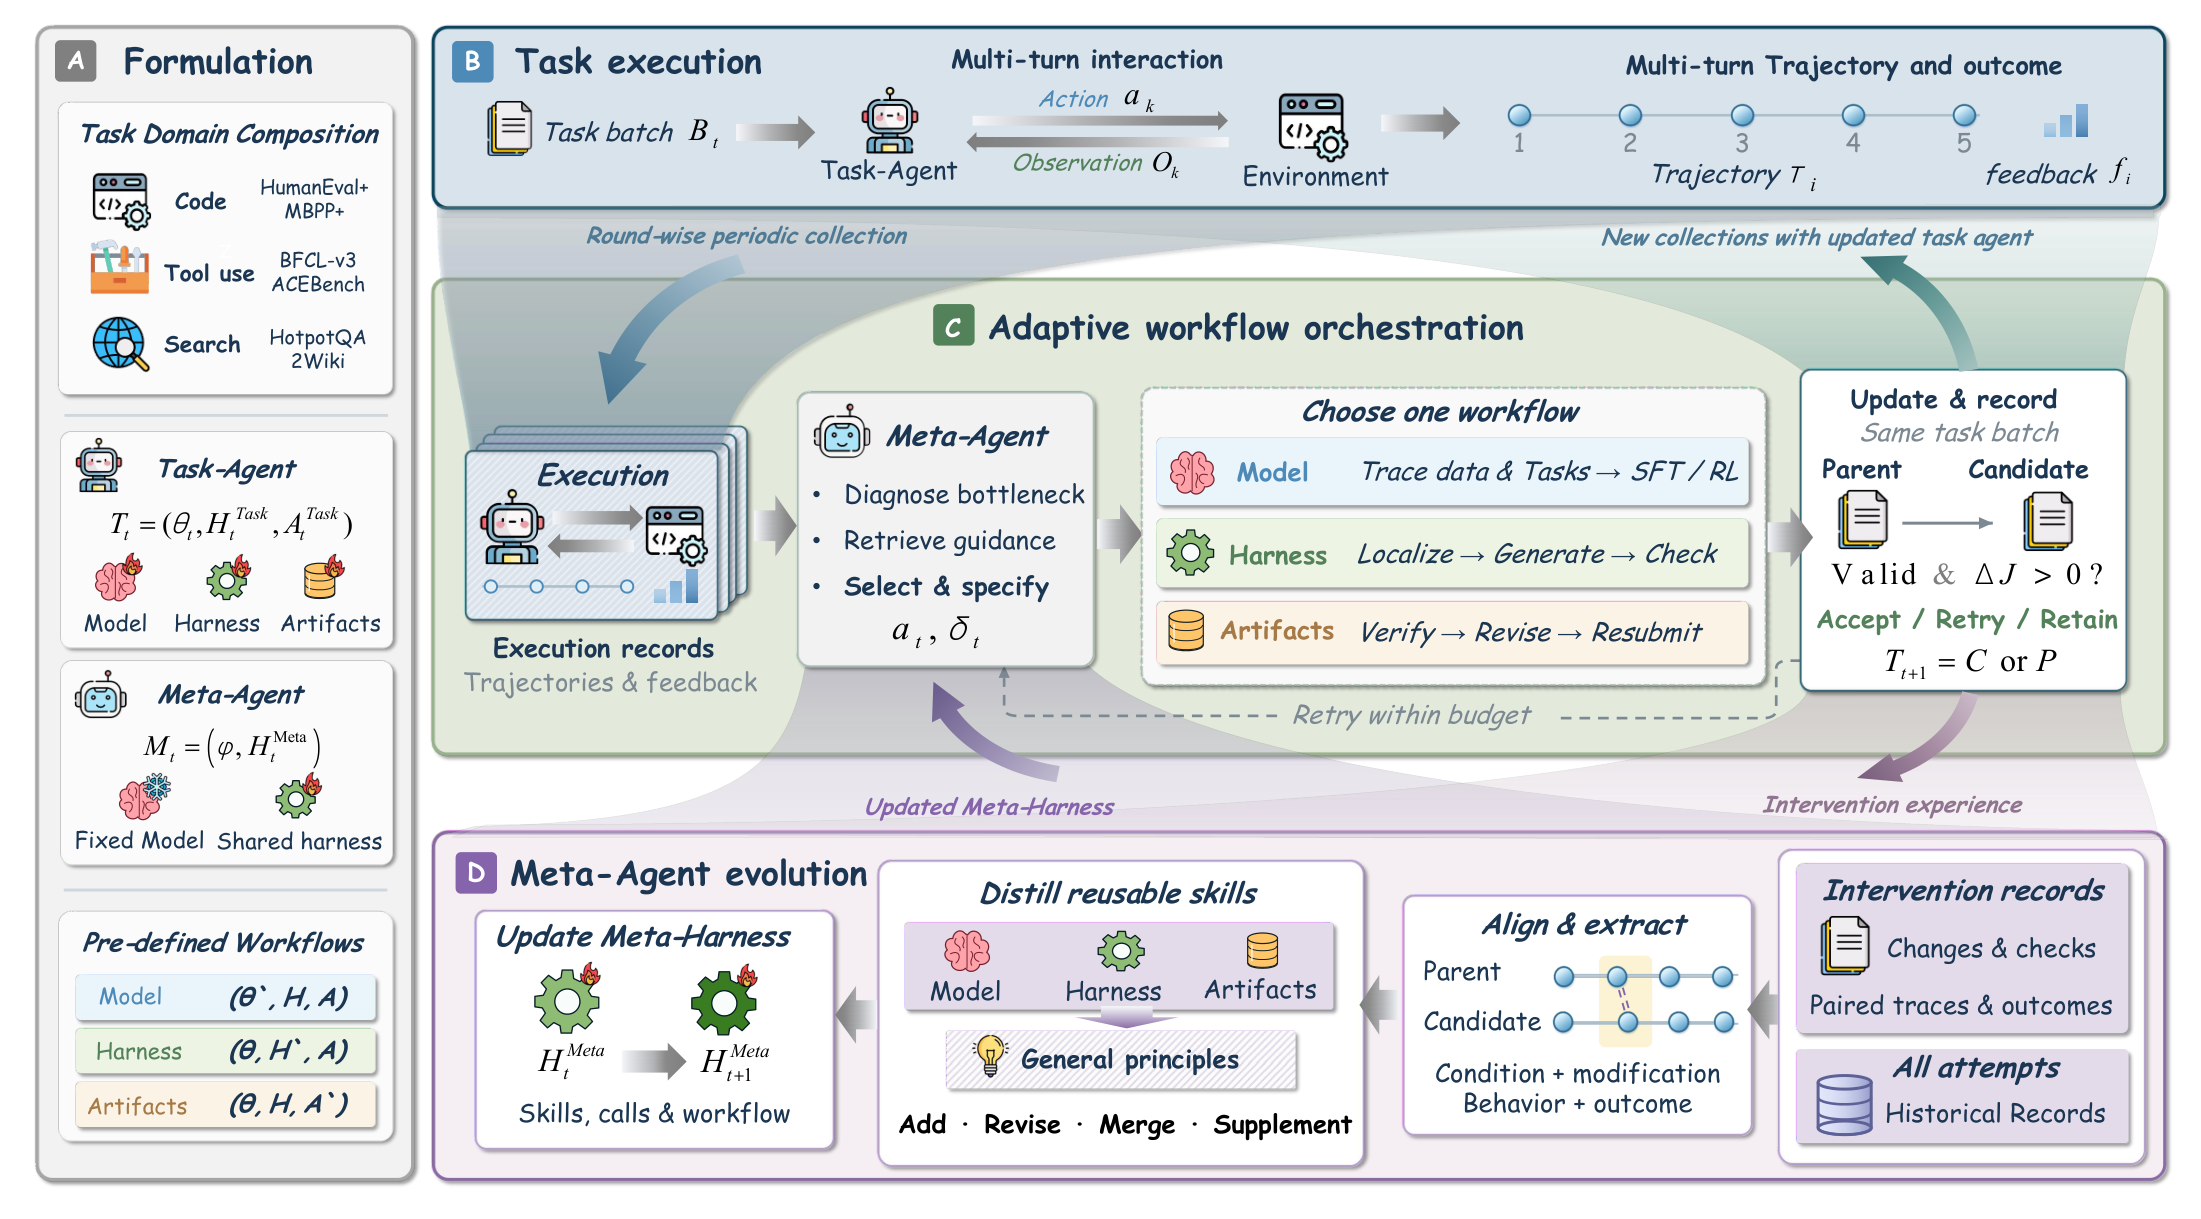
arXiv:2610.21791 Fig. 1)。Meta-Agent 根据执行记录诊断当前瓶颈并动态调度组件级改进工作流,再将干预成败记录提炼为自身的元技能与通用原则。7.7 MetaShare:不仅共享成功经验,更要跨分支广播“带符号收益的失败教训”(2026-10-15)
- 论文:MetaShare: Failure-Aware Collective Self-Improvement for Open-Ended Agents
- 范围:主线 / 元改进
- 核心洞察:人类进步最快的方式往往不是重复别人的成功,而是记住哪些死胡同千万别再踩。既往的群体演化(如 GEA、DGM-H)很少把“失败的修改尝试”当作一等公民做跨分支共享,导致不同分支反复尝试同一种无效改法。
- 核心机制:
- 带符号收益账本(Signed Performance Deltas):同时记录成功和失败的代码修改及其对应的分数增减。每一代开始前,同时检索其他分支的高分策略与高置信度失败案例,复用有效机制并主动避开已知死路。
- Task-Blind Auditor(盲审注入器)与去冗余重排:定期检测整个种群中缺失或欠探索的机制类别并主动注入,同时用 Embedding 相似度降权避免检索结果同质化。
- 多温度并行提议 + 确定性门控:多个 Meta-Agent 在不同采样温度下并行提议,背后由确定性选择器校验适用性、作用域、可编译性与补丁体积。在论文审稿、代码、数学批改、机器人奖励设计和金融审计风险评估 5 类任务上,MetaShare 仅用 1.7–2.9 倍更少的迭代轮次就追平或超越了 DGM-Hyperagents 的最佳表现。
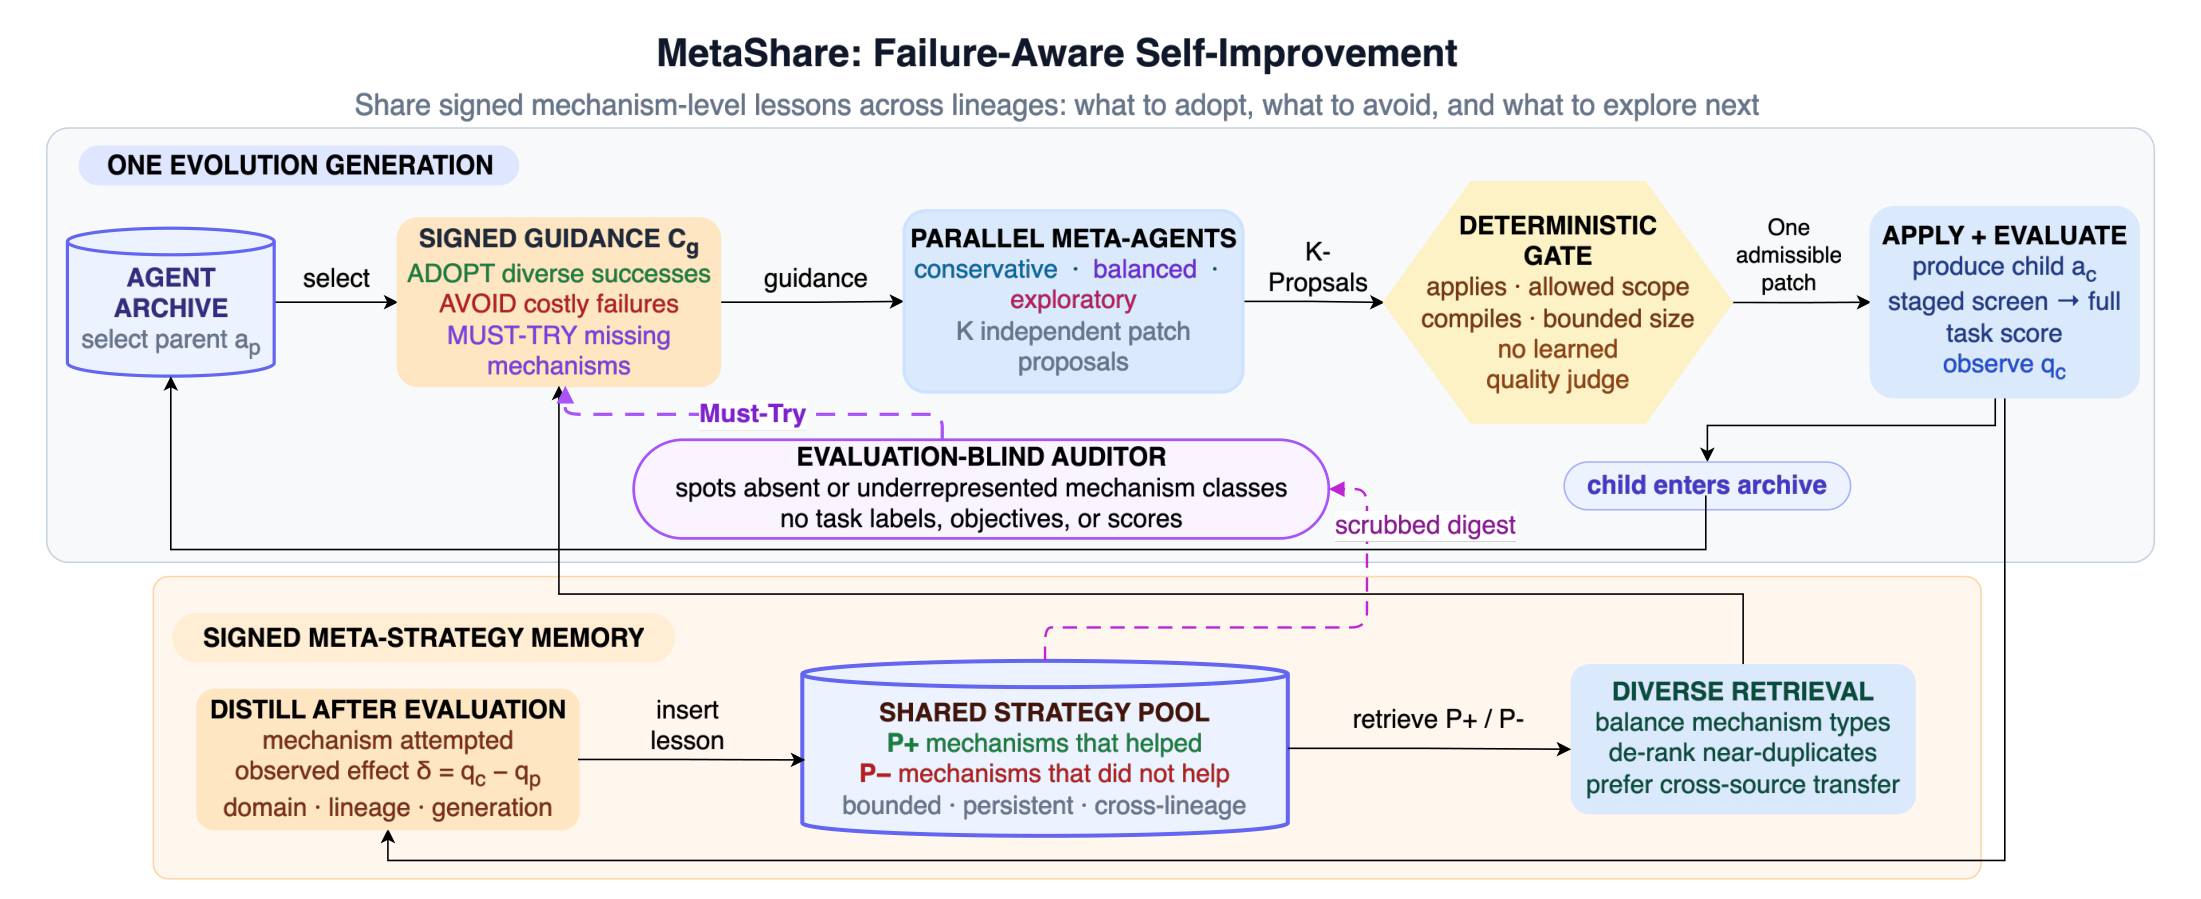
arXiv:2610.21887 Fig. 1)。通过共享策略池同时记录正收益机制(P+)与负收益机制(P-),结合无评测盲审器补充缺失机制,并经确定性门控筛选补丁。8. 支流五:换模型或训模型怎么办?——跨模型共享 Harness 与权重交替训练
前面绝大多数工作都默认“固定一个模型 ,专门给它搜一套 ”。但到了 2026 年 10 月,研究者开始正视两个更深的问题:第一,给模型 A 搜出来的 Harness 往往和 A 的怪癖强绑定,换个模型就失效,能不能直接搜一套跨模型通用的 Harness?第二,如果模型权重 也是可以训的, 和 应该怎么配合?
8.1 MaD-RSI:把异构大模型当作“训练数据”,学习跨模型共享 Harness(2026-10-20)
- 论文:MaD-RSI: Model-as-Data for Recursive Self-Improvement of Agent Harnesses
- 范围:主线
- 核心视角转换:以往的方法都是“在单模型上训练 Harness,训练完了再去别的模型上测泛化”,把模型差异仅仅当成测试期的考核指标。MaD-RSI 提出了 Model-as-Data(模型即数据) 视角:把多个异构大模型的不同失败轨迹直接作为训练期的优化证据,以 Harness 为中心,直接学习一份跨模型共享的通用 Harness。
- 为什么有效:不同模型在同一任务上的失败方式往往暴露了 Harness 在不同能力短板下的脆弱点(比如模型 A 容易漏读长输出,模型 B 容易调错工具参数)。把这些异构失败同时喂给演化循环,逼着优化器写出更具包容性的接口与护栏,既提升了跨模型泛化,又省掉了为每个新模型从头搜一遍 Harness 的高昂算力。
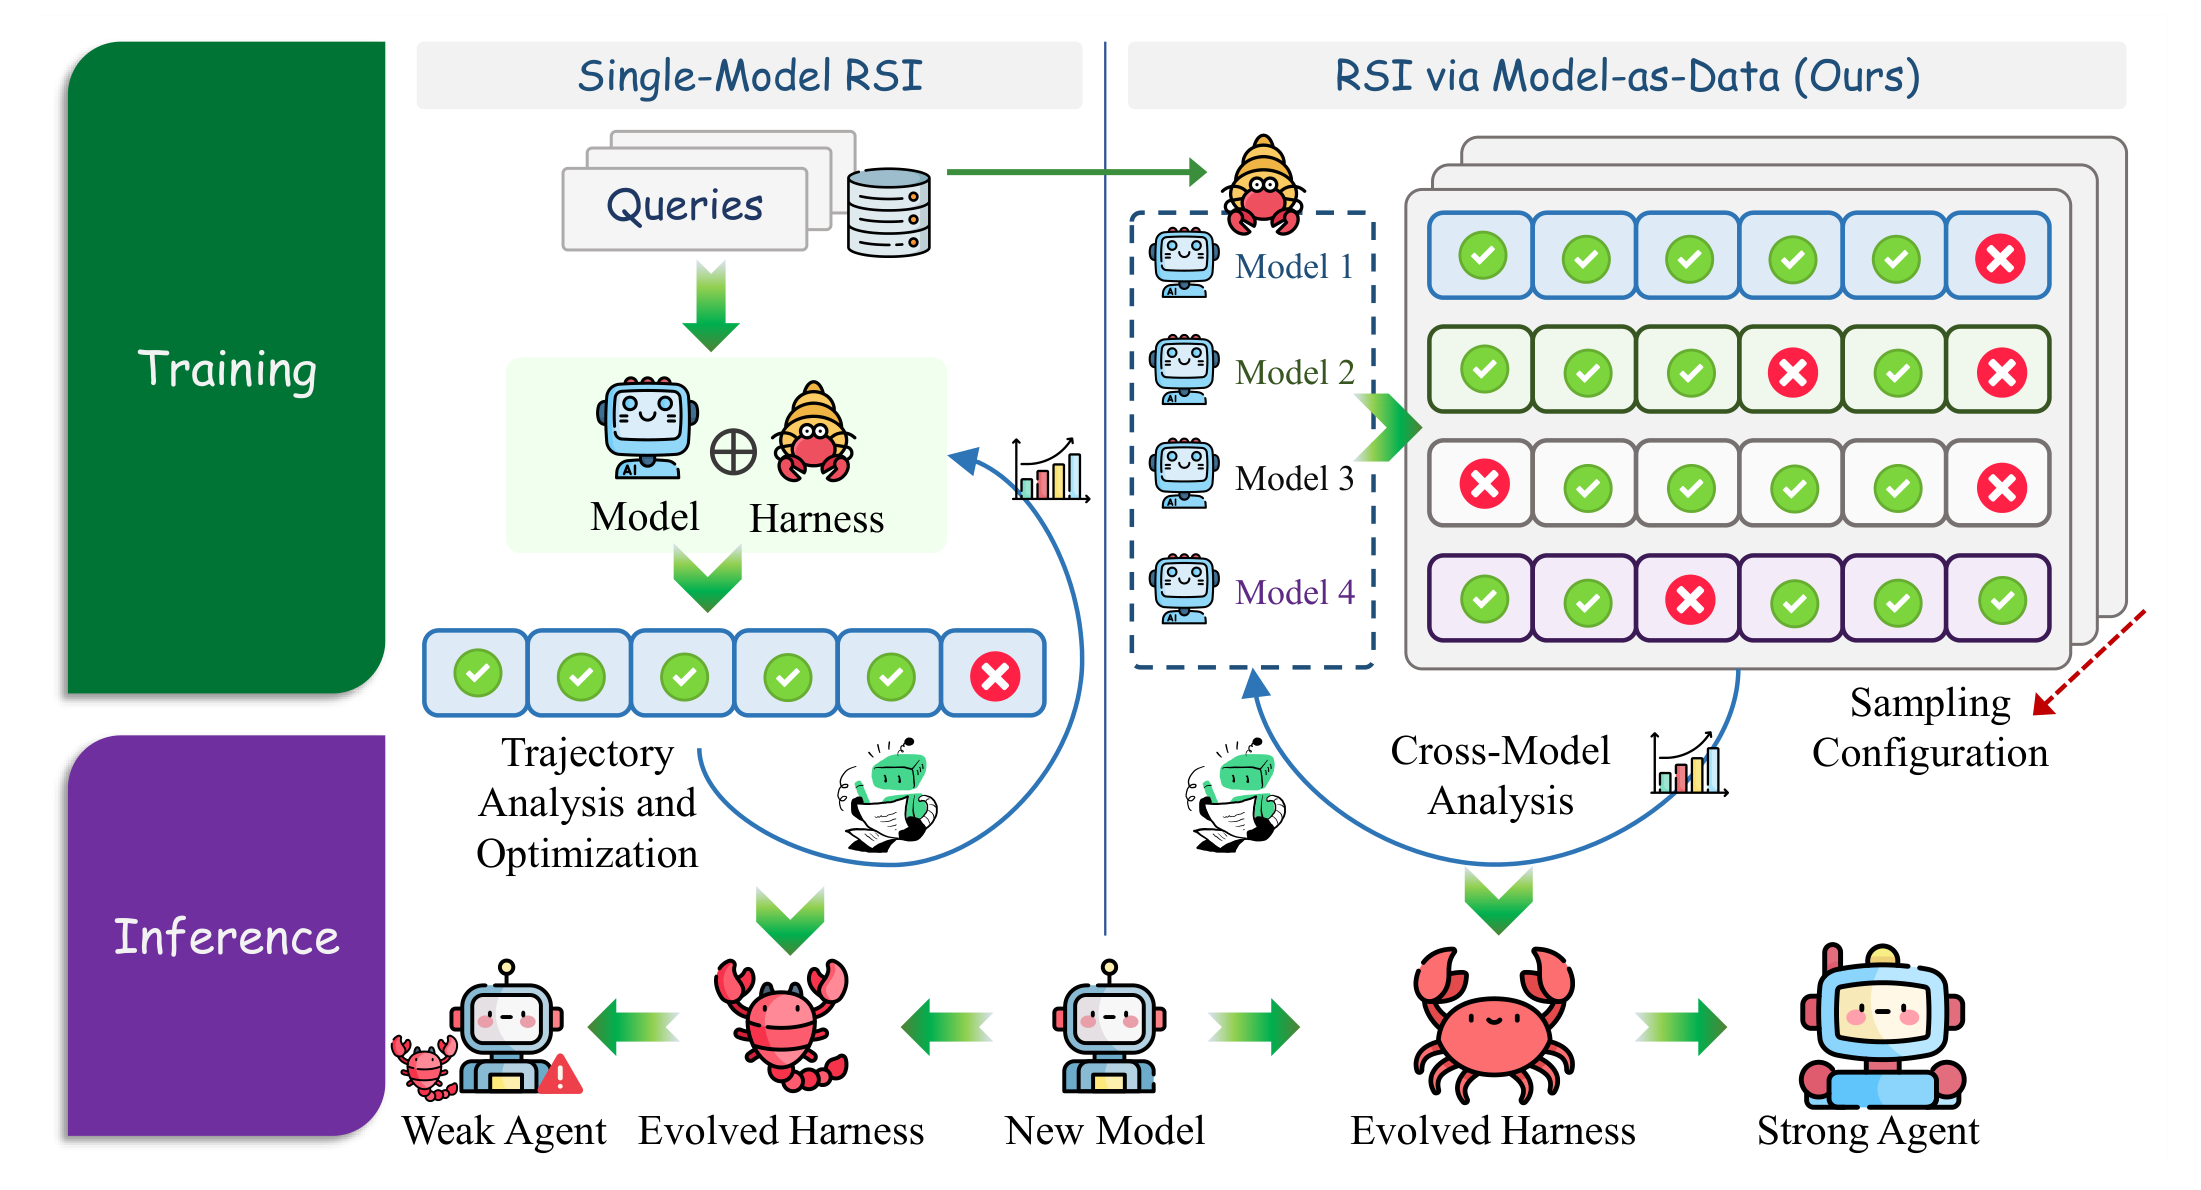
arXiv:2610.28201 Fig. 1)。将多个异构模型在同一批任务上的执行轨迹作为联合优化信号(Model-as-Data),直接学习可迁移至新模型的通用 Harness。8.2 Self-HPO:用当前策略模型当自己的 Harness 提议器,交替做 H-step 与 P-step(2026-10-16)
- 论文:Self-Evolving Coding Agents via Harness-Policy Optimization
- 范围:相关(Harness 与模型权重联合优化)
- 要解决的痛点:只进化 Harness,受限于冻结模型的天花板;只对模型做强化学习(RL),采样出来的轨迹又受限于固定 Harness 能触达的状态空间;而且模型权重一旦更新,它的失败模式就变了,原本适配旧权重的 Harness 就不再合身。
- 核心机制:提出 Harness-Policy Optimization(Self-HPO),让正在进化的策略模型自己充当自己的 Harness Proposer,交替执行两步:
- H-step(演化 Harness):当前策略模型分析自己的失败轨迹,提议并筛选新的 Harness 候选;
- P-step(强化学习更新权重):在选定的新 Harness 下对策略模型进行 RL 更新;同时,RL 训练过程中暴露出的**高难度任务(Hard Tasks)**自动组成下一轮 H-step 的搜索集,使 Harness 优化始终精确瞄准模型最新的能力短板。
- 实验结论:在三个代码基准上,Self-HPO 将 Qwen3.5-35B-A3B 的平均解决率从 57.8% 提升至 64.8%,全面击败仅优化 Harness 或仅优化 Policy 的基线,且联合收益大于两者单独收益之和(超可加性);若引入更强的外部模型(如 Claude Opus 4.8)担任 H-step 提议器,还能获得进一步加成。
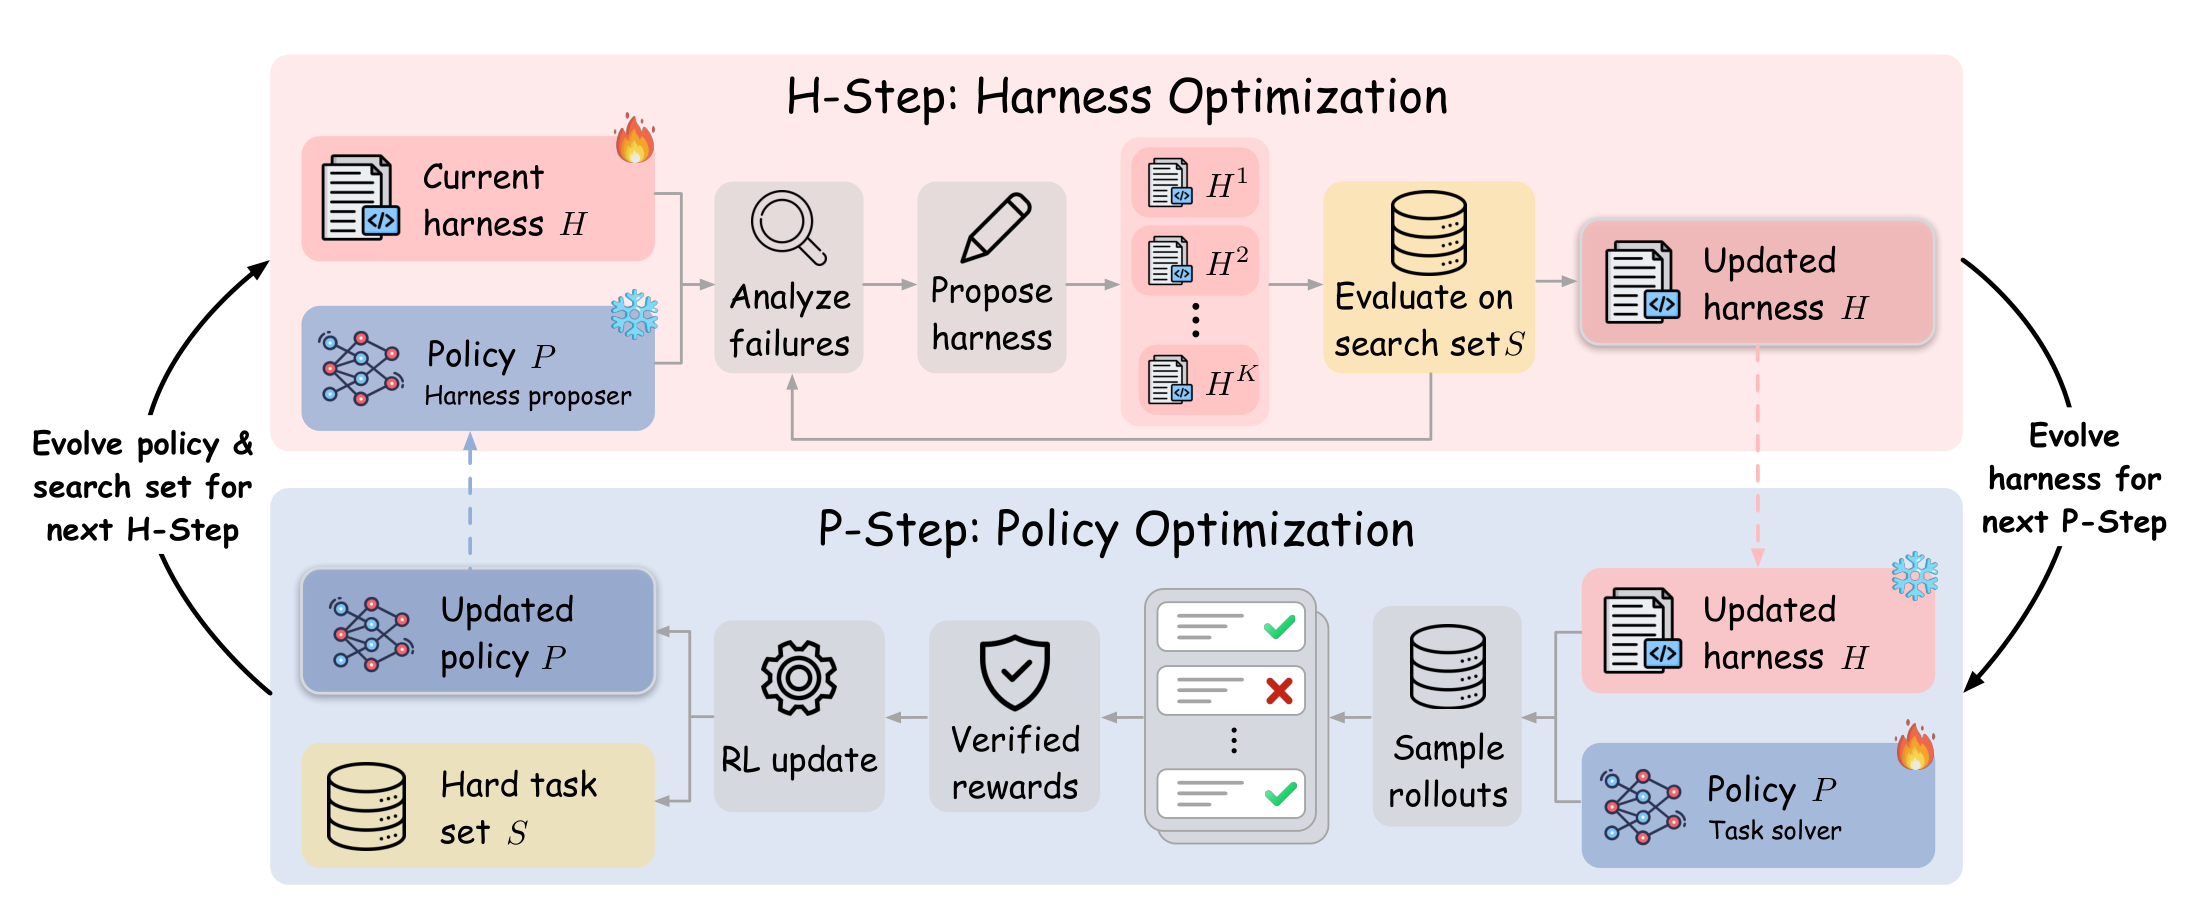
arXiv:2610.22791 Fig. 2)。H-Step 由当前策略模型提议并筛选 Harness,P-Step 在新 Harness 下执行强化学习并筛出困难任务驱动下一轮 H-Step。8.3 MASS:在无客观标准答案任务上,交替演化多 Agent 拓扑与轨迹 SFT(2026-10-08)
- 论文:Recursive Self-Improvement through Multi-Agent Self-Supervision
- 范围:相关(多 Agent 工作流演化 + 权重 SFT 联合优化)
- 要解决的痛点:在开放式研究等**不可直接验证(Non-verifiable)**的任务上,没有单元测试或编译器给你打分,甚至人类专家都很难快速评判输出好坏,单个模型自我批判又容易陷入同质化盲区。
- 核心机制:利用“多智能体计算图拓扑在复杂推理和评估上强于单智能体”的特性,让单个基座模型交替执行:
- 多 Agent 工作流演化:在结构护栏约束下,演化搜索最佳的多角色分工与信息路由图(Orchestration Topology),并用多 Agent 协同评估筛出高质量轨迹;
- 自生成轨迹 SFT:用筛选出的多 Agent 轨迹微调底座模型;变强后的模型在下一轮循环中自然成为更好的工作流提议者与评估者,形成递归自举。
- 实验结论:在 Qwen3.6-27B 上运行两轮 MASS 循环后,在 4 个开放式公开基准上实现了 1.2–1.6 倍的单位输出 Token 性能提升;且多 Agent 轨迹的训练效率明显更高——用其训练的学生模型击败了使用 1.4 倍训练 Token 的单 Agent 轨迹学生模型。
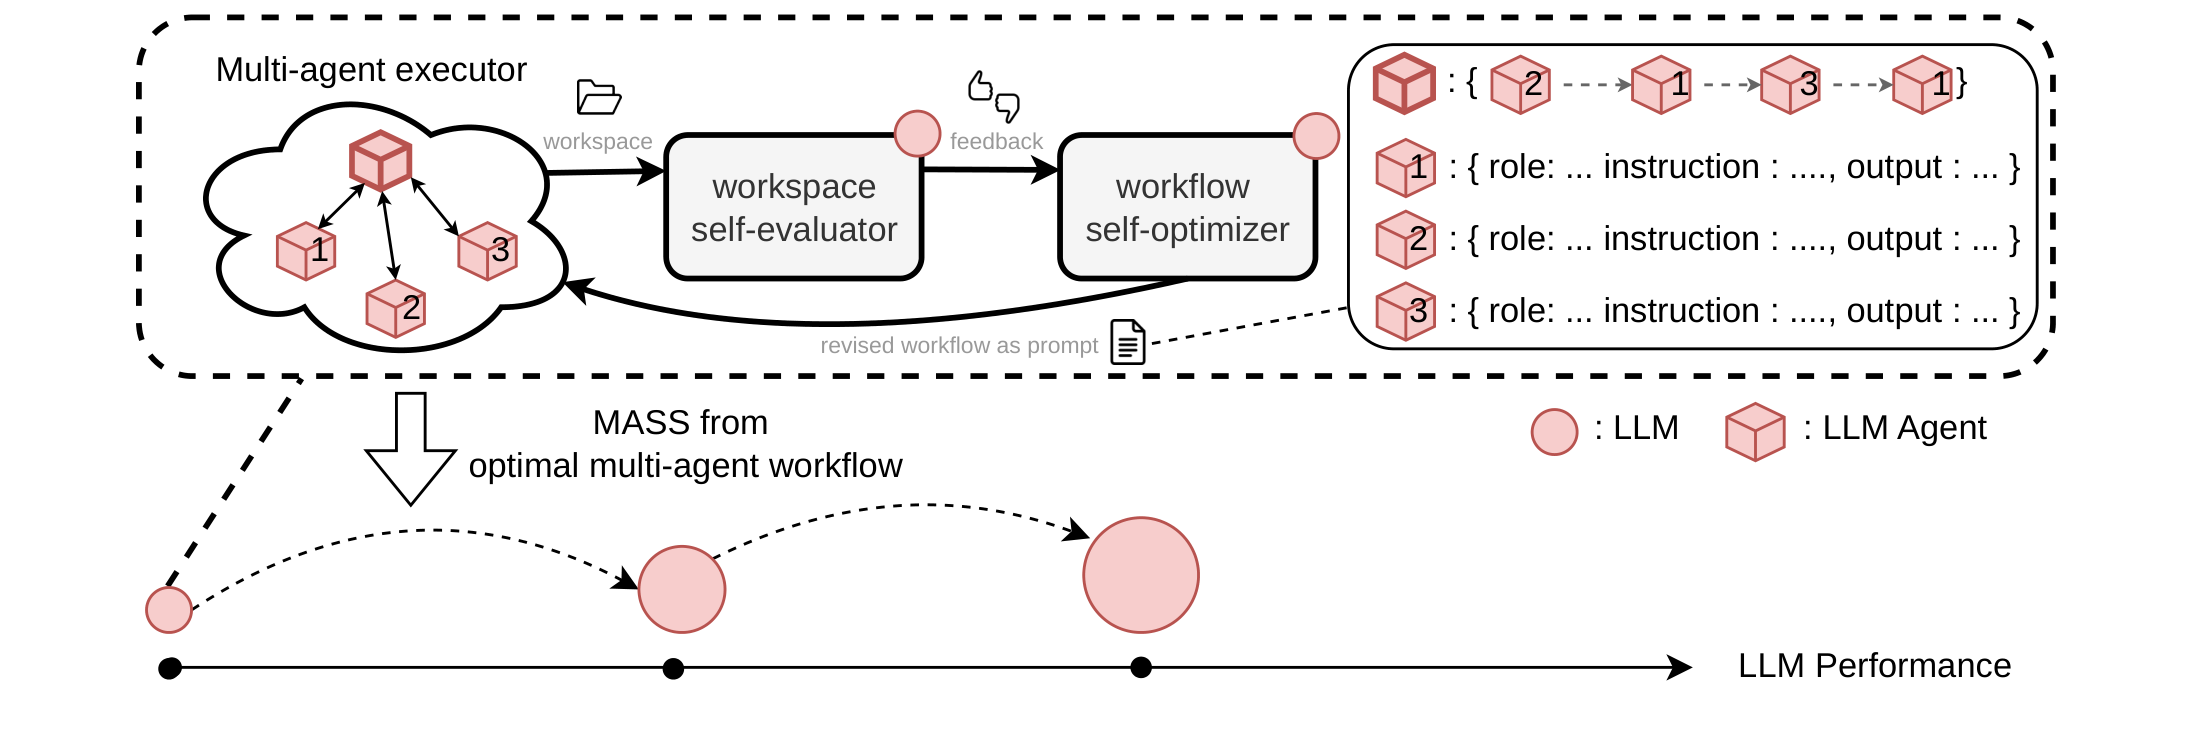
arXiv:2610.12176 Fig. 1)。在无外部标准验证器的任务上,先通过工作区自评估器与工作流自优化器搜索最优多智能体拓扑,再用高质量多智能体轨迹微调模型实现自举。9. 支流六:走出代码台能落到哪?——推理数据合成、具身机器人与多轮可视化
2026 年 10 月的另一个明显变化是,Harness RSI 开始走出 SWE-bench 和 Terminal-Bench 这类纯命令行代码台,在前沿推理数据合成、真实机器人控制和多轮对话式数据可视化三个垂直场景跑通了闭环:
9.1 Frontier Reasoning Data Synthesis:任务与数据合成 Harness 共演化(2026-10-02)
- 论文:Recursive Harness Self-Improvement for Frontier Reasoning Data Synthesis
- 范围:应用分支(数据合成)
- 核心机制:以往合成难题时,往往只把上一轮生成的题目当作新种子(Task-level Recursion),但负责出题、验题和改题的合成管线(Construction Harness)是不变的。本文提出 Task-Harness Co-evolution:
- 在线自改进(Online):在生成过程中,把求解器(Solver)的中途失败实时转化为可复用的出题 Skills;
- 批次后自改进(Post-task):每个 Batch 结束后修改合成器的 Skills、Prompts 与工作流,仅当新候选能在受控成本增幅内生成更难且经验证合法的题目时才予以采纳。
- 实验结论:在保持模型权重与验证标准冻结的前提下,跨越数学、代码和科学三大领域演进 14 轮后,求解器在新合成题目上的平均准确率从 100.0% 持续压低到 54.8%(说明题目难度真实且稳步上升)。用合成出的 10K 数学样本对 27B 学生模型做 SFT 与 GRPO 后,在 APEX 基准上拿到 62.5% mean@16,追平部分前沿大模型参考线。
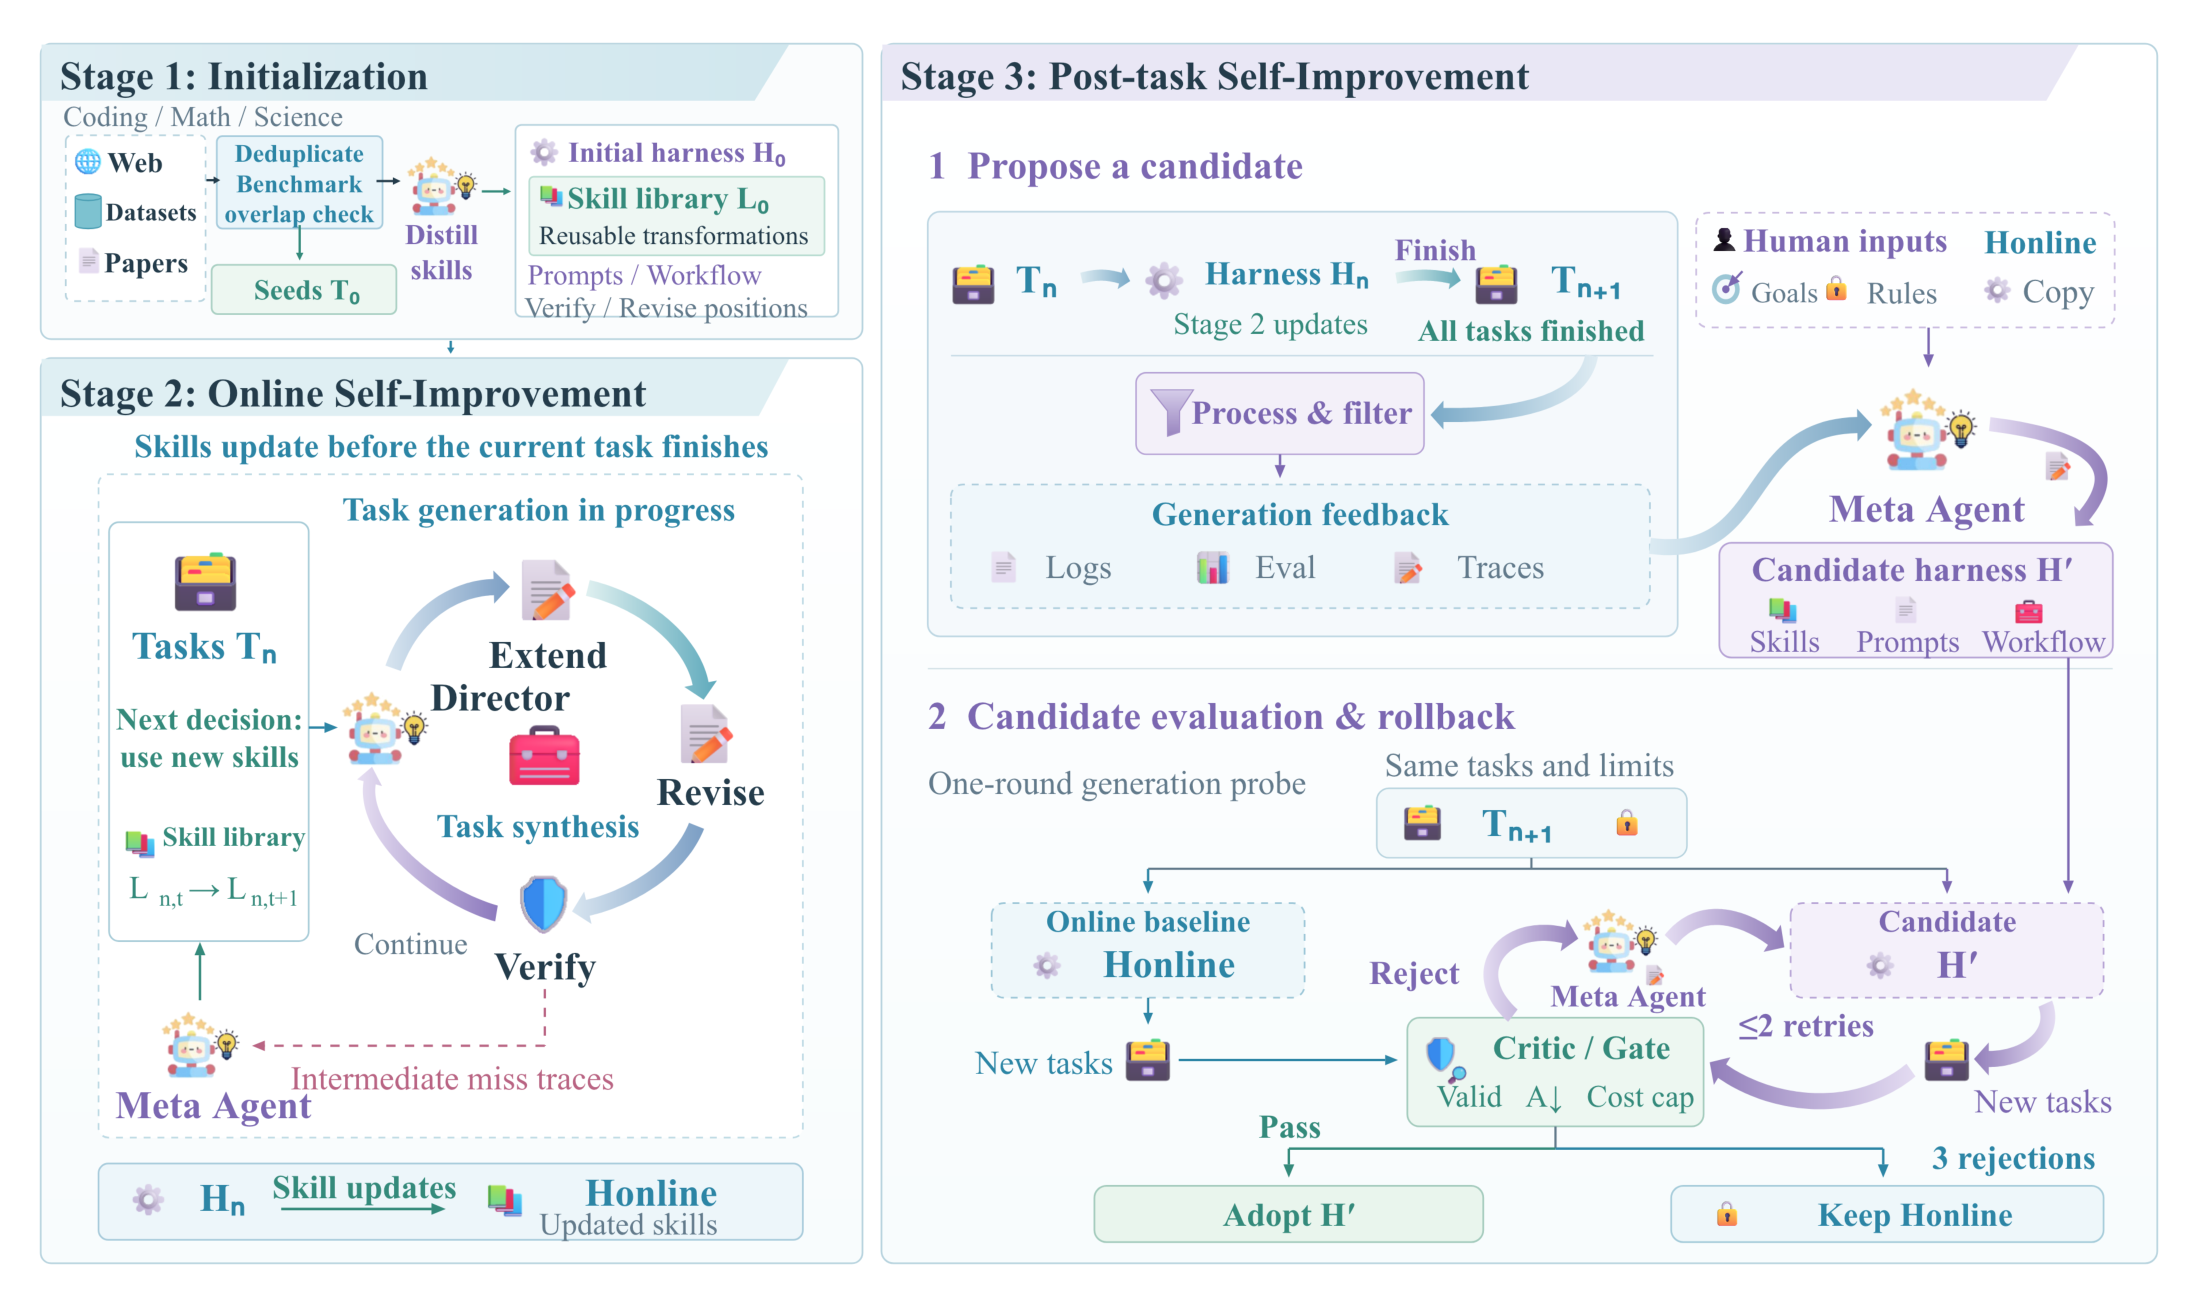
arXiv:2610.03548 Fig. 1)。涵盖种子与技能初始化(Stage 1)、合成过程中的在线技能更新(Stage 2)以及批次结束后的受控探测与回滚门禁(Stage 3)。9.2 RoboRSI:用自顶向下分层技能契约,让实体机器人在 104 轮中学会家务整理(2026-10-08)
- 论文:RoboRSI: Stable, efficient, and reusable robot self-evolution in complex real-world environments
- 范围:应用分支(具身智能 / 机器人)
- 核心机制:写代码控制的机器人如果随便自改底层代码,很容易在真实物理环境里失控或把好技能改坏。RoboRSI 提出了 Top-Down Skill Refinement(TSR,自顶向下技能精炼):
- 三层技能树 + 显式输入输出契约:将任务分解为复合技能(Compound)、原子技能(Atomic)和基础技能(Base),每一层都有严格的职责边界与 I/O 契约;
- 责任分支隔离修改:执行失败后,先将错误精确归因到具体的责任分支(Responsible Branch),只允许修改该责任分支内的代码,经 Manager、Planner、Engineer、Reviewer 四角色协同验证通过后才发布新技能,并将稳定的技能序列固化为新的复合技能。
- 实验结论:在一台真实移动机械臂上,RoboRSI 经过 104 轮演化自主掌握了多物体家庭桌面清理;在 LIBERO、LIBERO-PRO、LIBERO-Plus 和 RoboTwin 四套仿真基准上全面刷新最高成功率,超越最强基线 2.7 至 11.0 个百分点。
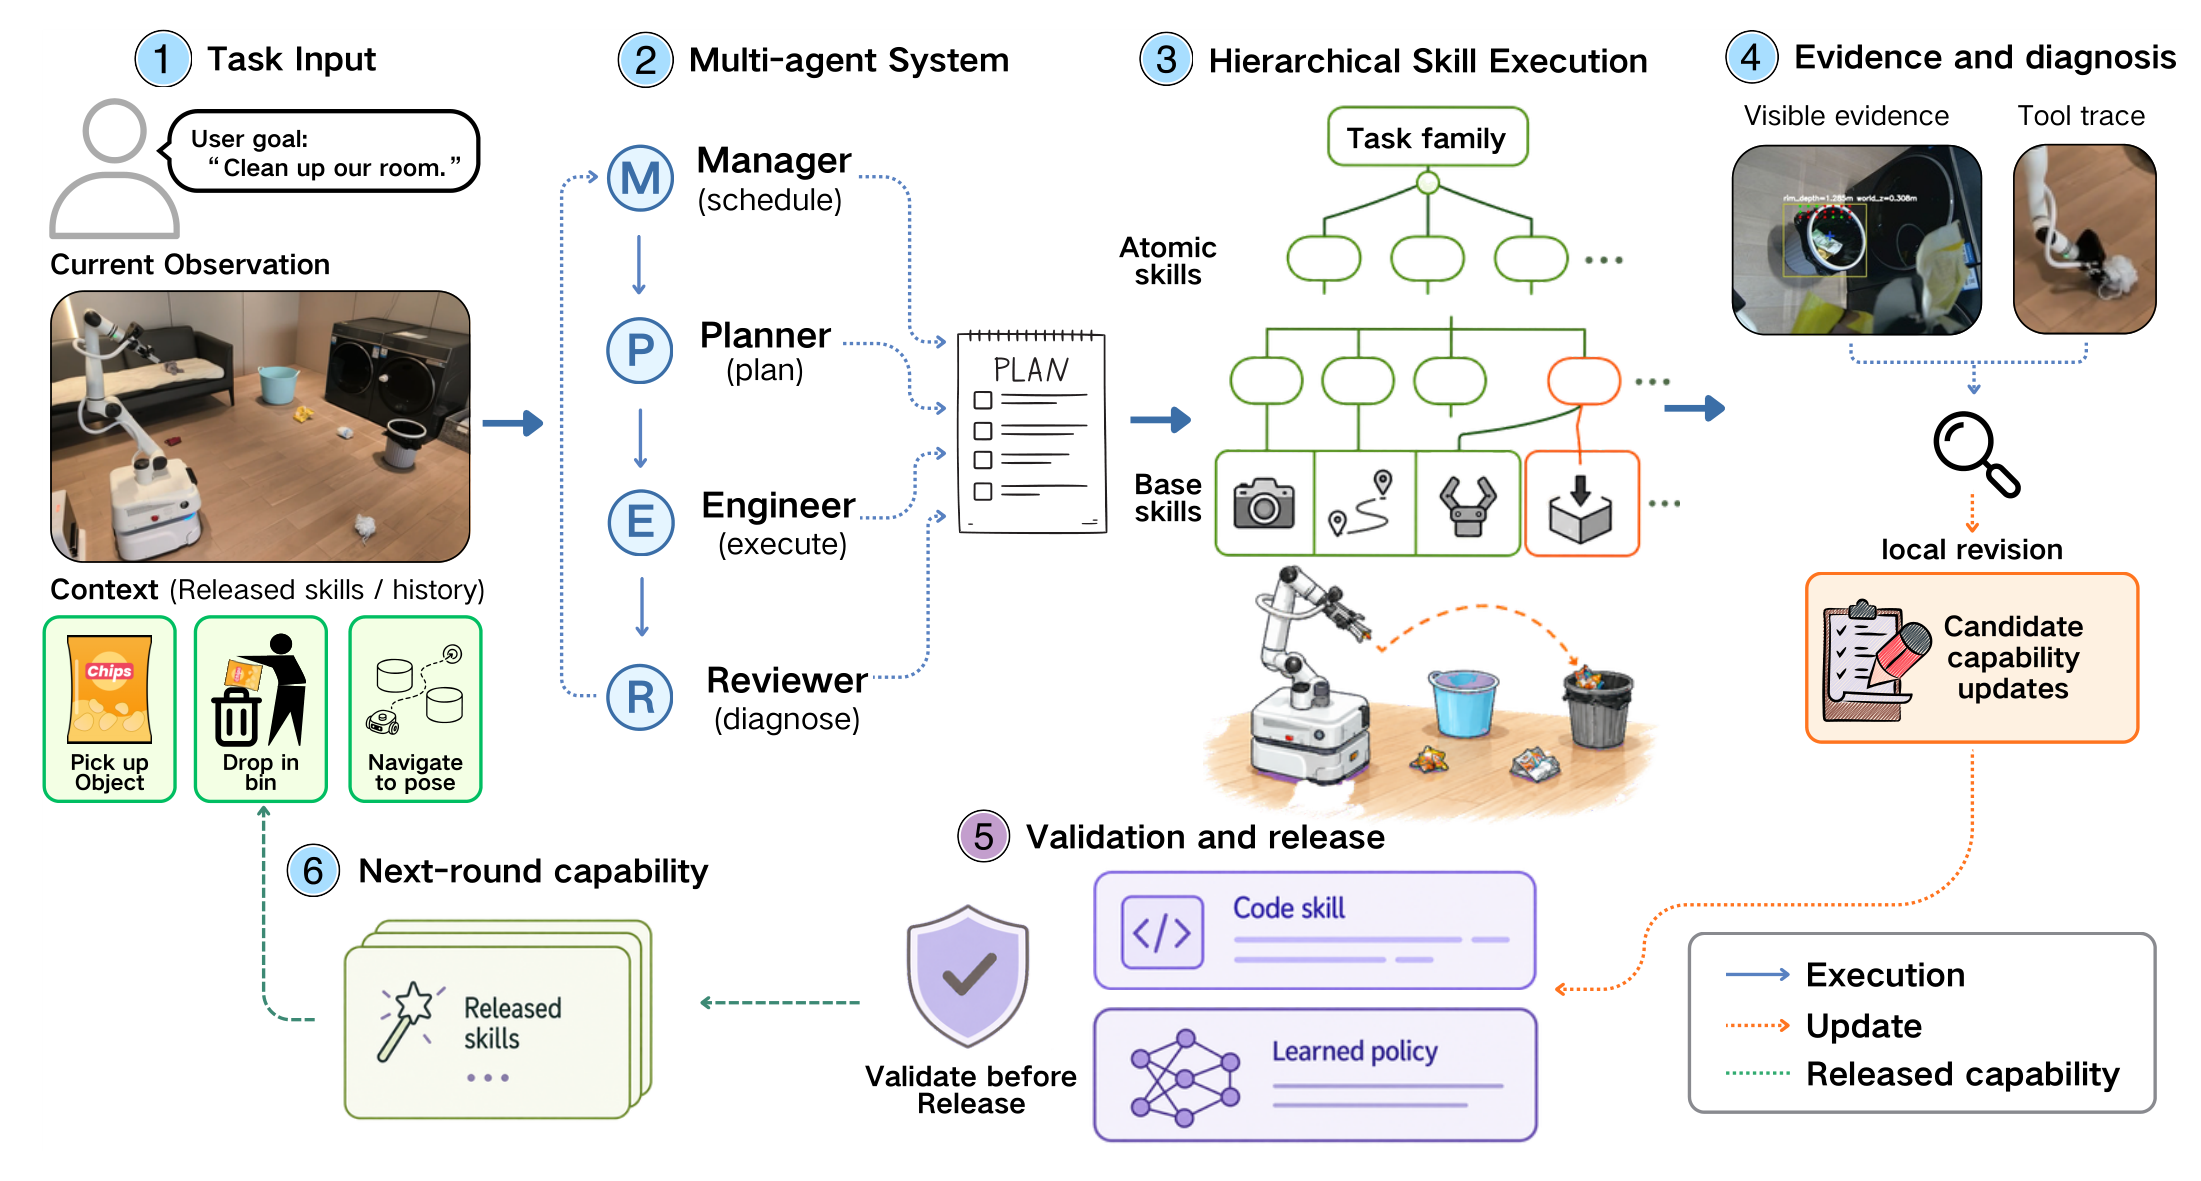
arXiv:2610.12424 Fig. 1)。通过分层技能树与责任分支定界,将机器人自修改限制在局部失效分支内,经验证通过后发布为下一轮可复用技能。9.3 RSIV-Harness:面向开放域多轮图表生成的锚点检查与崩溃恢复(2026-10-26)
- 论文:RSIV-Harness: A Recursive Self-Improvement Harness Framework for Open-Domain Conversational Text-to-Visualization
- 范围:应用分支(多轮 Text-to-Visualization)
- 核心机制:用户在做数据分析画图时,往往不知道数据在哪张表里、需求表述模糊,还会在多轮对话里不断追加修改条件。RSIV-Harness 提出了四层自改进架构,并专门设计了 Anchor Check(锚点检查)与 Memory Check(记忆检查):每次根据失败轨迹提议修改 Harness 后,必须先通过锚点与记忆一致性校验,通过则继续精炼,一旦校验不通过立即回滚恢复到历史最佳已验证 Harness。作者同步构建了包含 640 个任务的 ODAC-Vis 基准,仅单轮 RSIV-Harness 演化就在全部 6 项指标上超越种子 Harness,其中图表可执行率(Executability)暴涨 +28.02 分,图表结构准确率提升 +34.01 分。
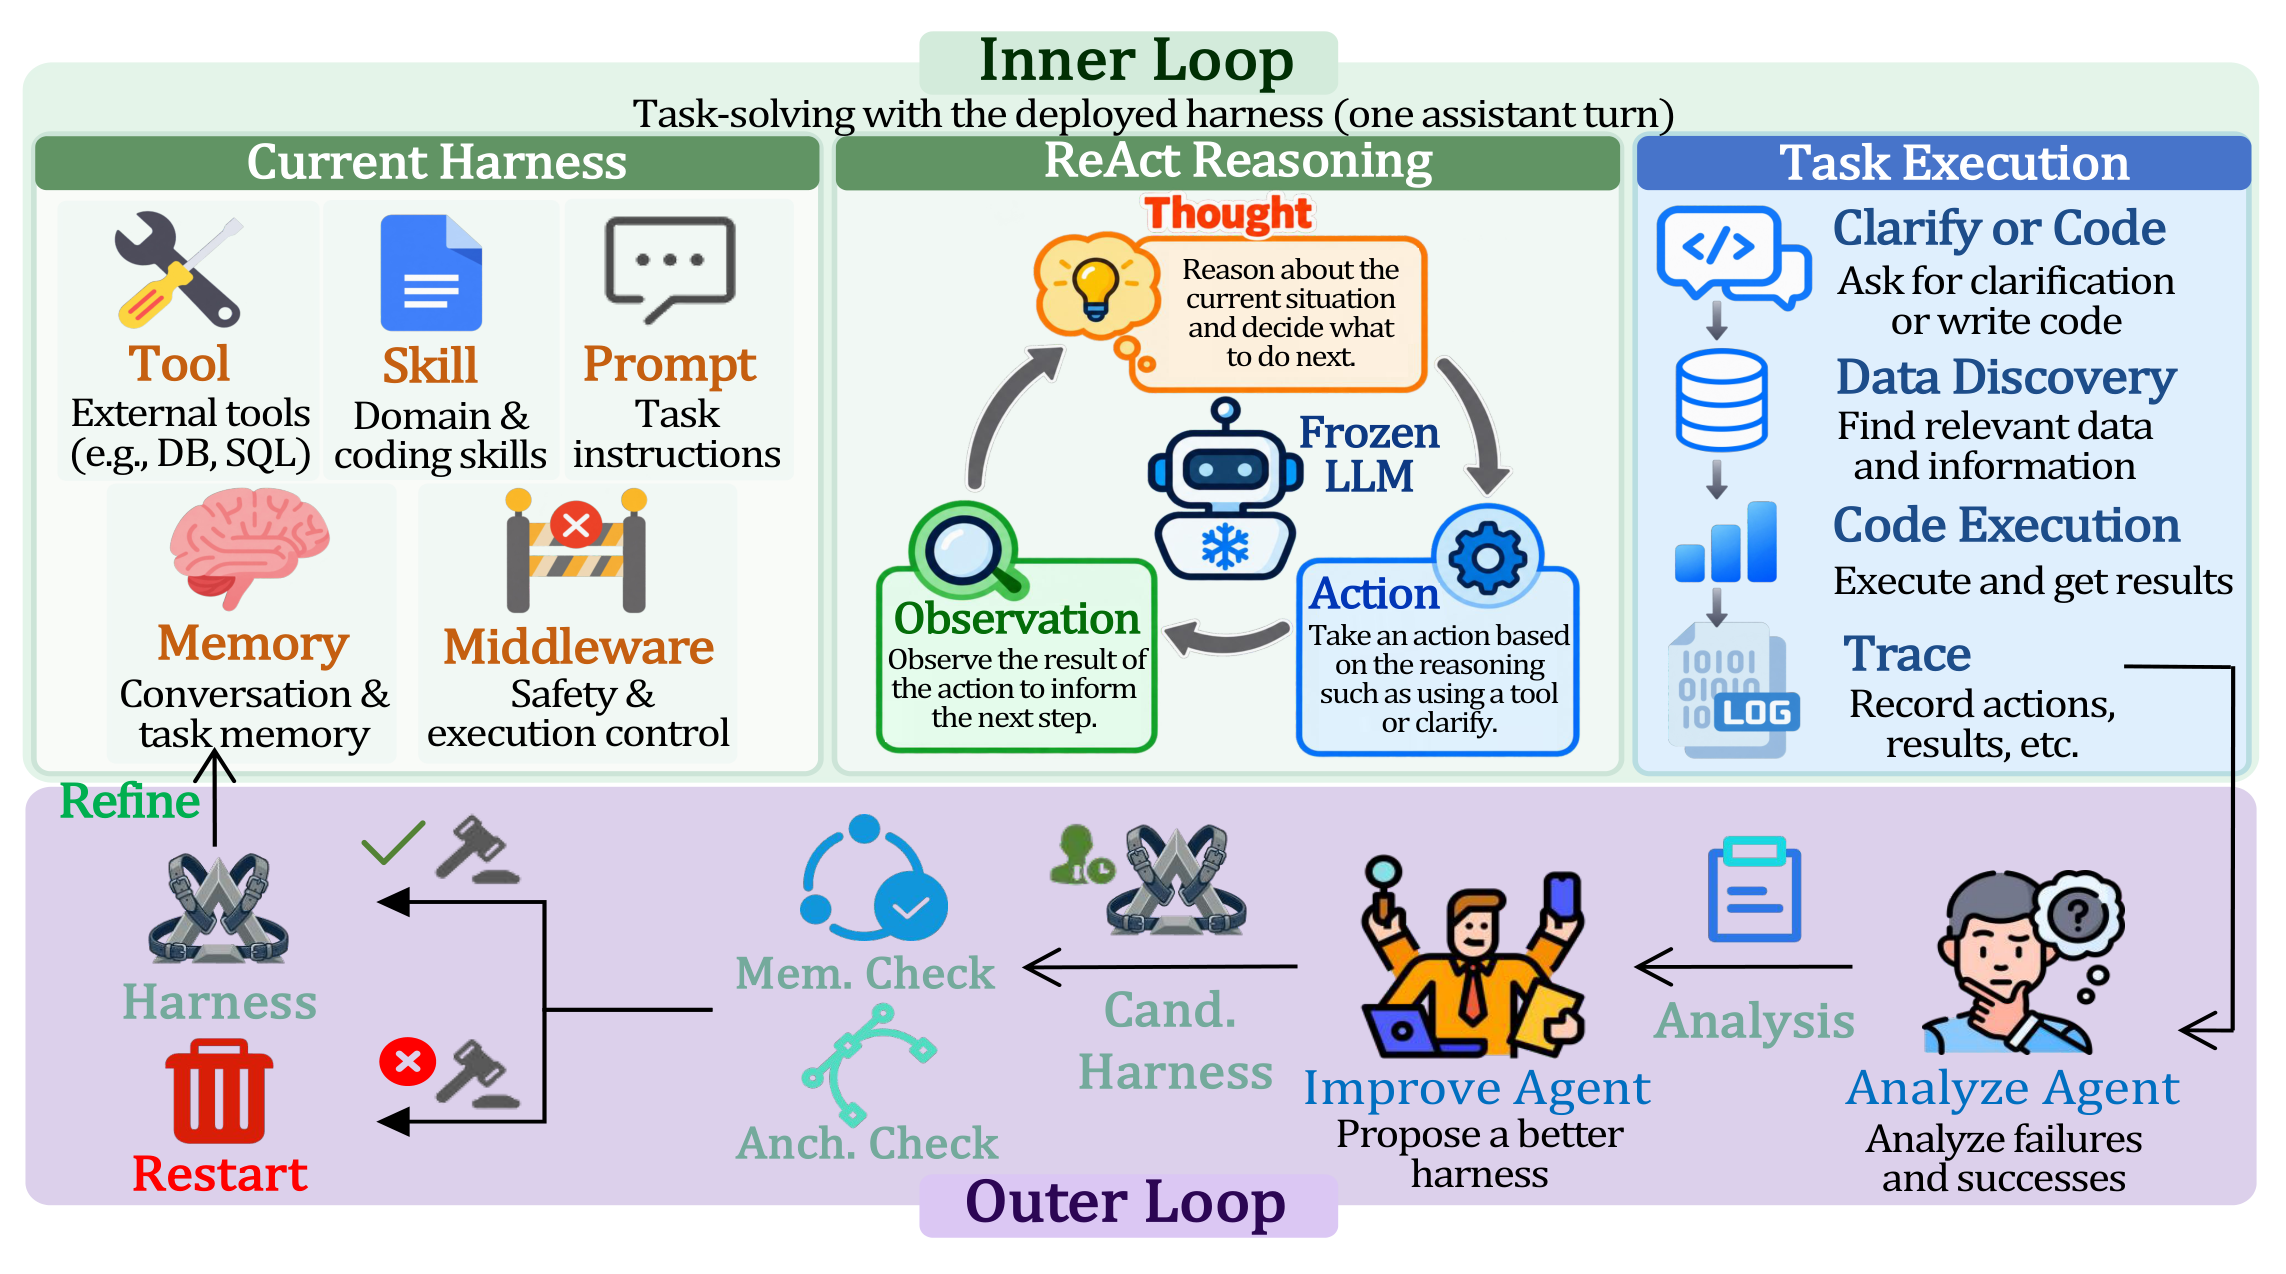
arXiv:2610.35316 Fig. 1)。内层执行多轮澄清、数据发现与代码画图,外层通过 Memory Check 与 Anchor Check 决定继续精炼或回滚至历史最佳 Harness。10. 单独关注的工程平台与理论综述:Dream-RSI、GEAR、PenguinHarness、RSIHub 与 Self-Evolving Agent Harness
除了上面按算法创新切分的论文外,近期还有几项工程基础设施与理论综述性质的工作。它们的目标不是再发明第 25 种提议算子,而是把复现协议、沙箱隔离和理论边界统一起来:
| 工作 | 时间与来源信息 | 核心定位与工程价值 |
|---|---|---|
| Self-Evolving Agent Harness | 2026-10-13(arXiv:2610.18813) | 理论与全景综述:严格区分更新对象(解释态状态 vs. 工具代码 vs. 仓库级控制流 vs. 插件组合)、提议机制与准入机制;基于持续 PAC 学习(Continual PAC-learning)推导期望泛化界、历史回归预算约束下的能力保持界,以及使用独立新鲜验证集的高概率准入规则。 |
| RSIHub | 2026-10-28(arXiv:2610.32253,本站拆解) | 可组合演化与防篡改评测框架:将演化拆成 7 阶段生命周期与 9 个可插拔算子槽位,把 evaluator/**、archive.jsonl 与 Train/Gate/Sealed 三层划分锁进受保护运行时,在同一套公平协议下复现并对比了 AHE、Hyperagents、A-Evolve 与 GEPA。 |
| Dream-RSI | 官方站点 dream-rsi.com(另见同脉络预印本 arXiv:2609.14858) | 可回放发现世界:把已记录的历史发现过程与轨迹档案当作可回放、可推演的搜索世界(Replayable Search World),用来训练和改进后续的探索策略。 |
| GEAR | 官方标注 2026-10 预印本 / GitHub | 通用模块化演化底座:支持提议(Proposal)、评估(Evaluation)和选择(Selection)算法的自由替换与组合;目前完整的模型权重与 Harness 联合训练闭环仍在持续开发中。 |
| PenguinHarness | GitHub 开源工程平台(本轮未核准到日首次公开时间) | 插件化 RSI 实验台:统一管理 Benchmark、版本快照和评测记录,除了默认迭代流外,内置了 OPRO、APE、ACE、AWM 等经典提示词与工作流演化插件。 |
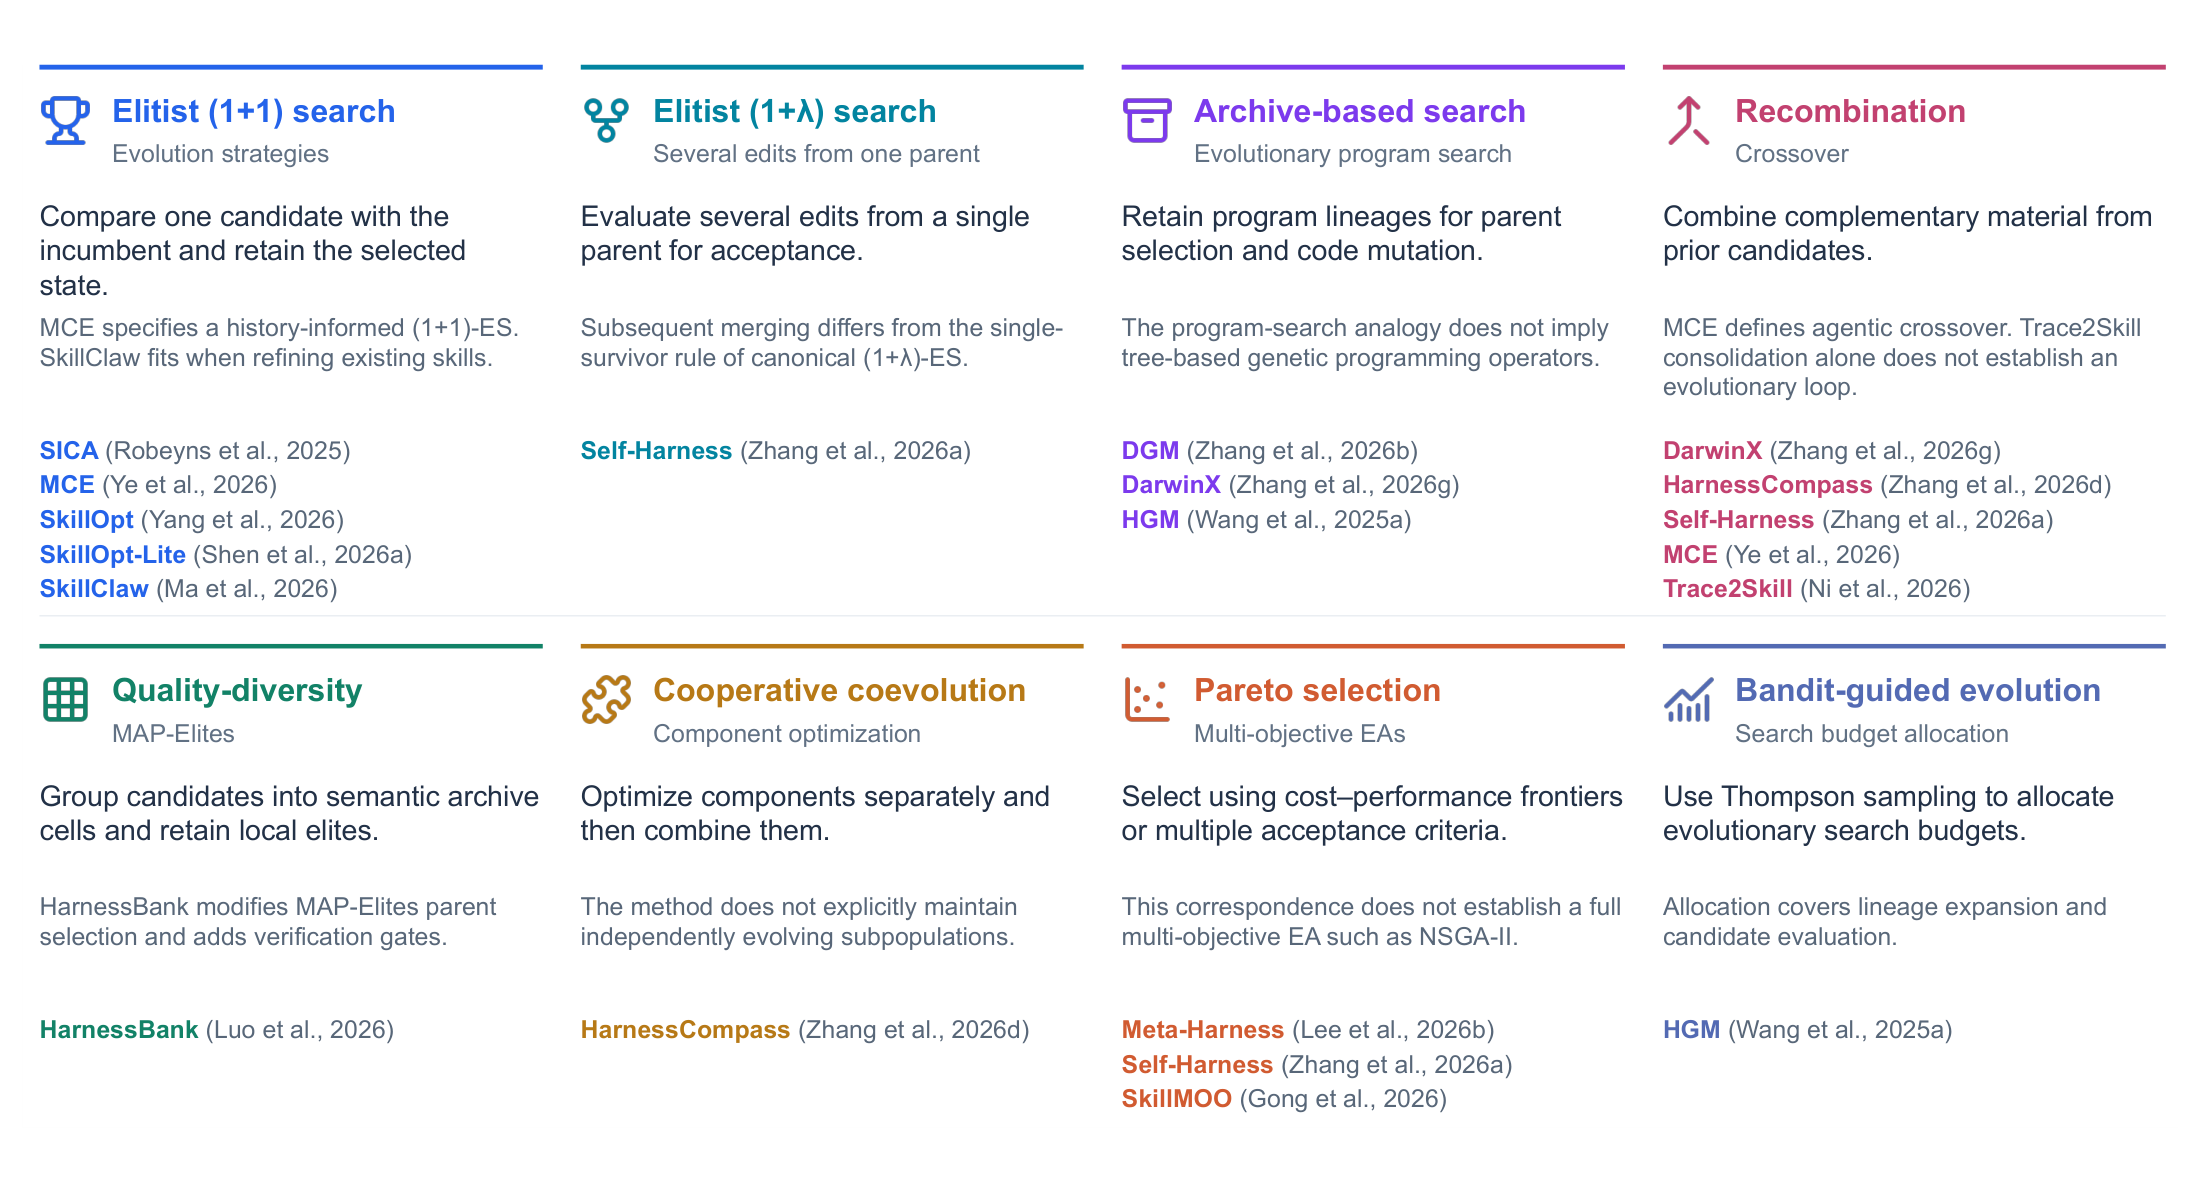
Self-Evolving Agent Harness 综述梳理的 8 类演化算法对应关系(源自 arXiv:2610.18813 Fig. 2),涵盖 (1+1) 精英搜索、(1+λ) 搜索、档案库搜索、重组交叉、MAP-Elites 质量多样性、协同演化、帕累托选择与 Bandit 预算分配。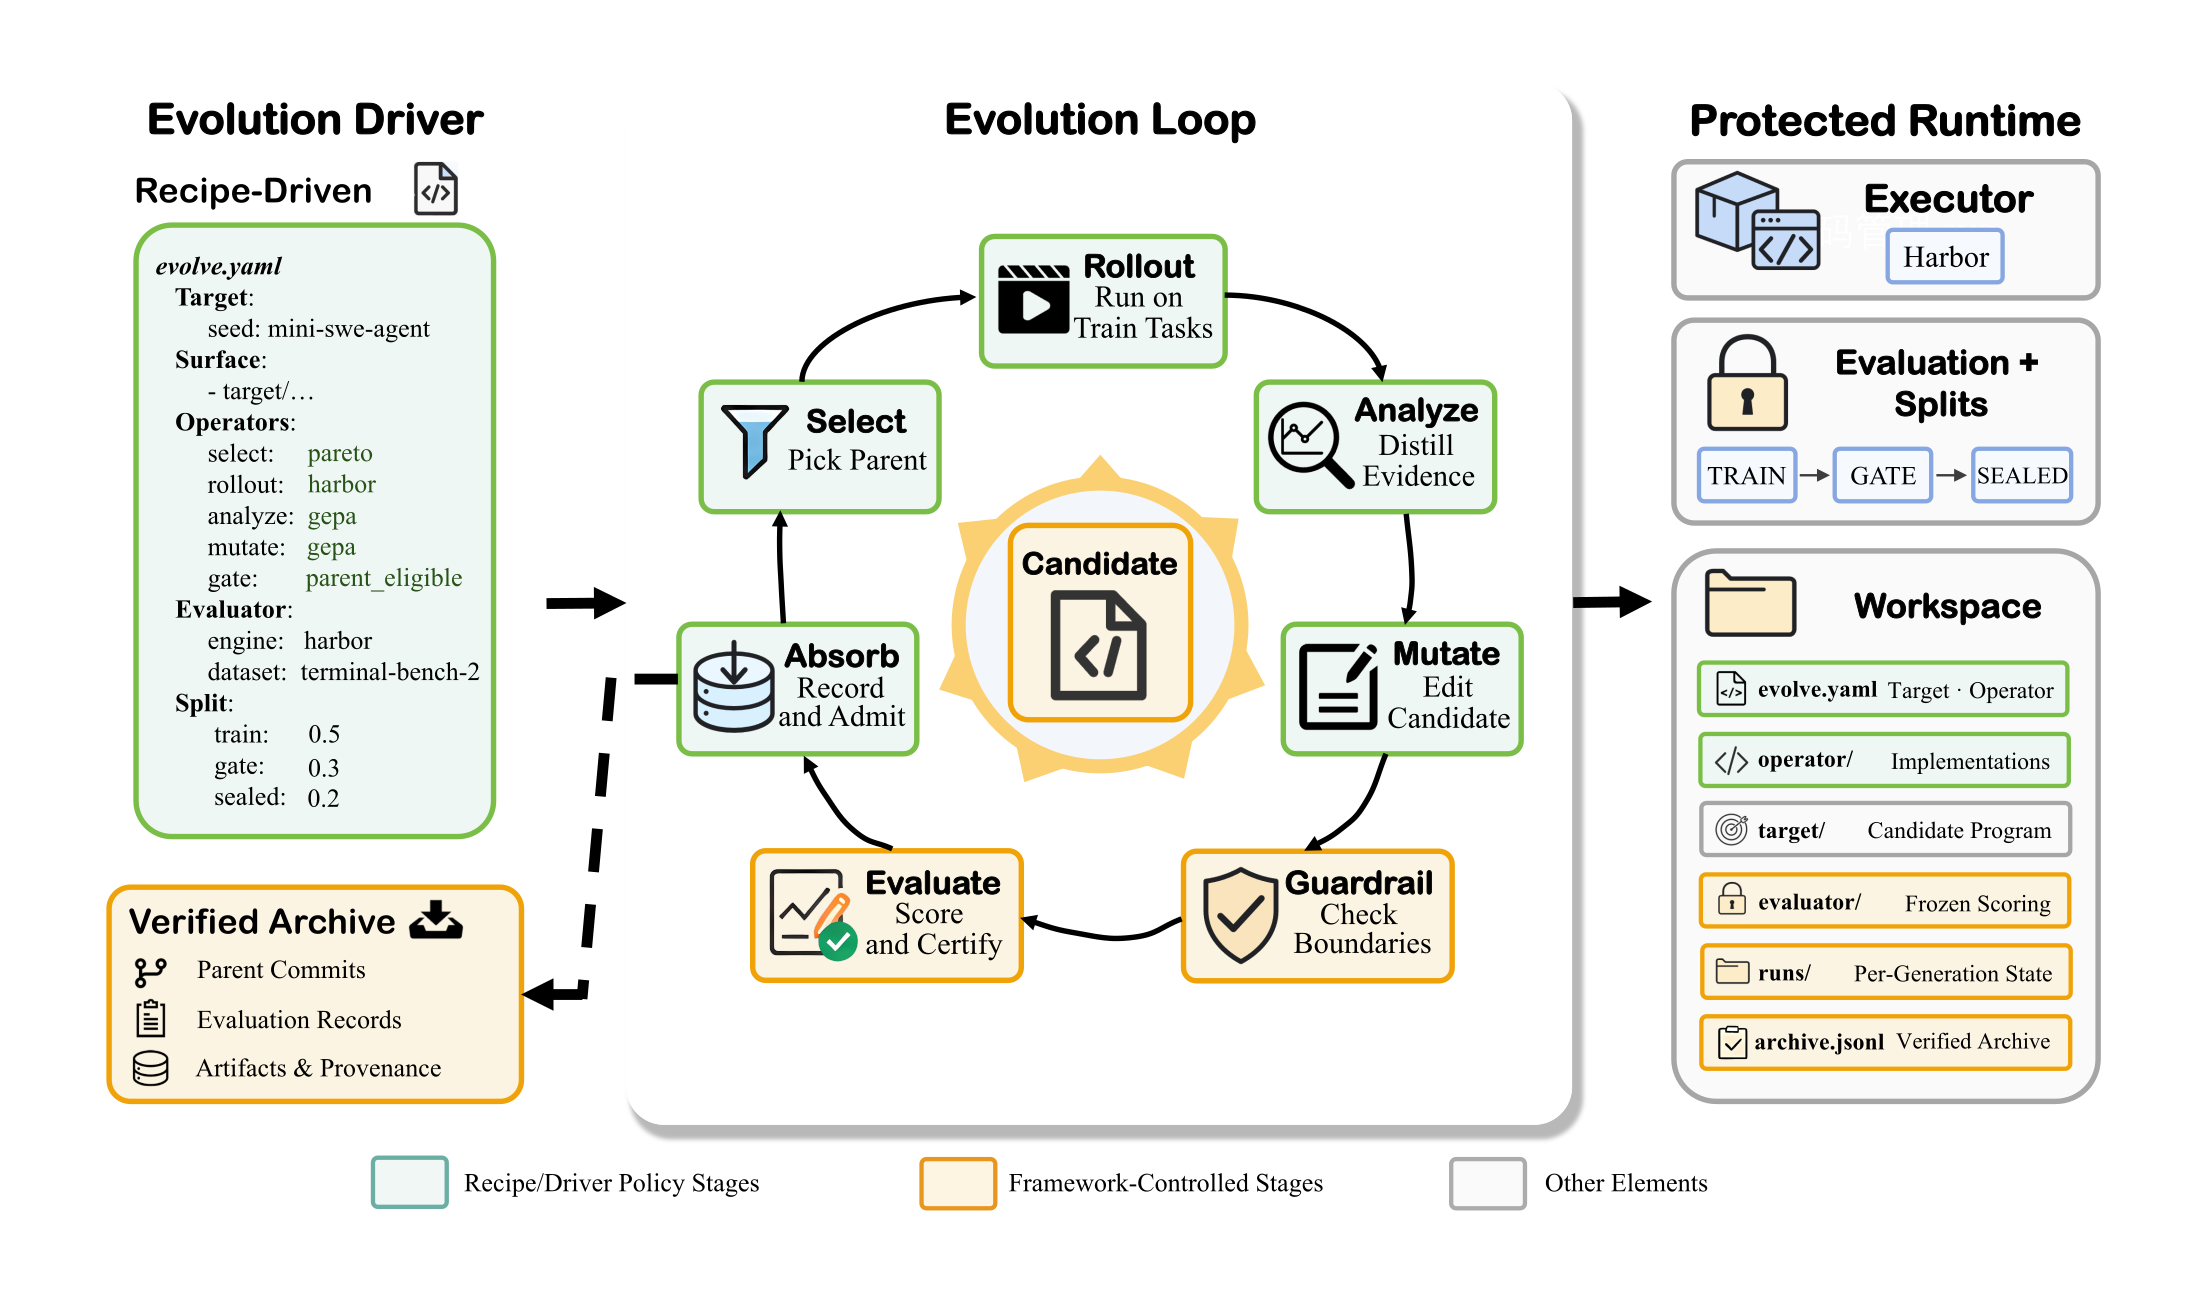
arXiv:2610.32253)。通过统一的 7 阶段演化生命周期与 Train/Gate/Sealed 三层隔离评测,在同一沙箱内公平对比不同 Harness RSI 算法。这里特别值得拎出来的是 Self-Evolving Agent Harness(arXiv:2610.18813) 和 RSIHub(arXiv:2610.32253) 共同揭示的一个残酷事实:在没有严格留出集隔离(Sealed Holdout)和回归预算控制的情况下,许多自我演化方法在训练集上的涨分,到了未见过的任务上会出现负迁移(例如 RSIHub 实验里观察到的 Train +4.1%、Sealed -4.1%)。 这也是为什么未来所有严肃的 Harness RSI 工作都必须把“准入机制(Admission Rule)”放在与“提议机制(Proposal)”同等甚至更高的位置上。
11. 阅读优先级:面对四个核心疑问,先读哪几篇
面对近 50 篇文献,不需要从头按时间顺序硬啃。根据你想搞清楚的具体工程问题,推荐按下面四组精准切入:
| 你最想搞清楚的问题 | 优先精读组合 | 读的时候重点看什么 |
|---|---|---|
| 1. “这不就是让 Coding Agent 帮忙改代码吗?” | Meta-Harness(2603.28052) Self-Harness(2606.09498) AHE(2604.25850) | 看它们怎样通过文件系统组织全量历史轨迹证据、怎样用三层可观测性提出可证伪的修改假设,以及怎样针对模型自身的失败模式做最小回归验证,而不是盲目让 LLM 自由发挥重写整个仓库。 |
| 2. “递归(Recursive)究竟体现在哪里?” | STOP(2310.02304) Hyperagents(2603.19461) VERSE(2610.02616) Harness²(2610.14224) | 严格区分“修改执行器(Executor)”与“修改优化器(Optimizer / Meta-Agent)”。重点看 VERSE 为什么证明“没有执行验证的优化器自进化无效”,以及 Harness² 怎样把当前任务的产物选择与跨任务的改进经验沉淀拆成两层递归。 |
| 3. “自动跑分会不会只是在刷 Benchmark?” | ModularRSI(2609.14857) RRSI(2609.24972) StarHarness(2608.24804) RSIHub(2610.32253) | 看数据隔离(可见搜索集 / 隐藏选择集 / 密封测试集)、五模块独立修改作用域、修改预算退火、防刷榜 Critic 与冗余剪枝,理解怎样在制度上堵死硬编码作弊。 |
| 4. “有限预算下怎么搜索、怎么部署?” | DGM(2505.22954) MGM(2608.07645) MESH-Harness(2610.05300) HarnessPro(2610.26770) SoL-Pi(2609.20519) | 对比分支保留、跨分支杂交、LinUCB 模块组合搜索、无标签自测出三档配置,以及运行时砍掉一半 Token 流量的四项确定性原语。 |
如果只精读两篇奠基之作,建议先读 Meta-Harness 和 Hyperagents:前者帮你看清“基于文件系统的自动化 Harness 工程”的基本形态;后者最直接回答“优化 Agent”与“优化自我改进机制”之间的本质差别。如果只精读两篇近三个月的最新代表作,建议读 VERSE 和 RRSI(或结合本站已拆解的 SoL-Pi 与 Harness²):它们分别代表了“受执行验证约束的元进化”与“防过拟合正则化”的最新水位。
12. 对 GUI Agent 与 APP 自动化测试 / Mobile QA 的启发
站在 GUI Agent 与移动端自动化测试(Android / iOS / H5 / Hybrid App E2E 测试、探索性测试与 UI 回归)的工程视角看,近三个月 Harness RSI 的演进直接命中了移动端 QA 长期头疼的几个核心痛点。如果要在移动测试平台落地自演化能力,最值得直接借鉴的有五条具体实践:
12.1 像 ModularRSI 和 RoboRSI 一样,按职责模块锁死自修改边界
移动端测试 Agent 跑挂一条用例,原因可能出在完全不同的层:
- 屏幕感知与 Grounding 层:无障碍树(Accessibility Tree / View Hierarchy)节点缺失、WebView DOM 未暴露、或者视觉坐标点击偏了;
- 动作执行与等待层:Appium / UIAutomator / XCUITest / Maestro 点击过快、页面转场动画未结束、软键盘遮挡了底部按钮;
- 系统弹窗与异常恢复层:突然弹出系统权限框、青少年模式弹窗、版本升级提示或登录态失效;
- 业务断言(Oracle)层:只看了最后一屏截图,没核对接口回执、本地 SQLite/MMKV 状态或订单号。
如果像早期方法那样让 Agent 每次失败都去通篇重写测试框架或全局系统提示词,修好一个弹窗往往会把原本稳定的商品加购流程改挂。应当借鉴 ModularRSI 的五模块解耦与 RoboRSI 的自顶向下责任归因(TSR):先把失败轨迹定界到“等待策略 / 弹窗处理 / 元素定位 / 完结断言”中的某一个独立子模块,只允许修改责任模块内的规则或辅助脚本,其他模块一律只读锁定。
12.2 像 OO-Harness 一样,用“基类 + 业务域子类 + 路由”管理跨端跨业务脚本
一个大型 App 往往同时包含原生页面、H5 营销页、小程序容器、直播间、IM 聊天和第三方支付 SDK。试图维护唯一一份“全能移动端系统提示词”是不现实的。
借鉴 OO-Harness 的面向对象继承设计:
- Base Mobile Harness(基类):封装所有业务共用的设备初始化、adb / WDA 连接保活、
logcat/ Crash 捕获、通用系统权限弹窗关闭和截图/层级树对齐; - Specialized Sub-Harnesses(业务子类):通过继承派生出
EcommerceCheckoutHarness(重写价格核验与优惠券断言钩子)、LiveStreamHarness(重写高动态画面等待与弹幕过滤策略)、WebViewHybridHarness(重写上下文切换与 DOM 注入脚本)等子类; - Runtime Router:在测试任务下发时,根据入口 Deeplink、页面包名或用例标签动态路由到对应子类,并在单业务域回归中独立演化对应子类,互不污染。
12.3 像 StarHarness、RRSI 和 RSIHub 一样,严防“测试脚本通过改弱断言来刷高通过率”
在自动化测试里引入自修复(Self-Healing)或自演化时,最危险的假阳性就是:候选 Agent 为了让失败用例变绿,偷偷删掉了末尾的价格校验断言,或者把 assert order_status == "PAID" 放宽成了 assert page_loaded == True。
必须直接引入 RSIHub 的冻结区原则与 StarHarness / RRSI 的准入护栏:
- 业务 Oracle 与评分器物理只读:测试断言脚本、后端数据库核验逻辑、Crash/ANR 零容忍门禁必须放在
evaluator/冻结目录中,任何演化算子触碰即拒绝; - 三划分验证(Visible / Hidden / Sealed):让 Proposer 在少量高频失败的录制回放轨迹上诊断并提议定位/等待补丁(Visible),在一批同业务域但未向 Proposer 暴露轨迹的用例上做准入筛选(Hidden Gate),并定期在密封的核心冒烟回归集(Sealed)上检查是否引入了回归倒退;
- RRSI 式的减法剪枝:随着 App 版本迭代,旧版本特有的临时弹窗兼容规则会逐渐失效。定期运行 Pruner 剔除那些不再触发、或徒增等待耗时与 Token 开销的陈旧规则。
12.4 像 RiseHarness 和 VERSE 一样,针对 Flaky Tests 建立“同用例成对轨迹对齐 + 回放验证”
移动端 UI 测试里最消耗人力的是 Flaky Tests(偶发失败用例)——同一个版本跑 5 次,3 次过、2 次挂。
这正是 RiseHarness 专门处理的 Flipping Tasks:不要只看挂掉的那一次轨迹,而是把同用例的成功运行轨迹(含每一步的 UI 树快照、动作时间戳、网络耗时与 Harness 内部等待日志)作为 Reference Trajectory,与失败轨迹做逐段对齐,一眼就能看出是哪一步的异步接口返回慢了 800ms 导致点击落空。同时借鉴 VERSE:允许排障优化器自己编写确定性的轨迹比对小工具(例如自动比对两帧 XML 树关键节点的 diff 工具),且任何修复补丁必须先在失败回放镜像上验证通过才能合入。
12.5 像 SoL-Pi 和 HarnessMM 一样,用观察值句柄化与受保护决策图砍掉多模态账单
长链路真机测试每一步都会产出高清截图、几十 KB 的 XML 控件树和几千行 logcat,直接全量重放很快就会撑爆 VLM 上下文并拉高测试成本。
- 借鉴 SoL-Pi 的 ObservationPack 与 EPR:只保留最近 2 步的完整控件树与截图,历史步骤原地替换为摘要句柄;对长
logcat用小模型提取报错行并强制做body.includes(quote)逐字节校验; - 借鉴 HarnessMM 的可执行决策图(Executable Decision Graphs):对于测试前置步骤(如“冷启动 App → 同意隐私协议 → 账号密码登录 → 跳过首页引导弹窗 → Deeplink 跳转目标页”),一旦在演化中验证出了稳定的动作与守卫条件(例如检测到固定控件 ID 与文本即点击),就将其编译进受保护决策图,在运行时由原生接口直接执行,跳过慢速 VLM 推理回调;只有当页面出现未知改版或守卫条件不满足时,才重新唤醒大模型接管。
13. 附录:截至 2026 年 11 月 2 日 Harness RSI 代表性工作完整清单
以下完整收录按首次公开提交日期从早到晚排列的 49 项代表性工作(含 45 篇时间线算法论文与 4 项工程框架/综述补充)。
13.1 2023—2025:从自改进程序,到自修改 Agent(11 篇)
| 首次日期 | 工作 | 范围 | 核心贡献 | 论文链接 |
|---|---|---|---|---|
| 2023-09-28 | Promptbreeder | 相关/元改进 | 同时演化任务 prompt 和负责变异的 mutation prompt,是“改进改进机制”的早期代表。 | arXiv:2309.16797 |
| 2023-10-03 | STOP:Self-Taught Optimizer | 元改进 | 从一个调用 LLM 的程序优化器出发,让优化器优化自己的代码。 | arXiv:2310.02304 |
| 2024-08-15 | ADAS:Automated Design of Agentic Systems | 相关 | Meta Agent Search 根据历史档案,用代码不断设计新 agent,覆盖 prompt、工具使用和工作流。 | arXiv:2408.08435 |
| 2024-10-06 | Gödel Agent | 主线/元改进 | 自引用 agent 框架,让 agent 依据目标与反馈修改自身逻辑。 | arXiv:2410.04444 |
| 2024-10-14 | AFlow | 相关 | 将代码表示的 agent 工作流作为搜索对象,用 MCTS、执行反馈和代码修改优化工作流。 | arXiv:2410.10762 |
| 2025-04-21 | SICA:A Self-Improving Coding Agent | 主线 | Coding Agent 利用执行反馈自主编辑自己的代码库,通过代码更新改善能力。 | arXiv:2504.15228 |
| 2025-05-29 | DGM:Darwin Gödel Machine | 主线/元改进 | 保存多条 agent 演化分支,通过自修改和 benchmark 验证扩大 agent 档案,而非只沿最新版本迭代。 | arXiv:2505.22954 |
| 2025-07-25 | GEPA | 相关 | 读取完整执行轨迹,反思、变异 prompt,并利用 Pareto 候选集合组合互补经验。 | arXiv:2507.19457 |
| 2025-10-06 | ACE:Agentic Context Engineering | 相关 | 用生成、反思、整理流程持续演化 contextual playbook;主要改变上下文知识,而非执行器代码。 | arXiv:2510.04618 |
| 2025-10-24 | HGM:Huxley-Gödel Machine | 主线/元改进 | 指出“当前任务得分高”不等于“后续自改进潜力高”,用后代生产力估计指导演化分支选择。 | arXiv:2510.21614 |
| 2025-11-17 | Live-SWE-agent | 主线 | 从最小 bash scaffold 出发,在解决软件问题的运行过程中动态演化自身工具与 scaffold。 | arXiv:2511.13646 |
13.2 2026 年 1—6 月:完整 Harness 优化与优化器自演化(12 篇)
| 首次日期 | 工作 | 范围 | 核心贡献 | 论文链接 |
|---|---|---|---|---|
| 2026-01-29 | MCE:Meta Context Engineering | 相关/元改进 | 双层演化:底层更新 context artifacts,元层更新负责 context engineering 的 skills。 | arXiv:2601.21557 |
| 2026-02-04 | GEA:Group-Evolving Agents | 主线 | 以 agent 群体作为演化单位,共享不同分支的探索经验,减少演化分支之间的信息隔离。 | arXiv:2602.04837 |
| 2026-02-10 | AutoHarness | 主线 | 根据环境反馈自动合成代码 harness,限制非法动作;进一步探索把完整策略生成为代码。 | arXiv:2603.03329 |
| 2026-03-19 | Hyperagents/DGM-H | 元改进 | 把 task agent 与 meta-agent 放入同一可编辑程序,使“生成未来改进的机制”也能被修改。 | arXiv:2603.19461 |
| 2026-03-30 | Meta-Harness | 主线 | Coding proposer 通过文件系统访问所有历史候选的源码、评分和轨迹,端到端搜索 harness 代码。 | arXiv:2603.28052 |
| 2026-04-28 | AHE:Agentic Harness Engineering | 主线 | 用组件、经验和决策三层可观测性组织演化;每次修改提出可检验的预测,再核对实际结果。 | arXiv:2604.25850 |
| 2026-05-11 | Continual Harness | 主线 | 在不重置环境的连续交互中,在线更新 prompt、subagents、skills 和 memory;另有模型共同学习扩展。 | arXiv:2605.09998 |
| 2026-05-21 | MOSS | 主线 | 根据生产失败证据进行源码级重写,通过候选镜像回放、版本切换和回滚组织更新。 | arXiv:2605.22794 |
| 2026-05-23 | DemoEvolve | 主线 | 面向长任务的稀疏反馈,引入示范辅助 harness 演化,补足单纯成功/失败信号的信息不足。 | arXiv:2605.24539 |
| 2026-05-26 | SIA:Self Improving AI with Harness & Weight Updates | 相关:联合优化 | 由 Feedback-Agent 同时更新任务 agent 的 harness 与模型权重。 | arXiv:2605.27276 |
| 2026-06-04 | RHO:Retrospective Harness Optimization | 主线 | 从历史轨迹挑选困难任务并重新执行,通过自验证、自一致性与成对自偏好选择更新,不依赖外部标准答案评分。 | arXiv:2606.05922 |
| 2026-06-08 | Self-Harness | 主线 | 同一基础模型完成弱点挖掘、最小修改提议和回归验证,强调适配模型自身的失败模式。 | arXiv:2606.09498 |
13.3 2026 年 7—9 月:模块化、泛化与搜索成本(11 篇)
| 首次日期 | 工作 | 范围 | 核心贡献 | 论文链接 |
|---|---|---|---|---|
| 2026-07-17 | RHI:Recursive Harness Self-Improvement | 主线 | 将 agent loop 表示成 prompt 级规范,利用历史版本之间的成对反馈进行轻量迭代。 | arXiv:2607.15524 |
| 2026-08-07 | MGM:Mendel Gödel Machine | 主线 | 引入跨任务轨迹比较与跨演化分支杂交,更充分地使用历史档案,而非只看单条失败轨迹。 | arXiv:2608.07645 |
| 2026-08-09 | HSI:Hierarchical Self-Improvement | 元改进 | 三层结构:任务 harness、修改 harness 的 evolver,以及修改 evolver 策略代码的 meta-evolver。 | arXiv:2608.08466 |
| 2026-08-15 | Evo-Harness | 相关 | 将单次执行中的上下文经验编译成跨任务、任务类型级的可复用 skill harness。 | arXiv:2608.15071 |
| 2026-08-25 | Metaⁿ | 元改进 | 保持元操作固定,反复作用于不断扩展的 solver stack,搜索多层改进结构。 | arXiv:2608.24735 |
| 2026-08-25 | StarHarness | 主线 | 针对企业环境演化工具接口、skills、MCP、subagents 等;分离 proposer 可见任务、隐藏选择任务与最终测试集。 | arXiv:2608.24804 |
| 2026-09-01 | HarnessEvolve | 主线 | 用参考轨迹对齐失败执行,定位系统性错误,并将执行、评估、优化和准入分离。 | arXiv:2609.00829 |
| 2026-09-14 | ModularRSI | 主线 | 将 harness 拆成 agent loop、tool use、observation、context 和 completion 五个模块;独立演化后集成,使用与评测集分离的演化任务。 | arXiv:2609.14857 |
| 2026-09-17 | SoL-Pi | 主线 | 通过大规模 auto-research 搜索降低 token 成本的机制,覆盖执行、上下文压缩、观察处理和委托阅读。 | arXiv:2609.20519 · 本站精读 |
| 2026-09-21 | RRSI:Regularized RSI | 主线 | 对提议与选择过程施加正则:修改预算、评测特化审查、噪声门槛、成本约束和剪枝,重点解决过拟合。 | arXiv:2609.24972 |
| 2026-09-29 | SelfSearch | 主线/元改进 | 搜索时利用过去自修改过程的记录,不依赖反复运行下游奖励评估,降低搜索成本。 | arXiv:2609.37968 |
13.4 2026 年 10 月:优化器演化、跨模型优化与应用分支(14 篇)
| 首次日期 | 工作 | 范围 | 核心贡献 | 论文链接 |
|---|---|---|---|---|
| 2026-10-02 | VERSE | 元改进 | 优化器同时修改 executor harness 和自己的 prompt、skills、tools、hooks;通过执行验证草稿修改、回放失败并跟踪回归。 | arXiv:2610.02616 |
| 2026-10-02 | Recursive Harness Self-Improvement for Frontier Reasoning Data Synthesis | 应用分支 | 联合演化生成任务与数据合成 harness,更新 skills、prompt 和工作流以生成更难且有效的推理数据。 | arXiv:2610.03548 |
| 2026-10-04 | MESH-Harness | 主线 | 模块化候选池加 bandit 引导的组合搜索,在有限评测预算下选择、重组和修改 harness。 | arXiv:2610.05300 |
| 2026-10-08 | MASS:Multi-Agent Self-Supervision | 相关:联合优化 | 交替进行多 agent 工作流演化和轨迹 SFT;更新后的模型参与下一轮优化与评估。 | arXiv:2610.12176 |
| 2026-10-08 | RoboRSI | 应用分支 | 用分层 skill 与明确接口定位机器人执行失败,将修改限制在责任分支,验证后形成可复用技能。 | arXiv:2610.12424 |
| 2026-10-09 | Harness² | 主线/元改进 | 两层递归:当前任务的 Propose–Probe–Compose,以及跨任务持续更新“改进 harness”;不要求在线标准答案。 | arXiv:2610.14224 · 本站精读 |
| 2026-10-15 | RSIFlow | 元改进 | 根据瓶颈动态选择不同组件的改进工作流,再将结果提炼为 meta-agent 的 skills 和跨组件原则。 | arXiv:2610.21791 |
| 2026-10-15 | MetaShare | 主线/元改进 | 跨演化分支共享成功与失败修改及收益变化,并主动补充欠探索的机制类型。 | arXiv:2610.21887 |
| 2026-10-16 | Self-HPO:Harness-Policy Optimization | 相关:联合优化 | 当前 policy 提议 harness,随后在选定 harness 下进行 RL;训练中的困难任务驱动下一轮搜索。 | arXiv:2610.22791 |
| 2026-10-19 | HarnessPro | 主线 | 以性能与成本为多目标演化 harness,通过模型生成测试进行无标签评估,输出不同预算档位。 | arXiv:2610.26770 |
| 2026-10-20 | RiseHarness | 主线 | 联合 agent 轨迹与 harness 内部执行轨迹分析不稳定任务,并借鉴其他框架的机制进行修改。 | arXiv:2610.27435 |
| 2026-10-20 | MaD-RSI | 主线 | 将多个异构模型的失败轨迹作为优化数据,直接学习跨模型共享的 harness。 | arXiv:2610.28201 |
| 2026-10-20 | OO-Harness:Object-Oriented Harness | 主线 | 用继承构建专门化 harness 类层次,运行时通过 router 为任务选择合适子类。 | arXiv:2610.28380 |
| 2026-10-23 | HarnessMM | 主线 | 演化可复用的决策图,在满足条件时复用已确定动作,减少重复推理调用。 | arXiv:2610.32813 |
| 2026-10-26 | RSIV-Harness | 应用分支 | 面向多轮文本到可视化,通过失败轨迹修改 harness,并用 anchor、memory 检查与恢复机制控制更新。 | arXiv:2610.35316 |
参考与延伸阅读
- 本站相关源码级精读:
- 本文机制图可编辑源文件(
.drawio):