SoL-Pi 论文与源码拆解:如何用零侵入扩展把 Coding Agent 的 Token 流量砍半
结合 NVIDIA、NTU 与 MIT 联合发表的 SoL-Pi 论文(arXiv:2609.20519)与 NVlabs/SoL-Pi 开源实现(v0.1.1),拆解 Action Fusion、ObservationPack、Evidence-Preserving Reducer 和 Online Context Compact 四项机制的搜索方法、源码钩子、确定性校验护栏、实验数据与工程边界。
长时间运行的软件工程 Agent 会把大量 Token 花在重复的中间环节上:改完一个文件后单独发起一轮请求去跑可预期的测试命令;十几 KB 的工具输出在后续几十轮请求里被反复重放;子任务已经完成,早期排查过程却一直留在活跃上下文里;为了看清长构建日志里的几行报错,主模型要完整读完整个输出。
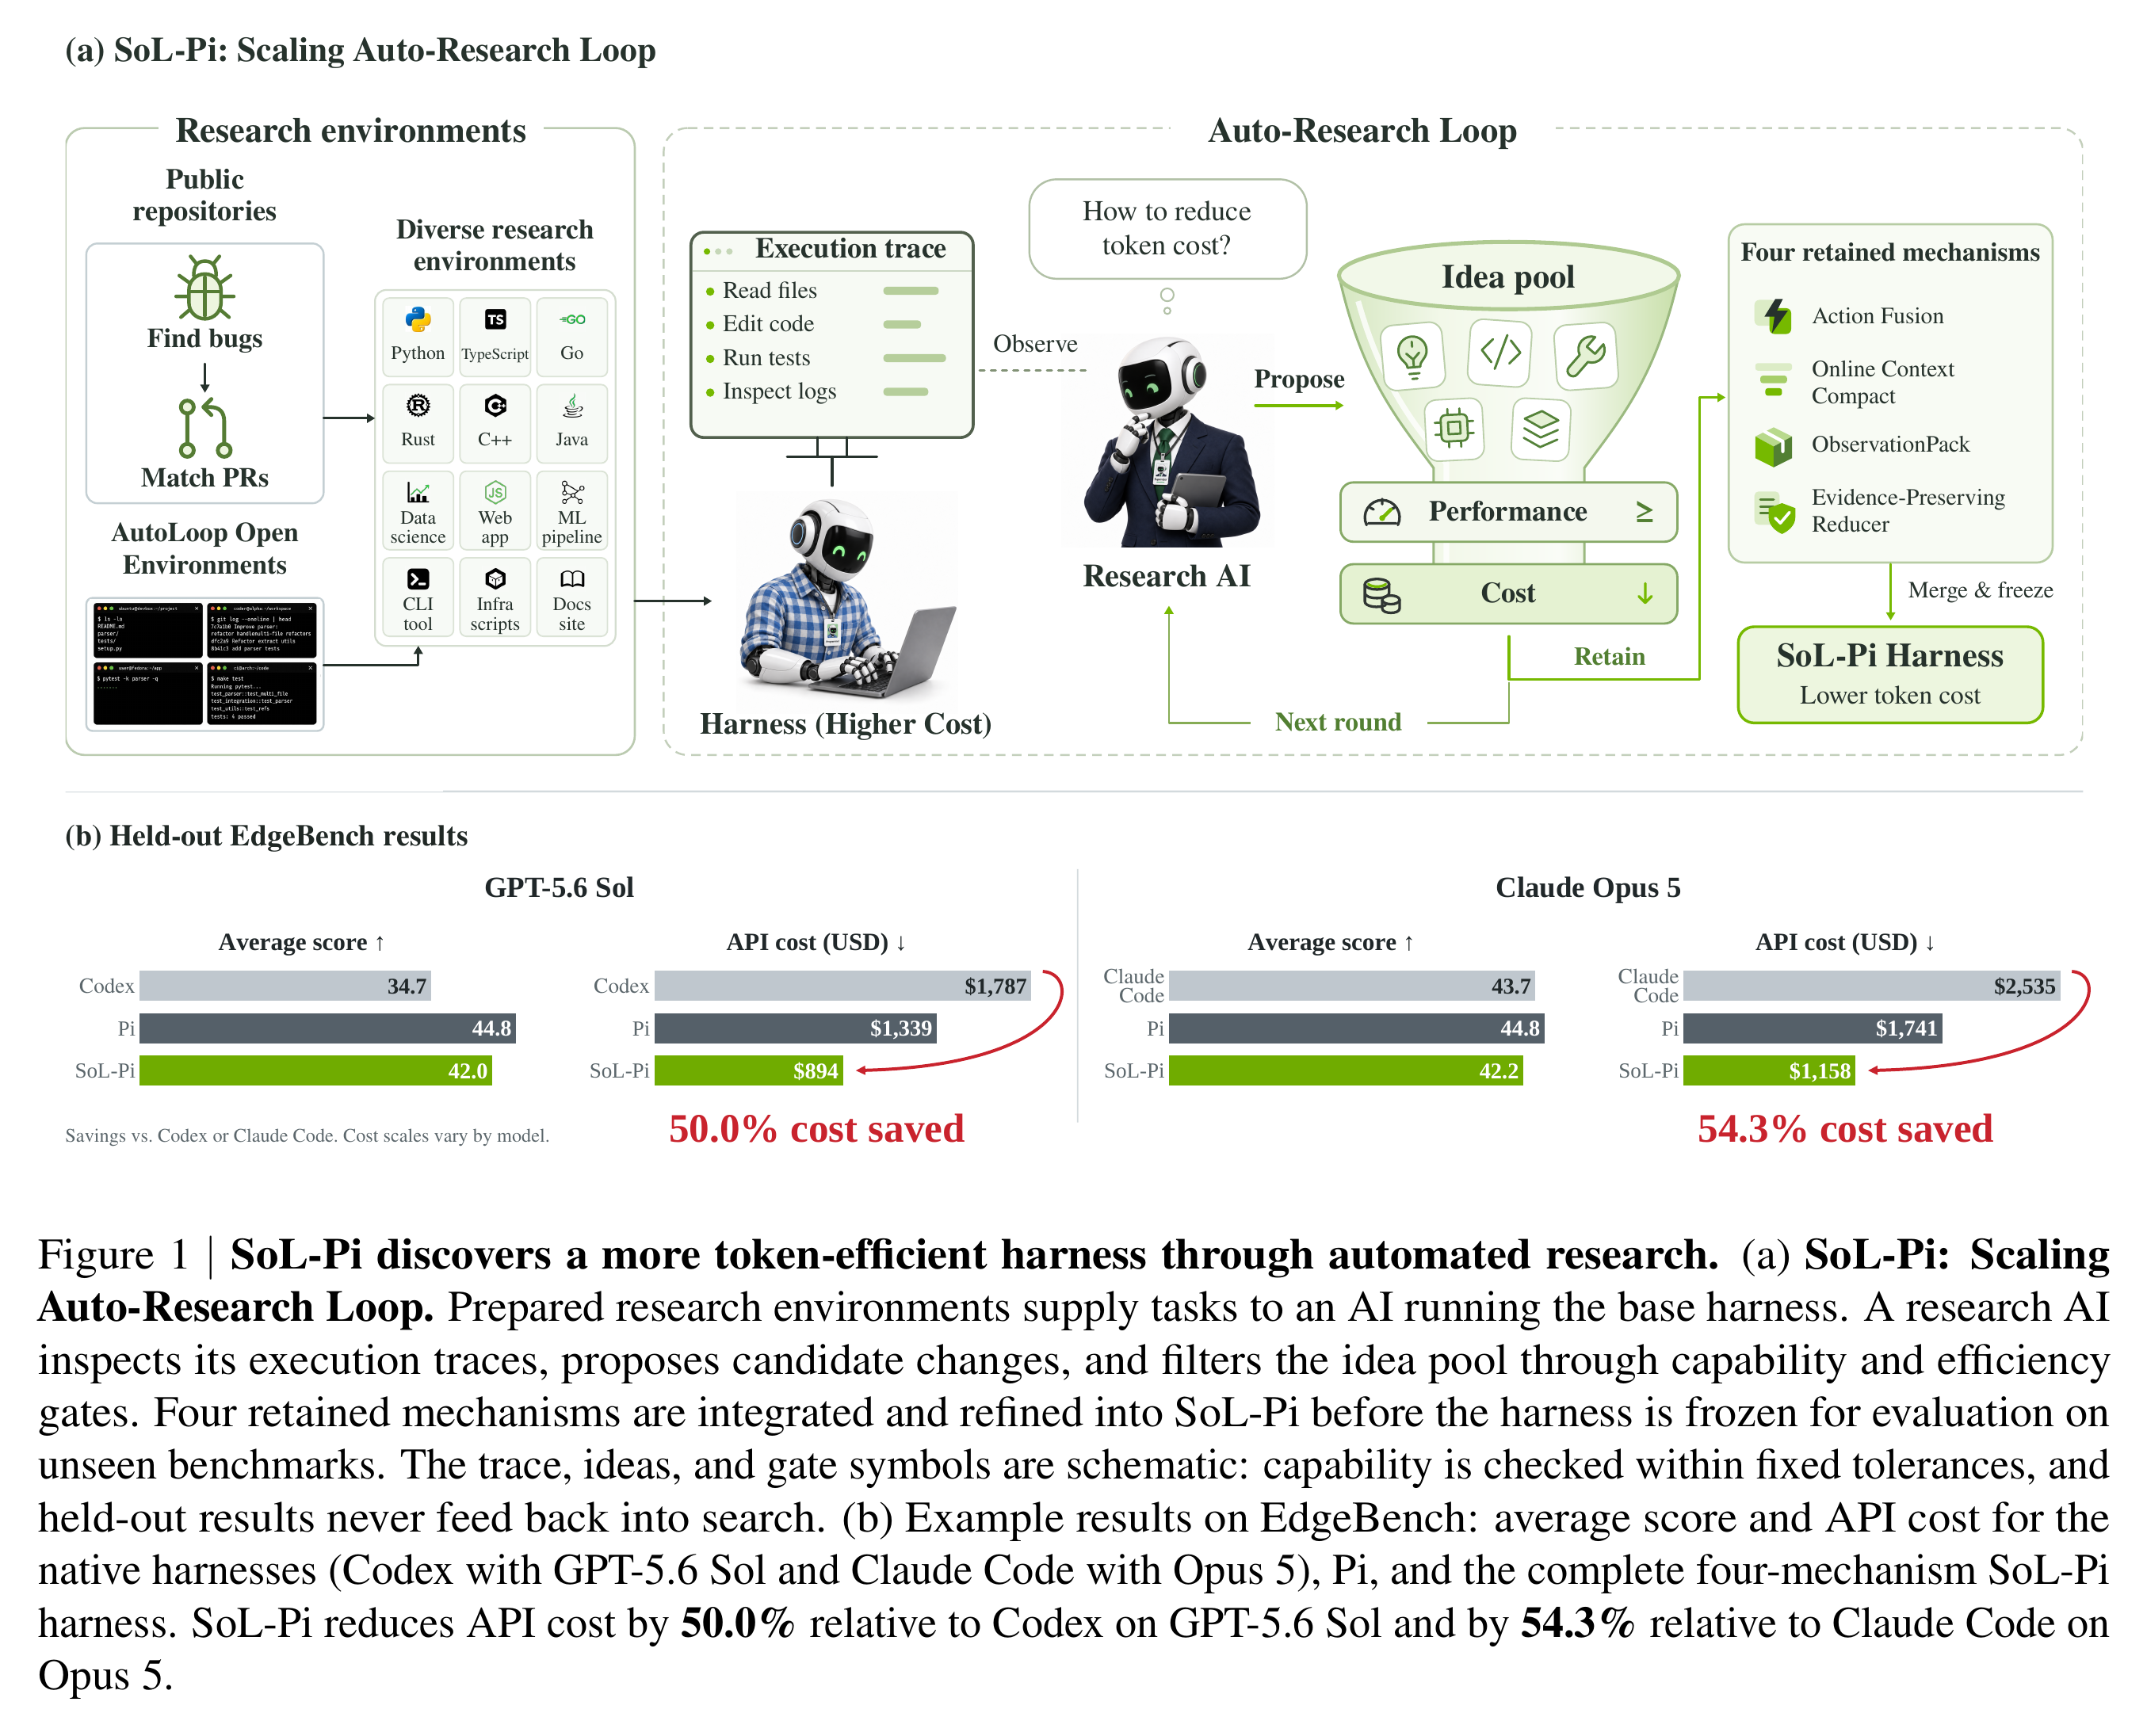
NVIDIA、南洋理工大学(NTU)与 MIT 联合发布的 SoL-Pi(论文 SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness,开源仓库 NVlabs/SoL-Pi)在不修改底层大模型权重、也不侵入宿主框架源码的前提下,从执行脚手架(harness)层解决这一问题。研究团队在 535 个可执行环境中运行了超过 3,000 次实验和 60,000 次环境交互,从 152 个候选方向中筛选出四项正交机制:Action Fusion、ObservationPack、Evidence-Preserving Reducer 和 Online Context Compact。
在 51 个公开任务的 EdgeBench 评测中,开启完整四机制的 SoL-Pi [Efficiency] 在 GPT-5.6 Sol 和未参与搜索的 Claude Opus 5 上分别保留了基线 Pi 93.7%(42.003 vs. 44.833)和 94.3%(42.224 vs. 44.756)的平均得分,同时将记录的 Token 流量降低 44.7%–49.0%,API 成本降低约三分之一(相对 Pi 降低 33.2%–33.5%,相对原生 Codex 和 Claude Code 分别降低 50.0% 和 54.3%)。
下文基于论文 arXiv:2609.20519v1 与 NVlabs/SoL-Pi 仓库提交 21956803(npm 包版本 0.1.1,适配 @earendil-works/pi-coding-agent 0.84.2、1.0.4 与 1.3.0),从自动研究搜索漏斗、扩展生命周期挂载、四项机制源码实现、安全降级边界、实验数据与移动端自动化测试启发六个维度展开拆解。文中将严格区分论文实验结论、源码确定性逻辑与本地测试结果。
目录
- 背景与核心问题:为什么在 Harness 层做受约束降本
- 论文方法:从 152 个假设到 4 项留存机制的广度—深度搜索
- 最小运行示例与仓库结构
- 总体架构:不改一行上游代码的 Pi 扩展挂载链路
- 机制一:Action Fusion(修改与后续命令同轮融合)
- 机制二:ObservationPack(大体积输出延迟替换与按字节分页召回)
- 机制三:Evidence-Preserving Reducer(带逐字节引文校验的日志委派压缩)
- 机制四:Online Context Compact(子任务边界的缓存经济学与自动续跑)
- 扩展生态:SoL-Pi Visual(3D 场景重建)与 SoL-Pi Skill(跨宿主后台委派)
- 错误处理、安全护栏与本地测试验证
- 实验结果与消融分析
- 对 GUI Agent 与 APP 自动化测试 / Mobile QA 的启发
- 局限性、潜在高估风险与源码阅读索引
- 总结与参考链接
1. 背景与核心问题:为什么在 Harness 层做受约束降本
降低 Agent 运行成本通常有三条路径:优化推理底层(如 FlashAttention、PagedAttention)、压缩模型权重(如 SmoothQuant、GPTQ),或者通过模型路由(如 FrugalGPT、RouteLLM)将简单请求分发给小模型。SoL-Pi 选择了与上述方案正交的第四条路径:优化介导模型与环境交互的 Agent Harness。
在长周期任务中,工具调用、上下文管理、结果核验、子代理委派和异常恢复彼此耦合。单纯截断输出或提前停止轮次虽然能省 Token,却容易把关键报错裁掉,或者只是把 Token 开销推迟到后续排障轮次。因此,SoL-Pi 将优化目标定义为受约束的效率提升(constrained efficiency):在不提前终止、不跳过验证、不隐藏原始证据的前提下,减少模型轮次、上下文重放、大体积观察值和长日志直读。
2. 论文方法:从 152 个假设到 4 项留存机制的广度—深度搜索
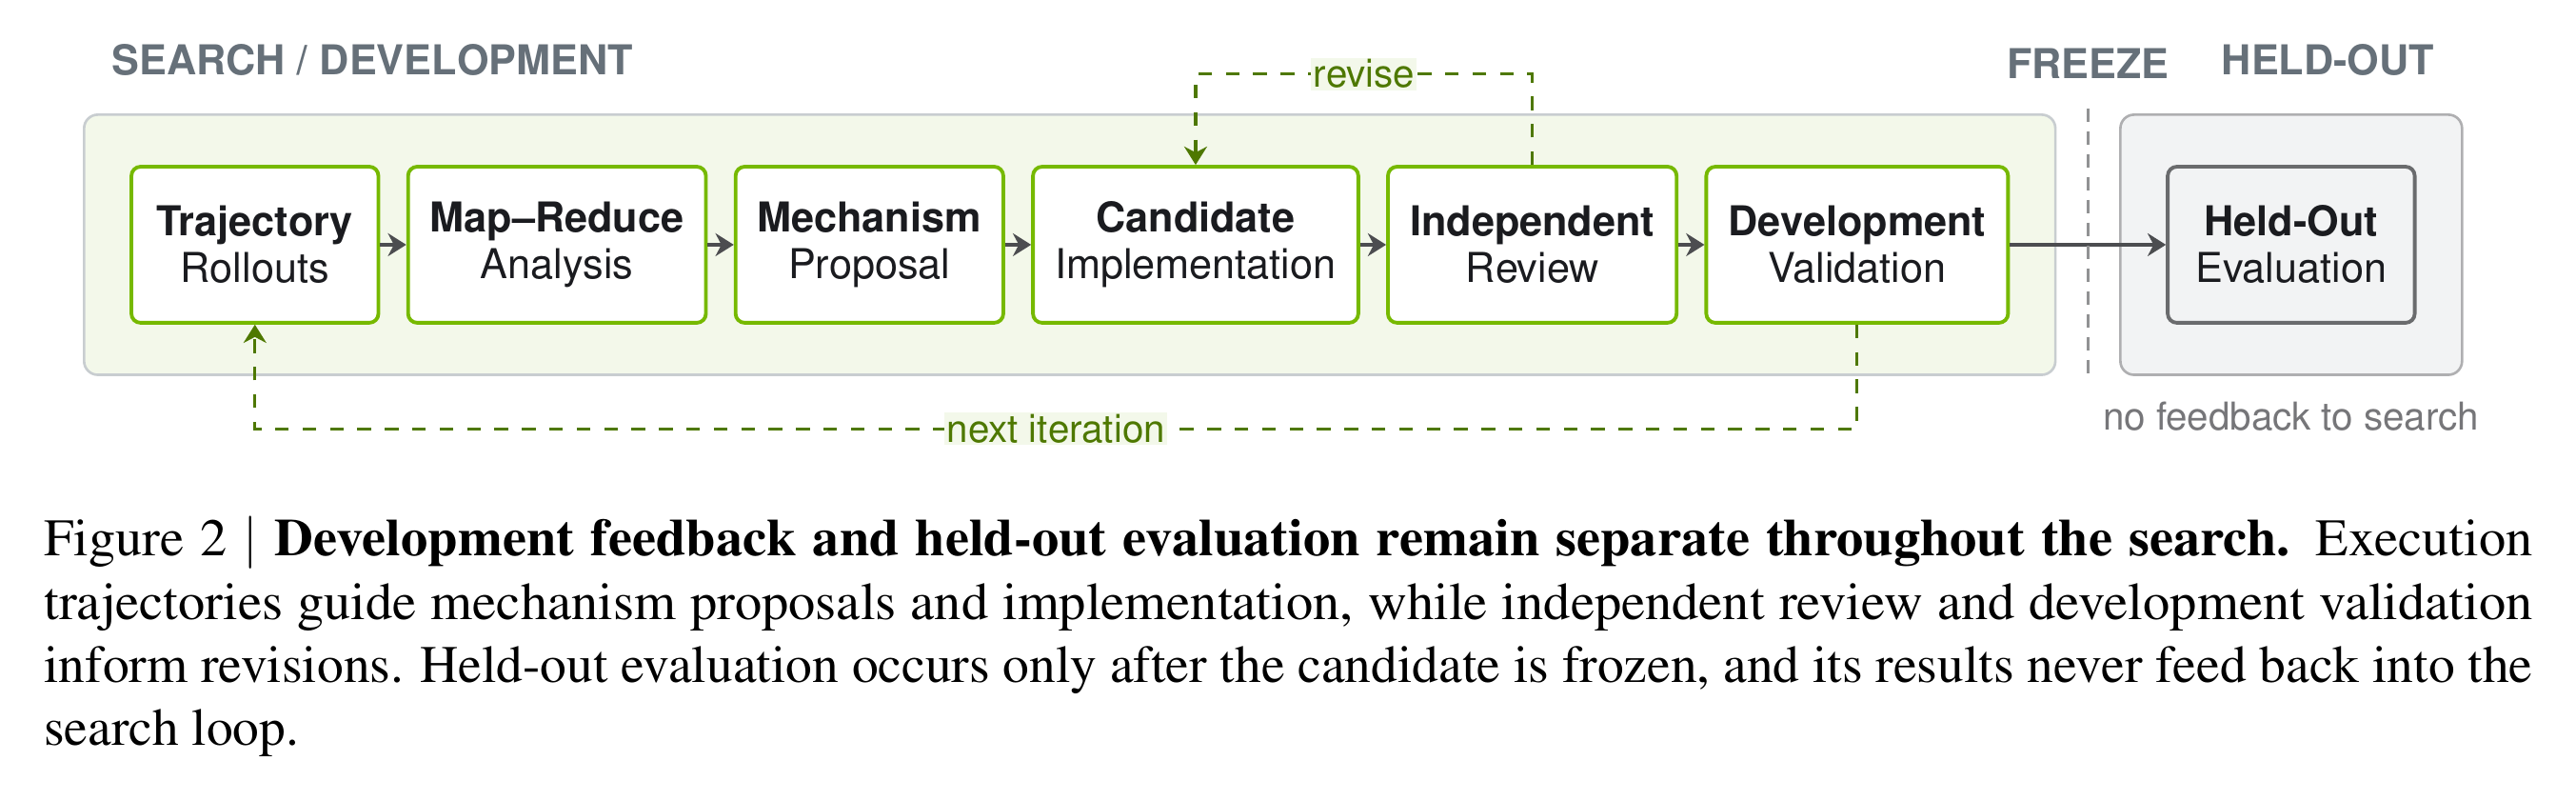
既往的自动 Harness 演进工作(如 Meta-Harness、RHI、AutoHarness)常面临一个质疑:在搜索任务上演化出的提示词或规则容易过拟合,换到未见过的留出任务(held-out tasks)后收益明显缩水。SoL-Pi 在方法设计上重点强化了搜索反馈与最终评测的物理隔离。
2.1 双阶段广度—深度搜索(Broad-to-Deep Harness Search)
搜索过程分为外层广度探索与内层深度打磨两个阶段:
- 外层假设池与 Oracle 分析:研究团队首先从上下文(context)、进度(progress)、工具(tools)、委派(delegation)、提示词与策略(prompt and policy)、改进与评测(improvement and evaluation)六个家族出发,生成了 152 个候选方向。在分配试跑预算前,先通过 Oracle Analysis 检查已有开发轨迹,识别基线 Harness 中可避免的重复开销。
- 内层独立演进谱系(Disposable Lineages):每个入选方向作为一个隔离的临时实验实例运行,遵循
Propose → Implement → Review → Validate循环(结合了 Karpathy 的 autoresearch 循环与 Claude Code 的 Ralph Loop)。实现者按完成标准修改代码后,必须先通过独立审查 Agent(Independent Reviewer)检查才能进入开发验证;多个独立分析器(Analyzers)以 Map–Reduce 方式逐条检查轨迹中的重复动作、上下文膨胀、大观察值或稀疏诊断信号,汇总为下一轮修订依据。 - 双门禁筛选(Sequential Gates):实验开始前固定能力指标、容忍度阈值和效率指标,且对优化 Agent 只读隔离。候选方案必须依次通过两道门禁:
- 能力门禁:所有能力指标必须保持在预声明的容忍度范围内;
- 效率门禁:至少改善一项预声明的效率指标。 通过双门禁后保留帕累托非支配解(nondominated results),最后将各自独立发现的四项机制合并为 SoL-Pi 并冻结代码、配置与超参数。
2.2 535 个搜索环境与留出集划分
为了避免在单一代码库上过拟合,机制发现阶段使用了 535 个可执行环境,分为两类:
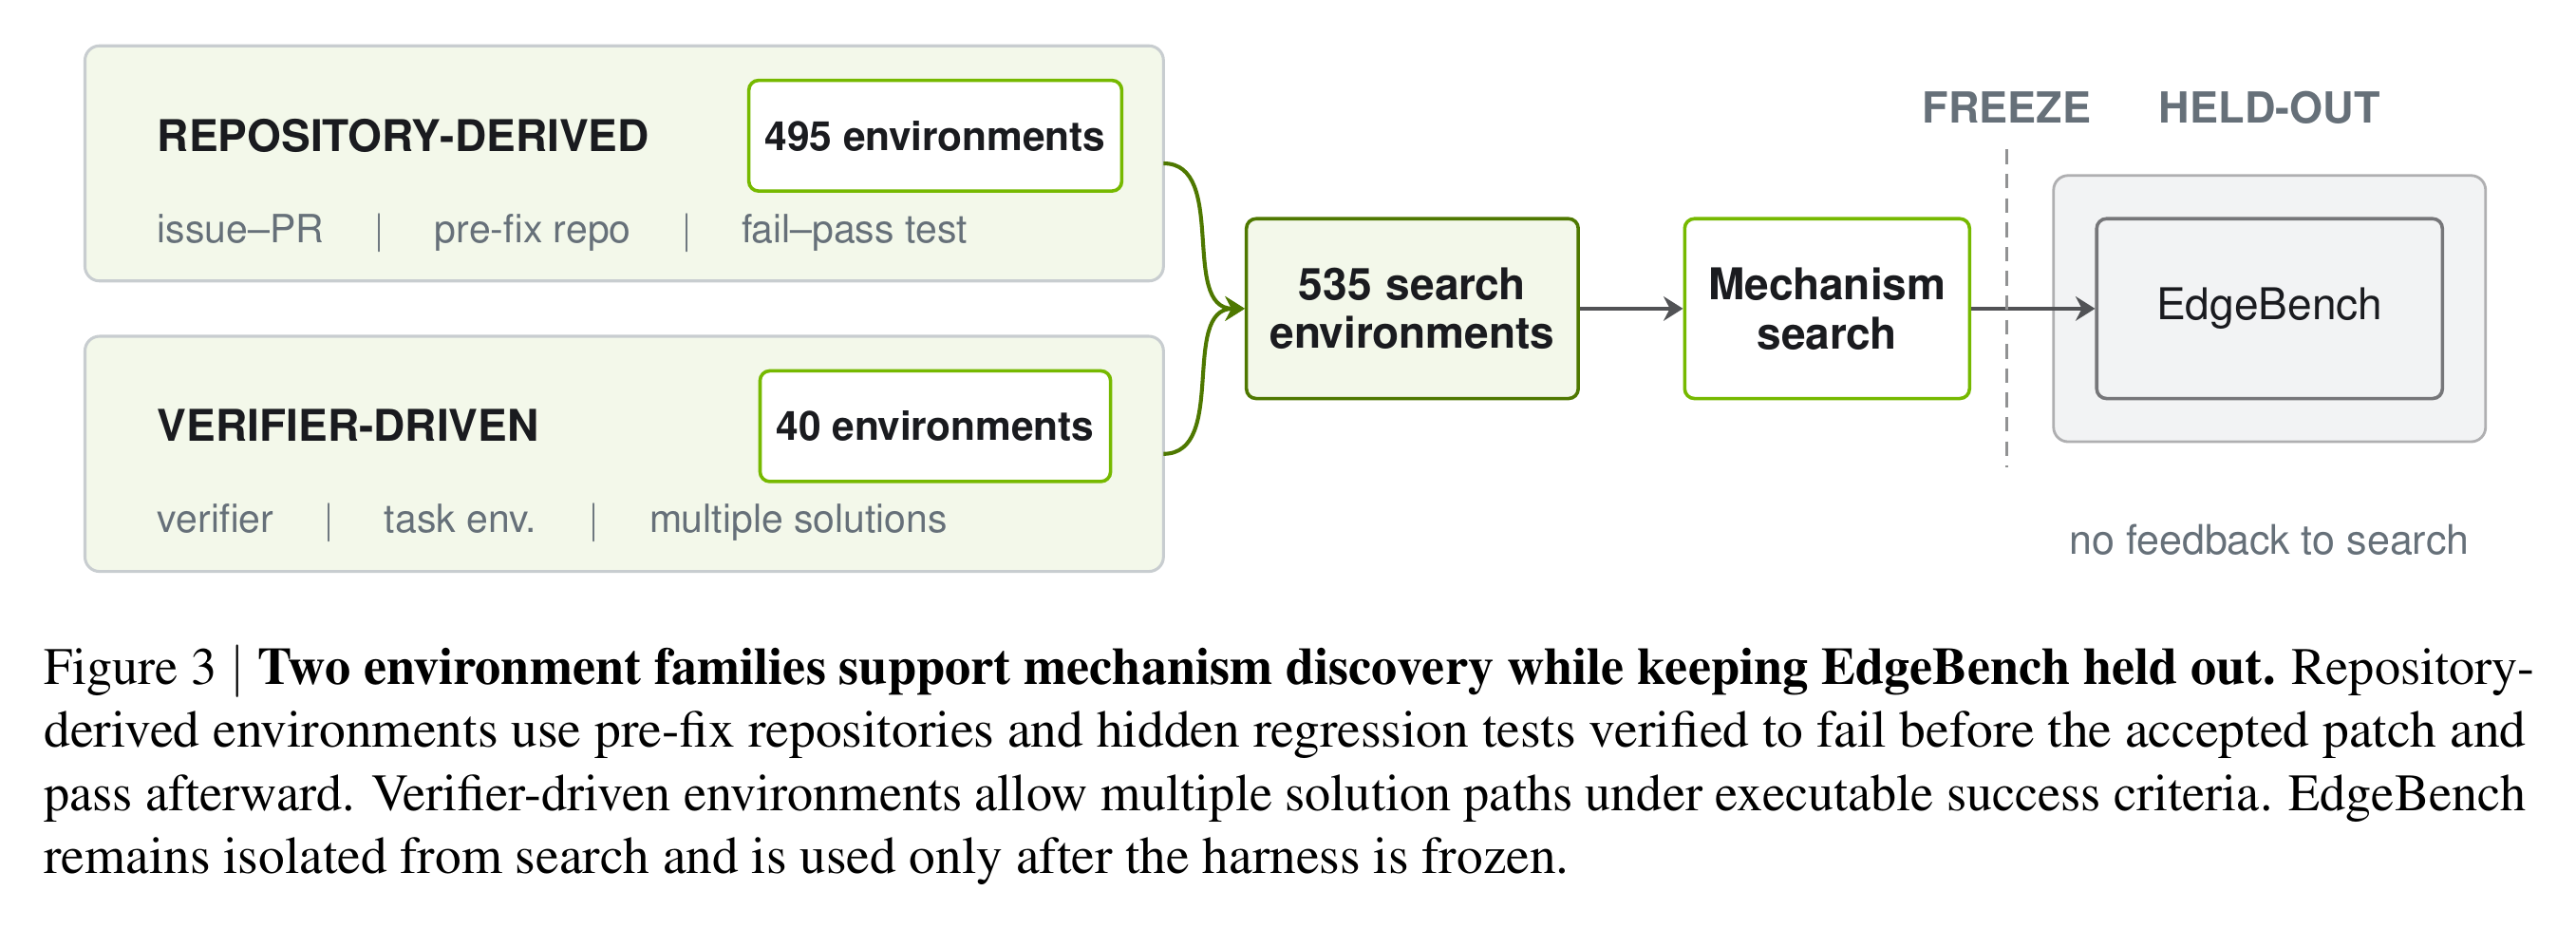
- 仓库派生环境(Repository-derived,495 个):基于真实的 GitHub Issue–PR 对构建,提供修复前的仓库状态与离线依赖。PR 补丁和回归测试对 Agent 隐藏,且仅保留“打补丁前测试失败、打补丁后测试通过”的环境。
- 验证器驱动环境(Verifier-driven,40 个):采用类似 Terminal-Bench-2 的可执行验证器接口,先编写定义成功标准的验证程序,再围绕它构造任务环境,允许 Agent 走不同的合法求解路径。
- EdgeBench 留出集(51 个公开任务):全程不参与搜索。其中 11 个任务用于冻结候选的单向准入检查(若未通过直接拒绝,不触发重调),剩余 40 个任务用于最终泛化评估。
3. 最小运行示例与仓库结构
3.1 最小运行与配置示例
NVlabs/SoL-Pi 是一个面向 @earendil-works/pi-coding-agent(0.84.2、1.0.4 或 1.3.0)的独立 TypeScript 扩展包。它不打包或修改上游 Pi 源码,且默认关闭所有功能(Explicit opt-in)。
安装 Pi 1.3.0 并挂载 SoL-Pi:
npm install --global @earendil-works/pi-coding-agent@1.3.0
pi install git:github.com/NVlabs/SoL-Pi --local --approve
在受信任项目的 .pi/sol-pi.json(或全局 ~/.pi/agent/sol-pi.json)中写入配置。若只开启纯本地、不发起额外模型调用且不中断当前运行的两项机制,配置如下:
{
  "version": 1,
  "actionFusion": true,
  "observationPack": true,
  "evidencePreservingReducer": false,
  "onlineContextCompact": false,
  "cacheWriteReadRatio": 12.5
}
若要开启全套四项机制并用官方预检脚本校验:
node scripts/check-sol-pi-config.mjs \
  --config .pi/sol-pi.json \
  --require-all-enabled
3.2 仓库目录与模块职责
仓库核心代码位于 src/sol-pi/ 下,结构紧凑,按职责拆分为顶层入口与四个独立扩展子目录:
src/sol-pi/
├── index.ts                     # 扩展主入口:监听 session_start,按配置注册四大机制
├── config.ts                    # 解析并严格校验 .pi/sol-pi.json 或 ~/.pi/agent/sol-pi.json
├── runtime-paths.ts             # 解析会话级存储路径 <sessionDir>/sol-pi/<sessionId>/ 或临时目录
├── shell-options.ts             # 从 Pi SettingsManager 读取受信任的 shellPath 与 commandPrefix
├── tui.ts                       # 终端闪电标识渲染(⚡ SoL-Pi)与 4 秒状态栏节省提示
└── extensions/
    ├── action-fusion/           # 机制一:edit/write 挂载 then_run、单文件队列与前后 SHA-256 校验
    ├── observation-pack/        # 机制二:>10KiB 文本内容寻址归档、前 2 次全量发送、句柄替换与 obs_recall
    ├── evidence-preserving-reducer/ # 机制三:≥4KiB 诊断日志归档、Luna 模型抽取与逐字节引文校验
    └── online-context-compact/  # 机制四:update_plan 进度边界、缓存负债盈亏核算与原生压缩续跑
4. 总体架构:不改一行上游代码的 Pi 扩展挂载链路
论文 Figure 4 展示了四项机制在 Agent–环境交互循环中的介入位置:
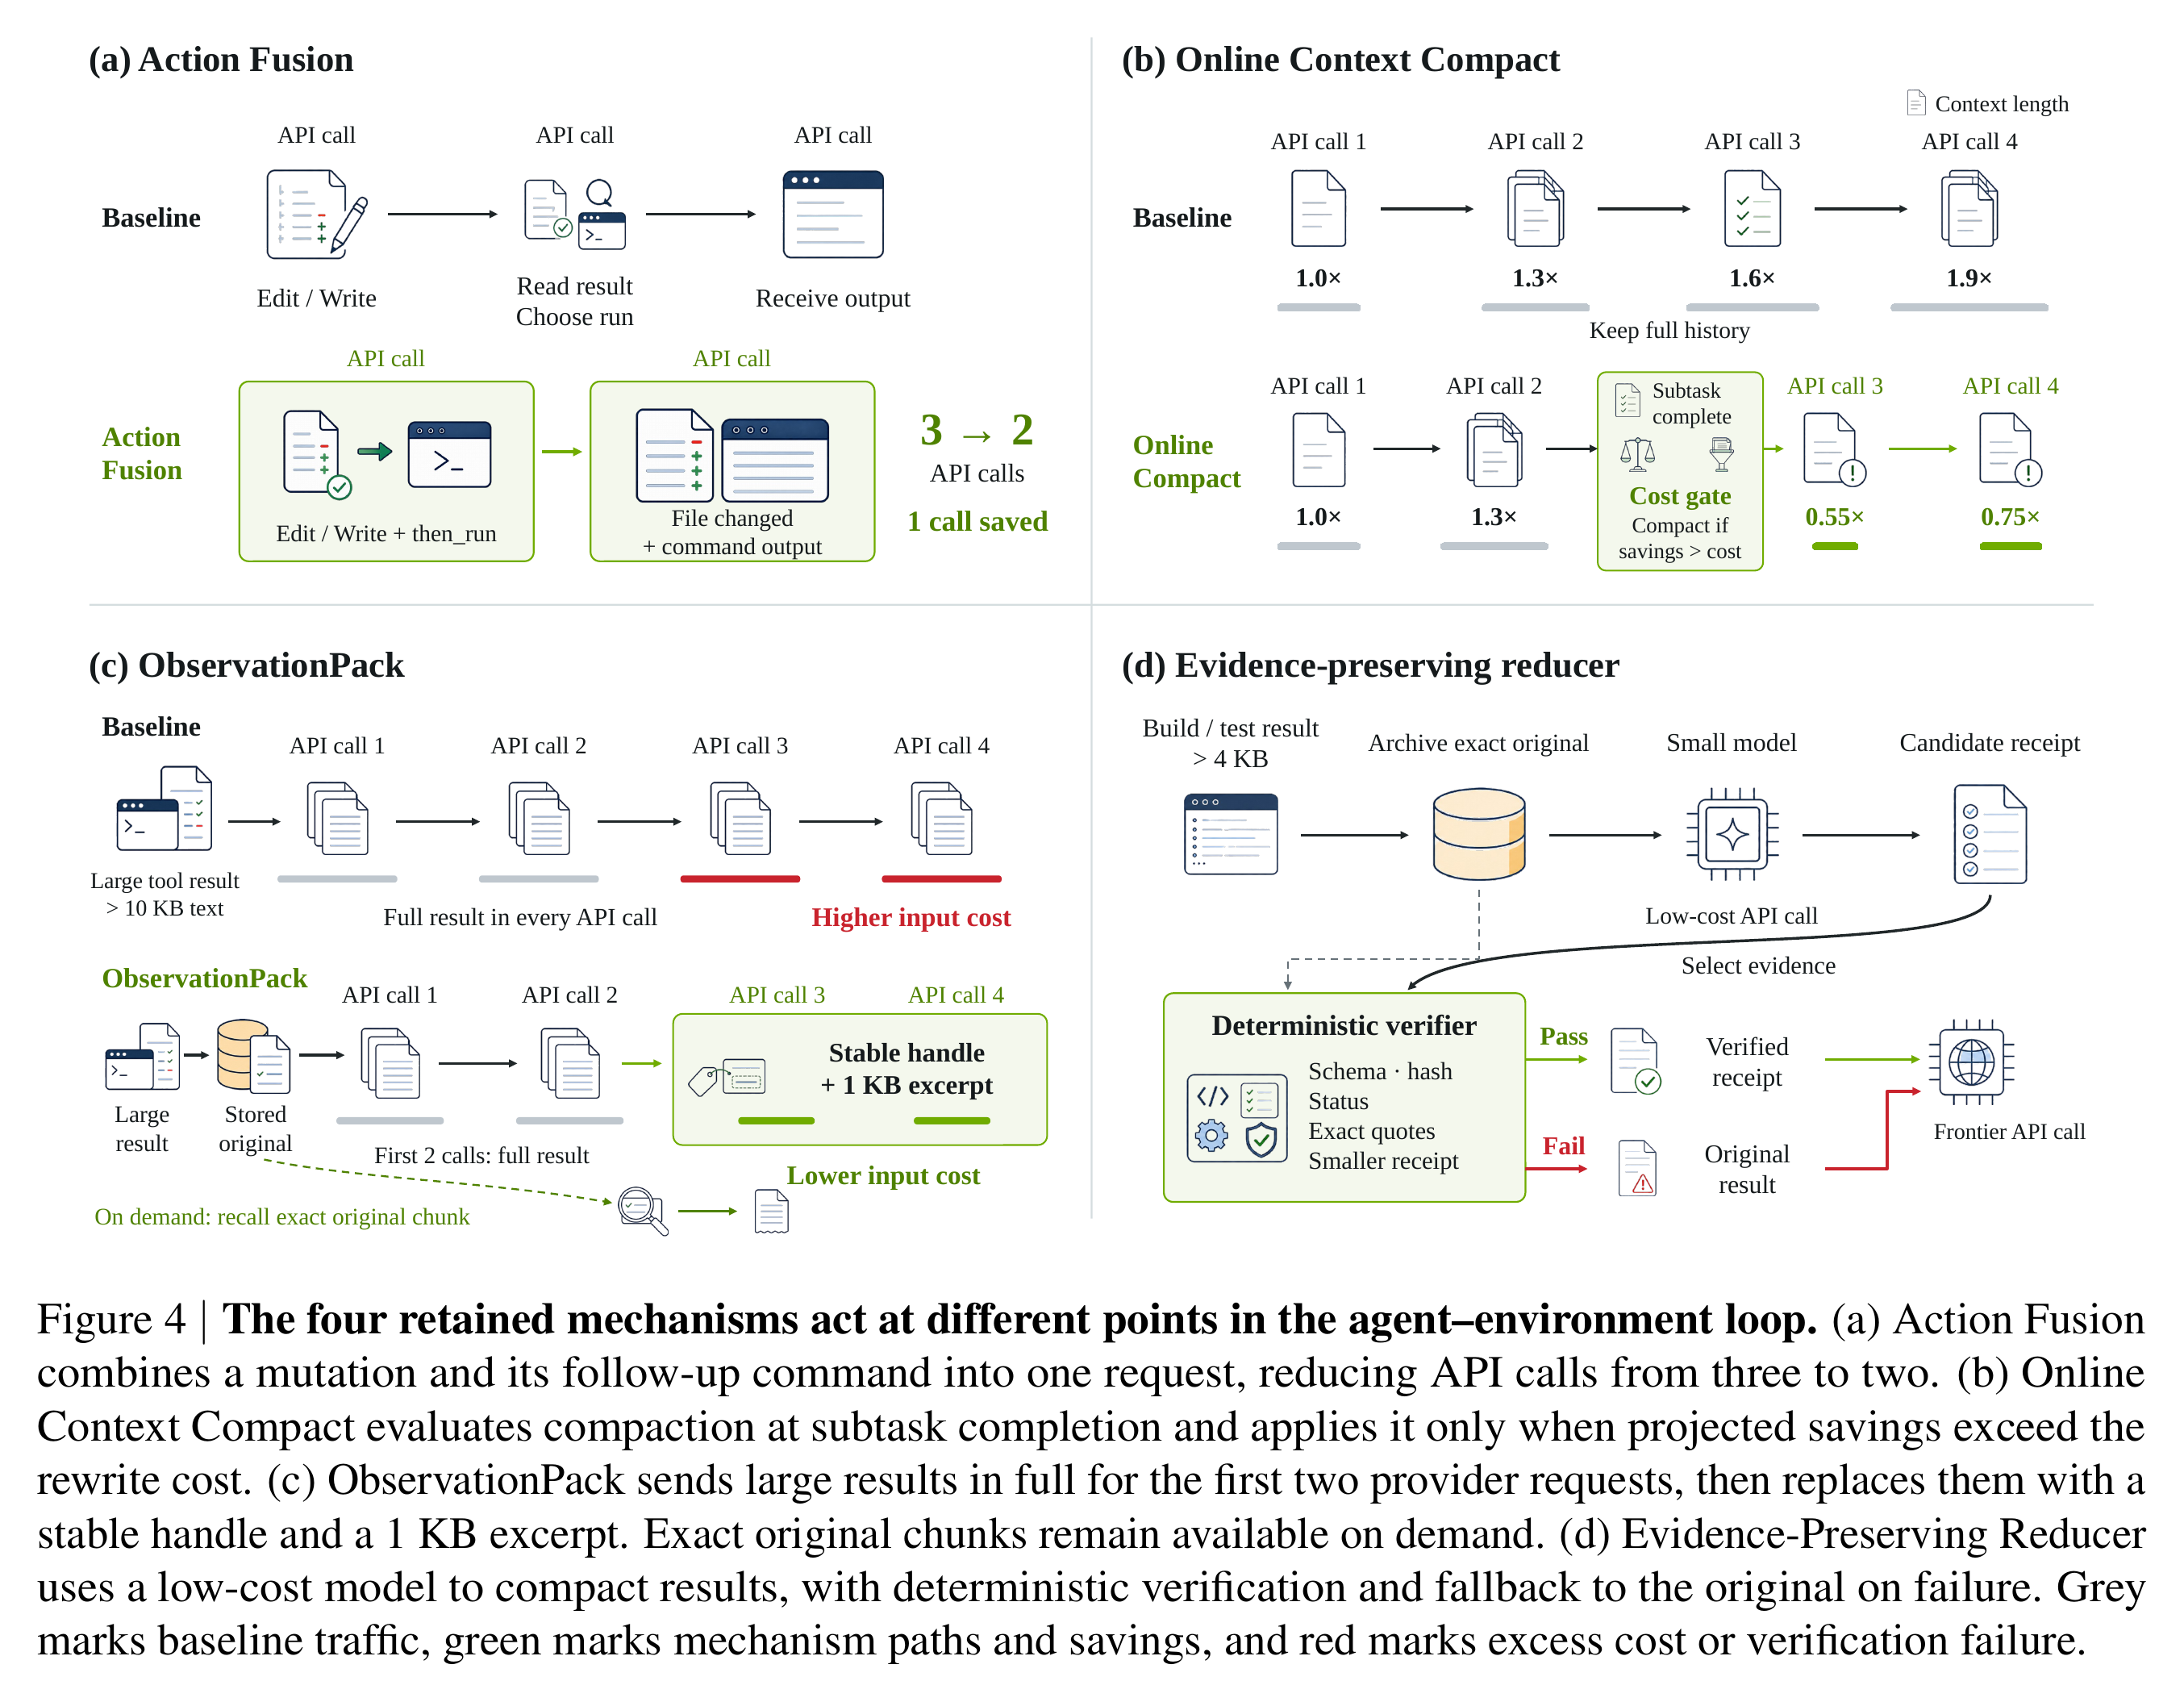
落到 NVlabs/SoL-Pi 的 TypeScript 源码中,这四项机制完全通过 @earendil-works/pi-coding-agent 公开的 ExtensionAPI 工具注册与生命周期事件钩子拼装而成。为了看清它们在单次会话中的执行先后顺序与数据交接,下面给出根据源码绘制的完整生命周期挂载图:
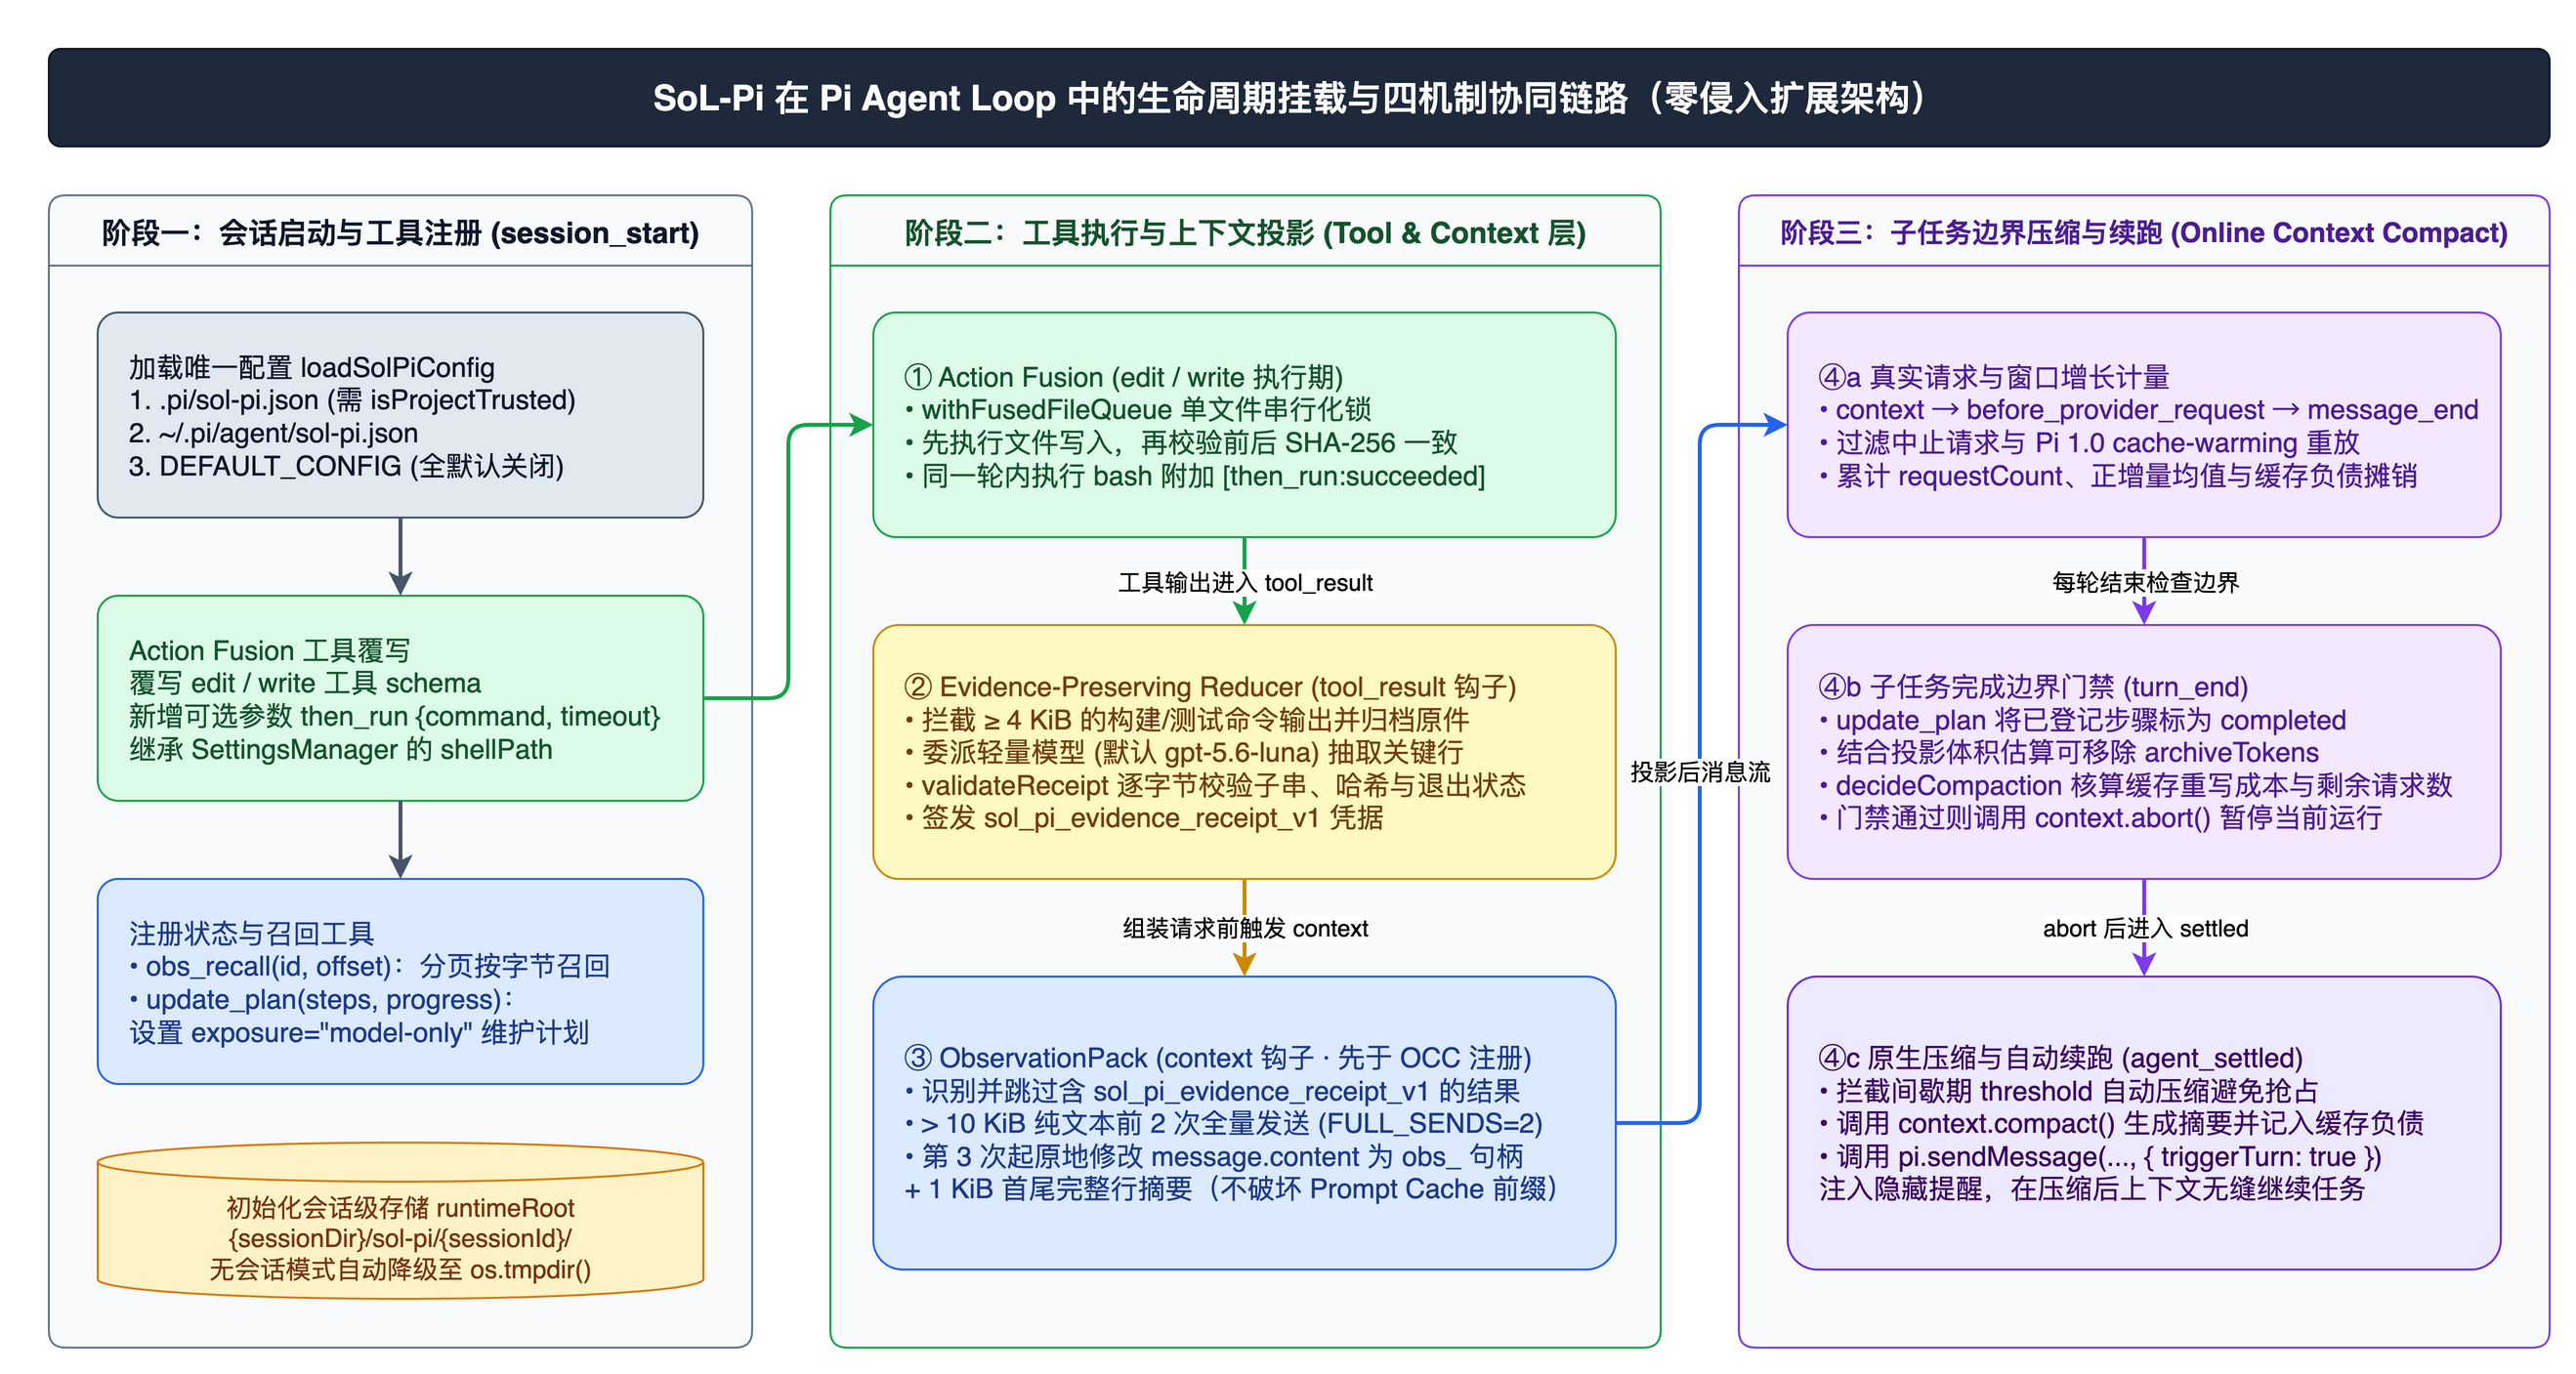
session_start 完成唯一配置加载与工具注册;阶段二在工具执行、tool_result 和 context 钩子中依次运行 Action Fusion、Evidence-Preserving Reducer 与 ObservationPack;阶段三在 before_provider_request、turn_end 和 agent_settled 中完成 Online Context Compact 的成本核算、运行中止、原生压缩与自动续跑。根据源码绘制,可编辑源文件。4.1 为什么注册顺序会影响运行结果?
查看主入口 src/sol-pi/index.ts 的 registerConfiguredFeatures 函数:
// 来自 src/sol-pi/index.ts (lines 14-28)
export function registerConfiguredFeatures(
	pi: ExtensionAPI,
	config: SolPiConfig,
	bashOptions?: BashToolOptions,
): void {
	if (config.actionFusion) createActionFusionExtension({ bashOptions })(pi);
	if (config.observationPack) registerObservationPack(pi);
	if (config.evidencePreservingReducer) {
		registerEvidencePreservingReducer(pi, {
			reducerModel: config.evidencePreservingReducerModel,
			reducerProvider: config.evidencePreservingReducerProvider,
		});
	}
	if (config.onlineContextCompact) registerOnlineContextCompact(pi, config.cacheWriteReadRatio);
}
这里的注册顺序包含两处关键的跨机制协同设计:
- Evidence-Preserving Reducer 在
tool_result阶段先于context运行:当测试或构建命令返回长日志时,tool_result事件最先触发。如果 EPR 成功将其压缩为带sol_pi_evidence_receipt_v1头部的验证凭据,后续context阶段运行的 ObservationPack 会识别该头部并主动跳过,避免把已经提炼好的报错证据再次替换成首尾截断占位符。 registerObservationPack必须在registerOnlineContextCompact之前注册:Pi 的context事件处理器按注册顺序依次执行。ObservationPack 先在context处理器里把超过 10 KiB 的旧输出原地替换为约 1 KiB 的占位符,紧接着 Online Context Compact 的context处理器记录observedMessages = [...event.messages]。这样 Online Context Compact 在计算“压缩能省多少 Token”时,使用的是 ObservationPack 替换后的真实投影体积,而不会把已经被占位符缩减掉的字节重复计入压缩收益。
4.2 严格的配置校验与项目信任门禁
createSolPiExtension 并不在扩展模块导入时立即读取配置,而是挂在 pi.on("session_start") 首次触发时初始化。src/sol-pi/config.ts 的 findConfigPath 规定:只有当 ctx.isProjectTrusted() 为 true 时,才读取项目目录下的 .pi/sol-pi.json;否则回退到全局 ~/.pi/agent/sol-pi.json,且两份文件直接覆盖、绝不合并。如果 JSON 中包含任何未知字段、version !== 1 或非法的 cacheWriteReadRatio,加载器会直接抛出异常终止初始化,防止因拼写错误静默退回默认行为。
5. 机制一:Action Fusion(修改与后续命令同轮融合)
5.1 论文动机与 27 轮演进历程
在基础 Pi 的轨迹分析中,研究团队统计了 edit / write 之后的紧邻动作分布(论文 Figure 8(d)):高达 85.1% 的下一步动作是紧接着调用 bash 去运行测试、编译或语法检查,只有 14.9% 是其他动作。Oracle 分析显示,如果把这类可预测的“修改文件 + 立即运行验证命令”合并到同一次工具调用中,在 100% 触发的理想情况下可减少 10.8% 的模型轮次(节省 149 轮)和 11.5% 的总 Token 消耗(节省 3.74M Tokens)。
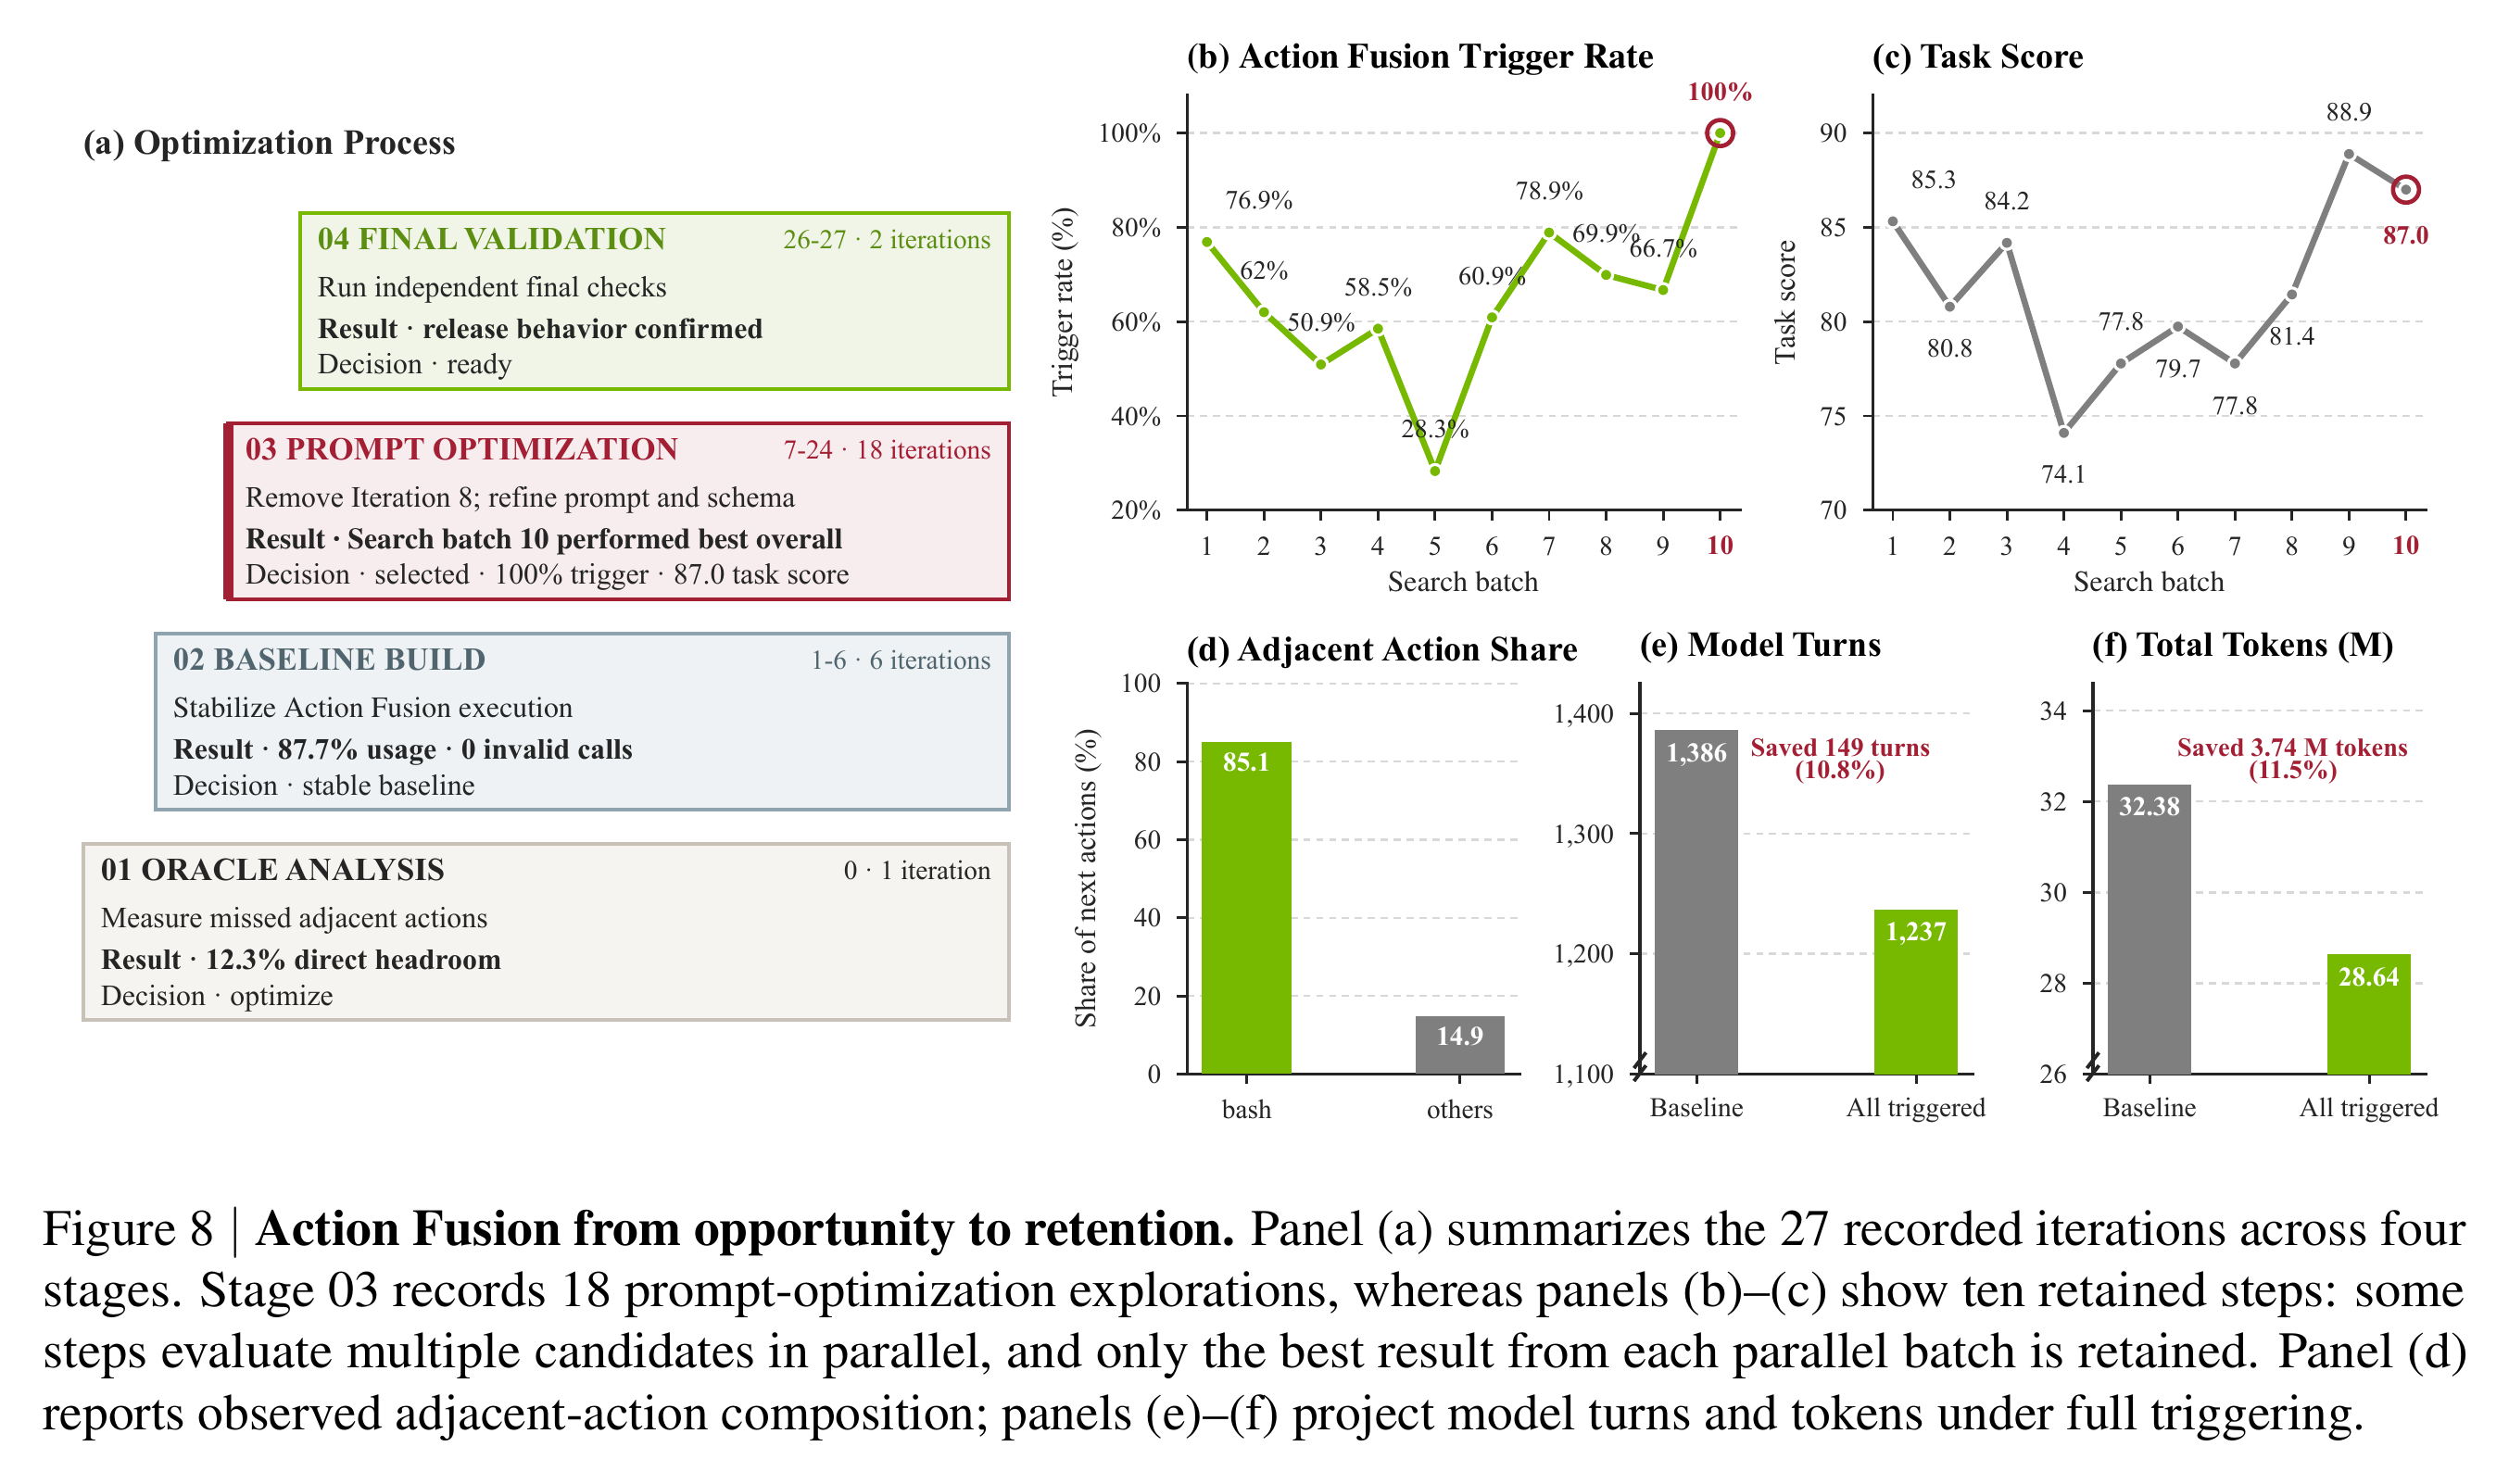
论文 3.5 节记录了一个很有价值的工程教训:在最初的基线构建阶段,研究 Agent 试图只靠修改提示词引导模型合并操作,但触发率极不稳定;随后研究 Agent 改用直接扩展 edit 和 write 的 Tool Schema,暴露显式的 then_run 参数,并把“触发率(trigger rate)”作为与任务得分并列的中间准入指标,经过 18 轮提示词与 Schema 迭代才将触发率稳定推到 100% 且零非法调用。
5.2 源码拆解:Schema 扩展、单文件串行队列与双哈希防篡改
在 src/sol-pi/extensions/action-fusion/index.ts 中,SoL-Pi 复用了 Pi 公开的 createEditToolDefinition 和 createWriteToolDefinition,通过 TypeBox 在原有参数属性上拼接 then_run:
// 来自 src/sol-pi/extensions/action-fusion/index.ts (lines 93-100)
const editParameters = Type.Object({
	...editTemplate.parameters.properties,
	then_run: createThenRunSchema(EDIT_THEN_RUN_DESCRIPTION),
});
const writeParameters = Type.Object({
	...writeTemplate.parameters.properties,
	then_run: createThenRunSchema(WRITE_THEN_RUN_DESCRIPTION),
});
当模型传入 then_run: { command, timeout } 时,src/sol-pi/extensions/action-fusion/then-run.ts 中的 runFusedMutation 负责执行。这里有两个容易在工程落地时踩坑的细节:
第一,单文件规范化队列(withFusedFileQueue)。 如果模型在同一轮并发发起多个针对同一文件的融合调用,必须保证“文件修改 + then_run 命令”作为一个原子槽位串行执行,不能让第二个修改插在第一个修改和它的测试命令之间。file-queue.ts 会先剥离 Unicode 空白符、处理 Pi 特有的 @ 前缀、file:// URL 以及 Windows Git Bash/MSYS/WSL 风格路径(如 /c/src/app.ts 转为 C:\src\app.ts),再向上递归解析 realpath 生成唯一队列键。
第二,命令执行前的事件循环让出与双重 SHA-256 校验(assertUnchangedBeforeCommand)。 即使有了进程内队列,外部进程或未加锁的其他插件仍可能在文件写入完成后、命令启动前改写目标文件。源码在启动 bash 前专门插入了一次 setImmediate 让出事件循环,并比对前后的文件 SHA-256:
// 来自 src/sol-pi/extensions/action-fusion/then-run.ts (lines 66-80)
export async function assertUnchangedBeforeCommand(
	path: string,
	yieldForInterference: () => Promise<void> = () => new Promise<void>((resolve) => setImmediate(resolve)),
): Promise<void> {
	try {
		const mutationHash = await fileSha256(path);
		await yieldForInterference();
		const commandHash = await fileSha256(path);
		if (mutationHash !== commandHash) {
			throw new Error("target content changed after the fused mutation");
		}
	} catch (error) {
		throw new Error(`${THEN_RUN_SKIPPED} ${errorText(error)}; the command was not run.`);
	}
}
一旦发现文件在写入后被外部篡改,或者前置的 edit / write 本身返回错误(isErrorResult(mutationResult)),runFusedMutation 会立即跳过命令并附加 [then_run:skipped]。如果命令执行失败,则返回 [then_run:failed] 及命令输出,同时保留已成功落盘的文件修改与 diff 详情(绝不自动回滚文件),让模型在下一轮直接根据报错修复,而不是重新写一遍文件。
6. 机制二:ObservationPack(大体积输出延迟替换与按字节分页召回)
6.1 为什么不立刻压缩,而是等待 2 次请求?
长周期任务中,一次 read、grep 或 bash 可能返回几十 KB 的文本。如果刚拿到结果就把它截断,模型往往还要立刻调工具重读;但如果一直原样保留在历史消息中,后续几十轮对话每发一次请求都要把这段几十 KB 的旧文本重传一遍。
ObservationPack 采取了折中策略(src/sol-pi/extensions/observation-pack/observation.ts):
- 阈值门禁:仅处理非报错(
!message.isError)、纯文本、且字节数严格大于THRESHOLD_BYTES = 10 * 1024(10 KiB)的工具结果。 - 前 2 次全量发送(
FULL_SENDS = 2):工具结果产生后的前两次 Provider 请求保留完整原文,确保模型在紧邻的决策轮次能够直接读取全部细节。 - 第 3 次请求起替换为稳定占位符:从第 3 次请求开始,将消息内容替换为包含稳定句柄
obs_<24位hex>、原始字节数/行数/估算 Token 数,以及最多PLACEHOLDER_EXCERPT_BYTES = 1024字节(前 512 字节完整行 + 后 512 字节完整行)的摘要。
6.2 源码拆解:为什么必须原地修改 message.content?
在 src/sol-pi/extensions/observation-pack/index.ts 的 pi.on("context") 处理器中,有一段非常关键的实现细节:
// 来自 src/sol-pi/extensions/observation-pack/index.ts (lines 183-208)
const placeholder = placeholderFor(observation);
const placeholderTokens = estimateTokens(placeholder);
const removedTokens = Math.max(0, observation.tokens - placeholderTokens);
// ... 记录 ledger 并显示节省通知 ...
// Same message object, new content: see the note at the top of this file.
message.content = [{ type: "text", text: placeholder }];
sentCounts.set(sendCountKey, previousSends + 1);
注意第 207 行:处理器直接原地修改了传入的 message.content 属性,并且函数不返回任何新数组(return undefined)。文件头部的注释解释了原因:
- Pi 在调用
context钩子前,已经对会话历史做了一次结构化克隆(structured clone),因此原地修改event.messages[i].content不会污染SessionManager持久化的原始历史;即使后续发生原生压缩或会话恢复,原始记录依然完整。 - 从 Pi 0.87 开始,如果
context处理器返回一个新的消息对象数组,Pi 会把对话中途插入的所有system消息(如动态提示词片段、工具声明增量)合并到最开头的单条system消息中——这会直接破坏大模型服务商的 Prompt Cache 前缀匹配,导致后续每次请求都重新全量写缓存。原地修改克隆对象的content属性既完成了内容替换,又保持了消息对象引用与system消息位置不变。
6.3 防符号链接归档与 UTF-8 字节边界安全召回
当模型需要查看被省略的中间内容时,可以调用注册的 obs_recall(id, offset) 工具:
- 内容寻址与防软链攻击:
ensureStored使用O_WRONLY | O_CREAT | O_EXCL | O_NOFOLLOW(权限0o600)将原文写入<runtimeRoot>/observation-pack/objects/obs_<24hex>.txt,拒绝任何符号链接目录或文件;若文件已存在(EEXIST),则以O_RDONLY | O_NOFOLLOW打开并逐字节比对文件大小与 SHA-256 哈希,不匹配则直接报错。 - UTF-8 多字节字符防截断:
readRecallChunk按字节偏移量offset读取最多16 KiB - 512 B或398行数据。由于按字节切片可能正好切在多字节 UTF-8 字符(如中文或特殊符号)的中间字节(0b10xxxxxx),源码专门通过trimUtf8End回退到合法字符边界,并返回精确的nextOffset供下次按偏移量续读:
// 来自 src/sol-pi/extensions/observation-pack/observation.ts (lines 207-211)
function trimUtf8End(buffer: Buffer, limit: number): number {
	let end = limit;
	while (end > 0 && end < buffer.length && ((buffer[end] ?? 0) & 0xc0) === 0x80) end -= 1;
	return end;
}
7. 机制三:Evidence-Preserving Reducer(带逐字节引文校验的日志委派压缩)
7.1 为什么普通小模型摘要不可信?
当 pytest、cargo test、cmake --build 或 lake build 输出数万字符的编译/测试日志时,真正决定下一步修复动作的往往只有几行报错栈或类型不匹配提示。如果让轻量模型(论文与源码默认配置为 openai-codex/gpt-5.6-luna)先读一遍日志并生成摘要,最大的风险是小模型产生幻觉:编造不存在的报错行、改写错误码,或者把真正的 fatal 错误漏掉、只留下一句“构建失败”。
Evidence-Preserving Reducer(EPR)的核心设计是:只允许小模型做“原文片段摘抄”,绝不允许做自由文本改写,再用确定性代码逐字节核对每一条摘抄。
7.2 源码拆解:准入过滤与四重确定性核验(validateReceipt)
在 src/sol-pi/extensions/evidence-preserving-reducer/index.ts 与 config.ts 中,一个工具结果要进入 EPR 必须先通过严格的准入条件:
- 非嵌套调用:无
parentToolCallId(排除 Pi 1.x codemode 脚本内部的子调用)。 - 工具与命令白名单:工具为
bash或带then_run的edit/write,且命令匹配DIAGNOSTIC_COMMAND正则(仅限lake build、lean、coq、cargo、zig build、pytest、unittest、py_compile、ctest、cmake --build、ninja、make、npm/pnpm/yarn test、go test、bazel test;普通的cat、grep、find一律绕过)。 - 体积与长度窗口:UTF-8 字节数 (4 KiB)且字符数 。若 Pi 因输出过大将其截断并写入了临时目录的
pi-bash-*.log,candidate.ts的exactBodyFromInline会在校验非符号链接后直接读取完整的未截断日志文件。 - 退出状态一致性与密钥扫描:命令退出码(
exitFailed)必须与event.isError一致;若正文命中LIKELY_SECRET正则(含api_key、authorization、bearer、access_token、secret赋值),立即放弃远程委派并回退。
通过准入后,EPR 将原始日志按 SHA-256 归档到本地 objects/<hash前2位>/<hash>.txt,并将原文包在 <untrusted_log>...</untrusted_log> 标签内发给 Reducer 模型,要求其只返回符合 sol-pi-evidence-receipt/1 Schema 的 JSON。拿到模型输出后,receipt.ts 中的 validateReceipt 执行确定性校验:
// 来自 src/sol-pi/extensions/evidence-preserving-reducer/receipt.ts (lines 110-143)
	for (const item of evidenceValue) {
		const kind = recordValue(item, "kind");
		const quote = recordValue(item, "quote");
		if (
			typeof kind !== "string" ||
			!allowedKinds.has(kind as EvidenceKind) ||
			typeof quote !== "string" ||
			quote.length < 1 ||
			quote.length > MAX_QUOTE_CHARS ||
			!body.includes(quote)
		) {
			return { ok: false, reason: "unverifiable-quote" };
		}
        // ... 去重并计算在原文中的精确行号 lineNumberOf(body, quote) 与 quoteSha256 ...
	}
	if (
		isError &&
		FAILURE_SIGNAL.test(body) &&
		!evidence.some((item) => item.kind === "fatal" || item.kind === "failure")
	) {
		return { ok: false, reason: "missing-failure-evidence" };
	}
这套校验器同时卡住了四道关口:
- Schema 与源哈希核验:
parsed.schema === "sol-pi-evidence-receipt/1"、parsed.source_sha256 === archive.hash、parsed.status === (isError ? "failure" : "success"),且证据条数不超过MAX_EVIDENCE_ITEMS = 12。 - 逐字节子串存在性核验(
!body.includes(quote)):每条引文长度必须满足 字符,且必须能在归档原文中逐字节精确匹配。只要小模型改了一个标点或空格,body.includes(quote)就会返回false,触发unverifiable-quote回退。 - 失败信号防漏检(
missing-failure-evidence):当命令执行失败(isError === true)且原始日志包含error|failed|failure|fatal|exception|panic|timeout|unsolved|type mismatch|assert等关键词时,提取出的证据列表中必须至少包含一条fatal或failure类型的引文,防止小模型只摘抄无关的summary或warning把真正的错误掩盖掉。 - 体积净收益核验:最终格式化出的凭据字节数必须严格小于原始日志(
receiptBytes < archive.bytes),否则以receipt-not-smaller回退。
校验通过后生成的凭据自带归档文件路径 source_artifact 与每条引文的精确行号 line,并在末尾声明 authority=Sol retains diagnosis, repair, rerun, and pass/fail adjudication,明确告知主模型:诊断与修复决策权仍在主模型手中,需要上下文时可直接按行号读取本地归档文件。
8. 机制四:Online Context Compact(子任务边界的缓存经济学与自动续跑)
8.1 为什么上下文压缩不能只看窗口快满了没有?
大多数 Agent 框架只在上下文逼近模型最大窗口(如剩余不到 16K Tokens)时才被动触发摘要压缩。但在长周期任务中,每完成一个独立子任务(例如“定位完 bug 原因”、“修完第一个模块并跑通单测”),此前十几轮的排查过程就已经不再需要逐字保留。
然而,提早压缩有一个现实的财务代价:破坏 Prompt Cache 前缀。一旦把前半段历史替换成一段新摘要,下一轮请求就不能命中原有的低价缓存读取(Cache Read),而必须把压缩后的整段上下文重新写入缓存(Cache Write)。在主流大模型定价中,Cache Write 单价通常是 Cache Read 的数倍(SoL-Pi 默认配置 cacheWriteReadRatio = 12.5)。如果任务再过两轮就结束了,提早压缩省下的读取费用还不够弥补重写缓存的开销。
8.2 源码拆解:剩余请求视野估算与缓存负债盈亏方程
Online Context Compact(src/sol-pi/extensions/online-context-compact/economics.ts)向模型注册了一个仅对模型暴露(exposure: "model-only")的工具 update_plan(steps, progress)。只有当一个此前已登记为未完成(pending 或 in_progress)的步骤在本轮转变为 completed 时,才会在 turn_end 触发压缩经济学评估(首次直接作为 completed 传入的步骤只记作历史,防止模型重排计划 ID 时反复误触发)。
设已完成步骤的各阶段请求数样本均值为 (样本下界为 ,默认标准差系数 时 ),剩余未完成步骤数为 ,当前上下文体积为 ,模型最大窗口为 ,观察到的单次请求平均正增长 Token 数为 。代码首先估算无界预期剩余请求数 与窗口填满前的请求上限 :
接着计算本次压缩的单次净节省 Token 数 与新增缓存重写负债(Cache Debt) 。设当前写入体积为 ,根据投影层估算的可移除旧前缀体积为 ,替换摘要预估体积为 ,缓存读写价格比为 (默认值),则增量缓存成本系数为 :
由此得到收回本次缓存重写成本所需的盈亏平衡请求数(Breakeven Requests) ,以及加上历史未还清负债 后的联合盈亏平衡请求数 :
对应 economics.ts 中的核心判定逻辑:
// 来自 src/sol-pi/extensions/online-context-compact/economics.ts (lines 158-204)
	const savingTokens = input.archiveTokens - input.memoTokens;
	const postCompactionTokens = Math.max(0, input.writeTokens - savingTokens);
	const incrementalCacheCostRatio =
		input.cacheWriteReadRatio === null ? null : Math.max(0, input.cacheWriteReadRatio - 1);
	const newDebtTokens = postCompactionTokens * (incrementalCacheCostRatio ?? 0);
	const breakevenRequests =
		savingTokens > 0 && incrementalCacheCostRatio !== null ? newDebtTokens / savingTokens : null;
	const combinedRepaymentTokens = input.cacheDebtRepaymentTokens + savingTokens;
	const combinedBreakevenRequests =
		savingTokens > 0 && incrementalCacheCostRatio !== null && combinedRepaymentTokens > 0
			? (input.carriedDebtTokens + newDebtTokens) / combinedRepaymentTokens
: null;为了防止频繁压缩导致缓存负债滚雪球,decideCompaction 区分了首次压缩与后续压缩:
- 首次压缩(
priorCompactionCount === 0):允许将预期剩余请求视野放宽firstCompactionRequestScale = 2倍(但不超过 ),只要 即通过经济门禁。 - 后续压缩(
priorCompactionCount > 0):每经过一次真实请求,历史负债 会按上次省下的cacheDebtRepaymentTokens逐步摊销(state.ts第 155 行)。再次触发压缩时,必须同时满足三项硬条件:- 距离上次压缩至少已发出
minimumRequestsSinceCompaction = 2次真实请求(冷却期); - 本次盈亏平衡点乘以
subsequentCompactionMargin = 1.5倍安全边际后仍不超过剩余请求数(); - 历史未还清负债与本次新增负债合并后的联合盈亏平衡点不超过剩余请求数()。
- 距离上次压缩至少已发出
- 窗口保护兜底(
windowProtection):一旦 (默认预留16,384Tokens),无论经济门禁与冷却期如何,只要 即刻触发压缩。
8.3 停止—压缩—自动续跑的状态机编排
在 Pi 的运行时架构中,ExtensionContext.compact() 会先中止当前活跃的 Agent 循环再生成摘要。如果直接在 turn_end 同步调用 compact(),会导致生命周期状态冲突。因此 extension.ts 实现了一个三步状态机:
turn_end选中并中止:当decideCompaction返回compact: true时,将其存入selected变量,并调用context.abort()主动停止当前轮次;同时在session_before_compact钩子中拦截reason === "threshold"的系统自动压缩,防止 Pi 在过渡期抢先消费掉这次压缩机会。agent_settled执行原生压缩:当整个运行排空所有队列进入空闲(context.isIdle())并触发agent_settled时,调用context.compact({ customInstructions: BOUNDARY_COMPACTION_INSTRUCTIONS, ... })。- 隐藏消息触发新轮次自动续跑(
continueParentTask):压缩完成后,通过pi.sendMessage({ customType: "sol-pi-online-context-compact", content: POST_COMPACTION_PLAN_REMINDER, display: false }, { triggerTurn: true })发送一条对终端用户隐藏的提醒消息,自动拉起新一轮对话继续执行未完成的计划步骤,外部调用方(包括 CLI Print/JSON 模式)无需手动重发Continue working。
9. 扩展生态:SoL-Pi Visual(3D 场景重建)与 SoL-Pi Skill(跨宿主后台委派)
除了四大核心机制,NVlabs/SoL-Pi 仓库在 examples/ 下还提供了两个可以直接运行的工程化扩展,分别展示了这套思路在多模态视觉任务与跨 Agent 宿主协同上的落地方式。
9.1 SoL-Pi Visual:Blender 3D 场景重建降本 37%
在 examples/solpi-visual/ 中,研究团队将 SoL-Pi 应用于 VSI-Bench(包含 ARKitScenes、ScanNet++ 和 ScanNet 共 15 个室内场景)的 Blender 3D 场景重建任务。该扩展在四大基础机制之上增加了三项视觉专属策略(通过 .pi/solpi-visual.json 开启):
localEditScope(局部编辑范围约束):首次全场景观察后,要求每轮编辑只针对一个最显著的视觉差异或耦合原因修改现有对象参数,禁止推倒重来重写无关组件。magnify(确定性局部裁剪放大工具):注册magnify工具(底层通过execFile("python3", ["magnify.py", ...])参数数组调用 Pillow,杜绝文件名 Shell 注入)。当全图看不清局部几何或材质差异时,按像素坐标[left, top, right, bottom]对已有渲染图和参考图同步裁剪并做双三次插值放大(默认放大 2 倍,最大边长限制 1024px,PNG 体积上限 3.75 MB),返回裁剪图及坐标/SHA-256 凭据,避免为了看清局部而反复触发高成本全场景重新渲染。awaitRender(前台等待渲染策略):启动渲染或构建命令且手头没有独立并行工作时,保持前台阻塞等待结果,禁止将命令放到后台再花多个模型轮次轮询状态。
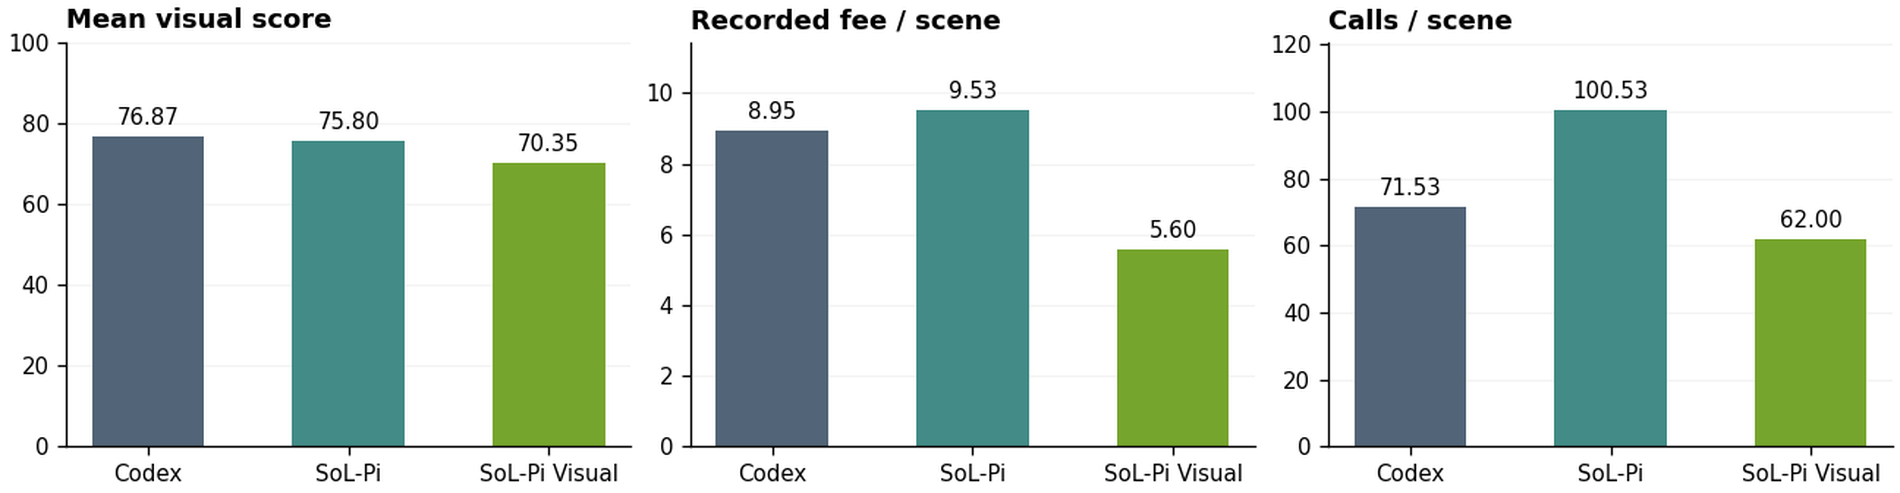
examples/solpi-visual/assets/results.png。从图 6 的实测数据可以看到:
- 单场景费用:从 Codex 的 8.95 美元(纯文本 SoL-Pi 为 9.53 美元)降至 SoL-Pi Visual 的 5.60 美元,单场景成本降低 37.4%;
- 单场景模型调用次数:从 Codex 的 71.53 次(纯文本 SoL-Pi 为 100.53 次)降至 SoL-Pi Visual 的 62.00 次,调用次数减少 13.3%;
- 视觉重建质量:平均视觉评分保持在 70.35(Codex 为 76.87,SoL-Pi 为 75.80)。这说明在纯代码/文本轨迹上搜索出的四项机制直接搬到重度渲染任务上时,单场景调用次数反而会上升(从 71.53 升至 100.53),必须配合视觉域的
localEditScope、magnify和awaitRender才能把轮次和成本同时压下来。
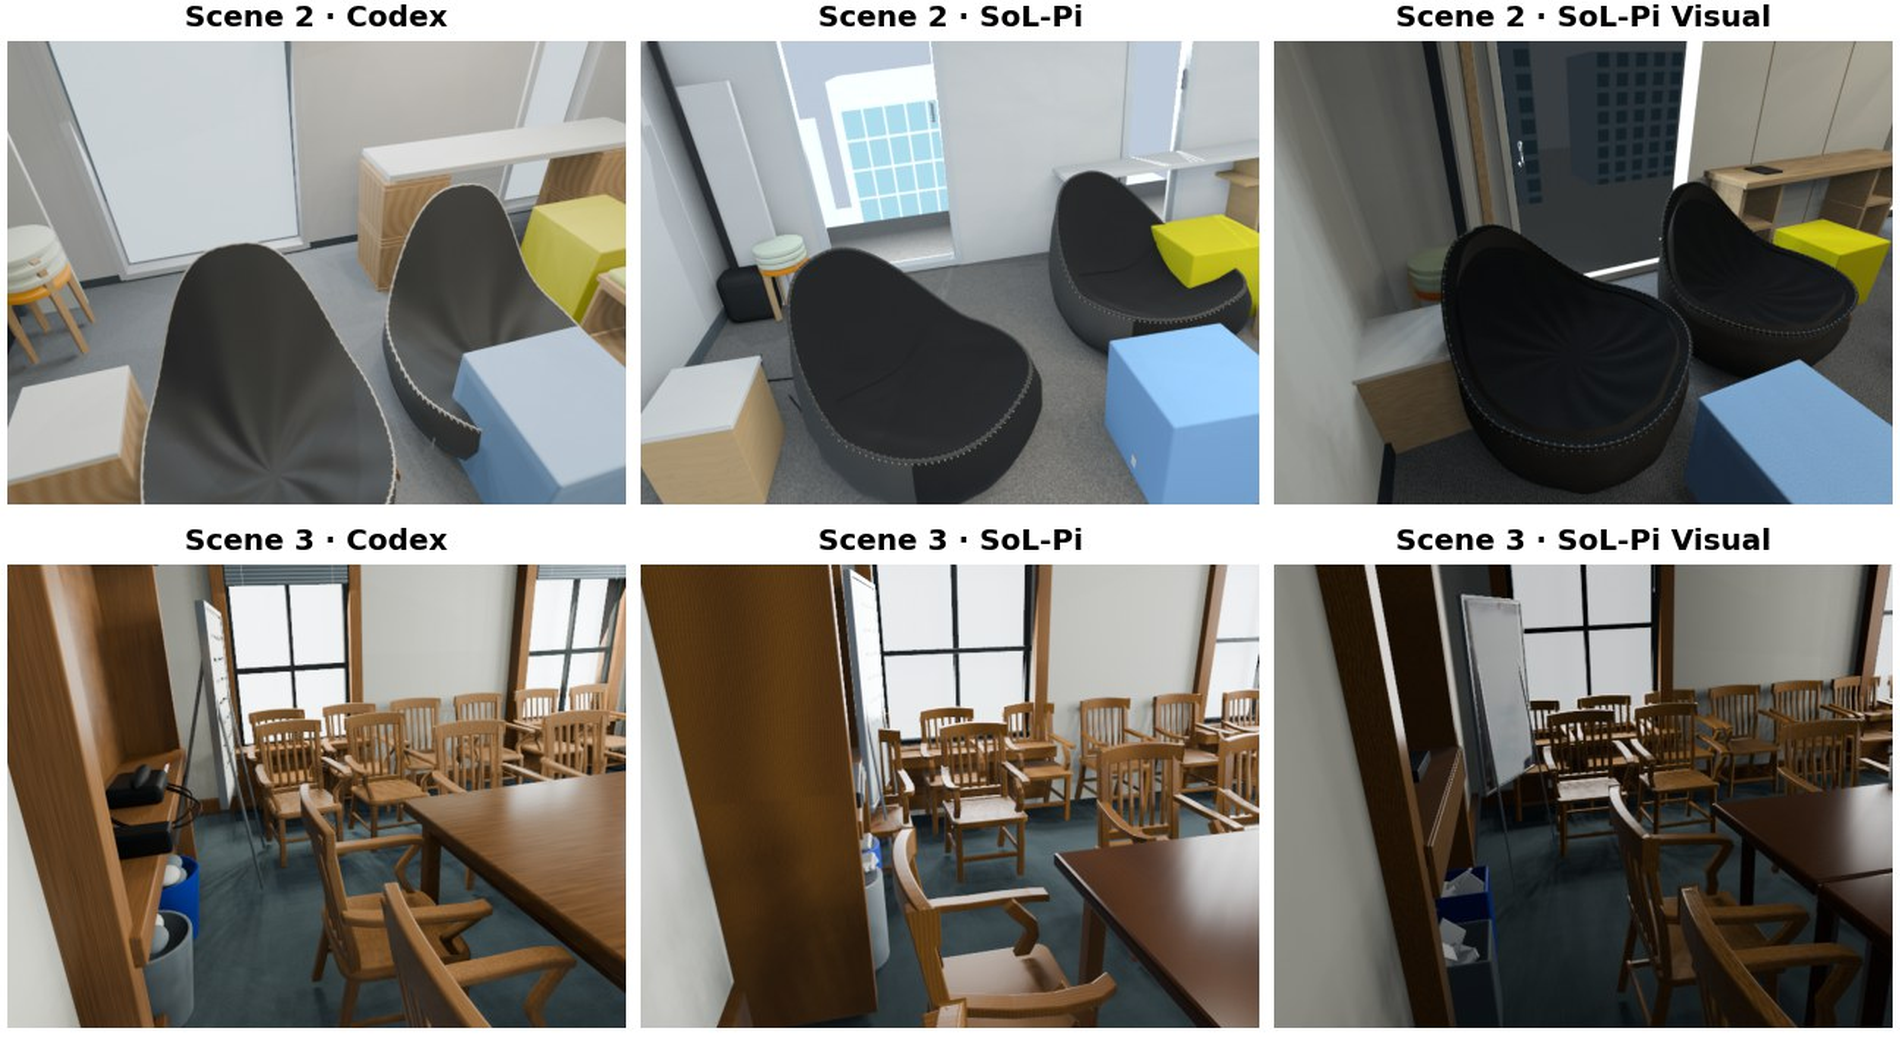
examples/solpi-visual/assets/scene-comparison.jpg。9.2 SoL-Pi Skill:把 Claude Code / Codex 任务零轮次转交后台 SoL-Pi
examples/sol-pi-skill/ 则解决了另一个实用问题:如果开发者日常使用的是 Claude Code 或 Codex CLI,如何不切换主工具就直接享用 SoL-Pi 的省 Token 能力?
- Hook 零模型开销拦截:安装插件后,当用户输入
/sol-pi <task>(Claude Code)或$sol-pi <task>(Codex)时,同步触发的sol-pi-run hook submit会直接在本地后台拉起独立的sol-pi-run start --with-session进程,并立即阻断当前宿主提示词,宿主模型甚至不需要为此消耗一次 API 请求。 - 上下文前缀压缩导出(
sol-pi-context):脚本自动读取当前 Claude Code 或 Codex 自上次压缩以来的会话记录,保留用户与助手正文、单行工具调用及首尾裁剪后的工具结果(剥离<thinking>、系统提示词与已注入的 skill 正文),拼接在任务指令前传给后台 SoL-Pi。 - 异步唤醒回传(
sol-pi-run hook notify):后台任务完成后,Claude Code 下通过asyncRewake(退出码 2)立即唤醒空闲会话汇报结果、花费与工作区文件变更;同时sol-pi-run会在配置中屏蔽sol-pi自身 skill 并检测环境变量,防止后台子进程递归委派给自己。
10. 错误处理、安全护栏与本地测试验证
10.1 四大机制的确定性护栏与 Fail-Open 汇总
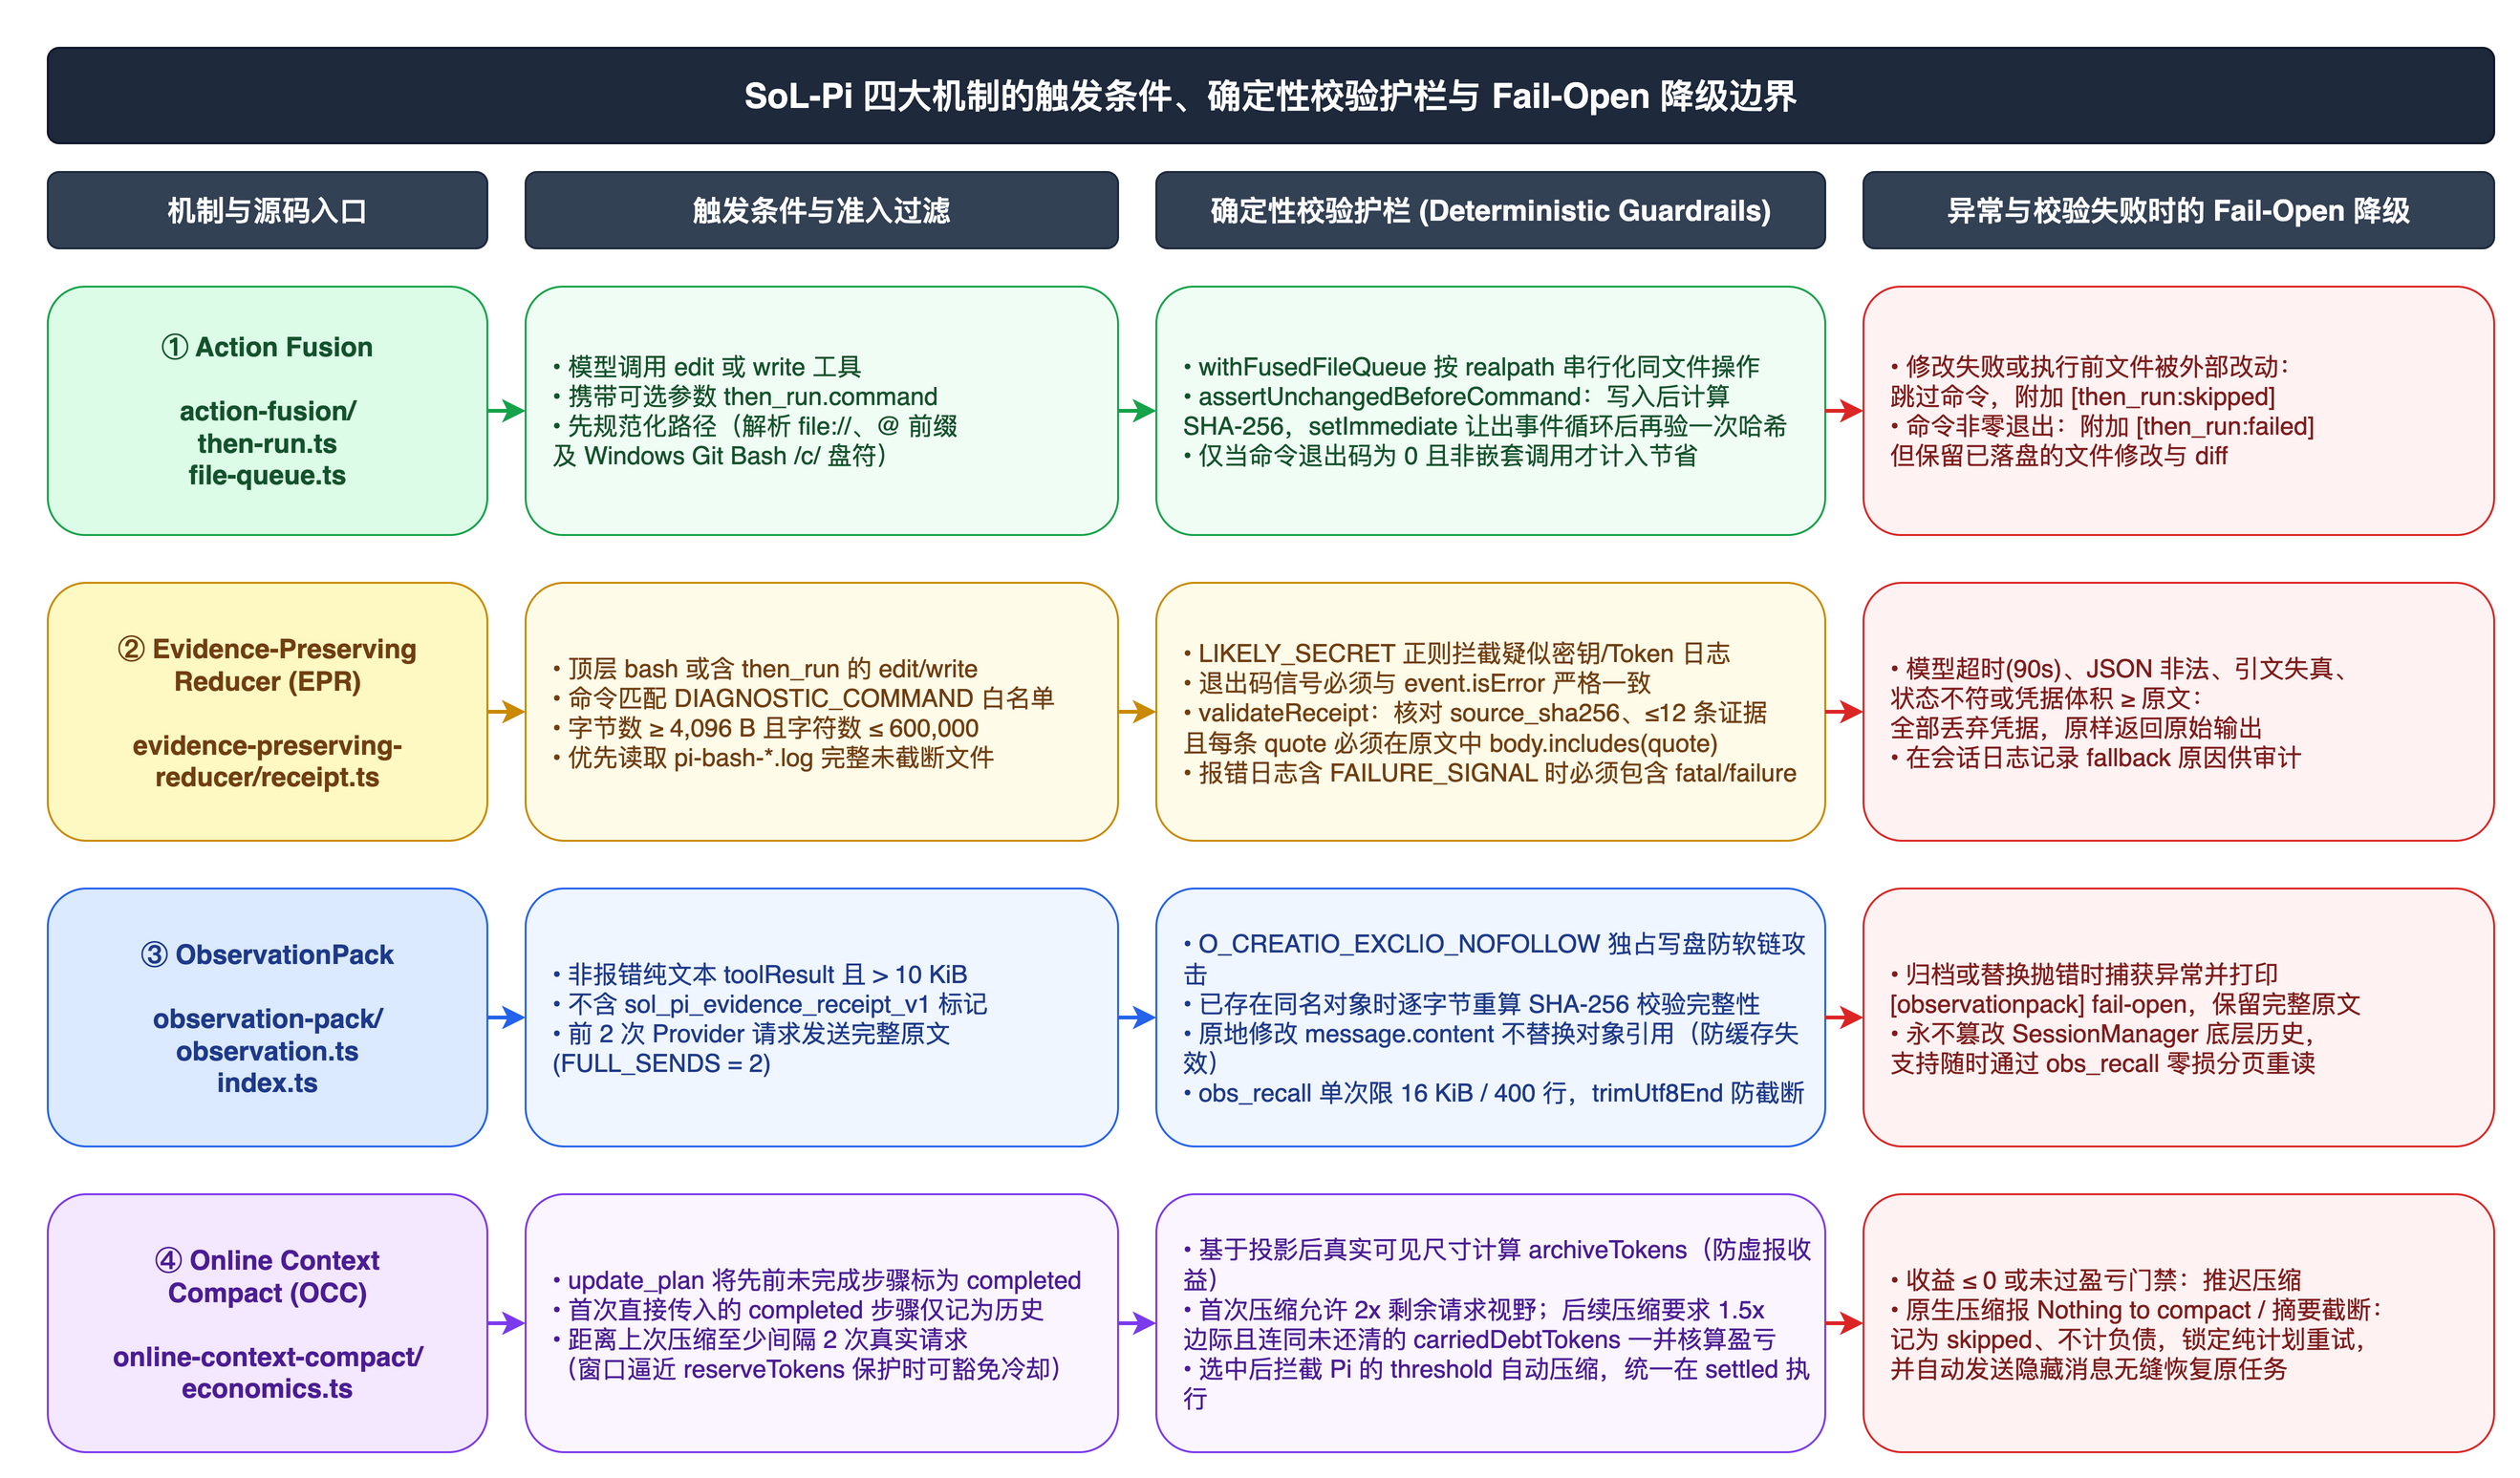
在工程实现上,SoL-Pi 最值得借鉴的一条准则是:任何优化机制出故障,最坏结果只能是“少省一点 Token”,绝不能让 Agent 丢失原始观察值或中断正在执行的任务。 下图汇总了源码中四项机制的触发条件、确定性校验护栏与降级路径:
10.2 本地测试套件实跑与一处源码测试边界发现
在本地环境中(Node.js + @earendil-works/pi-coding-agent@1.3.0),对 NVlabs/SoL-Pi(提交 21956803,版本 0.1.1)执行完整检查命令:
npm ci --ignore-scripts
npm run check
node scripts/check-pi-compat.mjs --strict
实测结果如下:
| 检查项 | 本地实跑结果 | 说明 |
|---|---|---|
tsc --noEmit | 通过(0 错误) | 严格 TypeScript 类型检查通过 |
check-pi-compat.mjs --strict | Pi compatibility: OK | 验证 @earendil-works/pi-coding-agent@1.3.0 公开导出与 codemode 兼容性通过 |
vitest run(24 个测试文件) | 268 项测试全部通过 | 覆盖四大机制、跨版本兼容、codemode、压力回归与真实 AgentSession 集成 |
npm pack --dry-run | 成功(37 个文件,1.6 MB) | 产物包结构完整 |
在本地实跑过程中,我们还验证出 tests/action-fusion.test.ts 的一个真实边界细节:当克隆仓库所在的本地目录名恰好包含大小写敏感的 "SoL-Pi"(即默认 git clone https://github.com/NVlabs/SoL-Pi.git 生成的目录名)时,第 210 行的单测 "drops the savings banner once a fused call settles as an error" 会报错:
// 来自 tests/action-fusion.test.ts (lines 187, 209-211)
cwd: process.cwd(),
// ...
const failed = render(true);
expect(failed.call).not.toContain("SoL-Pi");
expect(failed.rendered).not.toContain("SoL-Pi");
原因并不在业务代码,而在于测试用了过于宽泛的字符串断言 .not.toContain("SoL-Pi"):当 then_run 失败时,Action Fusion 确实已经移除了 ⚡ SoL-Pi · Action Fusion 节省横幅,但底层 Pi 内置的 write 工具渲染器会把目标文件路径格式化为终端 OSC-8 超链接 file:///.../SoL-Pi/target.ts。由于 process.cwd() 路径中带有仓库文件夹名 SoL-Pi,导致 .not.toContain("SoL-Pi") 误命中了文件路径。将工作目录名改为不含大写 SoL-Pi(或将断言收紧为 .not.toContain("SoL-Pi · Action Fusion"))后,24 个测试文件的 268 个用例 100% 通过。这也是一个很典型的测试反模式提醒:校验 UI 横幅移除时,应断言完整的组件特征标识,避免与工作目录路径发生子串碰撞。
11. 实验结果与消融分析
论文在 EdgeBench(51 个公开任务)、Terminal-Bench 4(63 个纯 CPU 任务)、IMO 2026(6 道 Lean 4 形式化数学题)以及多智能体算子优化集群(Agent Swarms)四个基准上评估了 SoL-Pi。所有 API 成本均按 2026 年 8 月 17 日的官方价格计算,核心效率指标定义为每获得 1 分总任务得分所消耗的 API 美元成本(Token Eff., $/score,越低越好)。
11.1 EdgeBench 主实验:与 6 种主流 Harness 对比及跨模型零样本迁移
论文报告了两个工作点:SoL-Pi [Efficiency](固定开启全部四项机制的完整栈)和 SoL-Pi [Performance](单机制消融中平均分最高的配置:GPT-5.6 Sol 下为 ObservationPack,Opus 5 下为 Action Fusion)。
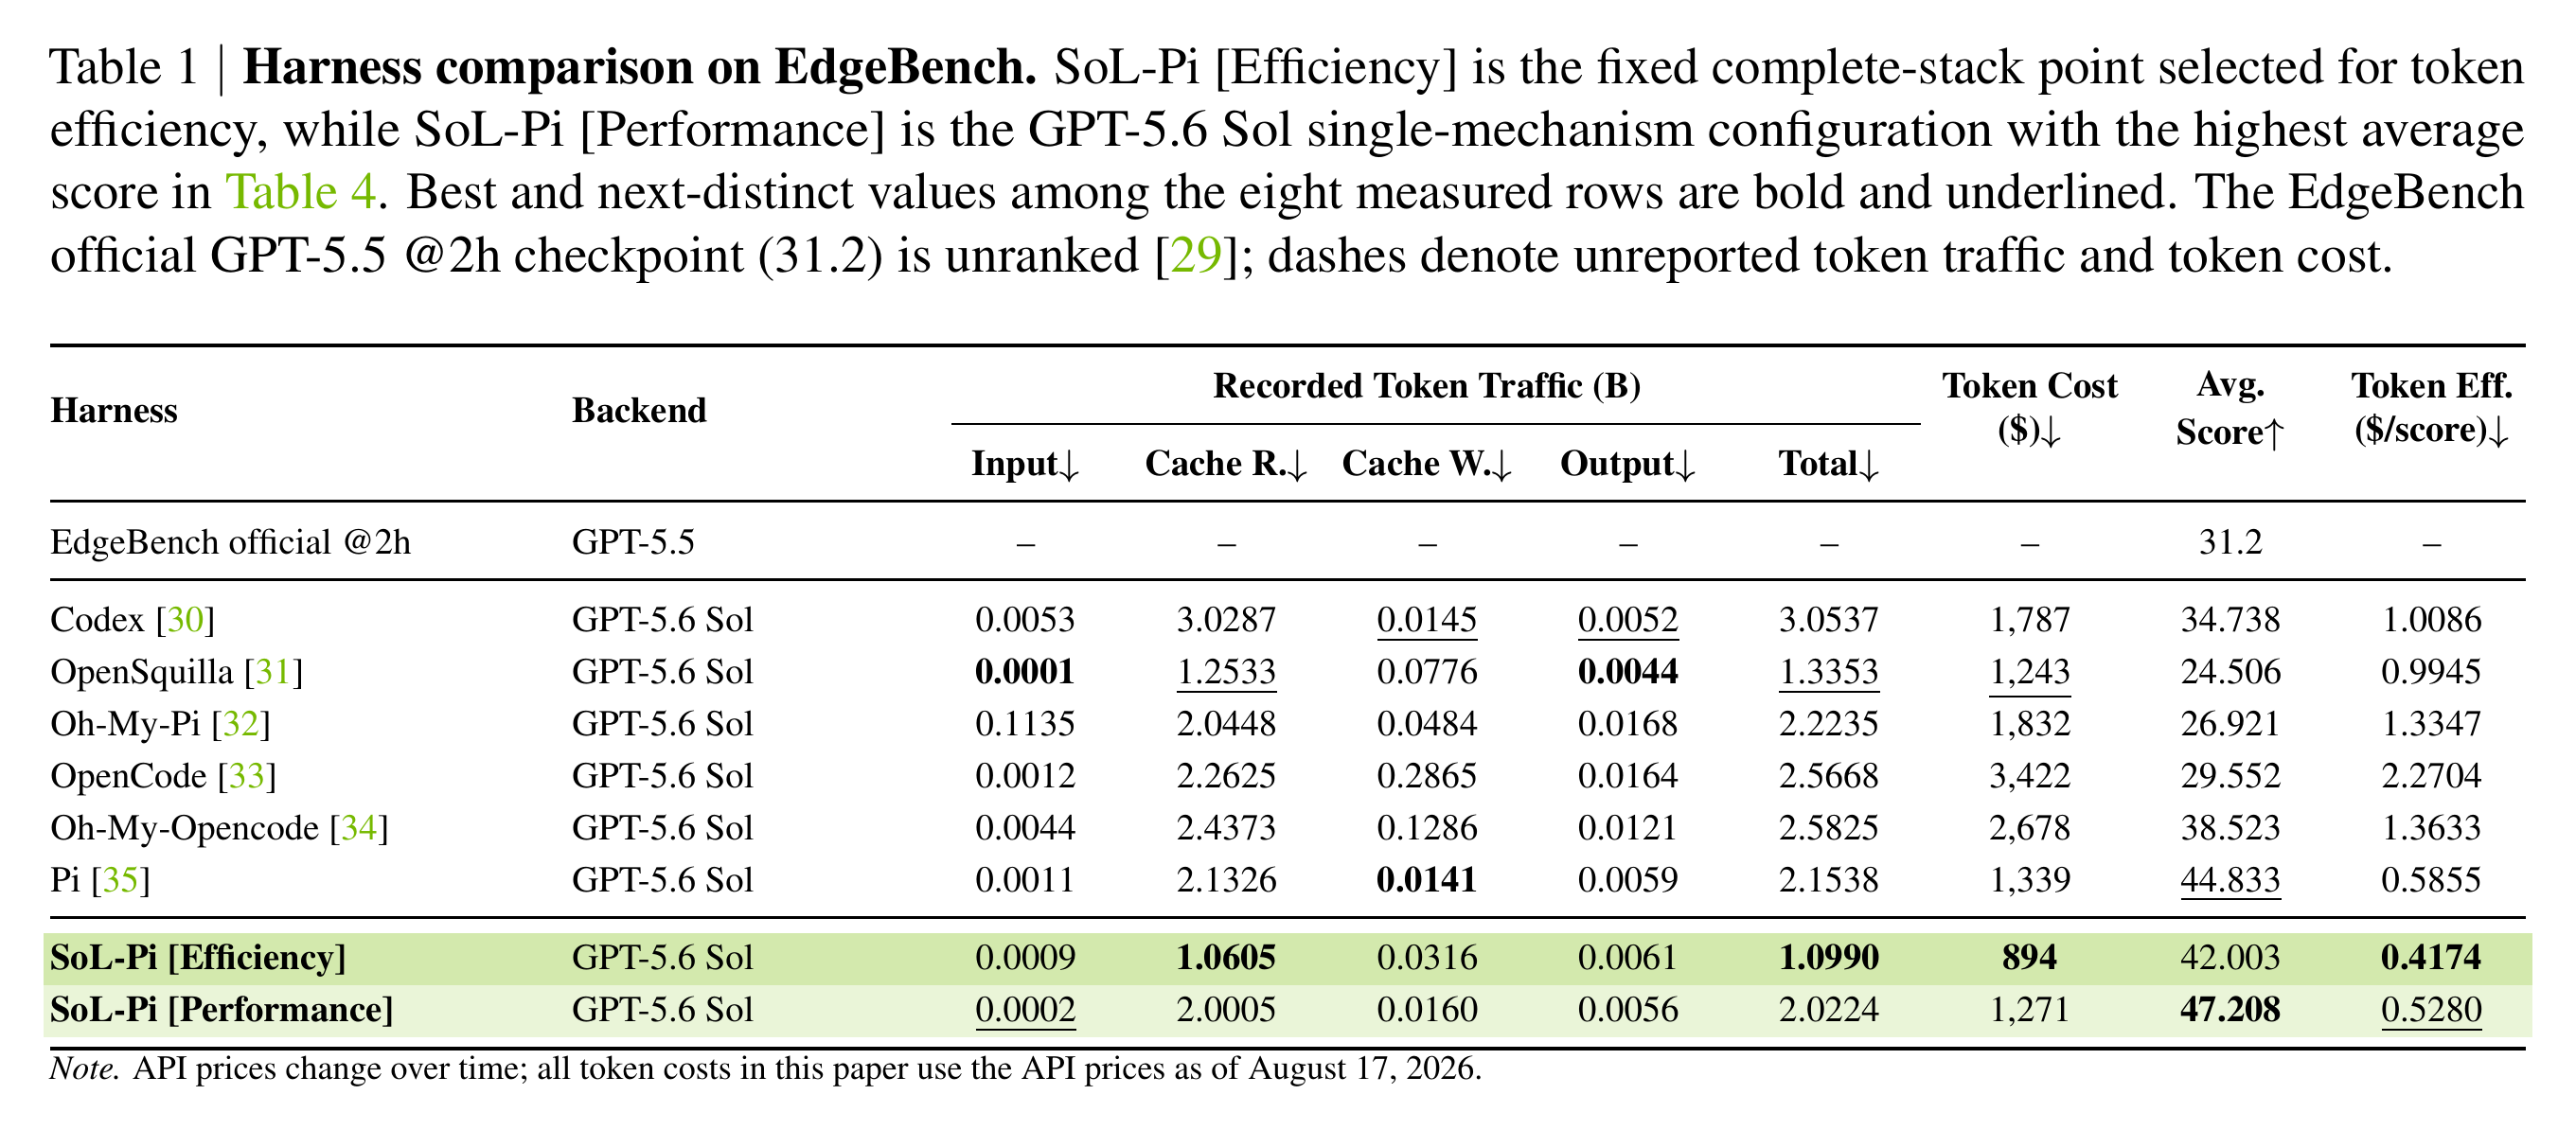
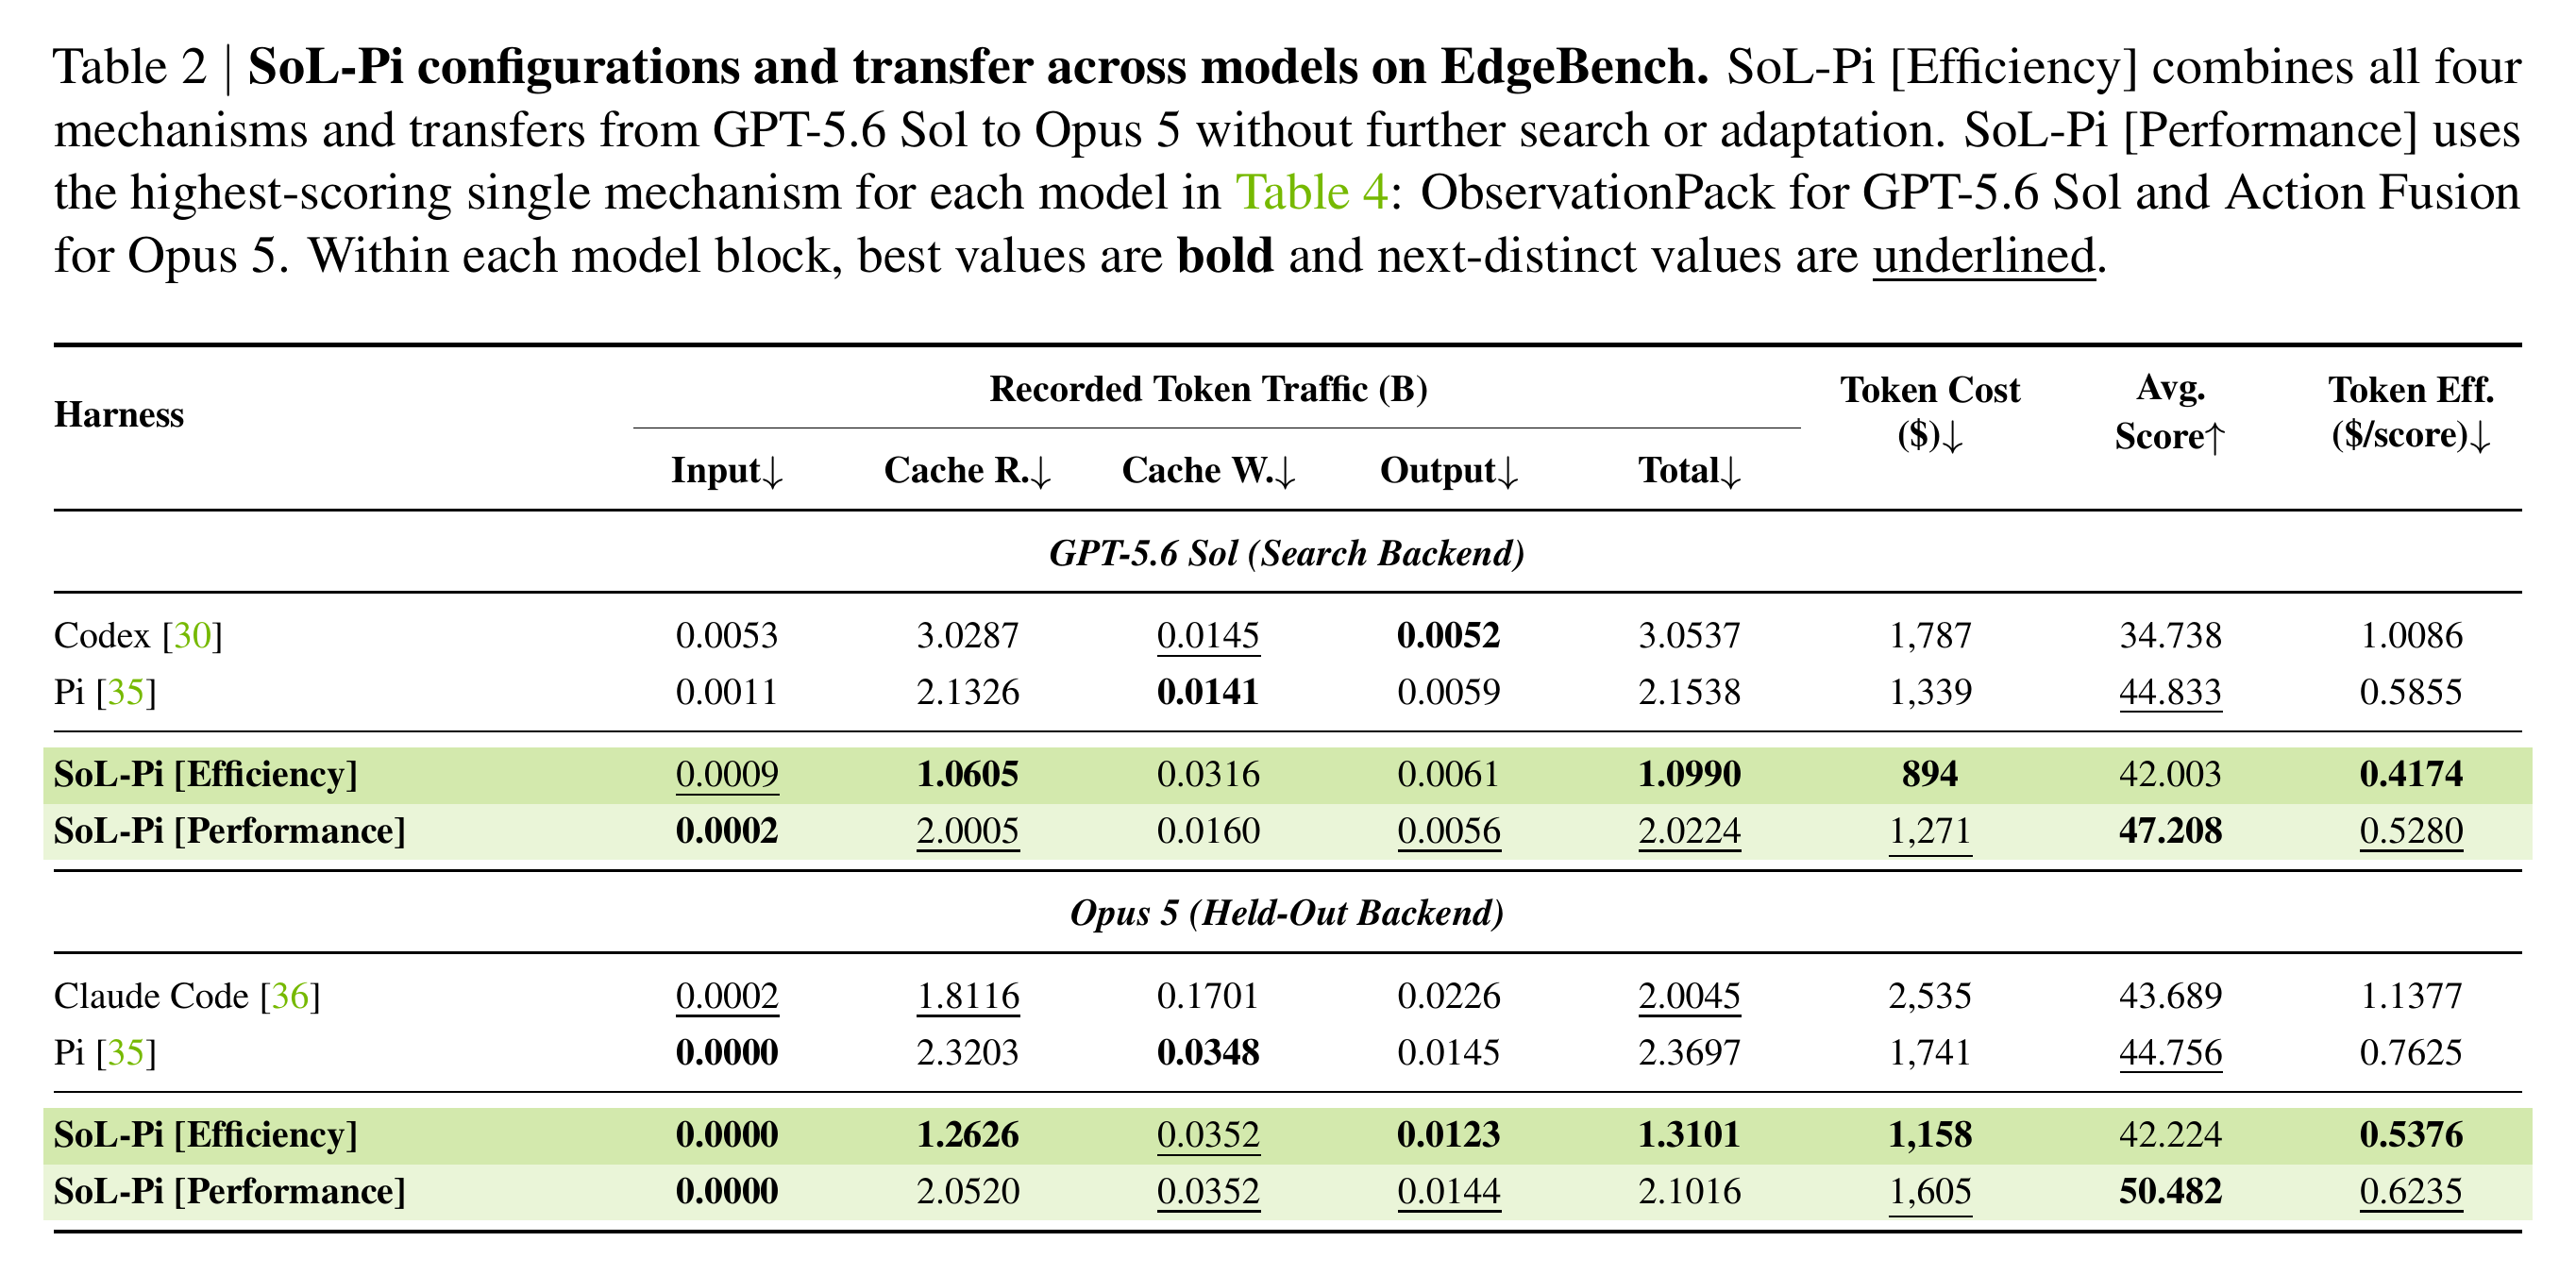
结合表 1 和表 2,可以得出三点关键结论:
- 基线选择本身决定了很大的起点差异:在同为 GPT-5.6 Sol 后端下,基线 Pi 的得分(44.833)和成本(1,339 美元)已经明显优于 Codex(34.738 分 / 1,787 美元)、OpenCode(29.552 分 / 3,422 美元)和 Oh-My-Opencode(38.523 分 / 2,678 美元)。SoL-Pi 是在已经相当精简的 Pi 基线上继续做减法。
SoL-Pi [Efficiency]将 Token 流量砍半、成本降三分之一:- 在 GPT-5.6 Sol 上,总 Token 流量从 Pi 的 2.1538 B 降至 1.0990 B(减少 49.0%),API 成本从 1,339 美元降至 894 美元(节省 33.2%,相对 Codex 的 1,787 美元节省 50.0%),平均分 42.003(保留 Pi 的 93.7%),单位得分成本从 0.5855 美元/分降至 0.4174 美元/分。
- 在未参与搜索的 Opus 5 上(零样本直接迁移,不改任何代码或超参),总 Token 流量从 Pi 的 2.3697 B 降至 1.3101 B(减少 44.7%),API 成本从 1,741 美元降至 1,158 美元(节省 33.5%,相对 Claude Code 的 2,535 美元节省 54.3%),平均分 42.224(保留 Pi 的 94.3%)。
SoL-Pi [Performance]实现了“既提分又省钱”:在 GPT-5.6 Sol 上仅开启 ObservationPack 时,平均分从 44.833 提升至 47.208(+5.3%),同时成本降至 1,271 美元;在 Opus 5 上仅开启 Action Fusion 时,平均分从 44.756 提升至 50.482(+12.8%),同时成本降至 1,605 美元。
11.2 单机制消融与 Prompt Cache 读写权衡
为什么在开启 Online Context Compact 和 ObservationPack 后,Cache Write(缓存写入)Token 反而增加了,总成本却大幅下降?表 4 的单组件消融给出了定量拆解:
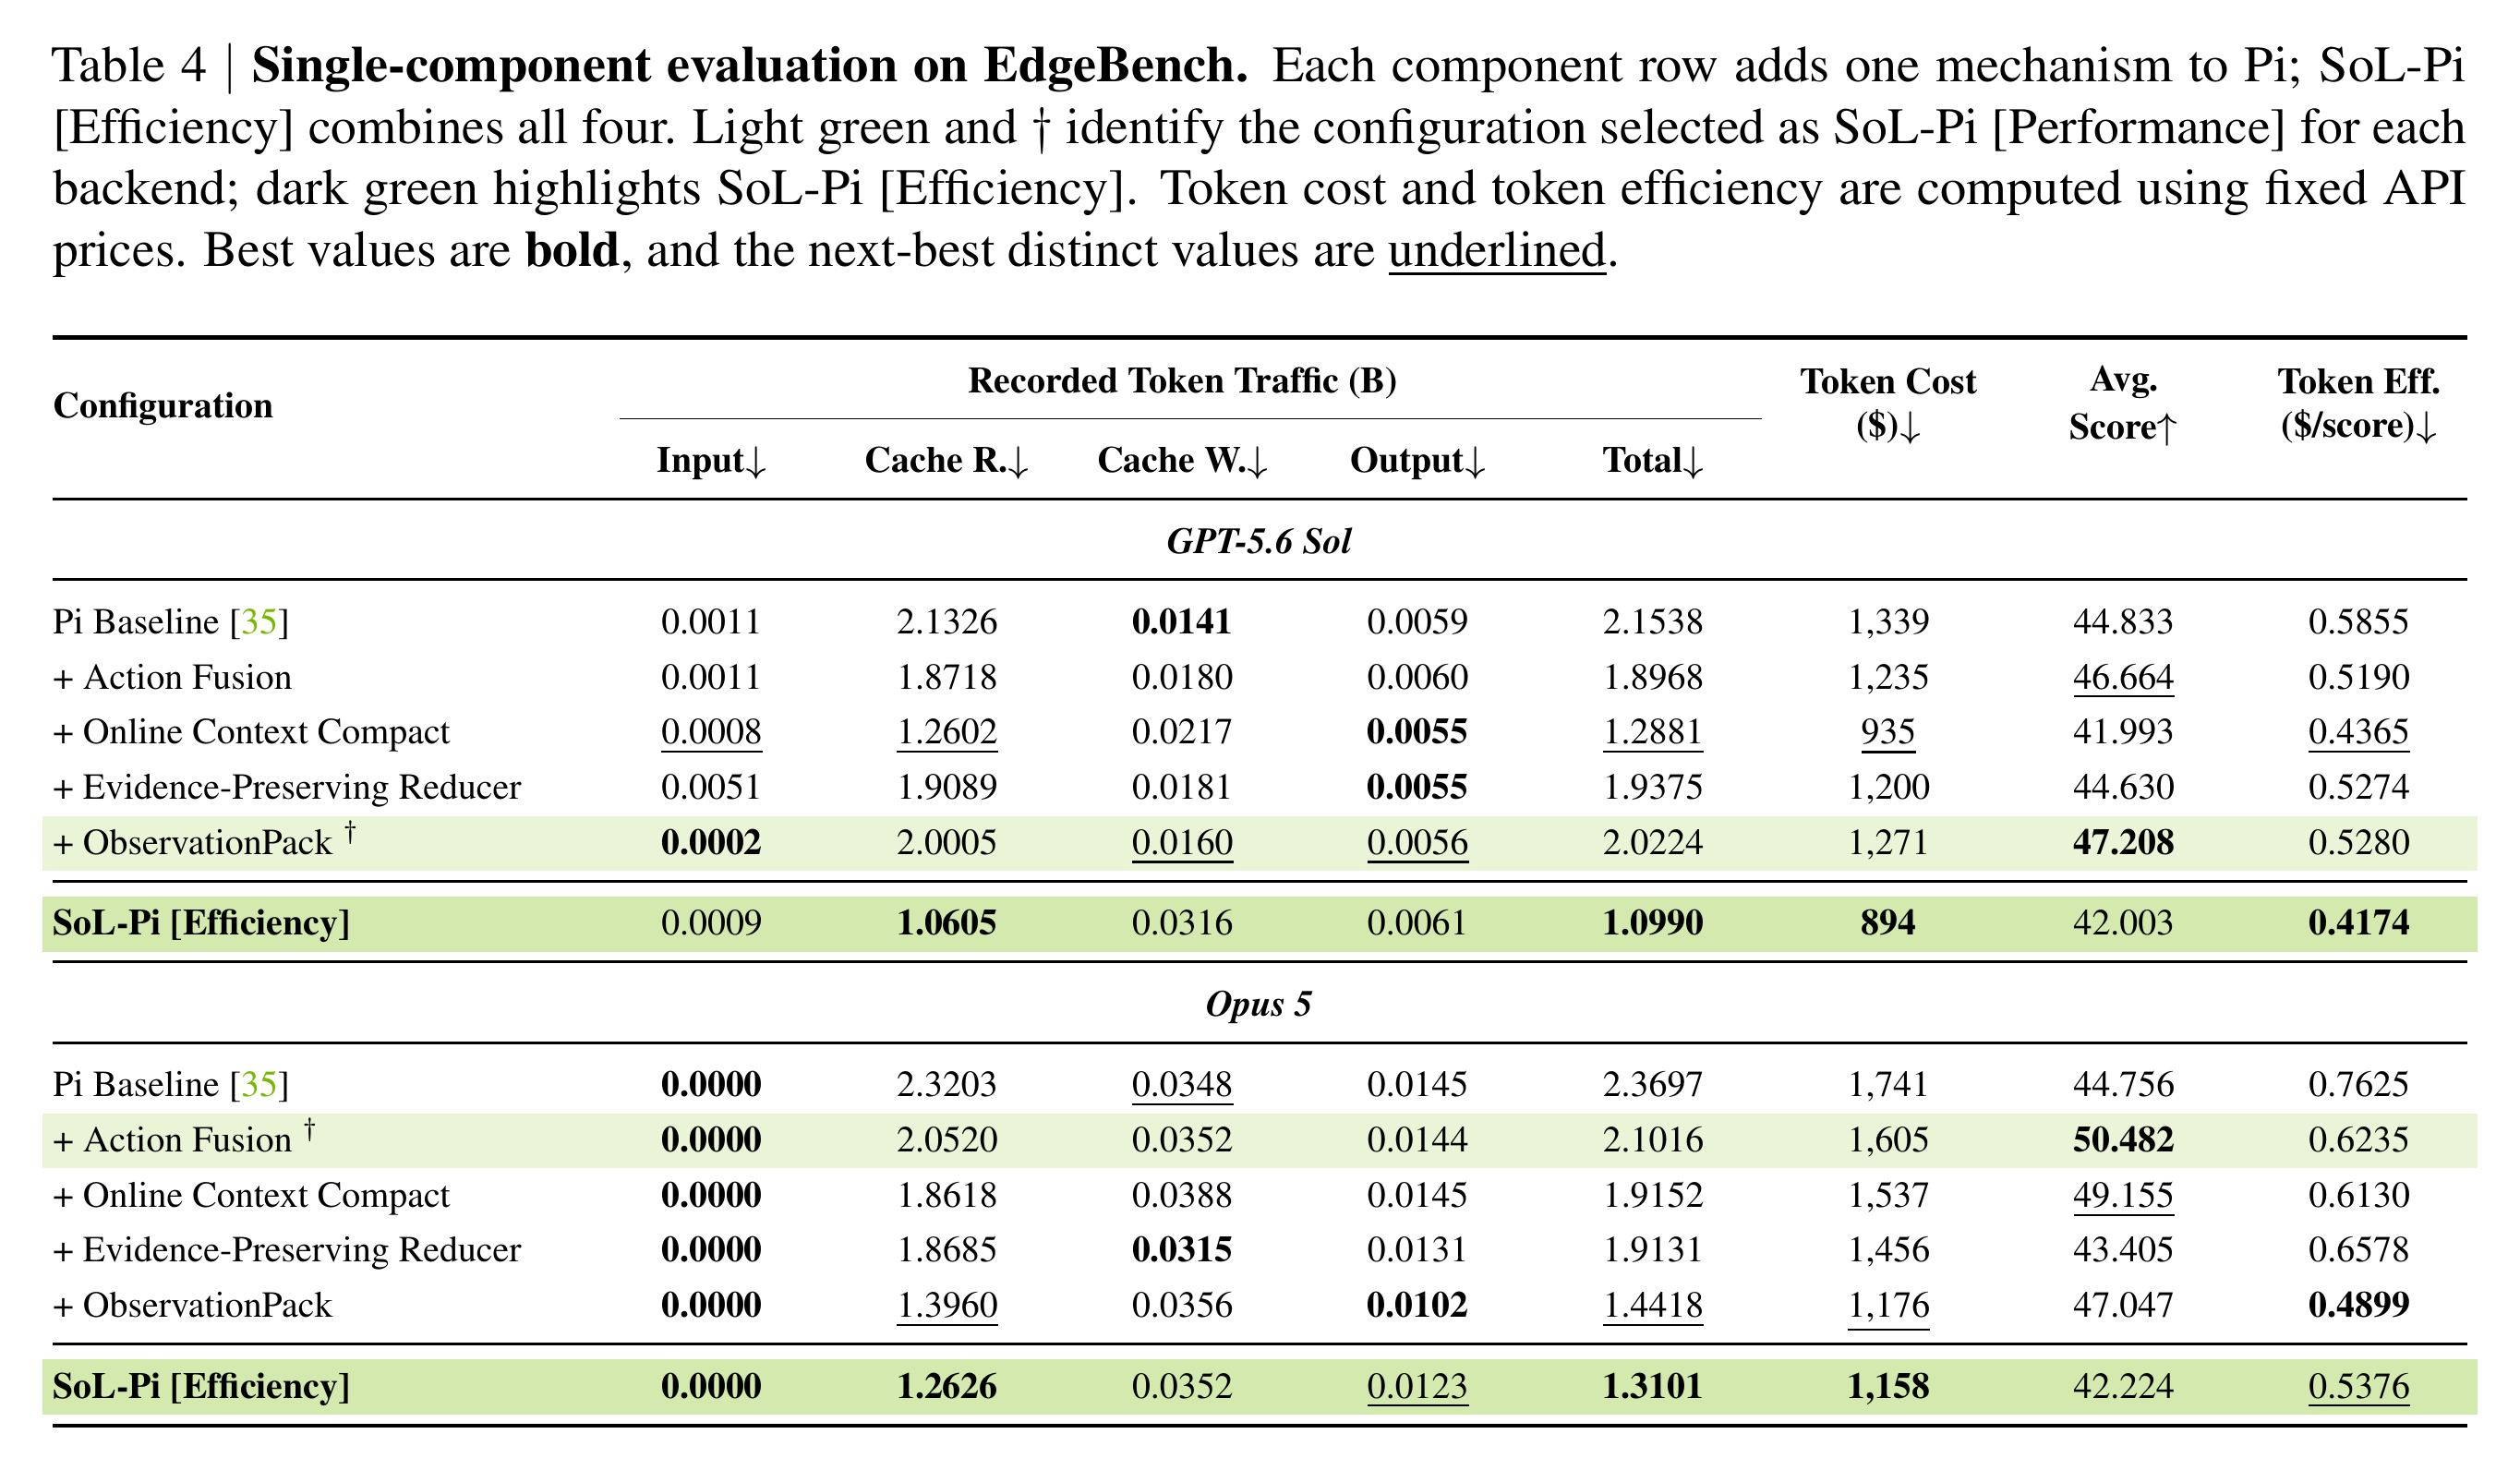
在 GPT-5.6 Sol 下,完整栈的 Cache Write 流量从基线的 0.0141 B 上升到 0.0316 B(增加了约 1,750 万 Tokens),因为上下文压缩和占位符替换改变了历史前缀,触发了局部缓存重写;但与此同时,Cache Read 流量从 2.1326 B 暴跌至 1.0605 B(减少了超过 10.7 亿 Tokens)。由于长任务中每一轮都在重复支付 Cache Read 费用,省下的 10.7 亿次缓存读取远超 1,750 万次缓存写入的开销,最终让总账单从 1,339 美元降到 894 美元。这也印证了 Online Context Compact 源码中“把 Cache Write 视为需要后续请求摊销的缓存负债”这一建模的合理性。
另外,从表 4 可以清楚看到完整栈分数略低于基线(42.003 vs. 44.833)的真正来源:在 GPT-5.6 Sol 下,单独开启 Action Fusion(46.664)和 ObservationPack(47.208)都会提升分数,单独开启 EPR(44.630)基本持平,唯独单独开启 Online Context Compact 虽然把成本从 1,339 美元猛砍到 935 美元,但平均分降到了 41.993。也就是说,激进的在线上下文压缩是完整栈约 6% 分数折损的主要来源。
11.3 跨模型触发行为与机制合并互补性
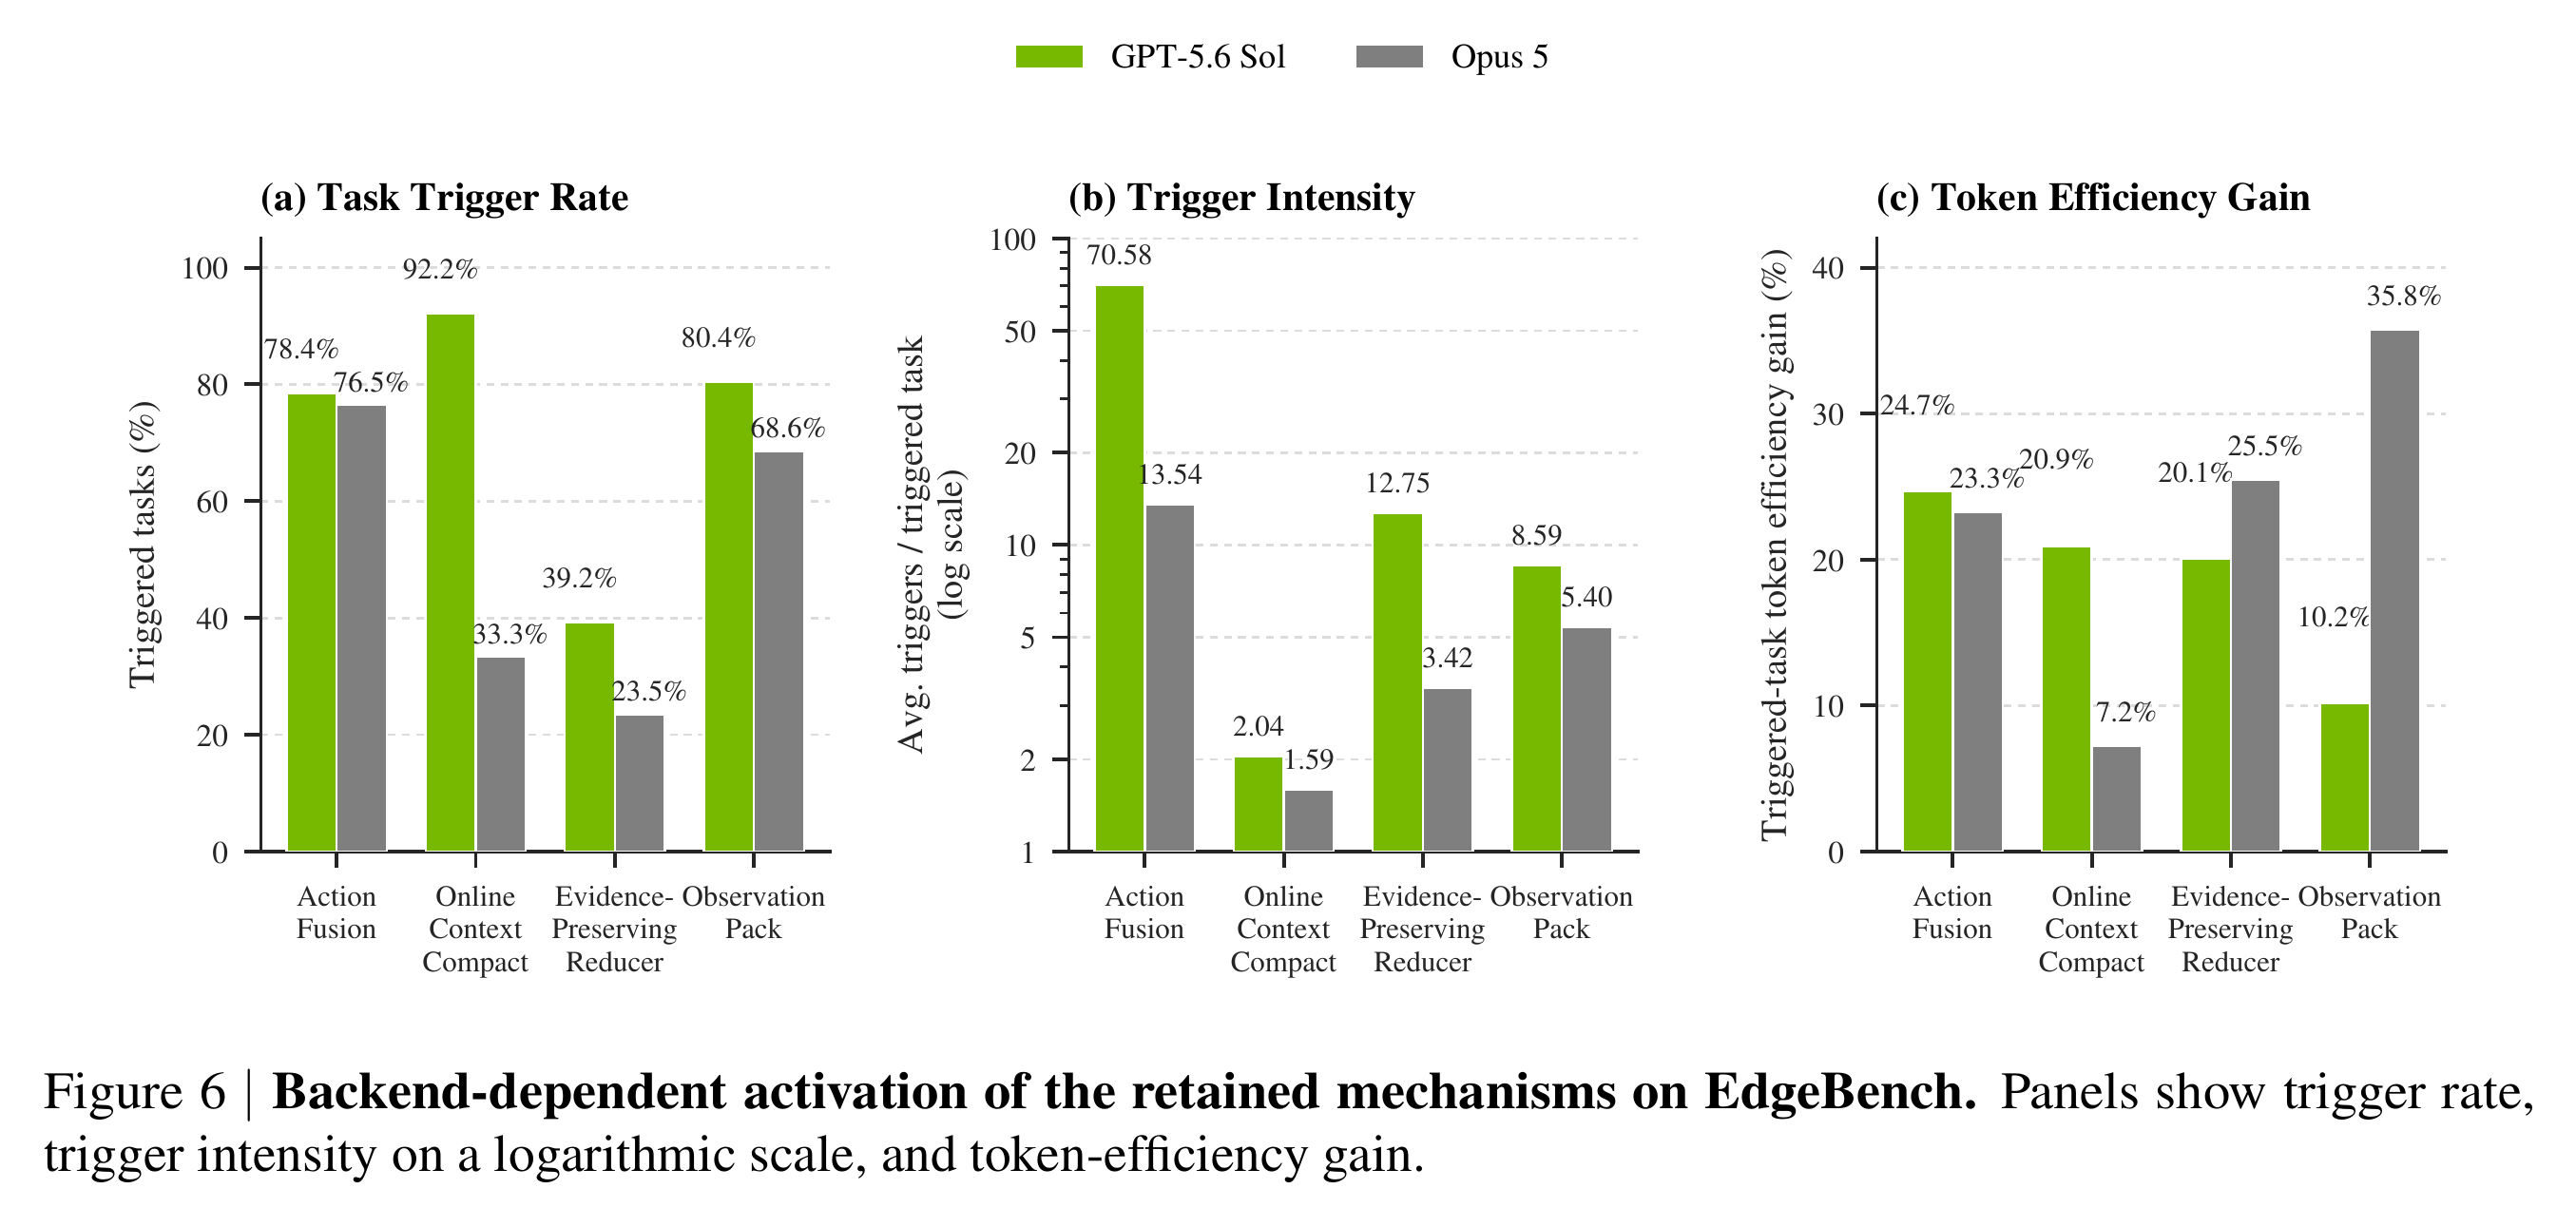
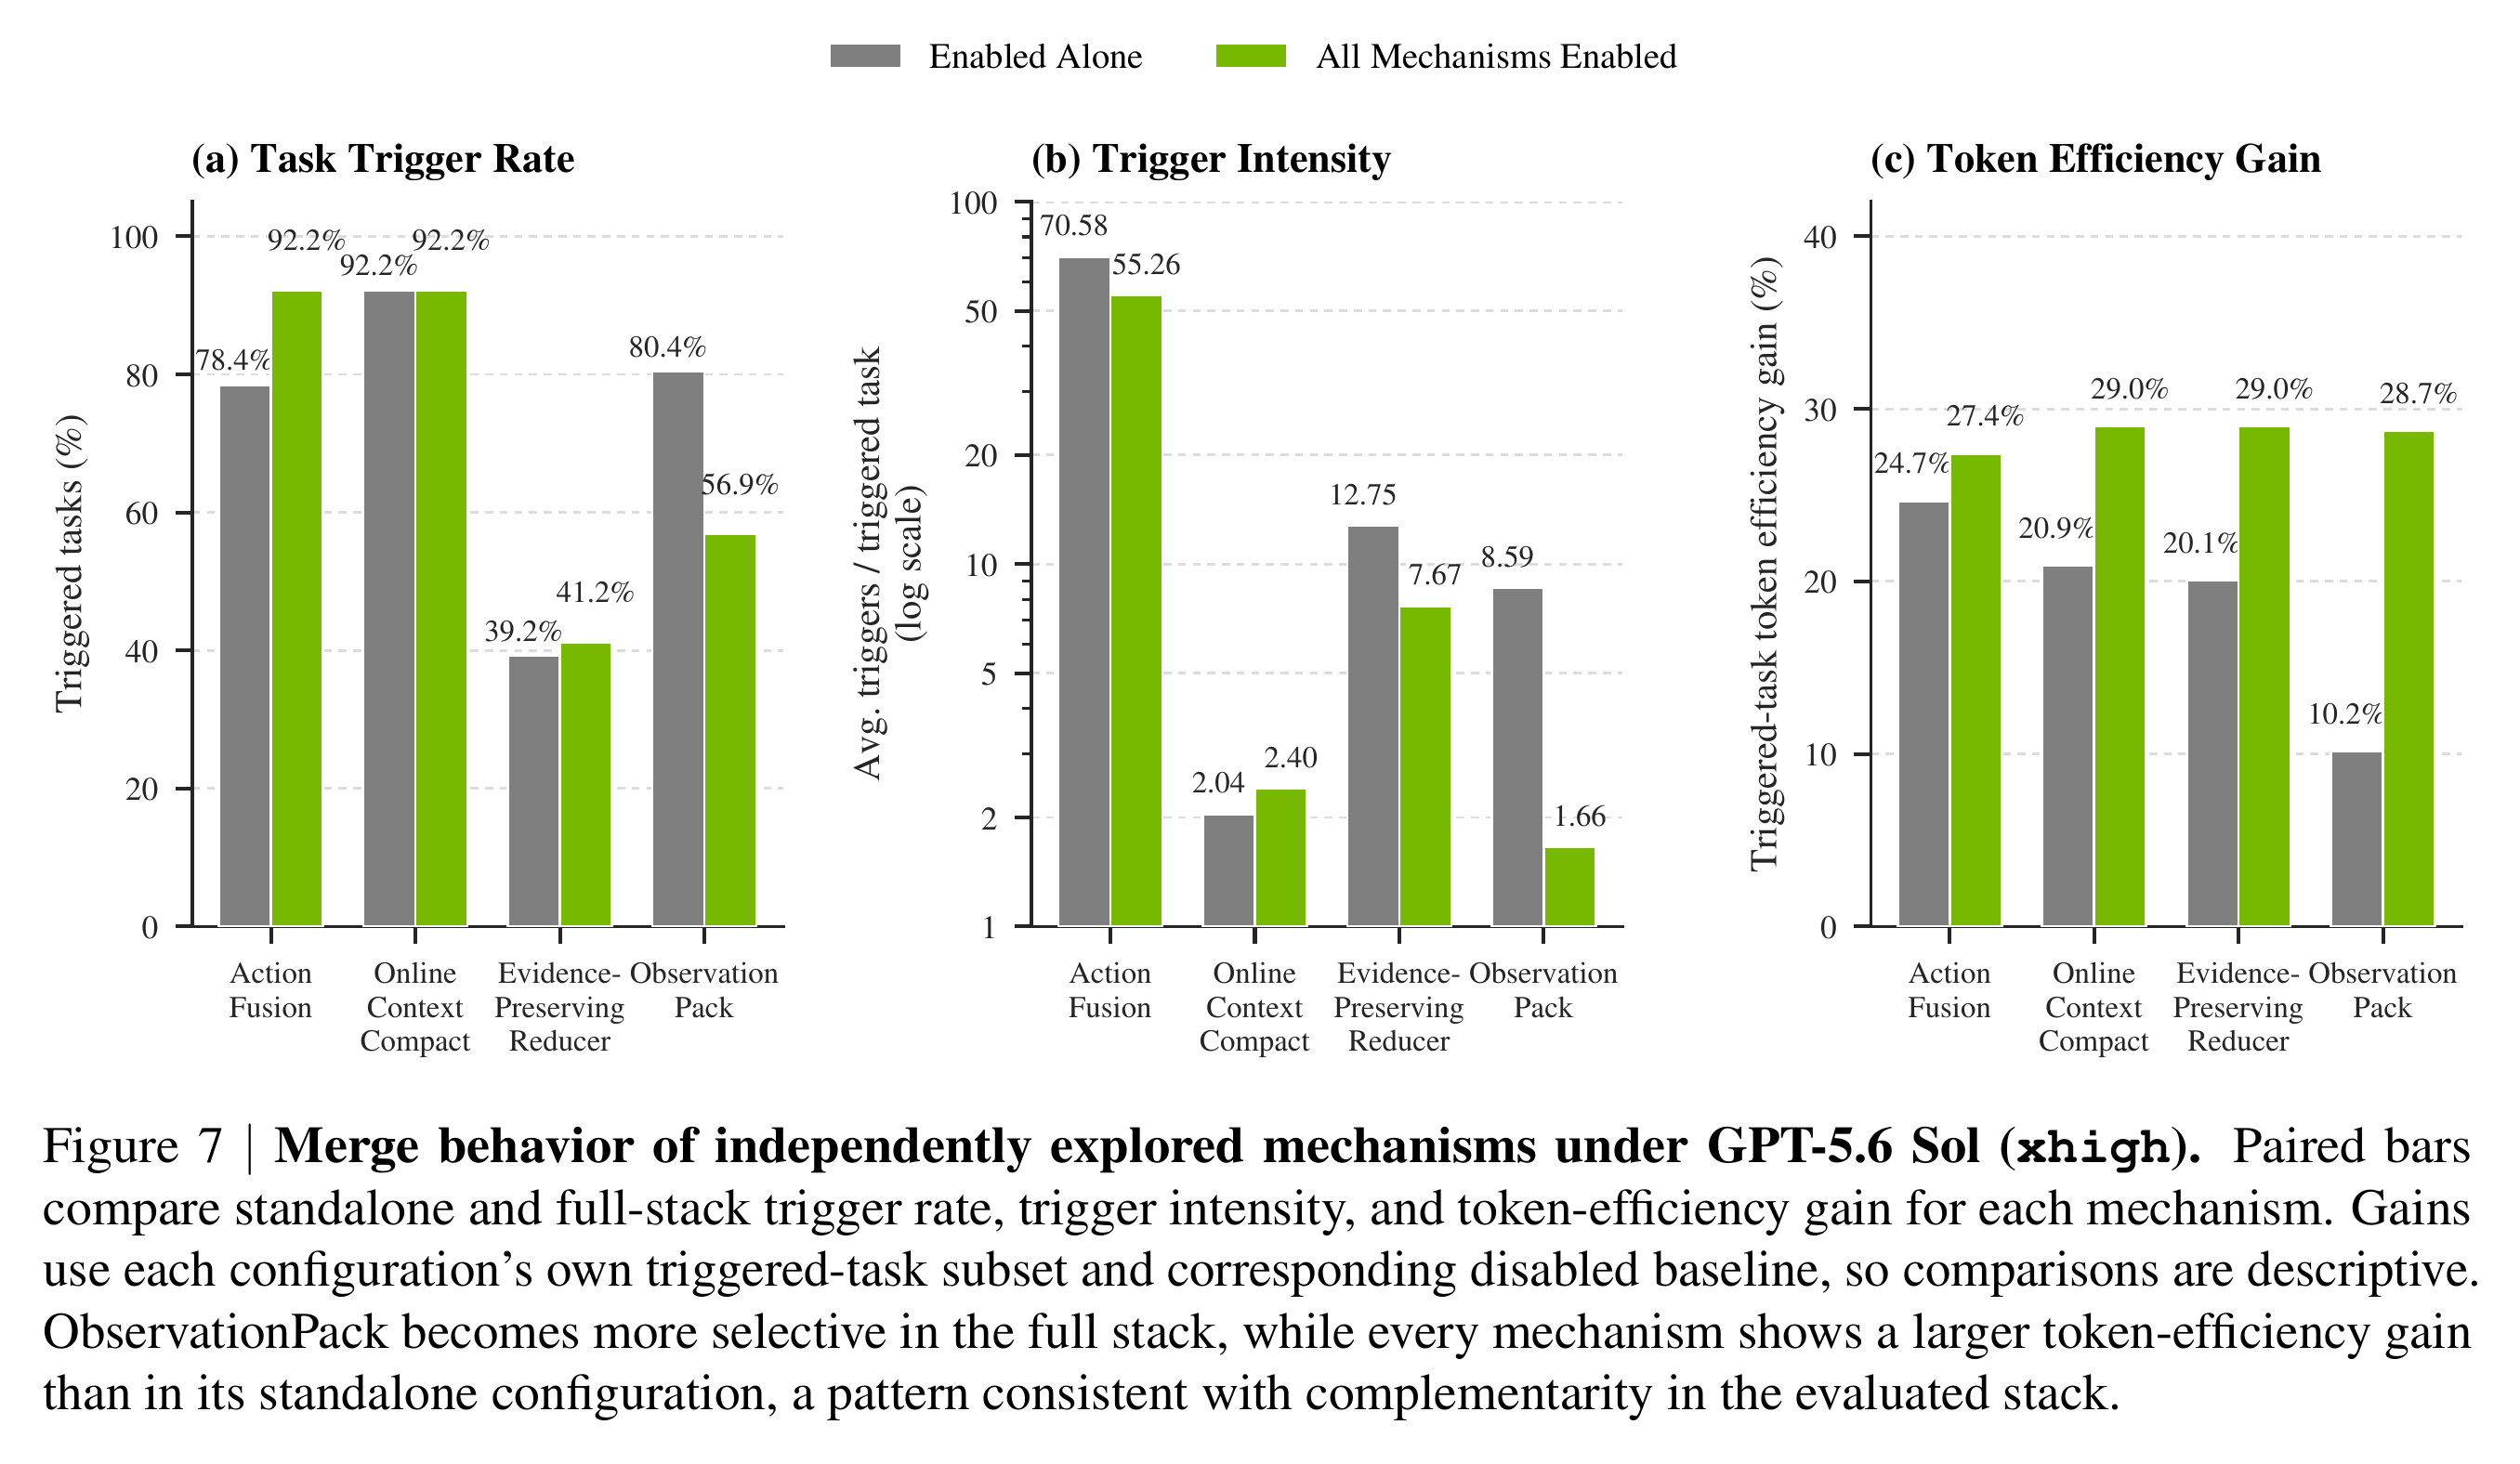
图 12 和图 13 揭示了两个重要现象:
- 搜索后端偏好(图 12):由于所有机制和提示词都是在 GPT-5.6 Sol 的轨迹上搜索调优出来的,切到 Opus 5 后,四项机制的触发率(Trigger Rate)和触发强度(Trigger Intensity)普遍下降——例如 Action Fusion 在每任务上的平均触发次数从 GPT-5.6 Sol 的 70.58 次降至 Opus 5 的 13.54 次,Online Context Compact 触发率从 92.2% 降至 33.3%。但只要触发,Opus 5 在对应任务子集上依然全部获得了显著的效率增益(ObservationPack 在 Opus 5 触发任务上效率增益达 35.8%)。
- EPR 与 ObservationPack 的职责分流(图 13):当四项机制全开时,ObservationPack 的任务触发率从单独开启时的 80.4% 降至 56.9%,单任务触发次数从 8.59 次降至 1.66 次,但它在触发任务上的效率增益却从 10.2% 跃升至 28.7%。这是因为原本很多 >10 KiB 的长测试日志已经被前置的 Evidence-Preserving Reducer 在
tool_result阶段压成了精简凭据,不再需要 ObservationPack 兜底;ObservationPack 得以专注于压缩大型文件读取和搜索结果。
11.4 Terminal-Bench 4、IMO 2026 与 20-Worker 多智能体集群
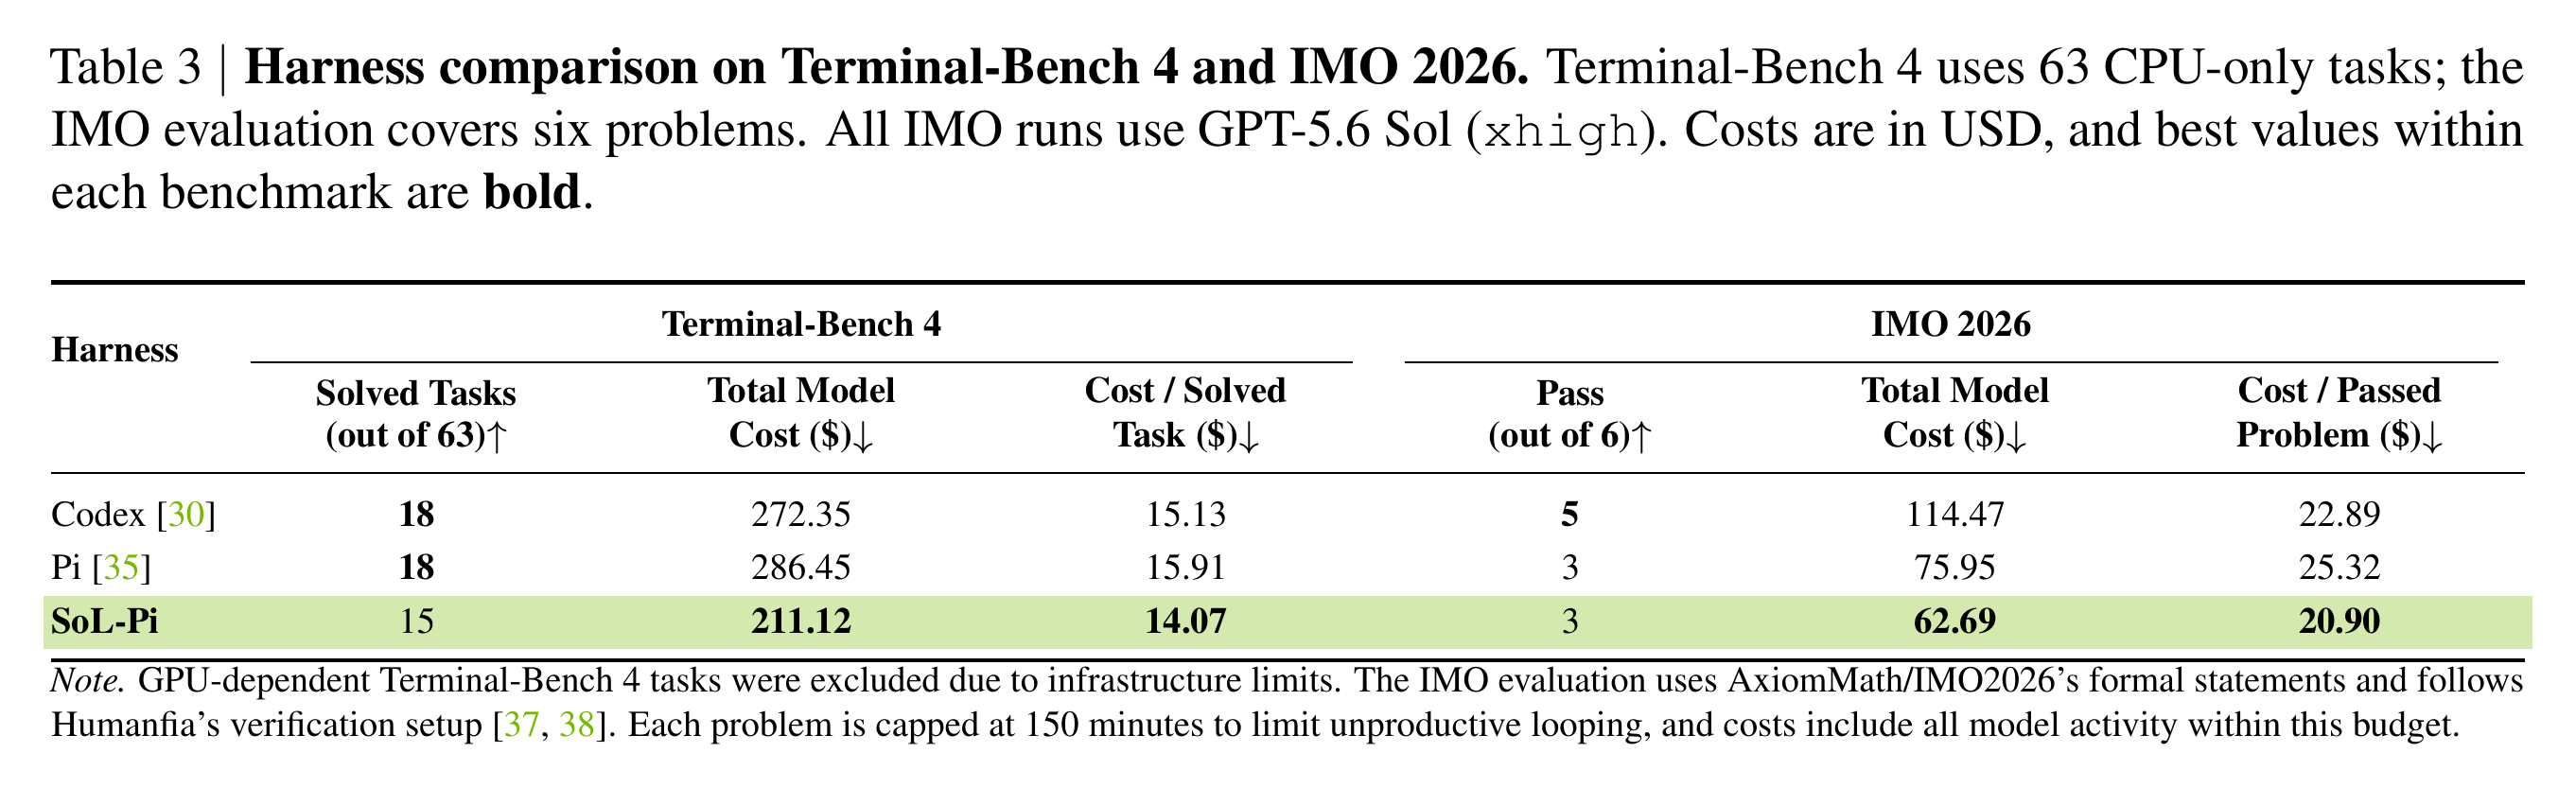
- Terminal-Bench 4(表 3 左):Codex 与 Pi 各解决 18/63 题,SoL-Pi 解决 15/63 题;SoL-Pi 将总成本从 Pi 的 286.45 美元降至 211.12 美元(-26.3%),单题成功成本降至 14.07 美元(优于 Codex 的 15.13 美元和 Pi 的 15.91 美元)。但这也暴露出一个边界:在极端复杂的命令行排障任务上,全开四项压缩机制可能会损失少量边际解题数(18 → 15)。
- IMO 2026 Lean 4 形式化证明(表 3 右):每题限时 150 分钟,SoL-Pi 与 Pi 均通过 3/6 题,总成本从 75.95 美元降至 62.69 美元,单题通过成本 20.90 美元为三者最低。
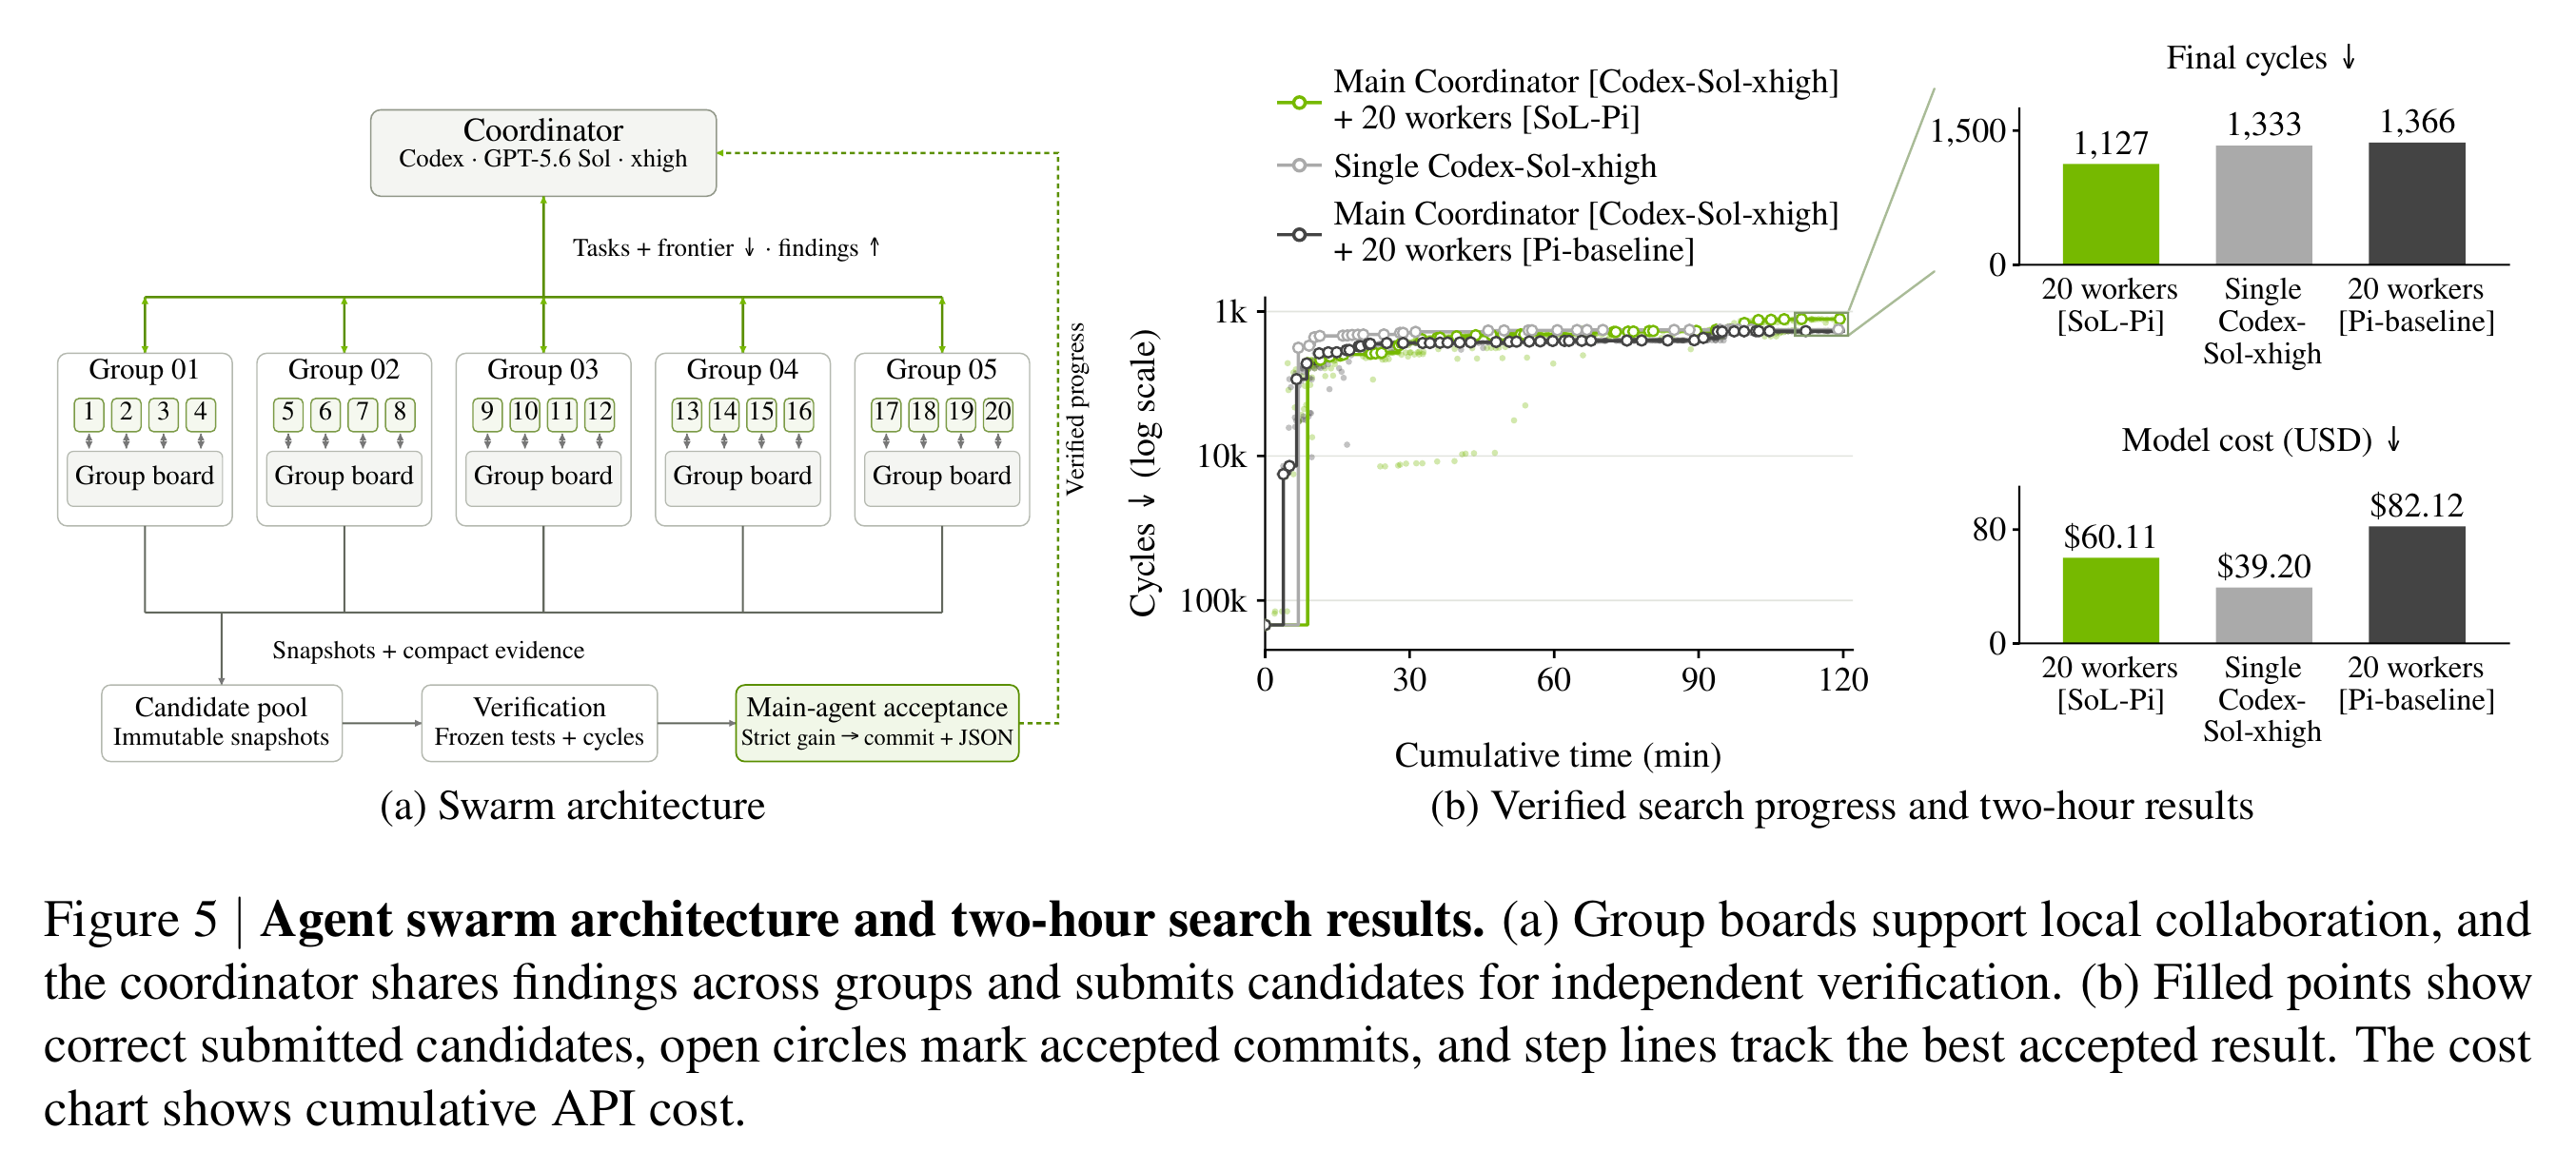
- 20-Worker 算子优化集群(图 15):在 2 小时限时算子性能优化基准上(初始机器周期为 147,734 cycles),由 1 个 Codex 协调器(GPT-5.6 Sol)带领 5 组共 20 个 SoL-Pi Worker(GPT-5.6 Luna)组成的集群,将最终周期数压到了 1,127 cycles(通过全部 8 道速度阈值),优于单 Codex 智能体(1,333 cycles)和 20 个基线 Pi Worker 集群(1,366 cycles,未通过最后一道 1,363 cycles 阈值),且集群 API 成本从基线 Pi 集群的 82.12 美元降至 60.11 美元(节省 26.8%)。
12. 对 GUI Agent 与 APP 自动化测试 / Mobile QA 的启发
虽然 SoL-Pi 的主体实现面向命令行与 Coding Agent,但它解决的四个开销源头——动作后置验证的多余轮次、大体积观察值重放、长诊断日志噪音、以及跨子任务上下文累积——在移动端 GUI Agent 与 APP 自动化测试(Android / iOS / H5 / Hybrid E2E 测试、探索性测试与 UI 巡检)中同样是决定单次测试成本和耗时上限的核心瓶颈。将 SoL-Pi 的源码机制映射到 Mobile QA 场景,可以直接提炼出四条落地实践:
12.1 把“UI 动作 + 页面稳态采样/断言”做成移动端 Action Fusion
在 Appium、Maestro、UIAutomator 或 XCUITest 驱动的移动端 GUI Agent 中,最常见的低效交互是:模型第 1 轮输出 tap(x, y) 或 input_text(),框架只返回一句 "Action executed",模型第 2 轮再发起调用去获取当前 Activity、截取屏幕或拉取无障碍树(Accessibility Tree / View Hierarchy)。
借鉴 action-fusion/then-run.ts:
- 可以在
tap、swipe、type、deeplink_open等界面变更工具上直接扩展可选的then_observe或then_assert参数(如等待页面 Idle 后自动拉取精简控件树摘要、检查 Toast/弹窗或验证特定 resource-id 是否出现),在同一轮 Tool Result 中把“动作执行状态 + 动作后页面状态差分”一次性返回给模型,直接砍掉一半的“动作—观察”往返轮次。 - 同时借鉴
assertUnchangedBeforeCommand的护栏思想:在移动端融合动作执行前后核对当前前台包名(Package Name)、窗口 Token 或页面树哈希,一旦中途被系统权限弹窗、系统升级提示或异常闪退打断,立即标记[then_observe:interrupted],避免在错误页面上继续执行后续断言。
12.2 用 ObservationPack 管理庞大 View Hierarchy 与抓包 JSON
Android 复杂页面的 XML Dump(或 iOS XCUITest 的层级树、WebView DOM 快照、Charles/Mitmproxy 接口 Mock 抓包响应)动辄达到 30 KiB–200 KiB。如果每一轮都把前几步的完整 XML 树塞进多模态上下文,不到 15 步就会把窗口撑爆。
借鉴 observation-pack/index.ts:
- 2 轮全量窗口 + 第 3 轮起句柄化:当前步和上一步的 UI 控件树保留完整结构供模型做局部定位与反思;从往前第 3 步开始,在
context投影层原地将历史控件树替换为ui_obs_<hash>句柄 + 页面顶层 Activity/路由名与可见可交互节点数摘要。 - 原地修改保缓存前缀:与 SoL-Pi 一样,只修改发送给 LLM 的投影克隆体,底层测试录制回放日志(Session Ledger)完整保留每一帧的原始 XML 与截图。当 Agent 需要回溯“三步前商品详情页里的价格字段是多少”时,再通过
obs_recall按节点路径或字节偏移精确拉取。
12.3 用 Evidence-Preserving Reducer 过滤 adb logcat 与 Crash/ANR 堆栈
移动端自动化测试失败时,adb logcat、iOS diagnosticd 日志、React Native / Flutter 控制台输出或 Gradle/Xcode 构建日志往往长达数万行。直接把几万行 logcat 喂给主规划 VLM 既昂贵又容易分散注意力;而只用简单正则截取最后 50 行,又常因为异步日志刷屏而漏掉真正的 FATAL EXCEPTION 或 ANR in 根因行。
借鉴 evidence-preserving-reducer/receipt.ts:
- 将超过 4 KiB 的
logcat/ Crash 日志先按内容哈希归档到本地测试产物目录,再交由轻量廉价模型提取最多 12 条属于fatal、failure、warning、target的关键日志行。 - 强制执行
body.includes(quote)逐字节校验:轻量模型返回的每一行异常堆栈都必须在原始logcat文件中逐字节匹配,并由校验器自动标出原始行号;若校验失败或漏掉了FATAL EXCEPTION/ANR信号,则自动回退为原始日志切片。这样主测试 Agent 拿到的是带有精确行号和哈希背书的“可信报错回执(Verified Receipt)”,既避免了小模型幻觉误导缺陷归因,又大幅降低了日志排障的 Token 消耗。
12.4 按业务子任务边界(而非固定步数)执行 Online Context Compact
一条完整的电商或社交 APP 端到端测试链路往往包含多个阶段:账号登录与环境准备 → 搜索与筛选商品 → 详情页加购与规格切换 → 结算页核对优惠券与提交订单。按固定步数(例如每 10 步)做上下文压缩,很容易在“正在填写结算表单”的半中间把刚查出来的商品单价压缩丢掉。
借鉴 online-context-compact:
- 让移动端测试 Agent 通过
update_plan维护测试阶段列表。只有当一个完整的业务子阶段状态变为completed(并附带progress.verification记录该阶段已验证的断言结果与关键测试数据)时,才触发上下文压缩评估。 - 结合
solpi-visual的magnify思路:在移动端视觉测试(Visual QA)中,优先对疑似布局错位、文字截断或组件重叠的局部 bbox 调用确定性裁剪放大核验,而不是反复重新渲染或全图高频重试。
13. 局限性、潜在高估风险与源码阅读索引
13.1 站在专家视角的客观审视:真正贡献与可能被高估的部分
- 真正推进领域的贡献:
- 给出了四个完全正交、工程边界极其克制的 Harness 原语:Action Fusion(省轮次)、ObservationPack(省大观察重放)、EPR(带逐字节校验的日志委派)和 Online Context Compact(带缓存负债核算的边界压缩)分别作用于工具层、投影层、结果层和会话控制层,且全部坚持零侵入上游代码与 Fail-Open 降级。
- 把 Prompt Cache 重写代价显式写进了上下文压缩决策方程:打破了“上下文越短就一定越省钱”的朴素假设,量化了 Cache Write 负债与剩余请求视野之间的盈亏平衡关系。
- 用确定性子串校验解决了小模型委派的信任问题:EPR 不相信小模型的概括能力,只用小模型做原文引文定位,再用
body.includes(quote)做零幻觉核验,这一模式可以直接复用到几乎所有 Agent 日志分析场景。
- 可能被高估或落地时必须警惕的风险:
- Online Context Compact 的分数折损不可忽视:从 Table 1、Table 3 和 Table 4 可以看到,开启完整四机制后,EdgeBench 平均分从 44.833 降至 42.003(-6.3%),Terminal-Bench 4 解决任务数从 18 题降至 15 题(-16.7%)。消融实验表明这一折损主要来自 Online Context Compact。如果团队的核心诉求是最高任务通过率而非极致压缩账单,直接开启
actionFusion + observationPack(即官方推荐的保守配置)是比四机制全开更稳妥的甜点。 - 跨模型迁移存在明显的触发率衰减:由于搜索过程只在 GPT-5.6 Sol 上进行,迁移到 Opus 5 后,尽管最终节省比例相似,但各机制的触发率与触发强度大幅下降(例如 Action Fusion 单任务触发次数从 70.58 降到 13.54)。将这套方案迁移到开源模型或国内模型后端时,需要对
then_run、update_plan和obs_recall的工具描述及触发率重新做一轮校准。 cacheWriteReadRatio = 12.5是静态配置:源码不会根据当前选用的模型动态查询真实的 Cache Write / Cache Read 价格比(例如 Anthropic Claude 与 OpenAI 各模型的缓存定价倍率并不相同)。在生产环境中接入不同厂商模型时,必须手动修正.pi/sol-pi.json中的cacheWriteReadRatio。
- Online Context Compact 的分数折损不可忽视:从 Table 1、Table 3 和 Table 4 可以看到,开启完整四机制后,EdgeBench 平均分从 44.833 降至 42.003(-6.3%),Terminal-Bench 4 解决任务数从 18 题降至 15 题(-16.7%)。消融实验表明这一折损主要来自 Online Context Compact。如果团队的核心诉求是最高任务通过率而非极致压缩账单,直接开启
13.2 源码阅读索引
如果你想在自己的 Agent 框架中复现或移植 SoL-Pi 的四项机制,推荐按以下顺序阅读仓库源码:
- 总入口与配置门禁:
src/sol-pi/index.ts:registerConfiguredFeatures(看清四项机制的注册顺序)与createSolPiExtension。src/sol-pi/config.ts:loadSolPiConfig(受信任项目配置覆盖规则与严格 Schema 校验)。src/sol-pi/runtime-paths.ts:runtimeRoot(会话目录与无会话临时目录派生)。
- Action Fusion(最易优先移植):
src/sol-pi/extensions/action-fusion/index.ts:如何包装内置edit/write工具并注入then_run。src/sol-pi/extensions/action-fusion/then-run.ts:runFusedMutation与assertUnchangedBeforeCommand(双重 SHA-256 校验)。src/sol-pi/extensions/action-fusion/file-queue.ts:withFusedFileQueue与跨平台路径规范化。
- ObservationPack(性价比最高、兼具提分与降本):
src/sol-pi/extensions/observation-pack/observation.ts:createObservation、ensureStored、placeholderFor、readRecallChunk与trimUtf8End。src/sol-pi/extensions/observation-pack/index.ts:obs_recall工具定义与pi.on("context")原地替换逻辑。
- Evidence-Preserving Reducer(学习零幻觉小模型委派):
src/sol-pi/extensions/evidence-preserving-reducer/config.ts:DIAGNOSTIC_COMMAND、FAILURE_SIGNAL与LIKELY_SECRET正则。src/sol-pi/extensions/evidence-preserving-reducer/receipt.ts:reducerInstructions提示词与validateReceipt逐字节校验器。src/sol-pi/extensions/evidence-preserving-reducer/index.ts:reduceToolResult主流程与各分支fallback审计记录。
- Online Context Compact(学习缓存经济学与状态机续跑):
src/sol-pi/extensions/online-context-compact/economics.ts:estimateRemainingRequests与decideCompaction。src/sol-pi/extensions/online-context-compact/projection.ts:estimateProjectedCompactionTokens(如何基于投影层而非原始字节估算可压缩体积)。src/sol-pi/extensions/online-context-compact/extension.ts:turn_end停止、agent_settled压缩与continueParentTask自动续跑状态机。
14. 总结与参考链接
SoL-Pi 在不改动上游 Pi 核心代码的前提下,通过四项正交扩展将长周期 Agent 的记录 Token 流量降低 44.7%–49.0%、API 账单降低约三分之一。其核心方法可以归纳为四条具体的工程实践:用工具 Schema 融合消除可预测的后续轮次,用投影层延迟句柄替换避免大输出反复重放,用逐字节引文核验约束小模型日志提取,用缓存负债盈亏方程管理上下文压缩时机。 对于正在构建 Coding Agent、GUI Agent 或移动端自动化测试系统的团队,按 ObservationPack → Action Fusion → Evidence-Preserving Reducer → Online Context Compact 的顺序逐项引入并对照各自场景的通过率与账单变化,是一条风险可控、收益可度量的落地路径。
参考链接
- 论文主页(arXiv):SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness (arXiv:2609.20519)
- 开源代码仓库:NVlabs/SoL-Pi (GitHub)(本文对应 commit:
21956803) - 官方技术博客:https://nvlabs.github.io/SoL-Pi/
- 上游 Pi 框架拆解:Pi 架构深度拆解:如何用现代 TypeScript 构建高可控的 AI Agent 与 Coding Harness