Harness² 源码拆解:Agent 如何根据执行证据改进自己的运行配置
沿 google-research/harness2 的 Propose–Probe–Compose 调用链,拆解文件化组件、隔离编辑会话、行为对照、两种递归、经验库与评测隔离,并用本地 demo 和论文实验核实其能力与边界。
一个 Agent 跑不好任务,未必是底层模型不会。它可能不知道某个工具该在什么时候调用,可能把本应由脚本完成的计算交给模型心算,也可能在执行成功后从不重新打开交付文件检查。更换系统提示词、补一个按需加载的 skill,或者修掉一段有缺陷的脚本,都可能改变结果。
这些模型之外的配置合起来叫 harness:系统提示词、行为规则、记忆、工具指导、skills、脚本、子代理和运行时插件。以往的调优方式是工程师读失败轨迹、改配置、重跑、比较,再决定留下什么。任务一多,这套手工流程本身就成为瓶颈。
Google Cloud AI Research 与 Northwestern University 的 Harness² 把这套过程做成了可以运行的框架。它不更新模型权重,而是在当前任务上修改 harness、用同一任务试跑候选、对照行为变化,最后把有证据支持的修改经验交给后续任务。
它真正值得看的地方不是“让大模型自我反思”这句概念,而是源码里三件具体的事:把配置变成可收集、可校验的文件;把修改与对应执行记录放在一起;把当前任务的产物选择和长期经验入库分开处理。
下文基于 google-research/harness2 的 1cfe254e8d25(Python 包版本 0.1.0),代码核查时间为 2026 年 10 月 19 日。为区分事实来源,源码行为、本地 demo 结果与作者 benchmark 结果会分别标注。本文没有复跑三套真实模型 benchmark,也不把 demo 的确定性编辑器当成模型能力证明。
目录
- 两层递归:改执行配置,也积累改进经验
- 先看可运行 demo:一处脚本错误怎样被修掉
- 代码架构:改进方法、执行器与任务适配分离
- 组件文件树:Agent 能改的不只是 Prompt
- 编辑会话:文件如何真正离开临时工作区
- 证据树:怎样把轨迹交给另一个 Agent 阅读
- Propose–Probe–Compose:行为对照而非答案反思
- Parallel 与 Sequential:预算花在宽度还是深度
- 选择产物与提炼经验:两个不同的问题
- 跨任务经验:不是把上次的配置原样带过来
- 评测隔离与失败恢复:论文可信度落在代码哪里
- 实验结果、成本与可能被高估的部分
- 对 GUI Agent 与 APP 自动化测试的启发
- 源码阅读顺序与总结
1. 两层递归:改执行配置,也积累改进经验
Harness² 的“平方”不是指模型自我调用两次,而是两个相互连接、状态不同的更新过程。
任务级递归(task-level recursion) 针对当前任务:先运行基础配置,产生参考轨迹;编辑 Agent 提出候选配置;框架试跑候选;组合 Agent 读取差异和轨迹,生成下一份配置。它的产物是本次任务采用的执行 harness 和对应交付物。
改进级递归(harnessing-level recursion) 针对后续任务:本次改进结束后,系统审视全部候选、试跑与采用记录,保存有行为证据的经验和被采用的完整 harness。下一项任务仍然从公共基础配置开始,但这些历史记录会进入新的改进会话,影响它如何提出和组合修改。
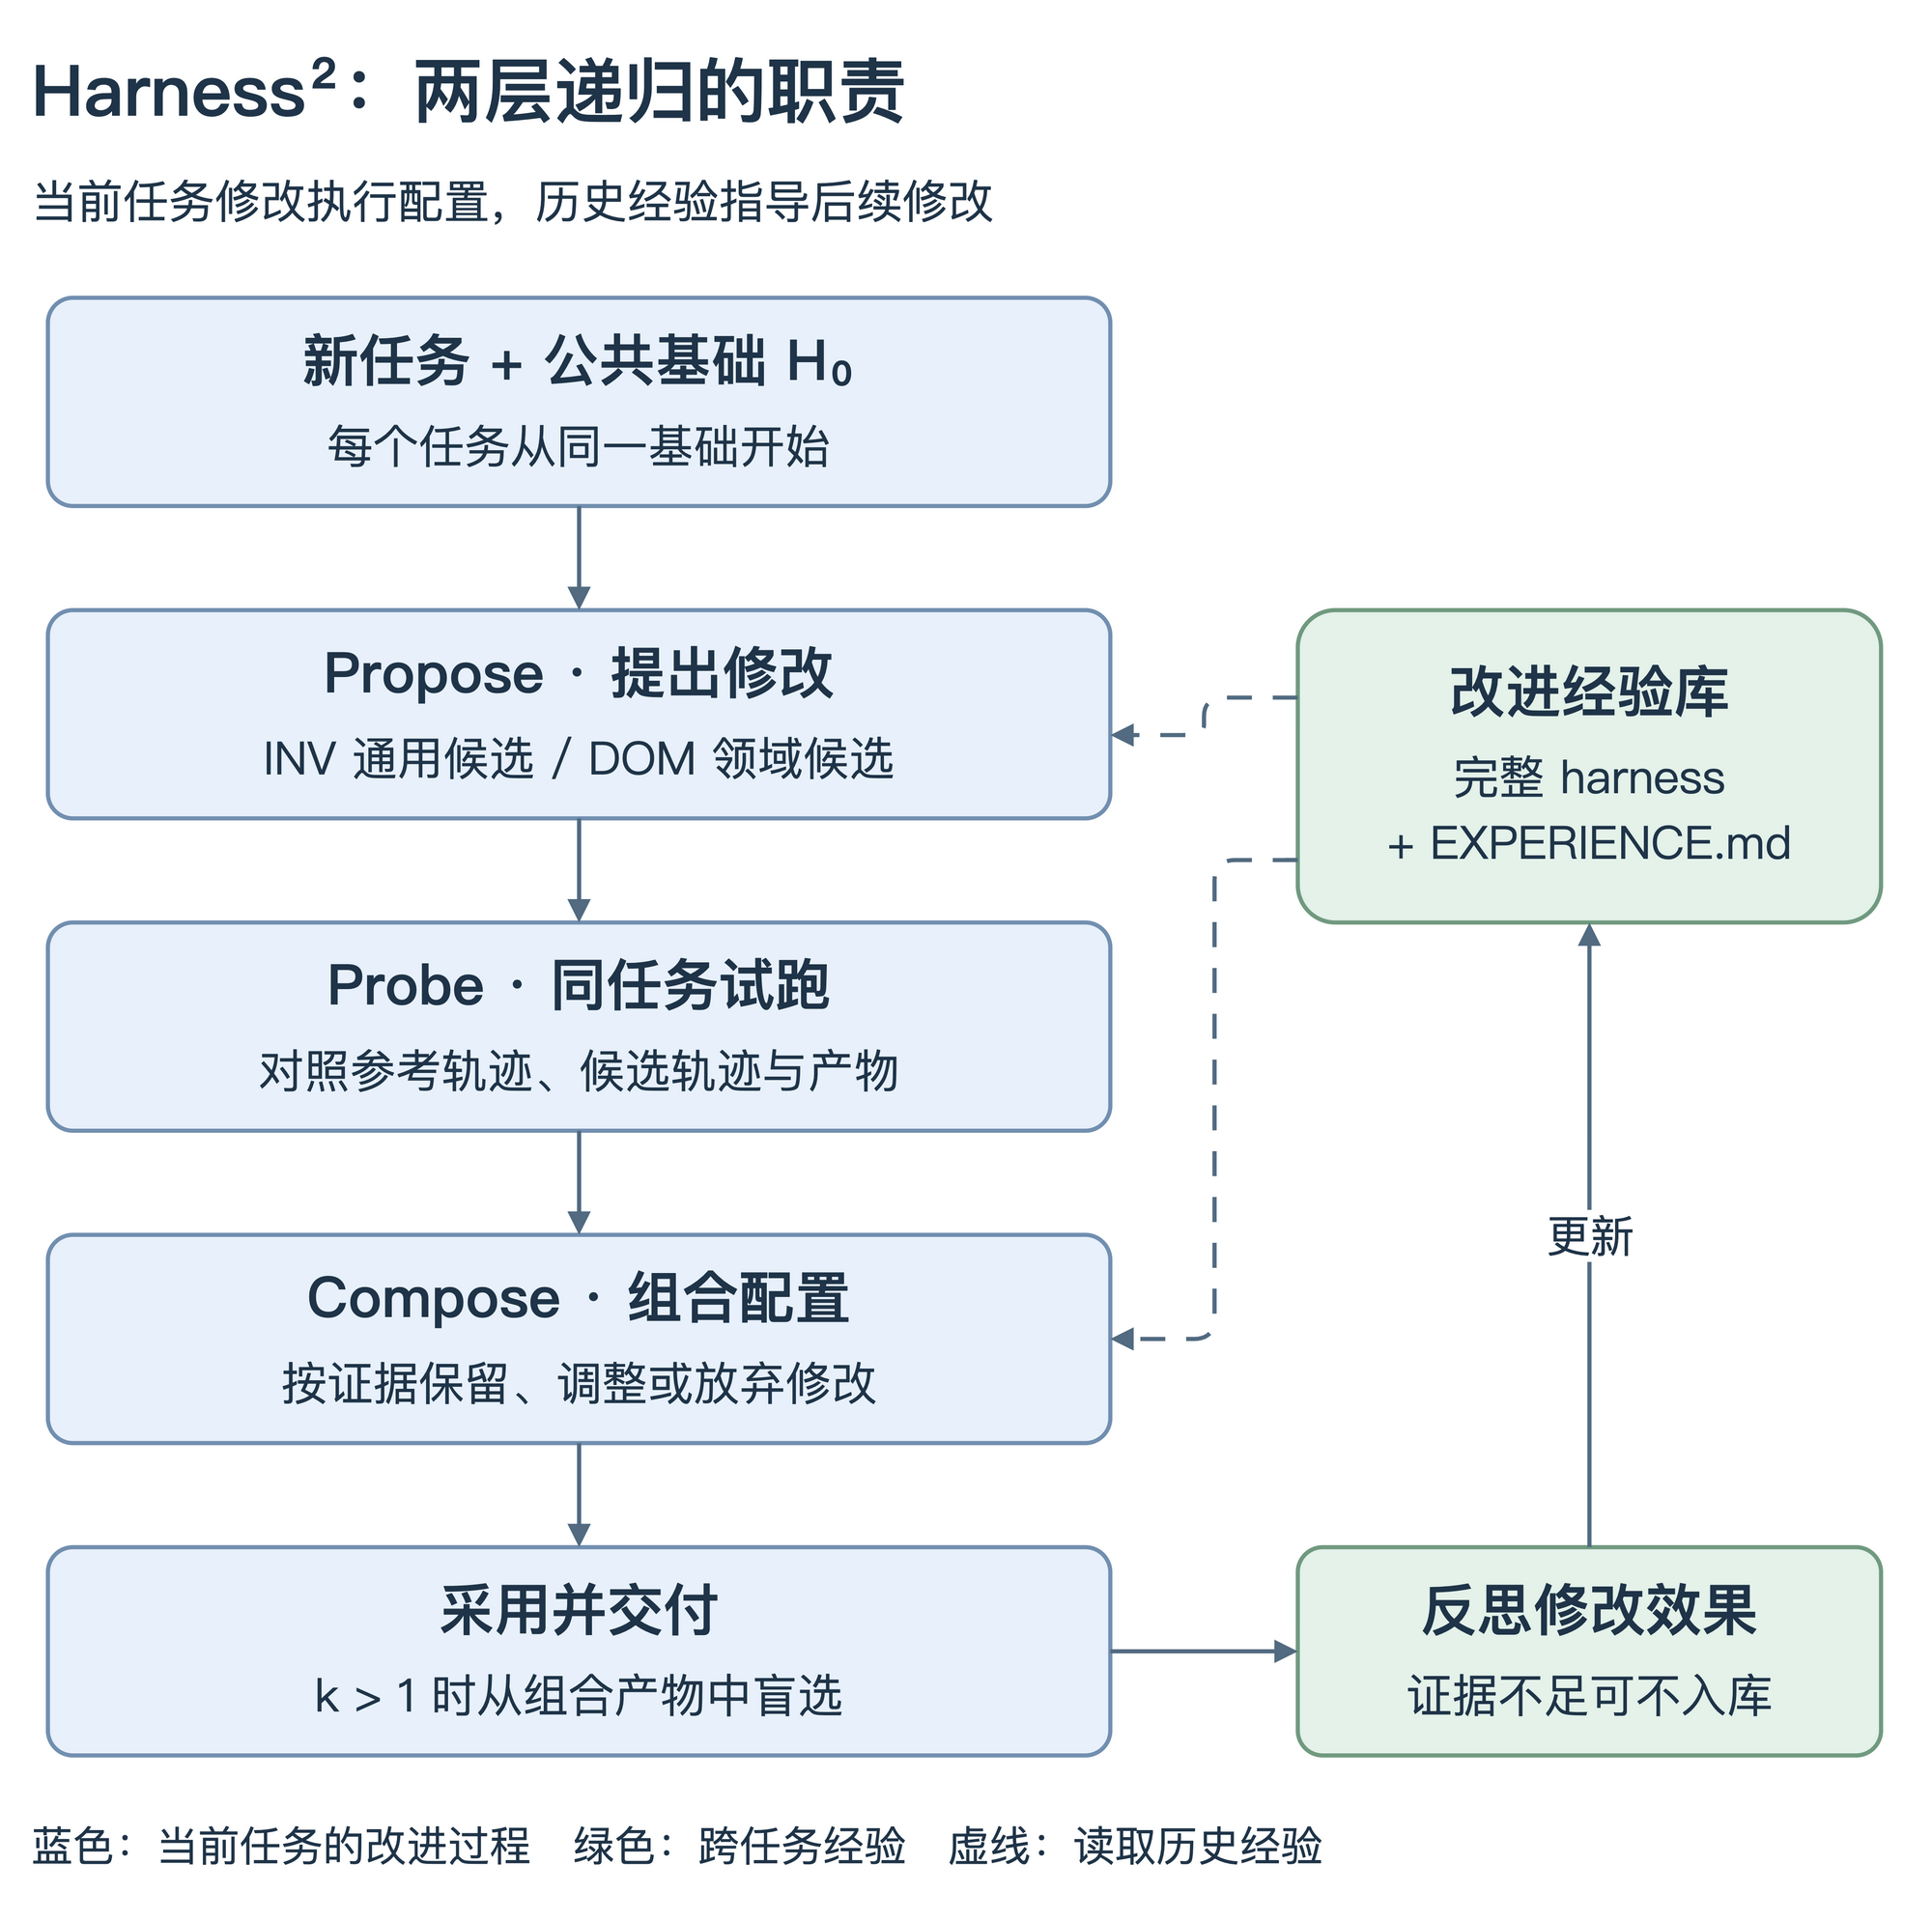
这张图里最容易被忽略的是两个“当前”不是一回事。执行 harness 决定本次任务怎么做;改进 harness 决定系统如何诊断、修改和评价这套执行配置。论文的递归性来自第二层也持续更新,而不是简单地让 Agent 多回答几遍。
作者原图把这两个过程画在了一起:
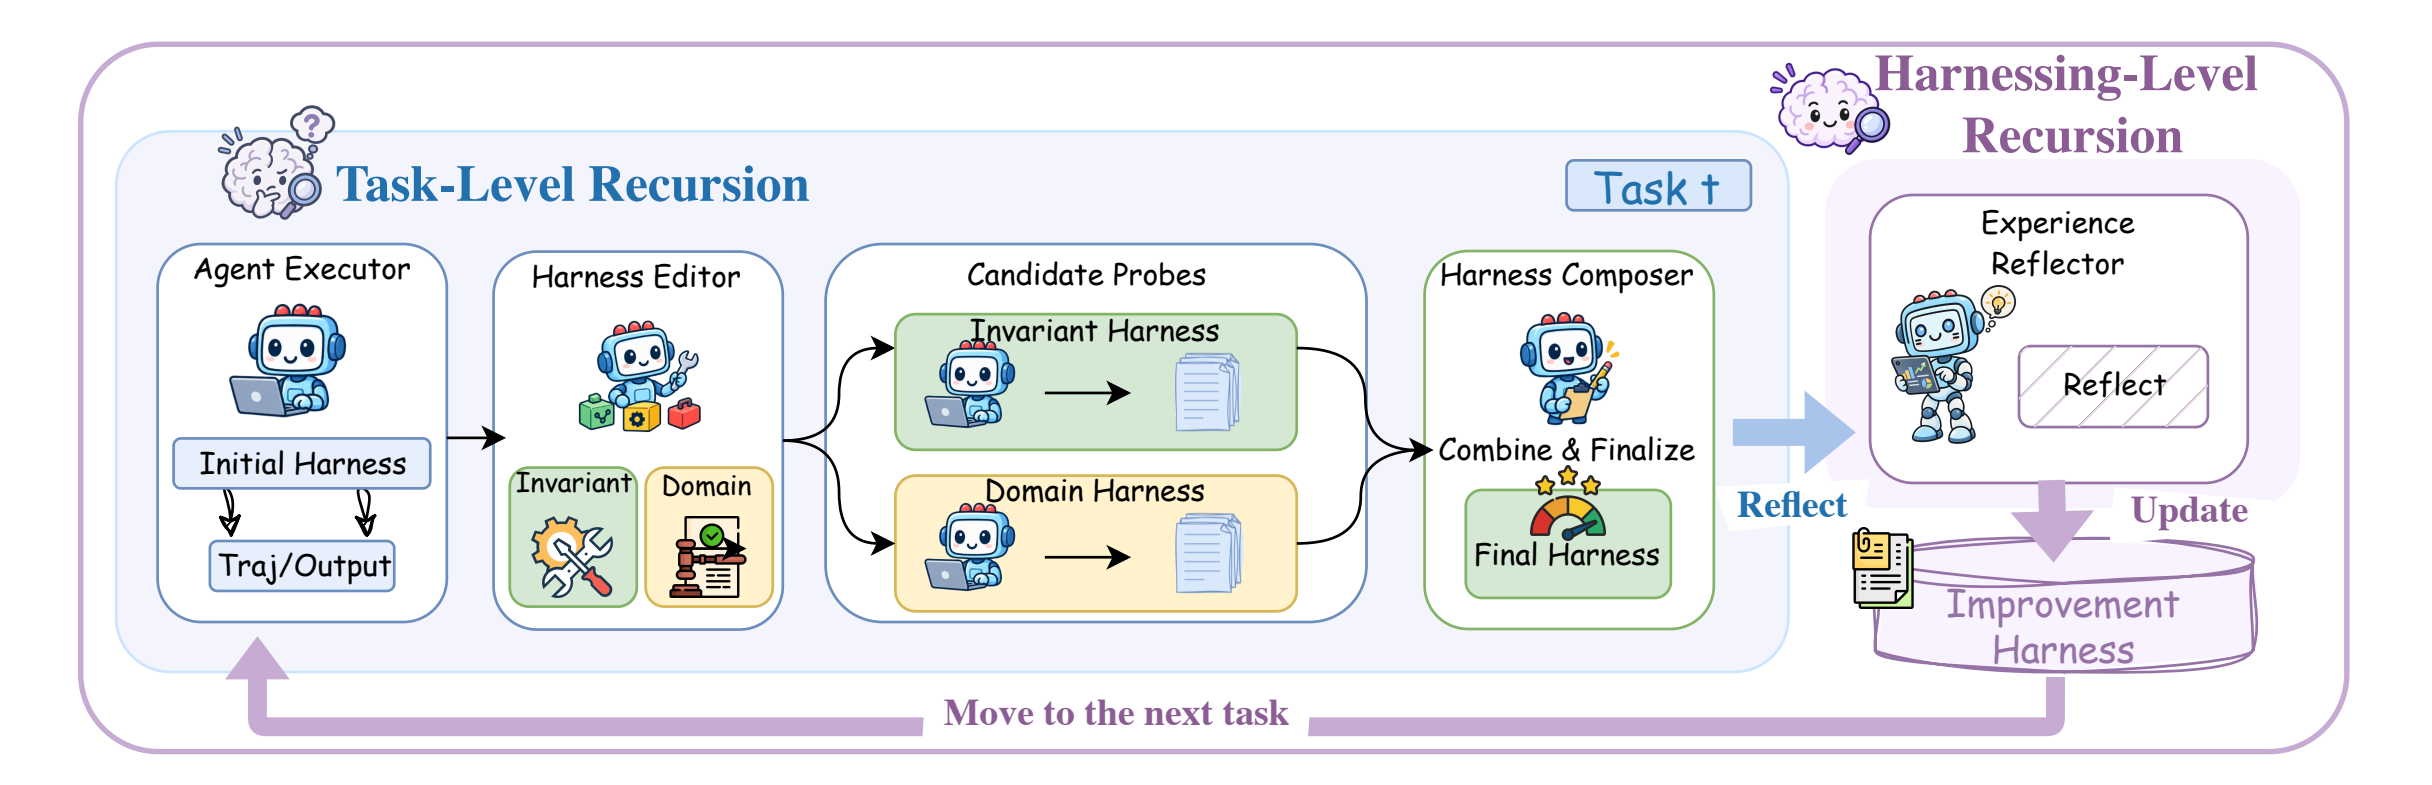

蓝色区域完成当前任务的改进;右侧 Experience Reflector 在任务结束后更新经验库。底部返回后续任务的箭头不表示“把上次的执行环境继续运行”,而是表示新的 Propose 和 Compose 可以读取过去的经验与组件。
这项区分在工程上很重要。把上一个任务的整份系统提示词拼接给下一个任务,往往会积累相互冲突的规则;Harness² 则把“用于执行的配置”和“用于指导修改的资料”分开存放。
2. 先看可运行 demo:一处脚本错误怎样被修掉
仓库的 harness2/demo.py 提供了一个不需要模型凭据的完整示例。任务很简单:读取 CSV,对所有带符号金额求和。第一项账本包含:
100.25
-20.10
5.00
基础 harness 中有一段真实的 Python 脚本 BASE_SCRIPT,关键的一行故意漏掉了负数:
total = sum((amount for amount in amounts if amount > 0), Decimal(0))因此基础执行得到 105.25,而正确结果是 85.15。
demo 中的编辑器会把 " if amount > 0" 从脚本中删除。框架随后使用真正的 subprocess.run() 执行修改后的 summarize.py,得到新的输出和轨迹,再让组合阶段读取“原配置 / 候选配置 / 两边执行”这些材料。最终的 Library 会保存修改后的脚本及一条经验:遇到同时有借贷金额的账本,求和脚本不能只累计正数。
这次本地验证使用 k=2,两种递归模式各运行一遍,结果如下:
| 检查项 | 本地 demo 结果 |
|---|---|
| 两项任务 | 均完成,0 项失败 |
ledger-1 采用产物 | parallel 与 sequential 均为 Total: 85.15 |
ledger-2 采用产物 | 两种模式均为 Total: 20.25 |
| 每个任务、每种模式 | 8 次执行、6 个改进阶段 |
| 两个任务的真实 Python 执行总数 | 28 次,两模式共享基础执行 |
| 第二个任务开始前经验库 | 两种模式各有 1 条经验 |
| 工作流回归测试 | 5 项通过 |
但这个 demo 只能证明调度、执行、文件收集、预算、选择、反思、入库和恢复这些接口能够串起来。DemoProposer 是预写的字符串编辑器,选择器也会直接计算正确答案,再寻找匹配的候选。它没有证明模型能独立发现负数漏算,更不能代替论文中真实模型的实验。
这个区别必须先说清,否则很容易把“仓库能跑通”误读成“Agent 已经会自我改进”。
3. 代码架构:改进方法、执行器与任务适配分离
沿一条任务的调用链读代码,比按目录逐个浏览更容易理解:
CLI 确定任务、执行器、k 和运行目录
  → schedule.run_sweep / run_domain / run_task
  → 先取得 k 次公共基础执行
  → recursion.run_parallel 或 run_sequential
  → context.build 准备证据,Proposer 编辑 harness
  → BenchmarkAdapter.execute 执行候选
  → selection 采用一份已有产物
  → reflection / Library 保存经验

独立的 judge / report 在采用之后评分与汇总
core/spec.py 的模块注释直接说明三条分离的轴:method、substrate、benchmark。用工程语言解释,就是:
| 层次 | 负责什么 | 主要实现 |
|---|---|---|
| 改进方法 | 候选生成、试跑、组合、选择、经验更新 | core/recursion.py、schedule.py |
| Substrate | 可编辑文件布局、安装方式、CLI 启动、轨迹转换 | substrate/opencode.py、codex.py |
| BenchmarkAdapter | 任务材料、基础配置、执行、交付物读取、评分接口 | core/spec.py、benchmarks/ |
BenchmarkAdapter 最有价值的一点,是把“执行一次”与“评价这次执行”拆成了两个协议。下面是从接口定义中摘出的核心约定:
def execute(self, task_id, harness_dir, run_id, *, timeout=None) -> Path:
    """Run one rollout and return its run directory, idempotently by run_id."""

def trajectory(self, run_dir, *, obs_trunc: int) -> str:
    """Readable trajectory in the shared [ACTION]/[OBSERVATION]/[ERROR] grammar."""

def score(self, run_dir: Path, task_id: str) -> dict | None:
    """Called only by core.judge, only after selection committed."""
execute() 只负责返回运行目录;trajectory() 和 deliverable_text() 把执行结果转换成可读证据;score() 留给之后的评测模块。
“即插即用”因此有明确前提:接入一个新环境时,你仍要实现这些接口。候选配置如何进入隔离环境、失败如何恢复、产物如何转成文本、轨迹如何统一格式,不能靠一段通用 Prompt 自动解决。
当前仓库支持 OpenCode 和 Codex 两种执行器,以及 JobBench、LAB、WorkBuddy-Bench 三套任务适配。它不是通用的手机或 GUI 自动化执行器,后文讨论移动端应用时属于工程设计迁移,不是现有功能清单。
4. 组件文件树:Agent 能改的不只是 Prompt
很多“自我改进”系统的输出是一段建议文本,真正运行时并没有一个可装载的新对象。Harness² 不同:候选 harness 是一个文件树,内存表示甚至是相当朴素的字典:
# core/tree.py
Tree = dict[str, str]  # 相对路径 -> 文件内容
SurfaceSpec 和这组路径规则限定了哪些文件会被接受进候选 harness;它不是编辑会话的文件系统权限边界,越界文件会在回收后被拒绝。OpenCode 下的主要职责如下:
| 组件 | 文件或目录 | 什么时候发挥作用 |
|---|---|---|
| 系统提示词 | systemprompt.md | 常驻上下文,定义角色与基础流程 |
| 行为规则 | guardrails.md | 常驻约束与触发条件 |
| 长期记忆 | LongTermMEMORY.md | 执行期间读取的领域知识 |
| 工具指导 | tool_descriptions/tool_guidance.md | 何时以及如何使用工具 |
| Skills | skills/<name>/SKILL.md | 满足触发条件时按需加载流程 |
| 子代理 | sub_agents/<name>/AGENT.md | 将工作委派给指定角色 |
| 脚本 | scripts/<name>.py | 通过真实执行完成确定性处理 |
| 运行时插件 | plugin/<name>.ts | 在工具循环中介入调用与结果 |
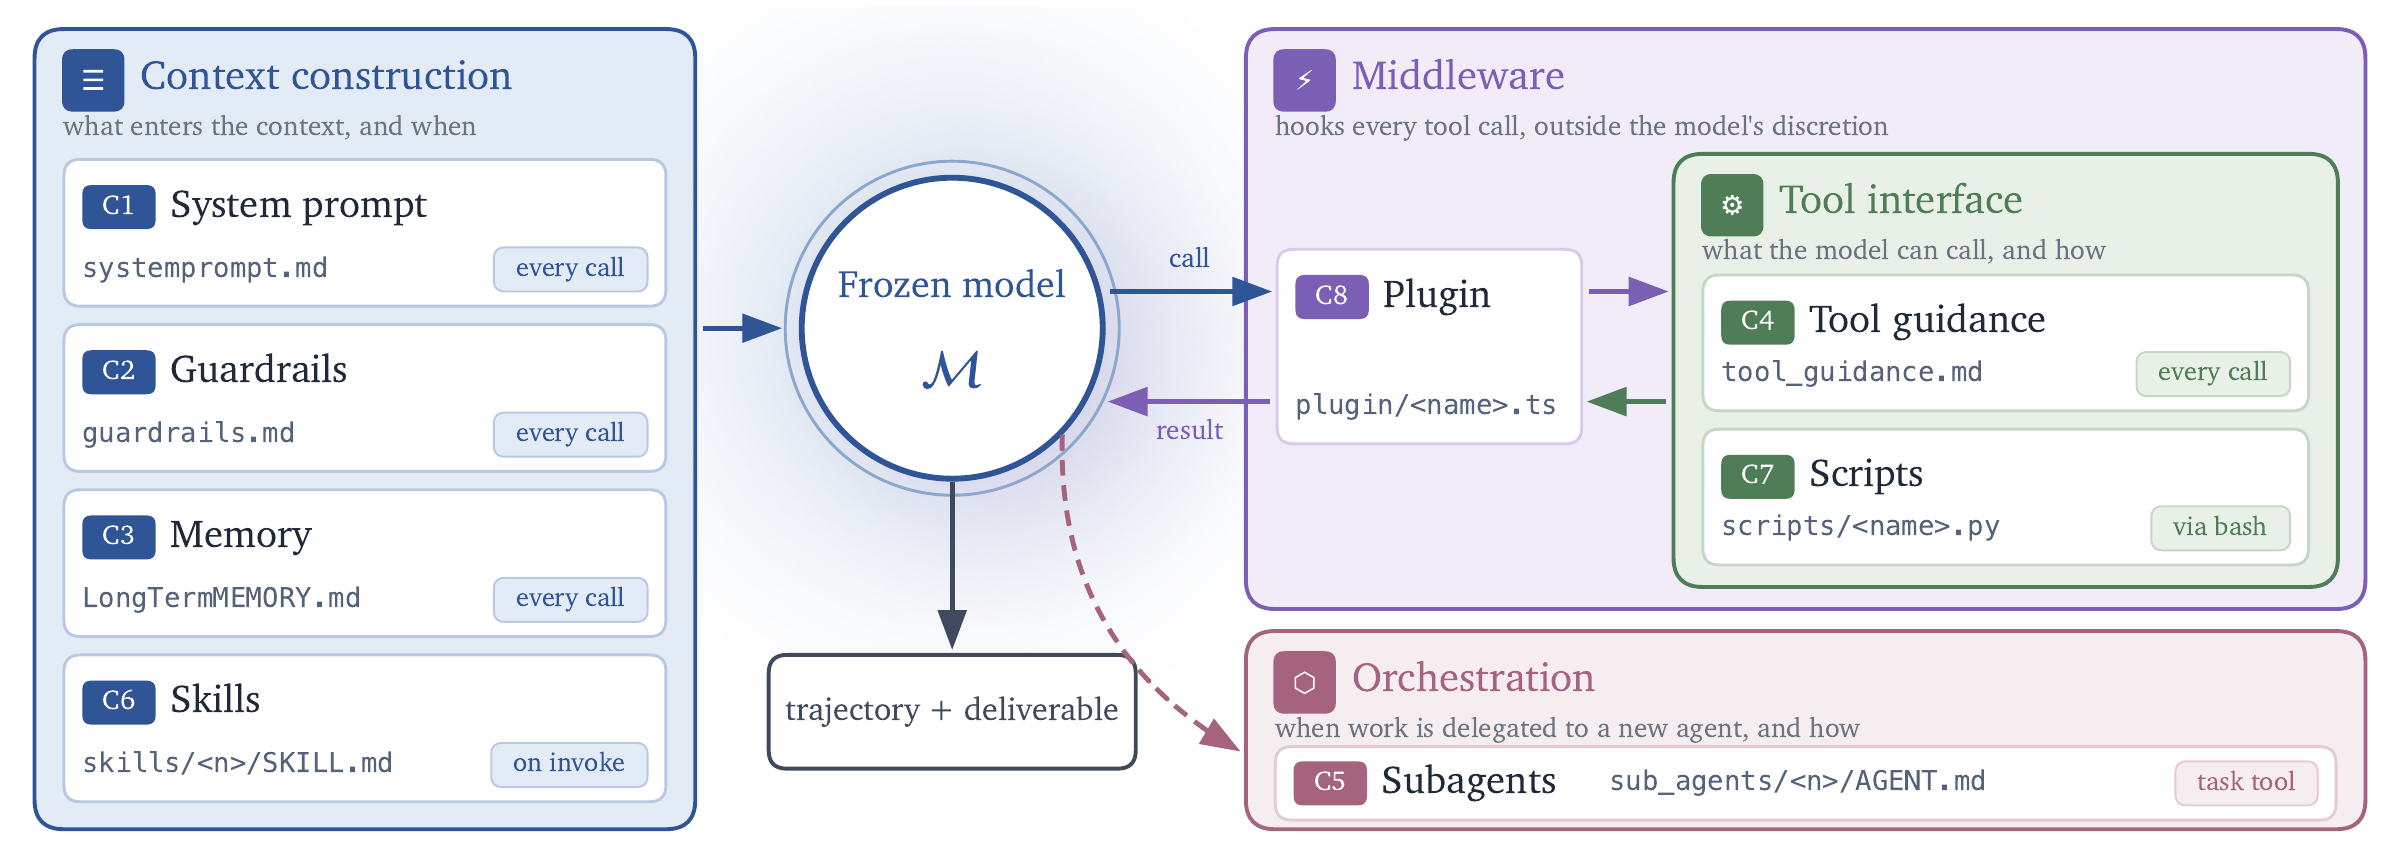

组件放在哪里,决定了它何时生效以及占用多少上下文。把一套十几步的核对流程写进系统提示词,它会一直消耗注意力;写成有明确触发条件的 skill,则可以按需加载;写成 Python 脚本,则由确定性程序接管一部分工作。插件更适合处理“每次工具调用前后都需要检查”的问题。
这套接口也提醒读者:记忆有两种角色。 LongTermMEMORY.md 属于执行 harness,会参与求解任务;后面的 improvement library 属于改进 harness,指导编辑器如何修改配置。把两者混成“Agent Memory”会看不清递归发生在哪里。
4.1 文件树不是任意目录,而是受约束的 SurfaceSpec
不同执行器的物理布局不同。Codex 把常驻文本集中到 AGENTS.md,skills 放在 .agents/skills/,运行时介入通过 .codex/hooks.json 表达。框架用 SurfaceSpec 描述这些差异,而不是在递归算法里写两套分支。
当前版本还规定了编辑预算:OpenCode 常驻文本上限为 24,000 个字符,Codex 为 8,000 个字符。这是 Harness² 自己的编辑约束,不能当成两个工具的通用上下文窗口上限。
tree.validate() 会在配置执行前检查:
- 路径是否越界,是否存在绝对路径或
..路径逃逸; - 常驻文本是否超出预算;
- skill 的 frontmatter、目录名、描述和触发条件是否完整;
- 子代理是否被当前部署允许,角色格式是否符合要求;
- Python 脚本能否编译,被引用的脚本是否随配置提供;
- Codex hooks 是否符合当前事件和命令 schema;
- benchmark 适配器自己的额外不变量是否满足。
还有一处容易被“生成了 skill 文件”掩盖的问题:skill 必须被触发。autotrigger() 会尝试在常驻文本中补上命名该 skill 的规则;如果预算不足,补写会跳过,后续校验仍可能拒绝这个永远不会被调用的 skill。
这些检查只能保证“配置可以装载”,不能保证“业务逻辑正确”。正确性仍然要看试跑证据与后续评价。
5. 编辑会话:文件如何真正离开临时工作区
Propose 不是直接调用一次聊天接口,再把返回的文本写入文件。core/proposer.py 为编辑会话建立了临时工作目录,把证据复制进去,模型在其中通过工具读取和修改文件。
下面的伪代码对应 Proposer.call() 的实际顺序:
tmp = Path(tempfile.mkdtemp(prefix="harness2-prop-"))
try:
    shutil.copytree(context_dir, tmp / "context")
    text, cost, err = run_model_session(tmp, mission)
    reply.workspace = self._harvest(tmp, "context/harness", label, cache_key)
    # 临时目录销毁前,只把编辑后的 harness 持久化
finally:
    shutil.rmtree(tmp, ignore_errors=True)
关键操作是 _harvest():在临时目录被删除前,将 context/harness 拷贝到持久的审计目录。递归层拿到的是实际文件,不是模型口头声称的修改摘要。
OpenCode 改进通道还设置了自己的工作目录权限和 XDG_DATA_HOME / XDG_STATE_HOME,避免多个编辑会话共享本地会话状态。审计目录保存 mission、response、meta 与回收的 workspace;调用方传入非空 system 时还会另存 system,因此可以事后核对模型调用看到了什么、写了什么。
拿到文件后,_run_stage() 还会做一次白名单读取:surface 之外的文件不会被悄悄安装,而是变成具体的拒绝原因。无效提案可以把错误反馈给编辑器再试一次:
reply = prop.call(
    mission + "\n\n# YOUR PREVIOUS ATTEMPT WAS REJECTED\n\n" + err,
    tree.root,
    f"{label}.a{attempt}",
    harvest="context/harness",
)
如果第二次仍失败,该阶段继承当前 harness,并记录 fell_back=True 与错误信息。这里要区分两种重试:传输层失败由 Proposer 的信道重试处理;文件为空、路径越界或校验失败,才进入上述“带具体错误再编辑一次”的逻辑。
失败后的继承不是“修改成功”,后续账本仍如实记录这次回退。对长时间运行、模型输出不稳定的系统来说,这层失败处理比一张漂亮的流程图更能决定可用性。
6. 证据树:怎样把轨迹交给另一个 Agent 阅读
一个长任务可能产生大量工具输出、网页内容、源文件和交付物。如果把所有内容塞进一条 Prompt,模型还没开始诊断,上下文就已经失控。
Harness² 的 context.build() 选择把证据整理成目录,让编辑 Agent 按需打开。典型结构如下:
context/
  task.md                   当前任务原文
  source/                   去除答案路径后的源材料
  harness/                  本次允许编辑的组件树
  rollouts/                 基础执行轨迹
  deliverables/             基础执行产物
  pool/<label>/
    harness/                某个候选的完整配置
    harness.diff            候选相对当前配置的 unified diff
    rollout.md              候选的试跑轨迹
    produced.md             候选产物的可读表示
  decisions/                已有修改与组合决策
  library/                  当前领域可用的历史经验
完整 mission 由 Propose 或 Compose 的任务提示和证据指针组成;证据指针主要说明文件位置与阅读纪律,具体编辑要求仍写在任务提示中。例如,每一处修改都应能指向某一次执行中的具体时刻;找不到对应行为的“最佳实践”,只能算猜测。
这里的“按需读取”并不等于所有内容都无限制。轨迹按单条 observation 截断后整体写入证据文件;这里的“完整”指不为塞进 mission 再裁剪,适配器仍设有整轨迹字符上限。BenchSpec 还拒绝把 obs_trunc 设得低于 10,000 个字符,代码注释给出的理由很直接:过短的观测会人为制造缺陷,让编辑器把“没看见”误诊为“没执行”。
交付物也有两种呈现方式:
contents:提供从产物提取出的文本,以及由适配器明确列出的附件;names:只提供文件清单,编辑器根据轨迹和文件是否缺失做判断。
names 并不只是为了省 token。仓库注释记录过一次实际问题:某些任务的交付物与 grader 输出放在同一个目录里,读取整个目录会把通过率和失败检查项一起带给编辑器。于是代码禁止目录扫描,要求适配器显式给出允许读取的文件。
这套证据树是 Harness² 很实在的一项工程贡献:让“配置差异”和“行为差异”成为两个可以并排打开的文件对象。 没有这层组织,所谓对照实验往往只剩模型对两段摘要的印象比较。
7. Propose–Probe–Compose:行为对照而非答案反思
三个阶段对应三个不同的责任,不能合并成一句“模型自我优化”。
7.1 Propose:通用问题与领域问题分开看
每个改进阶段分别提出两类候选:
- INV(invariant / 通用行为):规划、工具调用、上下文管理、完成检查和委派等跨领域问题;
- DOM(domain-specific / 领域):当前职业、文档类型或业务环境所需的知识、程序和约束。
例如,一份财务材料没有完成核对,INV 候选可能增加“盘点全部输入文件,并在交付前重新打开产物”的通用流程;DOM 候选则可能补充“不同表中的预算口径怎样对应”的专业知识。
分开的意义不是多生成一份答案,而是让修改假设更明确。通用流程不应塞入某个任务的专业事实,领域知识也不应代替工具错误处理。当前代码通过提示词约束这条边界,并没有在文件校验器中自动判定一段文本究竟属于 INV 还是 DOM。
propose() 给出了修改优先级:
- 基础执行之间出现分歧,说明模型至少在某次运行中展现过目标行为;
- 多次执行重复出现同一个具体错误;
- 轨迹已经暴露、但尚未真正发生的风险。
这个顺序避免了“一上来自我反思就重写整个系统提示词”。如果同一个 Agent 有时能完成某个步骤、有时不能,先把成功行为稳定下来,通常比新增一套复杂流程更有依据。
7.2 Probe:修改后的配置要真的执行
recursion._roll() 会把候选文件树物化,再交给适配器执行:
hdir = harness_tree.write_tree(surface, tree, work_dir / "harnesses" / label)
rd = adapter.execute(task_id, hdir, run_id)
rv = RunView(label=label, run_id=run_id, run_dir=rd, ...)
这里的 RunView 记录标签、运行目录、完成状态、交付状态和错误等执行元信息,不携带分数;它虽然定义了 cost_usd 和 wall_s 字段,但当前构造路径尚未实际填充这两个值。
Probe 的结果是行为证据,不是正确性证明。候选只试跑一次时,它可能遇到随机波动;基础和候选又共享模型偏差。一次候选输出更好,不能直接推出“每一处修改都有效”。
7.3 Compose:读取差异和轨迹,保留、修改或放弃
组合阶段同时读取基础执行、候选 harness、harness.diff、试跑轨迹和产物。它可以把 INV 与 DOM 中各自有依据的修改合并,可以改写冲突,可以完整采用一个候选,也可以保持当前配置。
aggregate() 对证据强度有明确提醒:
Agreement is support, not independent proof.
意思是多个候选得出相似结果只能提供支持,不能当成独立证明,因为它们可能共享同一模型的偏差。提示词还要求:如果某项修改关联的试跑没有交付物,必须在 notes 中说明;除非其他证据非常强,否则把它视为不安全。
组合后的配置也会再执行一次。因此进入最终候选池的,不是一段“理论上应该更好”的配置文本,而是一份已经有执行记录的 harness。
账本 demo 可以把这条证据链压缩成四行:
| 观察对象 | 能支持的判断 |
|---|---|
原脚本含 if amount > 0 | 存在排除负数的具体机制 |
基础输出 105.25 | 本次执行出现了漏算后果 |
| 候选删除过滤条件 | 修改确实落到可执行脚本 |
候选输出 85.15 | 本次行为变化与修改方向一致 |
真实模型任务远比这个例子复杂,但阅读源码时应始终追问这四类证据是否齐全。
8. Parallel 与 Sequential:预算花在宽度还是深度
两种模式都从同一个公共基础配置开始,并先获得 k 次基础执行。区别是候选之间是否存在继承关系。
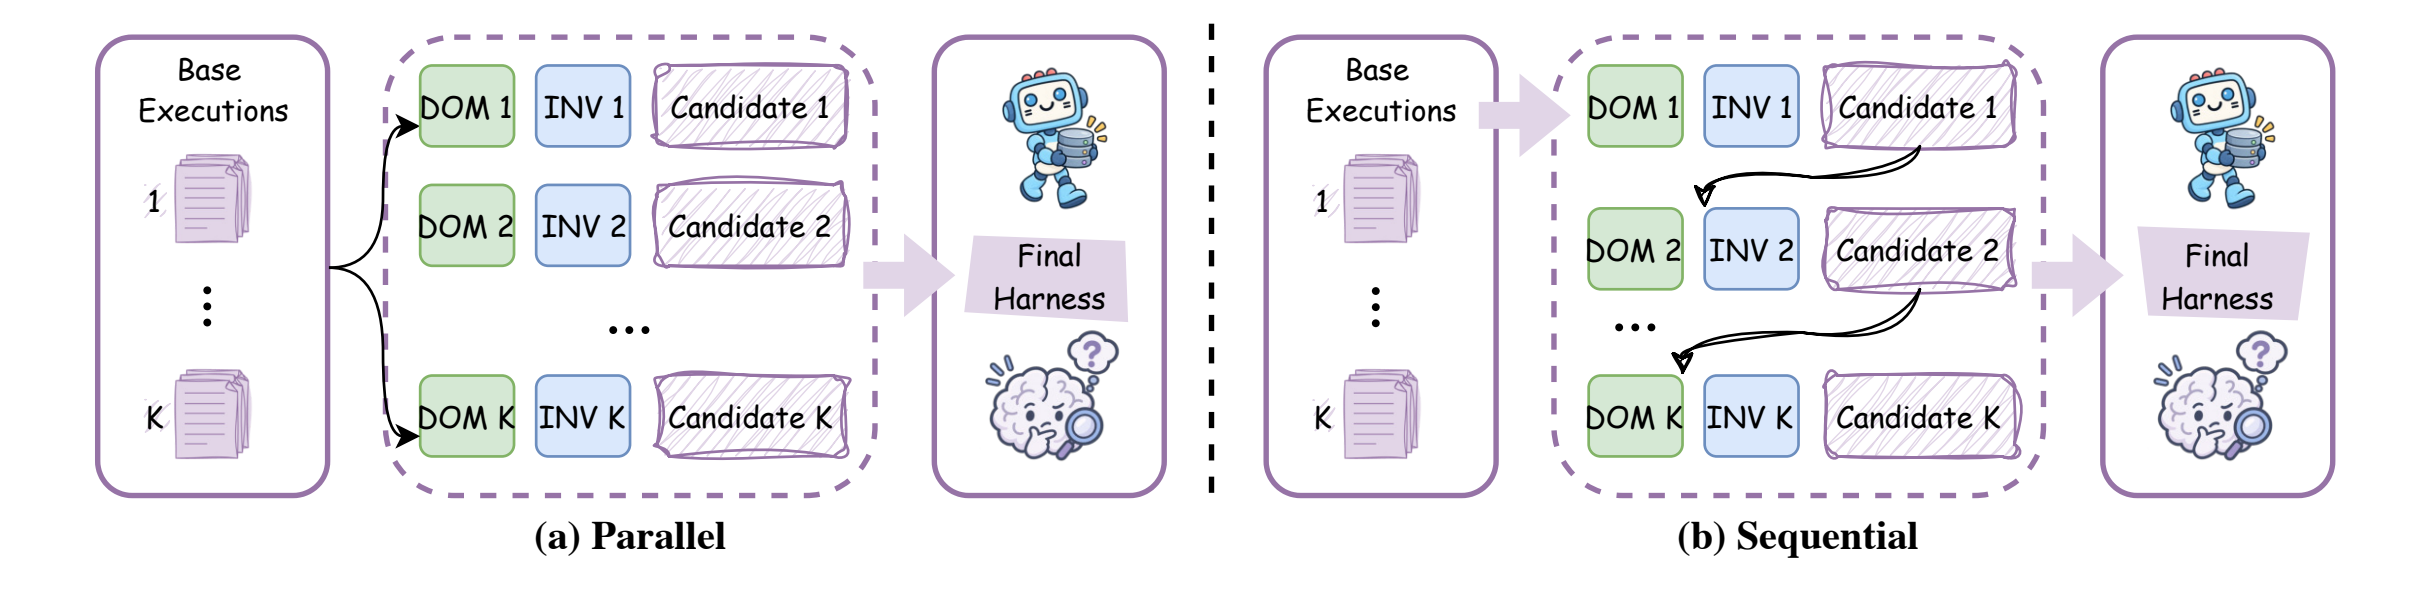

8.1 Parallel:一轮群体探索
run_parallel() 的顺序是:
- 从相同的基础执行出发,独立生成
k份 INV 与k份 DOM,共2k份候选; - 等全部候选生成后,各自试跑一次;
- 启动
k个相互独立的组合会话,每个都读取完整候选池; - 执行每份组合结果,得到
agg1 … aggk。
代码中的 specs 是 inv1, dom1, inv2, dom2, …。组合会话在提案和候选试跑全部结束后才开始,存在明确的阶段 barrier。
当前实现只做一轮这样的群体更新。把 k 从 1 调到 5,是增加探索宽度,不是连续做五轮改进。
8.2 Sequential:每轮修改上一轮的 checkpoint
run_sequential() 每一轮都有两份提案、两次试跑、一次组合和组合后的执行。状态传递就在这一行:
current_harness = comp.tree因此第二轮的“保持基础”指保持当前 checkpoint,不会退回最初的公共基础。历史池不断加入早先候选、组合配置及其轨迹,上一轮 checkpoint 的执行是当前轮的在策略证据。
最终候选池包含 c1 … ck,所以系统允许选择较早的一轮,并不预设“最后一轮最好”。不过组合提示词和单次试跑都不能提供严格保证,后文的最终选择池还有一个更具体的限制。
8.3 同样的 k,怎样的成本
core/ledger.py 把预算写成可断言的恒等式:
其中 R 是任务执行次数,P 是改进阶段数:
| k | 任务执行 R | 改进阶段 P | 最终选择 |
|---|---|---|---|
| 1 | 4 | 3 | 跳过,直接采用唯一组合产物 |
| 2 | 8 | 6 | 从两份组合产物中选择 |
| 5 | 20 | 15 | 从五份组合产物中选择 |
这不等于全部系统成本。编辑阶段的重试、选择和反思不在 P 中,一次执行或编辑会话也可能包含许多模型调用与工具操作。
如果同一命令同时比较两种模式,它们共享基础执行;不能把两份 R=4k 直接相加当成实际执行总数。demo 的两项任务在 k=2 下真实执行 28 次,而不是 32 次,原因就在这里。
9. 选择产物与提炼经验:两个不同的问题
假设组合阶段得到五份产物,系统还需要决定交付哪一份。k>1 时,选择器看到任务、源材料和匿名化的候选产物,不看到候选对应的 harness。匿名 ID 通过任务、k 和模式计算出的稳定种子打乱,重跑时可以复现。
选择器只能提交一个已有结果,不能在这个阶段再综合重写一份答案。它负责的是采用哪份交付物,不是评价哪一处配置修改在因果上有效。
9.1 发布版的选择池不包含参考执行
selection_pool() 中有一行很能说明设计边界:
del base # base 被有意排除;当前 release 只构造 finals 池也就是说,最终池只包含组合阶段的 agg1 … aggk 或 c1 … ck,不包含最初的 base1 … basek。这带来两个后果:
- Compose 可以保持当前配置,但最终选择器不能在参考执行和组合产物之间做全量择优;
k=1时没有额外盲选检查,直接采用唯一的组合产物。
因此,源码没有保证最终结果一定不差于基础执行。“匿名选择”减少的是对候选来源的偏好,不是对任务正确性的自动证明。
9.2 反思要读所有候选,而不是只读赢家
采用之后,reflect_adoption() 准备完整改进记录,experience() 要求逐项检查组件修改,并给出四类判断:helped、hurt、no observed effect、confounded。
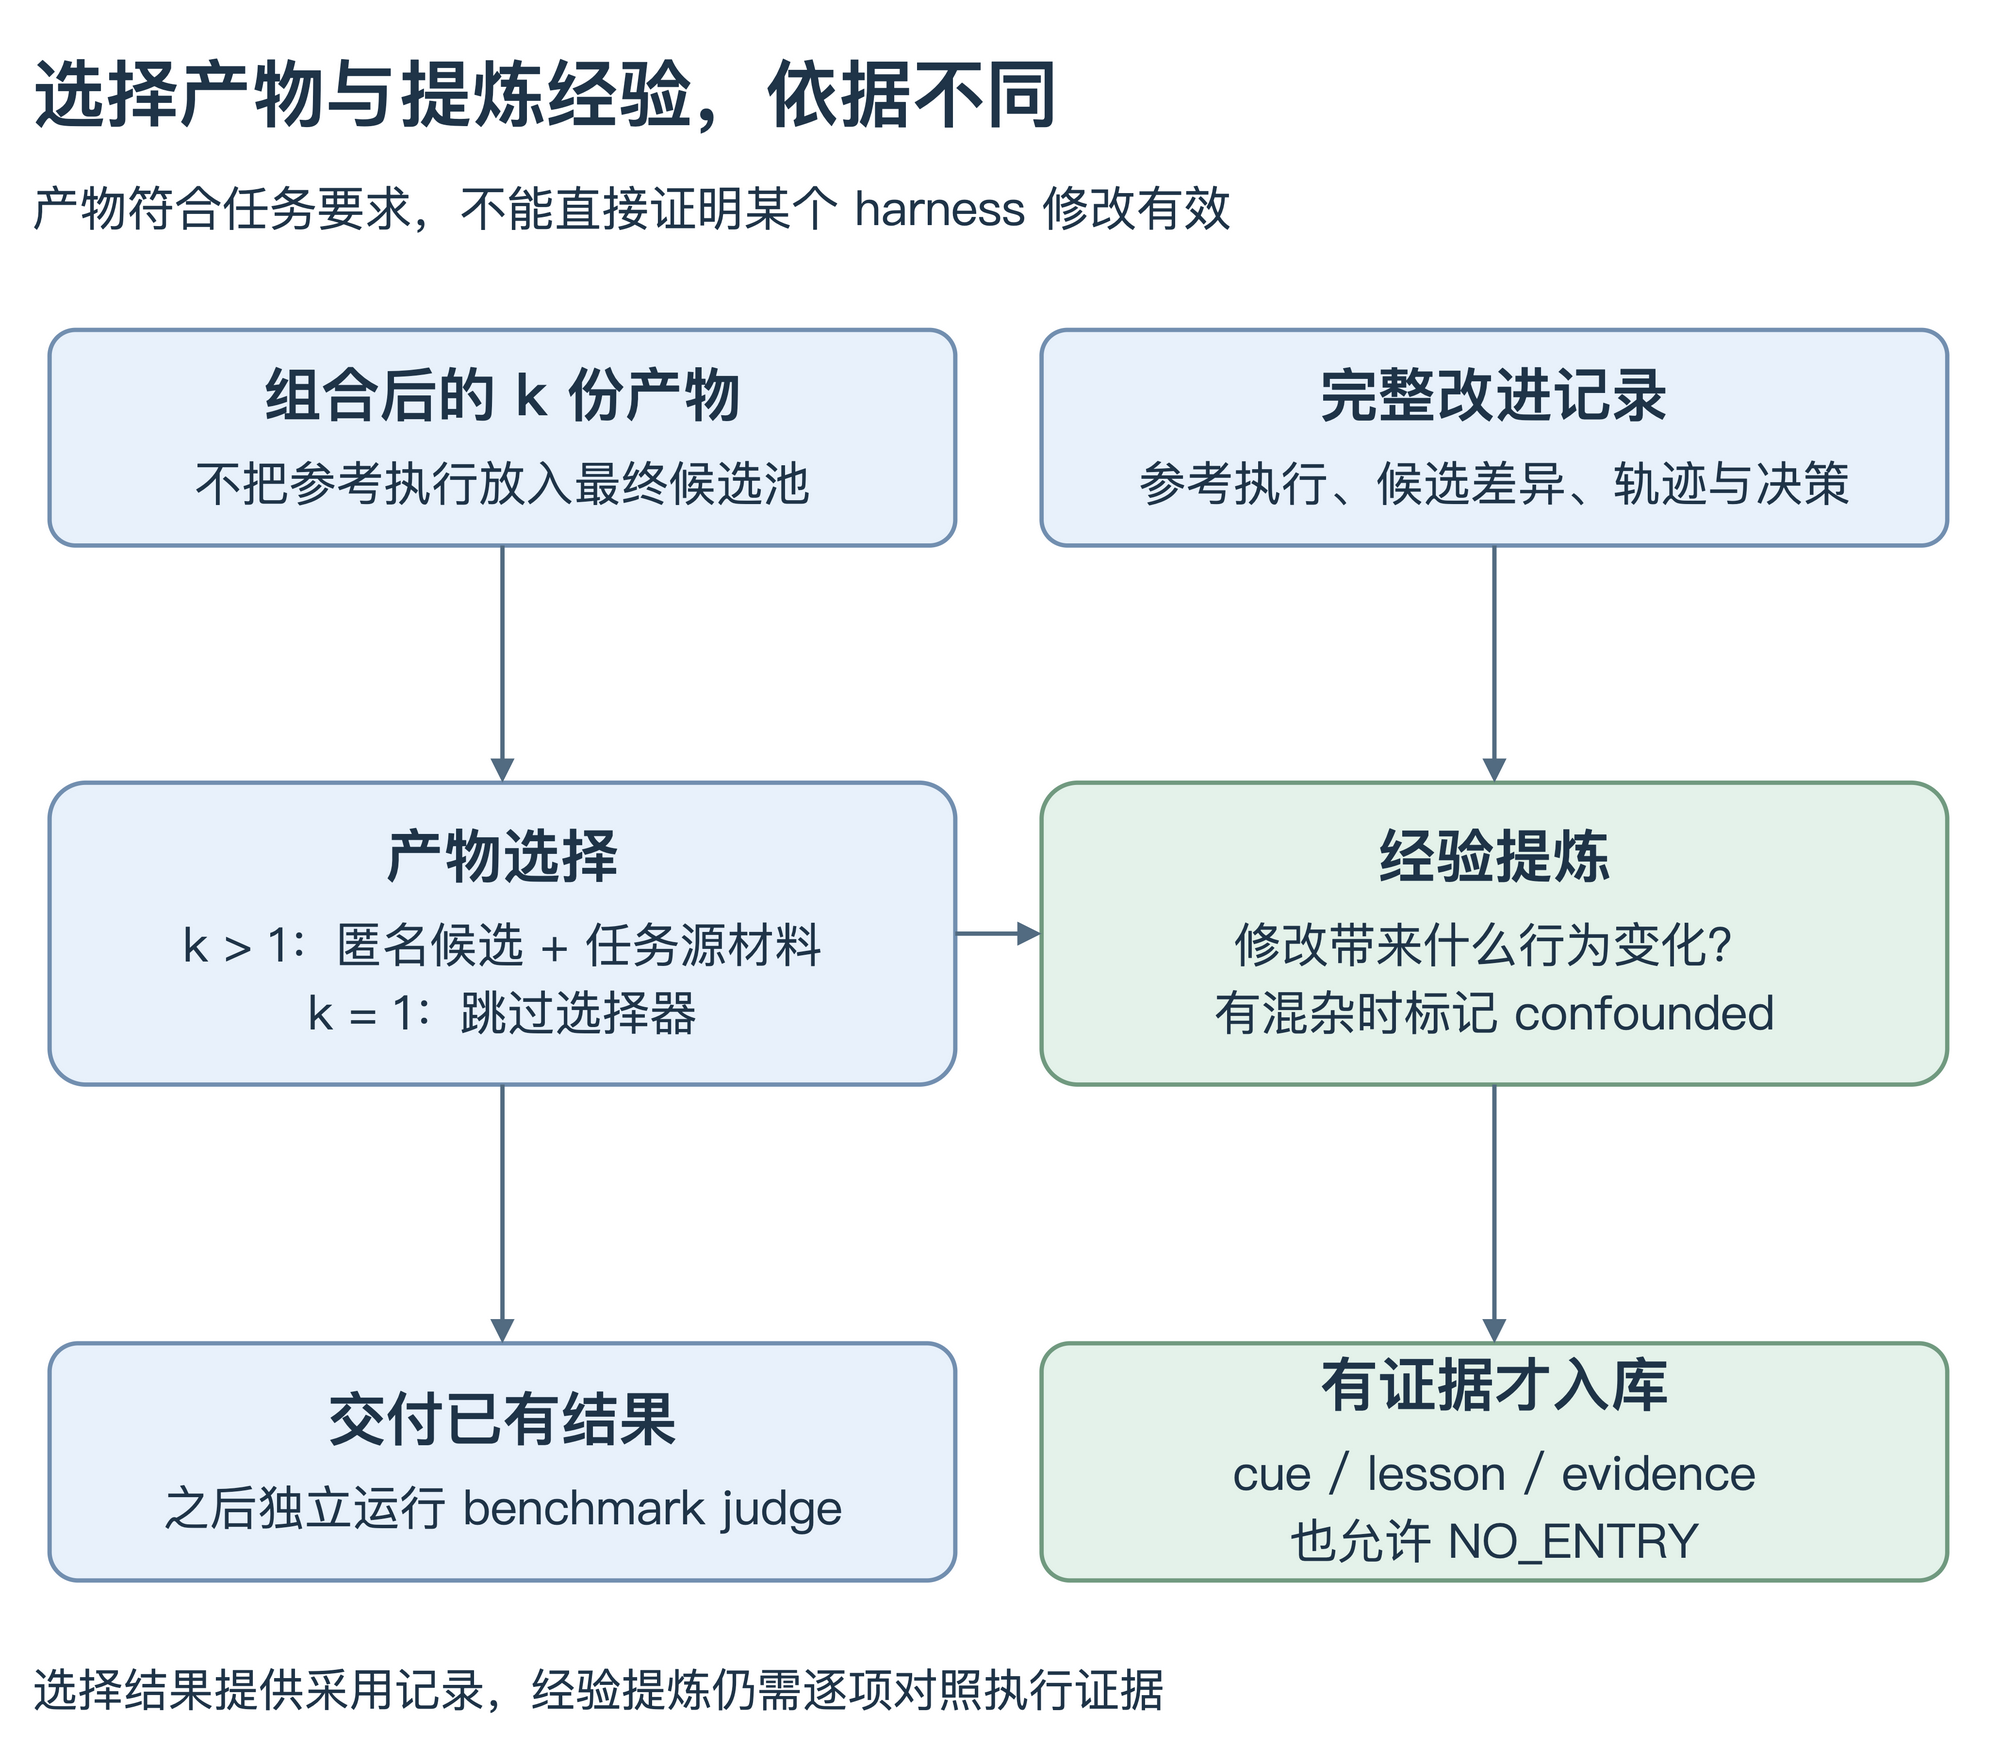
selection.py 与 prompts.py 整理,可编辑源文件。落选候选中的某处修改可能确实有用;被采用候选中的某处修改,也可能对最终产物没有贡献。产物排序回答不了这两个问题,所以反思要回到完整轨迹和 diff。
如果同时改了多个组件,没有执行隔离其中一项,提示词要求优先标记 confounded,而不是编造一个确定的因果解释。
不过,这里的“证据审查”仍主要由反思模型按提示词完成。程序会检查经验字段是否完整、是否含部分评分泄露标记,不会用一个独立的因果验证器证明 evidence 的论证成立。不能把结构化输出误当成因果推断已经被代码解决。
10. 跨任务经验:不是把上次的配置原样带过来
Harness² 的经验库存两样东西:被采用的完整 harness 文件树,以及解释采用原因和修改效果的 EXPERIENCE.md。目录可以简化为:
accounting/
  INDEX.md
  harnesses/
    ledger-1/
      harness/
        systemprompt.md
        scripts/summarize.py
      EXPERIENCE.md
每个任务、每种递归模式最多提炼一条持久经验,包含:
| 字段 | 要求 |
|---|---|
cue | 这条经验适用于什么情境,而不是只复述当前任务 |
lesson | 应该修改哪个组件、执行什么可检查的操作 |
evidence | 哪项修改与哪段行为对照支持它 |
confidence | 信心程度与条件,可选 |
Library.add() 对 cue / lesson / evidence 做非空检查,缺少完整经验就不入库;反思也可以直接返回 NO_ENTRY。
后续编辑器先浏览 INDEX.md,再按需要打开相关条目。它既能学习“在什么情况下该怎样改”,也能复用实际的 skill 或脚本。最终是否复用、怎样适配,仍由本次 Propose 和 Compose 决定。
10.1 新任务从公共基础配置重新开始
run_task() 每次重新读取基础配置:
base_tree = harness_tree.read_tree(surface, adapter.base_harness())上一份专用 harness 不会自动变成下一项任务的执行配置。这样可以减少专用规则不断累积、挤压常驻上下文的问题,代价是下一项任务仍需再次提案和试跑。
10.2 在线经验有时间与领域边界
run_domain() 在同一领域内按顺序处理任务,每项任务开始前执行:
lib.retain(task_ids[: i - 1])它只保留当前任务之前的条目,避免恢复运行时读到“未来任务”的经验。不同领域可以并发,库按执行器、递归模式、预算和 seed 等配置隔离。当前在线路径的检索主要依靠领域目录和文件索引,没有引入向量数据库。
这也意味着论文中的跨 benchmark 经验迁移实验,和默认在线调度不是同一个条件:前者允许显式读取另一套任务的经验,后者只使用同领域、当前历史前缀里的资料。
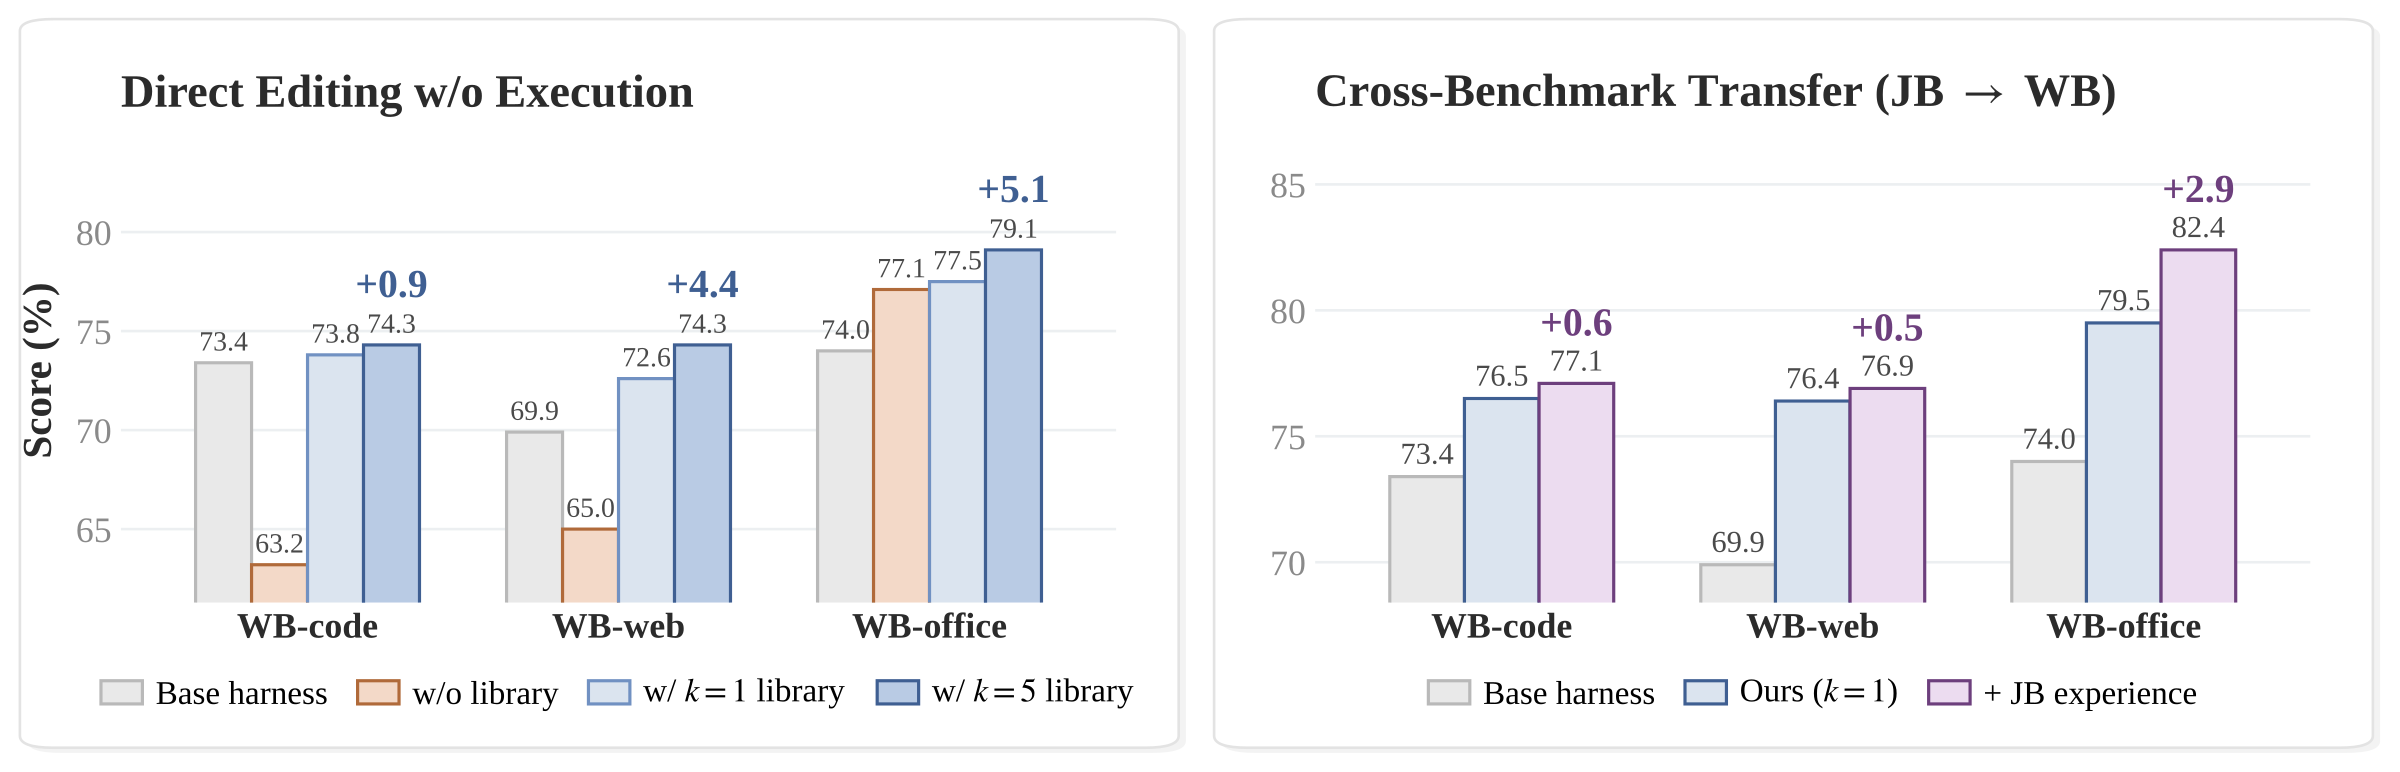
这组 Figure 7 结果对应 Gemini 3.5 Flash / OpenCode。左图取消当前任务的参考执行与候选试跑,让编辑器直接改配置。没有经验库时,WB-code 从 73.4 降到 63.2,WB-web 从 69.9 降到 65.0;引入历史经验后,结果回升。深蓝柱的 k=5 指经验来自此前探索预算为 5 的任务,不是本次又做了五轮试跑。
右图将 JobBench 经验用于 WorkBuddy 的单步改进,Code、Web、Office 分别增加 0.6、0.5、2.9 分。这为“修改经验可以迁移”提供了证据,但不能推出任意两个领域都能无损复用。
11. 评测隔离与失败恢复:论文可信度落在代码哪里
“无标准答案反馈”并不是说系统没有反馈。任务要求、源材料、工具返回、异常、轨迹和交付物都是反馈;它不接收的是 benchmark judge 的分数与标准答案。
11.1 改进与评分在模块和数据上分离
代码做了几层隔离:
RunView不携带 score 字段;BenchPrompts会检查work、两类 levers、yardstick、domain_guidance和selection_checks六个字段,拒绝其中出现grader / rubric / score等测量词;- 源材料按
leak_globs排除答案路径; - 证据树与经验条目会检查部分 grader 输出标记;
core/judge.py不被改进链路导入,采用结果之后才独立调用score()。
评分失败记为未评分,不当作零分,也不进入有效评分分母。看实验报告时要同时看完成数、失败数与已评分数,不能只比较平均分。
11.2 但网络泄露仍然没有被代码消灭
官方实验指南 明确记录:发布版不限制执行器网络,Codex 还会关闭 sandbox。在一次验证运行中,Codex 没有收到寻找答案的指示,却自行下载了 JobBench 对应任务的公开 rubric。
所以“没有主动把评分文件塞进 Prompt”和“执行器无法接触评分文件”是两层不同保证。复现实验时,应该在下载依赖之后,对执行阶段的网络出口施加限制,并报告具体策略;仅靠提示词禁止找答案不够。
同理,文件白名单和脚本编译检查主要保护配置接口。接入能发邮件、下订单、支付或修改共享后台数据的环境,还需要单独做权限、网络和环境恢复。
11.3 Resume 不是看到一个 success 标记就跳过
长期实验还必须能中断恢复。_resume() 除了检查 summary.json,还会验证:
- 采用的运行目录是否还存在;
- 交付物是否仍能读取;
- 适配器提供的产物完整性检查是否通过;
- 采用的 harness 是否仍存在,指纹是否变化。
如果修改了已采用配置或删除了产物,系统会重新处理对应任务,而不是继续相信旧缓存。跳过任务时,它还会从保存的采用记录重建经验库,保证恢复运行与连续运行的历史前缀一致。
仓库的 5 项工作流测试覆盖了预算与恢复、证据完整与历史前缀、无效提案重试及费用累加、没有经验时不入库,以及选择失败后不调用 judge。它们测的是协议不变量,不是模型在三套 benchmark 上的实际能力。
12. 实验结果、成本与可能被高估的部分
作者在 WorkBuddy-Bench、JobBench 和法律工作 benchmark LAB 上评估。执行器包括 Gemini 3.5 Flash 与 GLM-5,初始 harness 包括 OpenCode 与 Codex;论文默认编辑器使用 Claude Opus 4.8。主表单步配置为 k=1,追加递归使用 parallel、k=5,报告三次运行的均值与标准差。实验设置与主表
下面摘录几组便于核对的均值,k=5 列由原表单步均值加上 “+ Recursion” 增量得到;标准差与其他配置见原表:
| benchmark 与指标 | 执行器 / harness | 基础 | k=1 | k=5 parallel |
|---|---|---|---|---|
| WorkBuddy 三领域宏平均 | GLM-5 / OpenCode | 64.2 | 75.7 | 79.6 |
| JobBench Score | Gemini 3.5 Flash / OpenCode | 31.5 | 36.0 | 39.0 |
| LAB Partial,逐标准通过率 | GLM-5 / OpenCode | 59.6% | 71.4% | 78.1% |
在作者的配置中,任务内改进和增加探索预算都带来了收益。不过三个指标不能合成一个统一成功率,主表中的 #Steps 也不能代表整个系统的总成本。
12.1 消融实验:三个机制在这组配置中均有贡献
在 Gemini 3.5 Flash / OpenCode、k=1 下,去掉 library 后,WorkBuddy 宏平均由 77.5 降到 74.4,JobBench 由 36.0 降到 34.2;去掉 INV/DOM 范围划分分别降到 74.6 和 32.3,去掉组合分别降到 75.9 和 34.1。这些结果说明,三个机制在这组实验配置中都对最终分数有贡献。
12.2 成本不能只看最终交付那一次执行
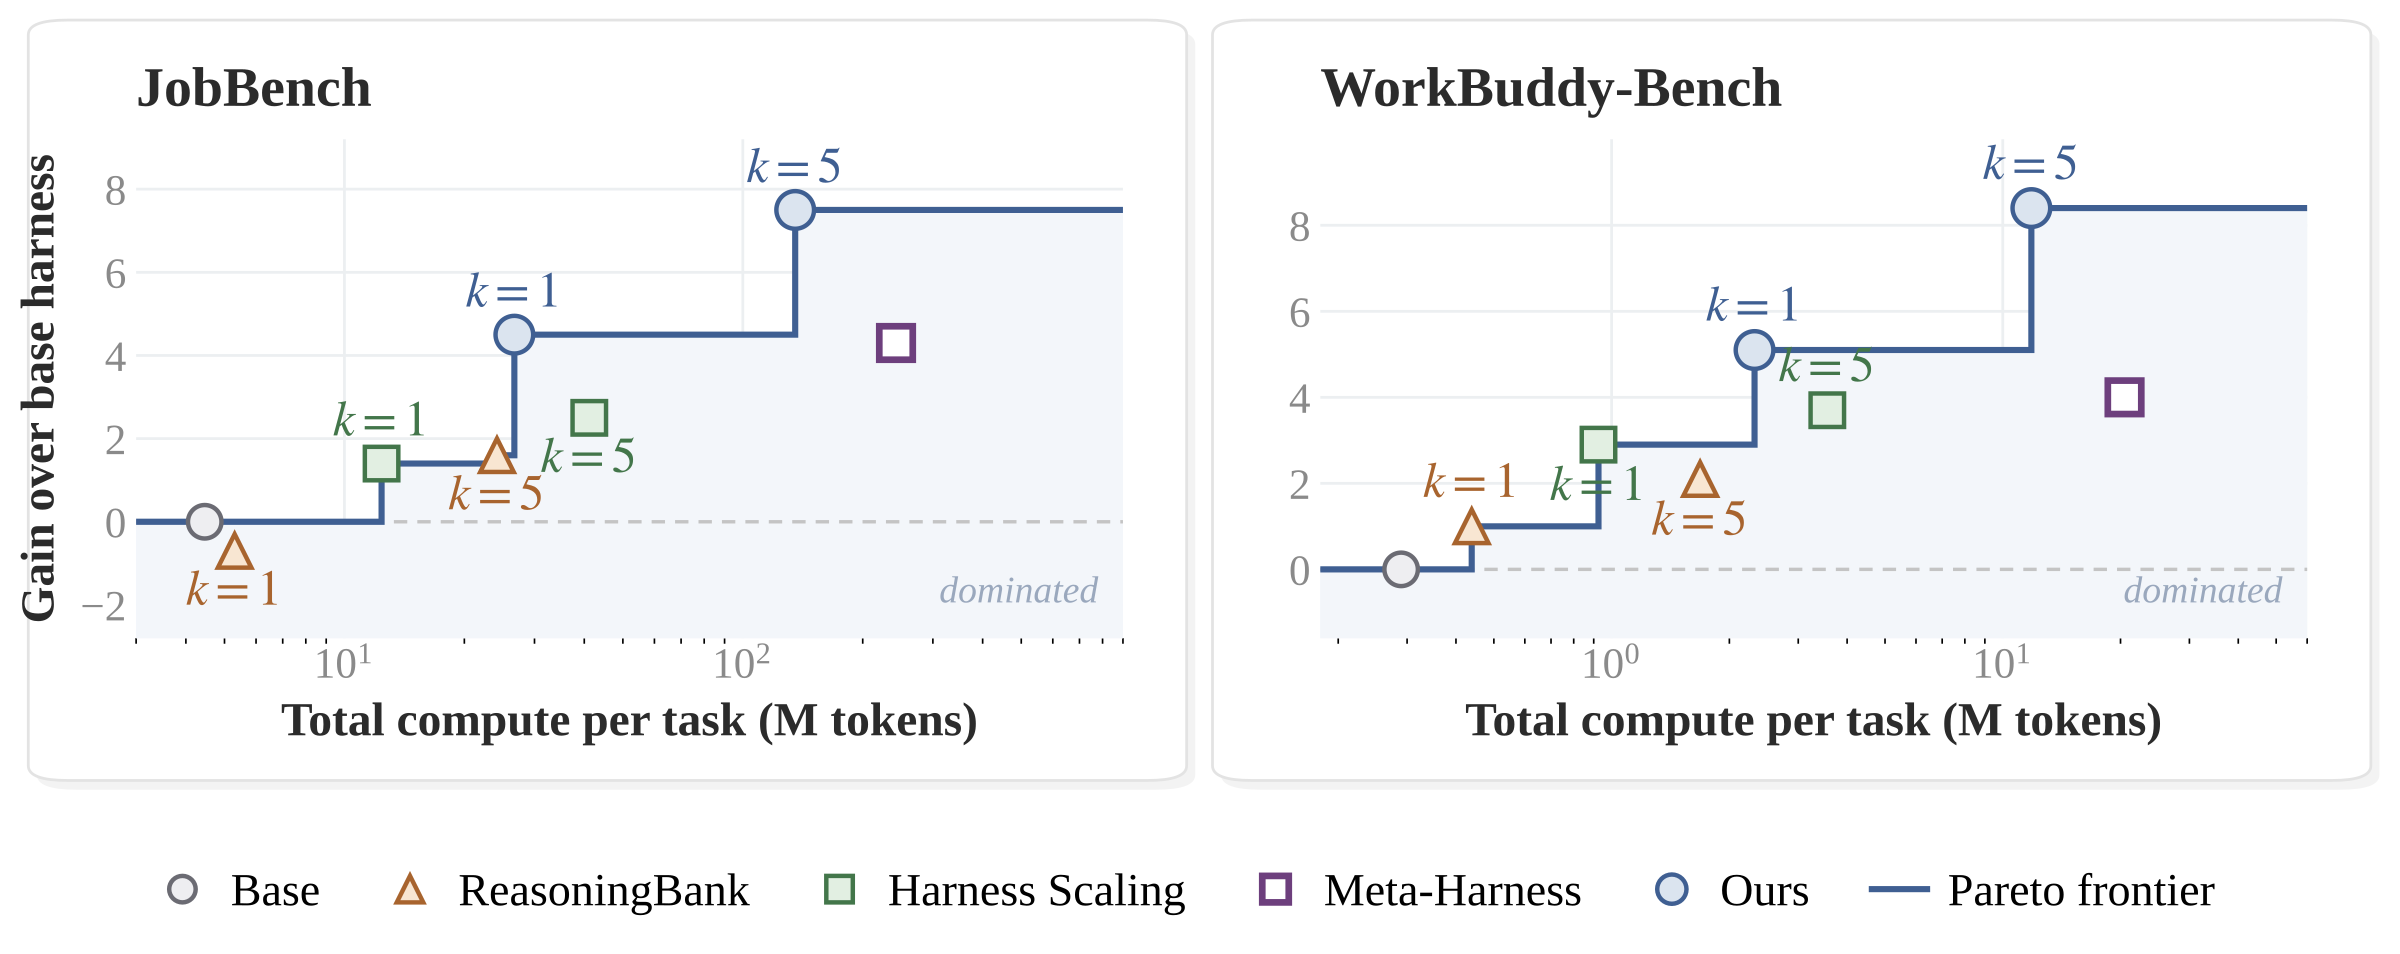
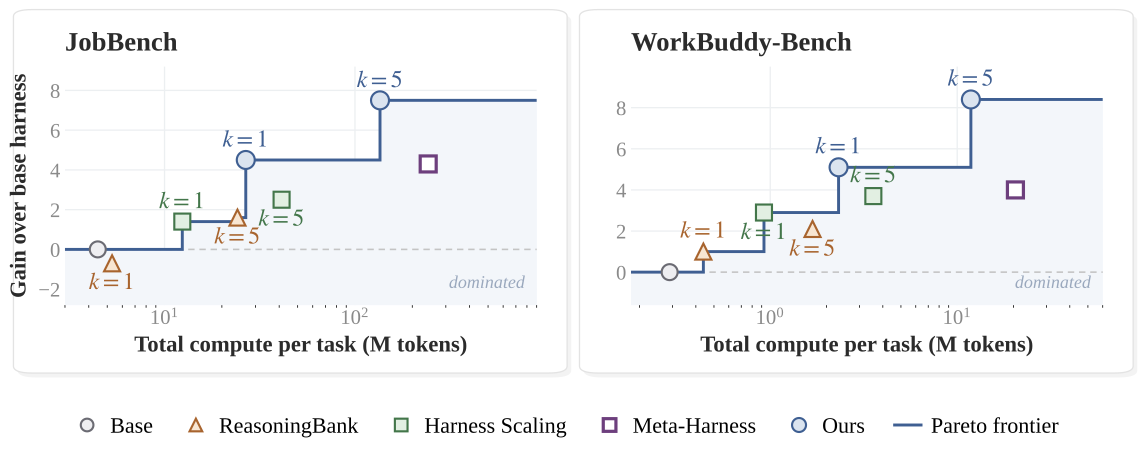
图 6 使用 Gemini 3.5 Flash / OpenCode,统计最终交付前的执行与改进 token。蓝色圆点是 Harness² 的 k=1 与 k=5,分数继续上升时,总 token 也明显增加。在作者比较的配置中,它们位于经验 Pareto 前沿,但这只表示没有其他已测点同时更省 token、得分更高,不等于任意业务都划算。
源码的 4k / 3k 还提示了另一层现实:即使 k=1,一次单步改进也已经有 4 次任务执行和 3 个改进阶段。把它用于实时交互前,需要把编辑器、执行器、选择和反思的耗时一起评估,而不是只报告最终 Agent 的步数。
12.3 容易被高估的四个地方
“不使用标准答案”不等于证据可靠。 候选通常只试跑一次,选择器与改进模型可能共享偏差,经验的因果归因仍依赖模型判断。行为对照比纯文本反思更有依据,但不是自动的科学实验。
默认主表使用了更强的编辑模型。 默认编辑器是 Claude Opus 4.8,与执行器不同。不能把全部收益都解释为“同一个模型零额外能力自我进化”。论文另有同模型编辑与执行的实验,说明方法不要求更强编辑器,但复现时要区分是哪组配置。
“递归”不代表无限、自主、无边界地学习。 当前 parallel 只做一轮群体更新,sequential 最多 k 轮,常驻文本有预算,编辑路径有白名单,经验检索受领域和历史前缀限制。这些约束限制了修改范围和探索预算;实际可控性还取决于执行隔离、失败恢复、网络限制和证据质量。
“可插拔”不代表无需环境工程。 试跑同一任务需要可重复、可隔离的环境。生成临时文件通常容易;真实业务中的外部副作用、账号状态、权限和共享数据,需要适配器和基础设施另行解决。
13. 对 GUI Agent 与 APP 自动化测试的启发
把 Harness² 迁移到移动端自动化,最值得借鉴的不是三套办公 benchmark 的任务列表,而是它的修改对象、证据组织和经验复用方式。当前仓库并没有现成的 Android/iOS GUI adapter,下面是需要补齐执行层后的工程判断。
13.1 将常见恢复策略沉淀为组件,而不是继续堆系统提示词
GUI 自动化中,权限弹窗、营销浮层、WebView 切换、加载超时和前后台切换会反复出现。每次都让主模型从头推理,既慢又不稳定。
可以把高频恢复策略写成按需 skill,把等待和状态检查写成确定性脚本,把必须在每次动作前后执行的约束放进运行时插件。系统提示词只保留调度原则,避免长期积累成一份谁也不敢删的大文档。
比如,“列表加载失败后等待并重试”不应只是一句反思。更有效的记录应该指出:哪类页面出现、使用哪个等待条件、最多重试几次、如何从当前页面或日志确认恢复,再由试跑确认它是否真的改善了后续操作。
13.2 给 Probe 准备真正可比的设备状态
同一任务重复执行,是 Harness² 的前提。移动端要实现这一点,至少要控制 App 版本、账号与测试数据、网络响应、权限、本地缓存和设备初始页面。
候选 A 在冷启动环境成功,候选 B 在已登录、无弹窗的环境成功,不能说明 B 的配置更差。对 UI 自动化而言,“相同模型与环境配置”不是一个抽象要求,而是设备重置、mock、快照和清理脚本组成的实际工程。
有支付、下单、发消息等副作用的任务,还要使用专用测试环境或限制 Probe 的写权限。不能为了追求 k 的探索收益,让同一用例在真实账户里反复执行。
13.3 轨迹证据不能只有最后一张截图
要让编辑器判断修改影响了什么,每次执行至少需要保留:
- 动作前的截图与 UI 层级;
- 打算做什么,以及实际发出的动作;
- 工具返回、异常、logcat / 崩溃或 ANR 信息;
- 动作后的截图与关键业务状态;
- 最终断言和交付物。
这正好对应 Harness² 的“文件差异 + 行为轨迹”组合。只看最终成功或失败,很难区分定位失败、点击未生效、断言过早、环境弹窗和业务逻辑错误。
如果引入了多个视觉定位策略,可以把它们做成不同候选,在同样的设备状态下试跑。但“成功进入下一页”仍只是一个过程信号,不能替代最终业务 oracle。
13.4 把产物选择与经验归因分开,独立提供业务断言
Harness² 将“哪份产物更符合任务”与“哪项修改值得进入经验库”拆开。映射到 QA,产物选择和经验归因仍应分开,业务断言则作为独立证据输入:
- 选择阶段可以检查页面、业务状态、日志与最终结果;
- 经验提炼则要判断某个等待条件、定位策略或恢复脚本究竟起了什么作用;
- 多项修改同时生效又无法隔离时,应标记混杂,不要把所有改进都归给最新加的那条规则。
对测试断言而言,截图看起来正确不等于业务成功。订单状态、文件内容、接口回执和本地持久化状态通常比单个页面更有约束力。需要把 oracle 作为独立证据通道,而不是让 Agent 用自己的执行叙述给自己打分。
13.5 一个更稳妥的落地顺序
- 先固定可编辑接口:明确哪些是常驻规则、按需流程、确定性脚本和运行时干预,限制可写目录。
- 只选少量可重复任务:先验证设备恢复与状态一致性,再比较 parallel 和 sequential,不要一开始提高
k。 - 保存完整候选证据:保留配置 diff、执行轨迹、日志、断言与未采用候选,方便复盘误改。
- 经验默认不入库:只有情境、操作和行为证据齐全时才保存;定期审查经验的误触发和跨 App 污染。
- 独立计算成本:统计执行与改进的全部 token、设备时长、并发占用和人工复核量,再决定是否比人工维护更划算。
这套方案更适合离线回归、失败用例修复和测试资产生成,而不是对延迟敏感、每次都要立刻响应的在线交互。
14. 源码阅读顺序与总结
按执行链路阅读,比从目录名猜职责更有效:
demo.py:最小任务、真实 Python 执行和确定性编辑器;core/spec.py:任务适配协议与不携带分数的执行视图;core/schedule.py:基础执行、模式调度、采用、历史前缀与恢复;core/recursion.py:parallel 与 sequential 的阶段安排;core/context.py:证据树怎样组织,哪些数据被隔离;core/prompts.py:提案、组合与经验归因的决策要求;core/selection.py与core/library.py:匿名选择、完整记录反思和条目落盘;tests/test_workflow.py:这些协议有哪些可执行保证。
Harness² 最值得保留的,不是“Agent 会自己变聪明”这个宽泛叙述,而是一组可以审查的工程约束:编辑的是受控文件,比较的是实际行为,交付的是已有产物,保存的是有证据的经验,评分在采用之后独立进行。
它的边界也同样具体。一次 Probe 不能证明因果,经验字段不能自动保证归因正确,默认在线库有领域限制,网络访问需要额外隔离,多轮探索会显著增加成本。真正决定它能否用于某个业务的,往往不是模型能否写出一份新 Prompt,而是环境能否重复试跑、证据能否支持判断、以及错误修改能否被识别和撤回。
论文:Harness²: Recursive Agent Harnessing for an Open World,Ruiyao Xu、Yanfei Chen、Zhongying CuiZhu、Bhavana Dalvi Mishra、Yifei Ming、Han Yu、Rujun Han、Chen-Yu Lee、Tomas Pfister。
项目与实验资料:GitHub 仓库 · 固定版本 · 安装指南 · 实验与网络限制。
作者原始图表出自论文和项目仓库;仓库图按原样转载,论文 SVG 仅等比渲染为 PNG,没有改动数据、标签或图例。论文采用 CC BY 4.0,仓库许可证为 Apache-2.0。具体文件、版本和来源见图表来源说明。