拆解 billion-context:用模型驱动的“折叠”与 LSM 分层摘要,让 200K 窗口跑完百亿 Token 马拉松会话
结合源码(v0.1.213 / acp-kernel v0.0.193)、论文(Preprint v0.2)与 1,500 题跨基准独立评测,拆解 billion-context 如何通过只压增量、三级罗汉塔蒸馏、双模摘要载体与 SMT 求解器验证,在不破坏 KV-Cache 前缀的前提下实现 70× 常态压缩比与 94.2% 缓存读占比。
长周期编码 Agent 跑不远,通常不是因为底座模型不够聪明,而是上下文窗口先一步被工具输出撑爆。一次 grep、一段编译报错或几个大文件读取,几轮下来就是几万 Token。主流 CLI 常见的解法无非三种:按滑动窗口直接截掉旧轮次、等窗口填到 80% 时调一次 /compact 把整段历史压成一个大块并丢弃原文,或者把对话抽成零散事实存进外部向量库。
这三种做法在超过几百轮的会话里都会遇到麻烦:滑动窗口把早期约束彻底忘光;阈值触发的一次性改写不仅每次都会打碎服务商的 KV-Cache 前缀,而且经过三四轮反复“摘要的摘要”后,早期关键细节会按几何级数衰减;外部 RAG 则很容易弄丢排查过程中的因果链(比如“试过方案 A 但因为某行报错失败了”)。
由冉祥磊(Xianglei Ran)开源的 ranxianglei/billion-context(最新主干版本 v0.1.213,内置压缩内核 acp-kernel v0.0.193,commit 33104b1f9)给出了另一套工程解法。它在随仓库以 MIT 协议开源的论文 Model-Driven Incremental Hierarchical Compression: Training-Free Multi-Generational Context Management for Long-Lived Coding Agents 中提出并验证了一个判断:不需要扩大模型窗口,也不需要微调定制权重,20 万 Token 的有界上下文窗口加上正确的“折叠(The Fold)”布局,就能支撑持续数月、上万次调用、累计百亿级输入 Token 的单会话开发。
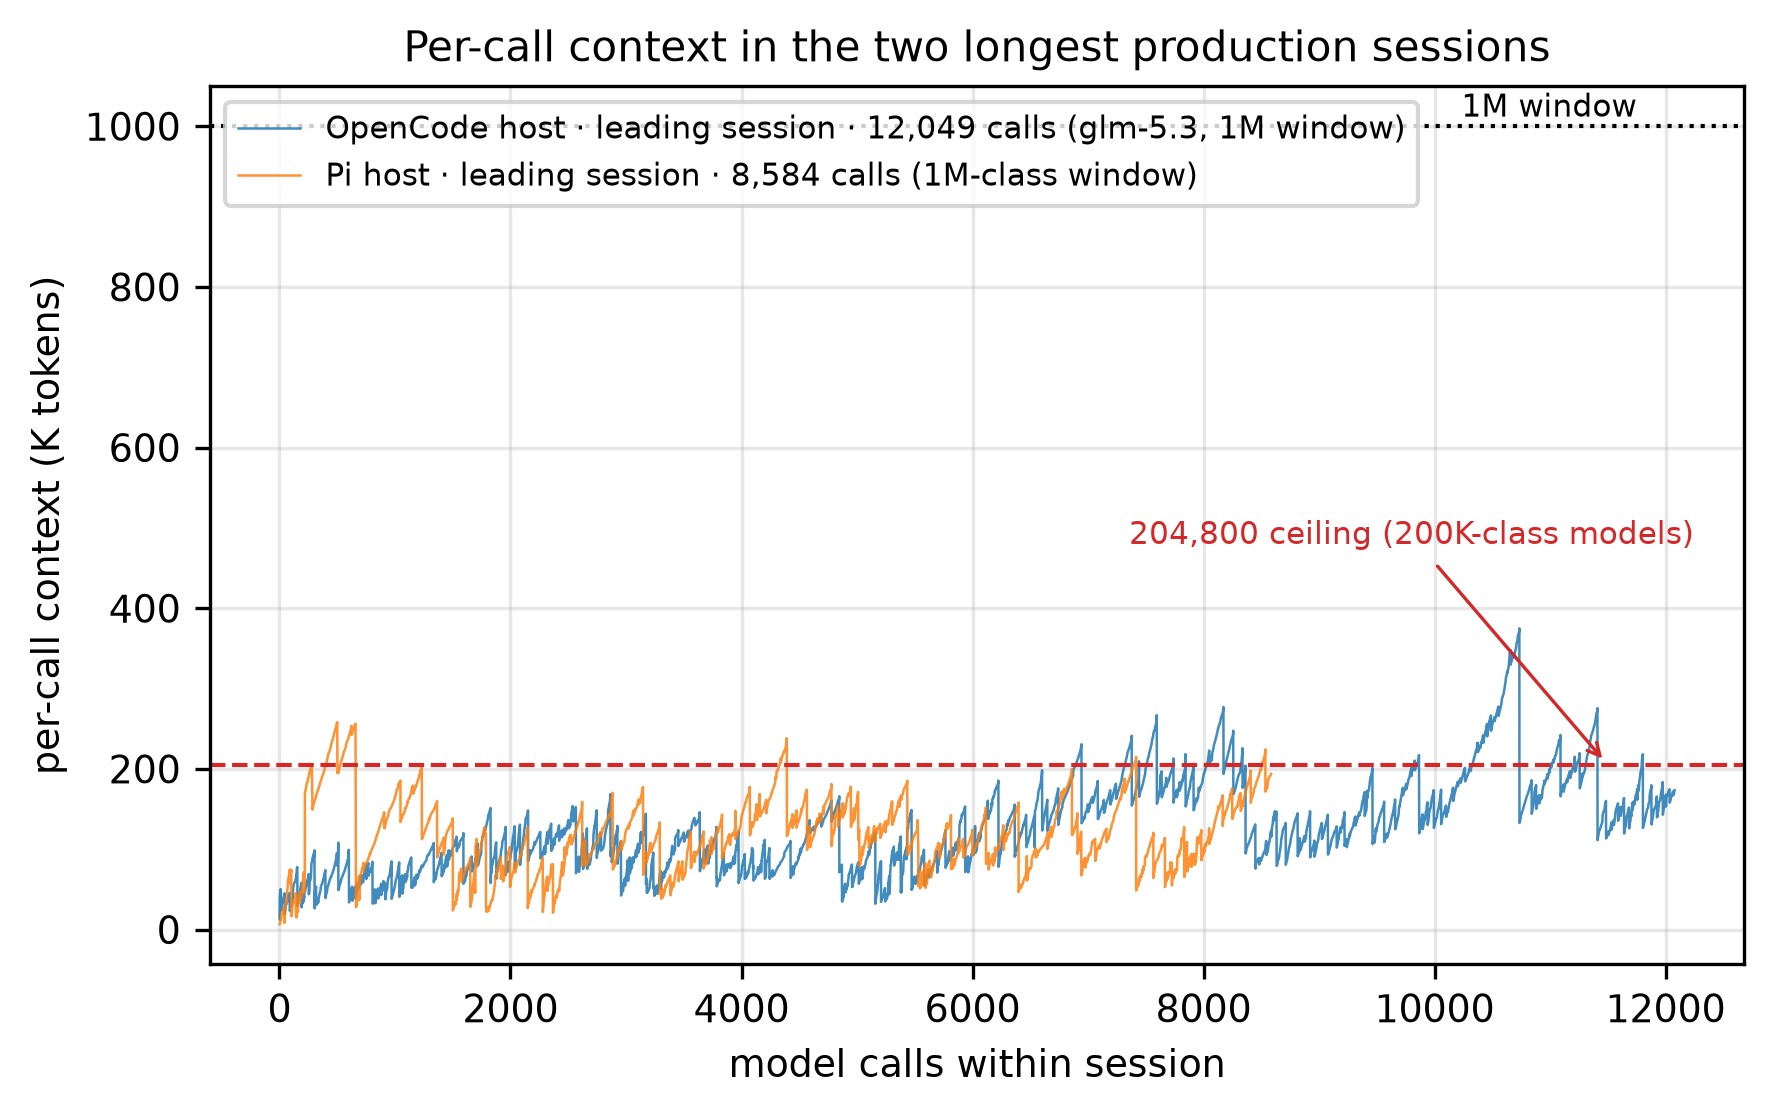
在跨三个宿主(OpenCode、Pi、ework 自治服务)、历时 4.5 个月的日常生产统计中,该系统在 4,843 个会话、174,327 次模型调用中累计处理了 187.6 亿输入 Token(跨三宿主合计约 247 亿 Token),在 204,800 窗口的模型上实现了 0 次窗口溢出,最长单会话连续运行 12,049 次调用(累计 15.2 亿 Token),常态宏观压缩比约 70×,活跃节奏下的 KV-Cache 读占比保持在 94.2%。
本文结合 billion-context 的仓库源码、架构文档、随仓论文图表以及 1,500 题第三方跨基准评测数据,拆解这套系统是如何设计的、核心代码怎么跑,以及它在什么场景下有效、什么场景下会撞上边界。
目录
- 项目背景与核心命题:为什么传统
/compact撑不住万轮会话 - 最小运行示例与三种接入方式
- 仓库结构与总体架构:纯函数内核与多协议代理分离
- 入口分析与双模压缩载体:Plugin 模式 vs Proxy 模式
- 内核主流程拆解:
acp-kernel的 16 节点流水线 - 四个关键工程机制:单一投影、50K 增速门控、压缩哲学与身份防错绑
- 核心数据结构与状态持久化:散文上的三层 LSM 树
- 形式化验证与安全护栏:把 TypeScript 决策核翻译成 SMT 求解
- 论文生产实测与 1,500 题第三方基准对比
- 适用边界与源码阅读索引
1. 项目背景与核心命题:为什么传统 /compact 撑不住万轮会话
为了衡量不同上下文管理方案在超长会话里的表现,随仓论文在 §4.2 定义了一个指标:会话级信息留存率 ,即截至时刻 处理过的全部信息中,在当前会话内仍能按需恢复(在窗口内常驻或可通过指针取回)的比例。
如果拿这个尺子去量现有的商业编码 CLI(默认在窗口占用达到 80% 左右时触发一次性自动压缩),会发现两个结构性问题:
- 信息留存率随压缩轮数呈 几何衰减:传统阈值压缩每次触发时,都会把前 80% 窗口的历史重写成一段占 30%–50% 窗口的新摘要。假设单轮保留率 ,由于下一轮压缩会把“上一轮的摘要 + 新增对话”混在一起再次总结,早期内容每经历一轮压缩就会被再损耗一次。4 轮之后,早期信息只剩 3%–13%;8 轮之后只剩 0.7%–1.7%,渐近留存率 。
- 每次压缩都会打穿 KV-Cache 前缀:一次性重写历史意味着会话开头的字节被整体替换。服务商刚建好的 Prefix Cache 瞬间全部失效,下一轮请求不得不为整窗内容重新支付全额输入费用和首字延迟(TTFT)。
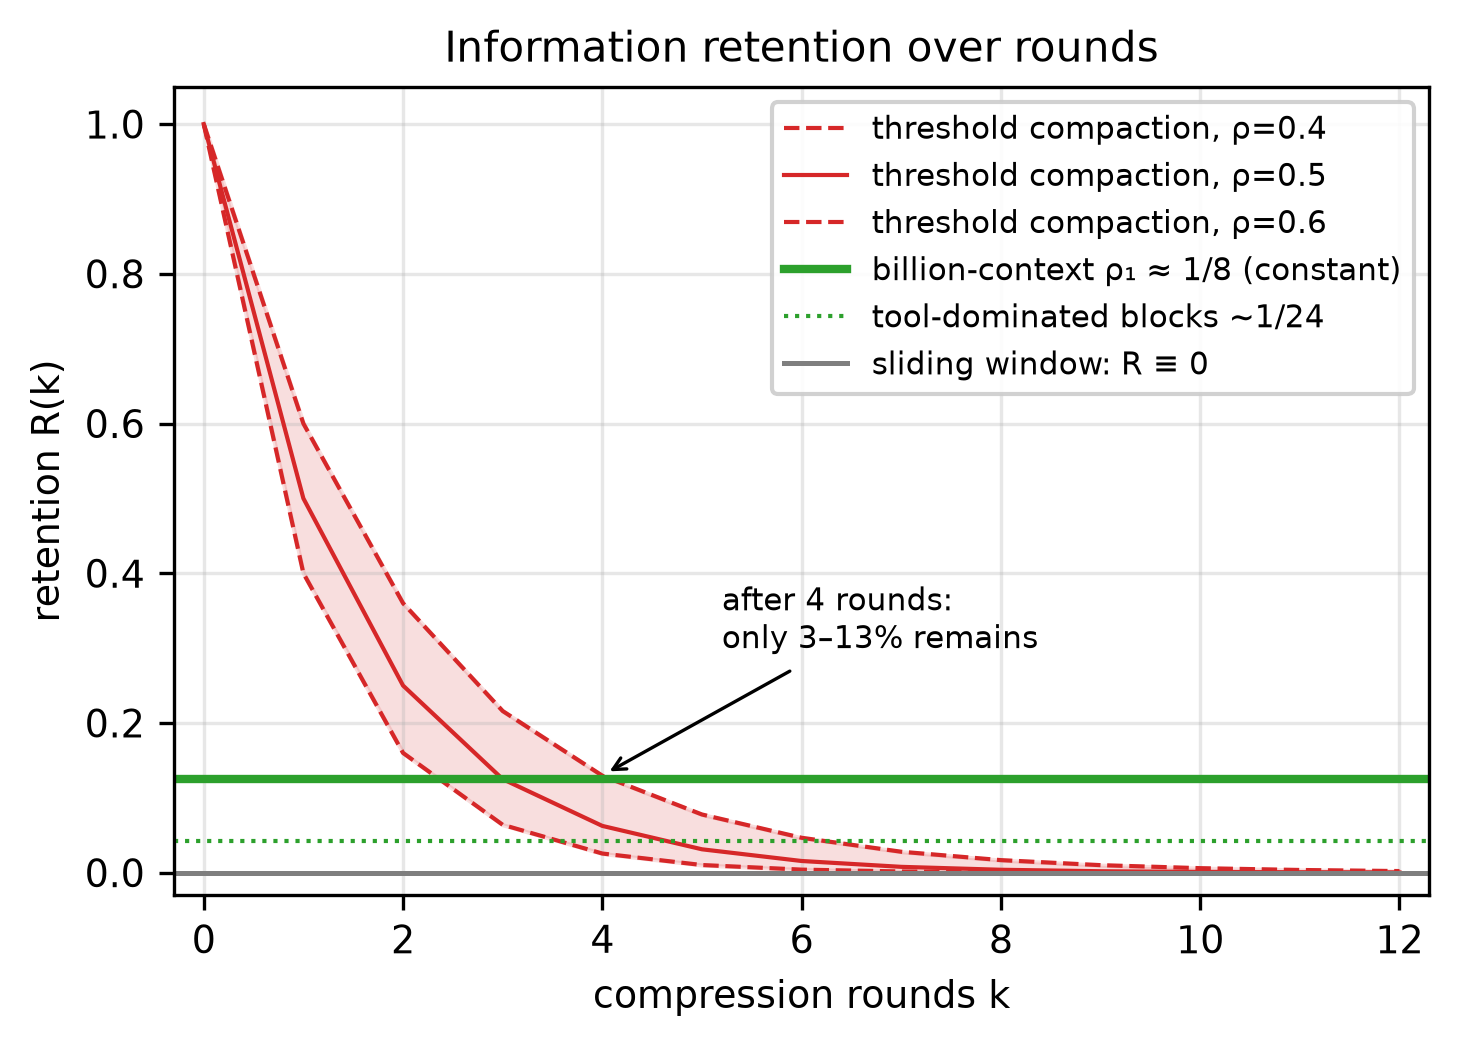
billion-context 的折叠布局让每段原文一生只被折叠一次,留存率恒定在 (工具密集块约 1/24),不随轮数复合衰减。billion-context 的核心设计称为折叠(The Fold)。它把模型窗口切分成两部分:前面是按世代分层(Tier-1 / Tier-2 / Tier-3)、可随时按编号解压恢复的摘要块前缀,后面是保持原文的近期工作区(约 50K Token)。
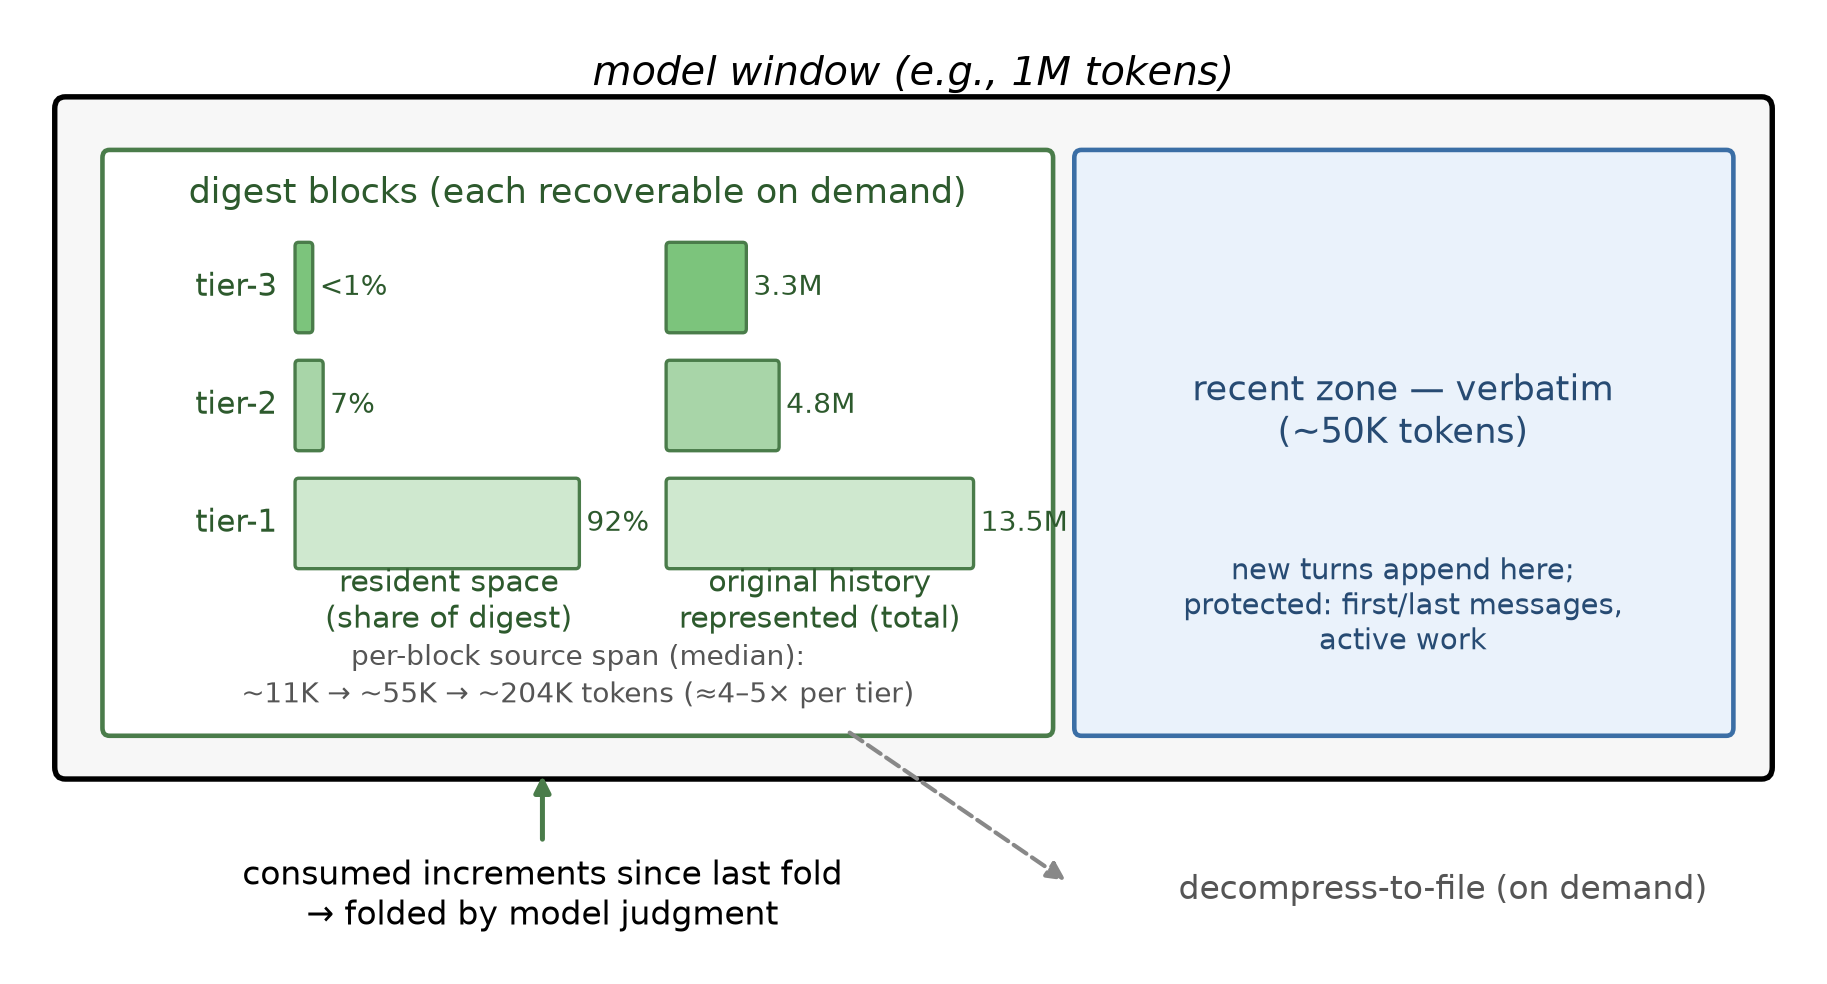
这套布局改动了两件最根本的事:
- 只压已消费的增量,单折不复合:每次压缩只针对“自上次压缩以来新增且已被当前步骤消费完”的中段消息区间,生成一个新的小摘要块(生产实测单块输出中位数仅 185 Token,97.5% 不超过 2K),绝不重写已经生成的旧摘要块。当 Tier-1 摘要块攒够一定数量或体量时,再像数据库的 LSM-Tree 压实(Compaction)一样,把一批旧块递归蒸馏成 Tier-2、Tier-3。
- 模型自己决定何时压、压哪里、留什么:何时发起压缩不由死板的百分比阈值强制决定,而是由内核在上下文每增长 50K Token 时注入一条轻量提示(Nudge),把待压缩候选区间及其真实尺寸列给模型。模型根据“当前任务步骤是否还需要这段内容”自己调用
compress工具写摘要,如果在调试关键节点也可以直接忽略提示、拒绝压缩。
compress、decompress、search_context、acp_status 四个上下文工具,中段已消费的消息区间被折叠为紧凑摘要块,近期对话保持原文。2. 最小运行示例与三种接入方式
billion-context 发布在 npm 上,提供 bili(别名 bili-proxy)命令行工具,目前已适配 Claude Code、Codex、OpenCode、Pi、Gemini CLI、Kimi、Qwen Code、dsh(deepseek-harness)、Hermes、Aider、Zed 等 20 多种主流编码客户端。
安装只需一行用户级全局命令(避免 sudo 导致后续后台自更新撞上权限报错):
npm install -g billion-context --prefix=~/.local根据客户端是否有插件扩展点,系统提供了三种由深到浅的接入姿态:
# 方式 1:原生插件模式(最推荐,代理随宿主自拉起,注册原生工具)
bili plugin install pi          # 支持 pi / omp / opencode / dsh / claude / kimi / hermes / zcode

# 方式 2:零配置启动器(不改真实配置文件,自动分配 18787+ 端口并通过 env 或证书 MITM 路由)
bili claude                     # 或 bili codex / bili gemini / bili aider / bili zed 等

# 方式 3:通用 URL 前缀改写(适用于任何能改 baseURL 的客户端)
bili                            # 默认在 127.0.0.1:8787 启动代理
# 随后将客户端原本的 https://api.openai.com/v1 改为:
# http://localhost:8787/bili/https://api.openai.com/v1
代理跑起来后,可以通过本地回环管理端点或客户端内的 /acp、/acp-cache 命令直接查看健康状态与缓存账本:
curl -s http://localhost:8787/__bili/health
# → {"ok":true,"upstream":"https://api.anthropic.com"}

curl -s http://localhost:8787/__bili/stats
3. 仓库结构与总体架构:纯函数内核与多协议代理分离
查看仓库根目录与 AGENTS.md,整个工程是严格模式的 TypeScript(ESM),使用 tsup 打包,测试全部跑在 Node.js 原生测试运行器(node --import tsx --test)上。为了让分发包尽可能轻量,主入口 dist/index.js 保持零外部运行时依赖(使用 Node 22+ 内置的 node:sqlite 做存储引擎)。
按职责划分,代码库可以分为五个核心部分:
| 目录 / 模块 | 代码规模与定位 | 核心职责与代表文件 |
|---|---|---|
kernel/ (acp-kernel) | 约 10k 行纯 TypeScript,550+ 单测,零宿主/I/O 依赖 | 整个系统的压缩决策核:管理块生命周期、引用编号分配、单一单元投影 (unit-projection.ts)、16 节点逐轮流水线 (compress.ts)、四条承重压缩哲学 (compression-rules.ts)。 |
src/server/ + src/loop/ | 代理请求管道与多协议流式闭环 | 入站剥离 ACP 标签 (src/marker/)、路由分诊 (handle.ts)、按客户端与线路裁决车道 (lane-decisions.ts)、4 种协议准备器 (prepare-anthropic/openai/responses/google.ts)、统一工具拦截循环 (src/loop/core.ts) 与流式 SSE 改写 (stream-*.ts)。 |
src/agent/ + src/launcher.ts | 20+ 客户端的宿主内插件与启动器 | 跑在宿主进程内的 shim 与拦截器 (pi.ts, opencode-native.ts, dsh-native.ts)、零配置进程启动器与证书 MITM 白名单控制 (mitm.ts)。 |
src/storage/ + src/persist.ts | 统一 SQLite 存储层(Schema v11) | 单一 WAL 写者,保存会话、消息行、规范化内容哈希、压缩块、引用账本、CCR 原文仓库与缓存计费账本 (cache-ledger.ts)。 |
verif/ + proof/ | 决策核 SMT 形式化验证 | 将受保护的 TypeScript 源码直接编译为 SMT-LIB2 公式 (symbolic.ts),调用 cvc5/z3 寻找违反“只追加前缀字节稳定”不变量的反例,并回放真代码验证 (replay.ts)。 |
官方在 docs/architecture.zh-CN.md 中维护了一张随 PR 强制同步更新的全局架构图(由 CI 脚本 tools/check-architecture-docs.mjs 校验):
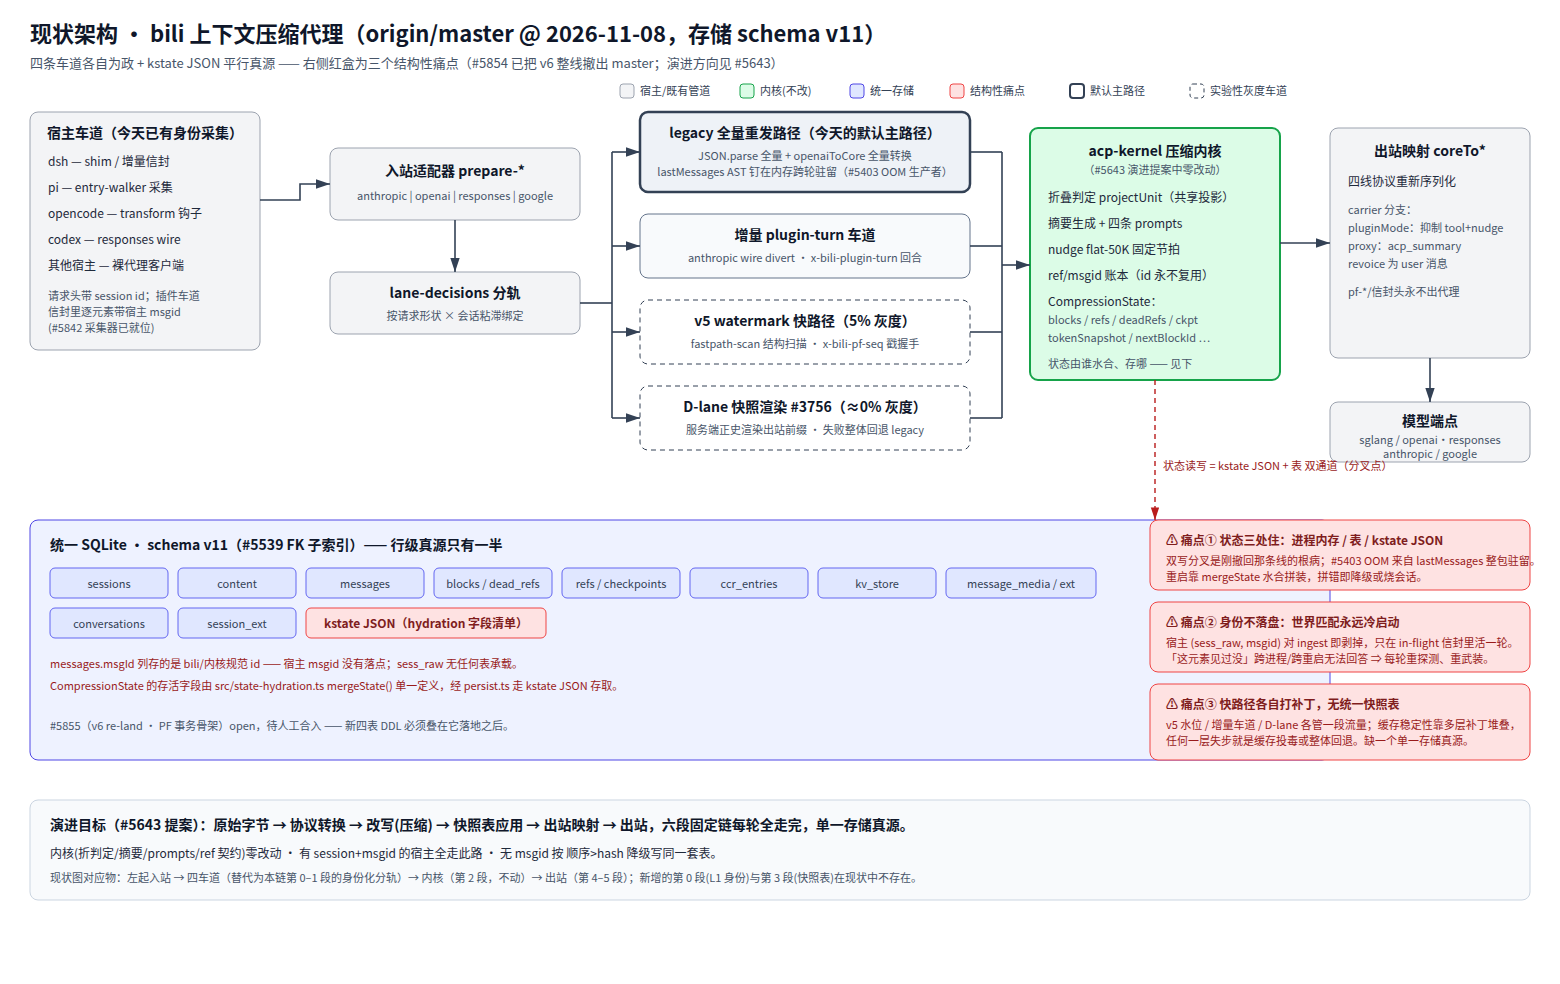
docs/architecture/assets/architecture-current.zh-CN.png(截至 2026-11-08,Schema v11)。从左到右展示了宿主车道入站、prepare-* 归一化、lane-decisions 选道、acp-kernel 压缩决策、coreTo* 出站序列化,以及底部的单一 SQLite 存储带。右侧红框诚实标出了当前架构正在通过 Issue #5643 收敛的三处历史包袱(双通道状态、宿主 msgid 未落盘、快路径分散)。为了让读者更直观地看清“一次请求从客户端进来,如何经过内核并分流到插件模式或代理模式”,我们结合源码绘制了下面的总体架构与双模闭环图:
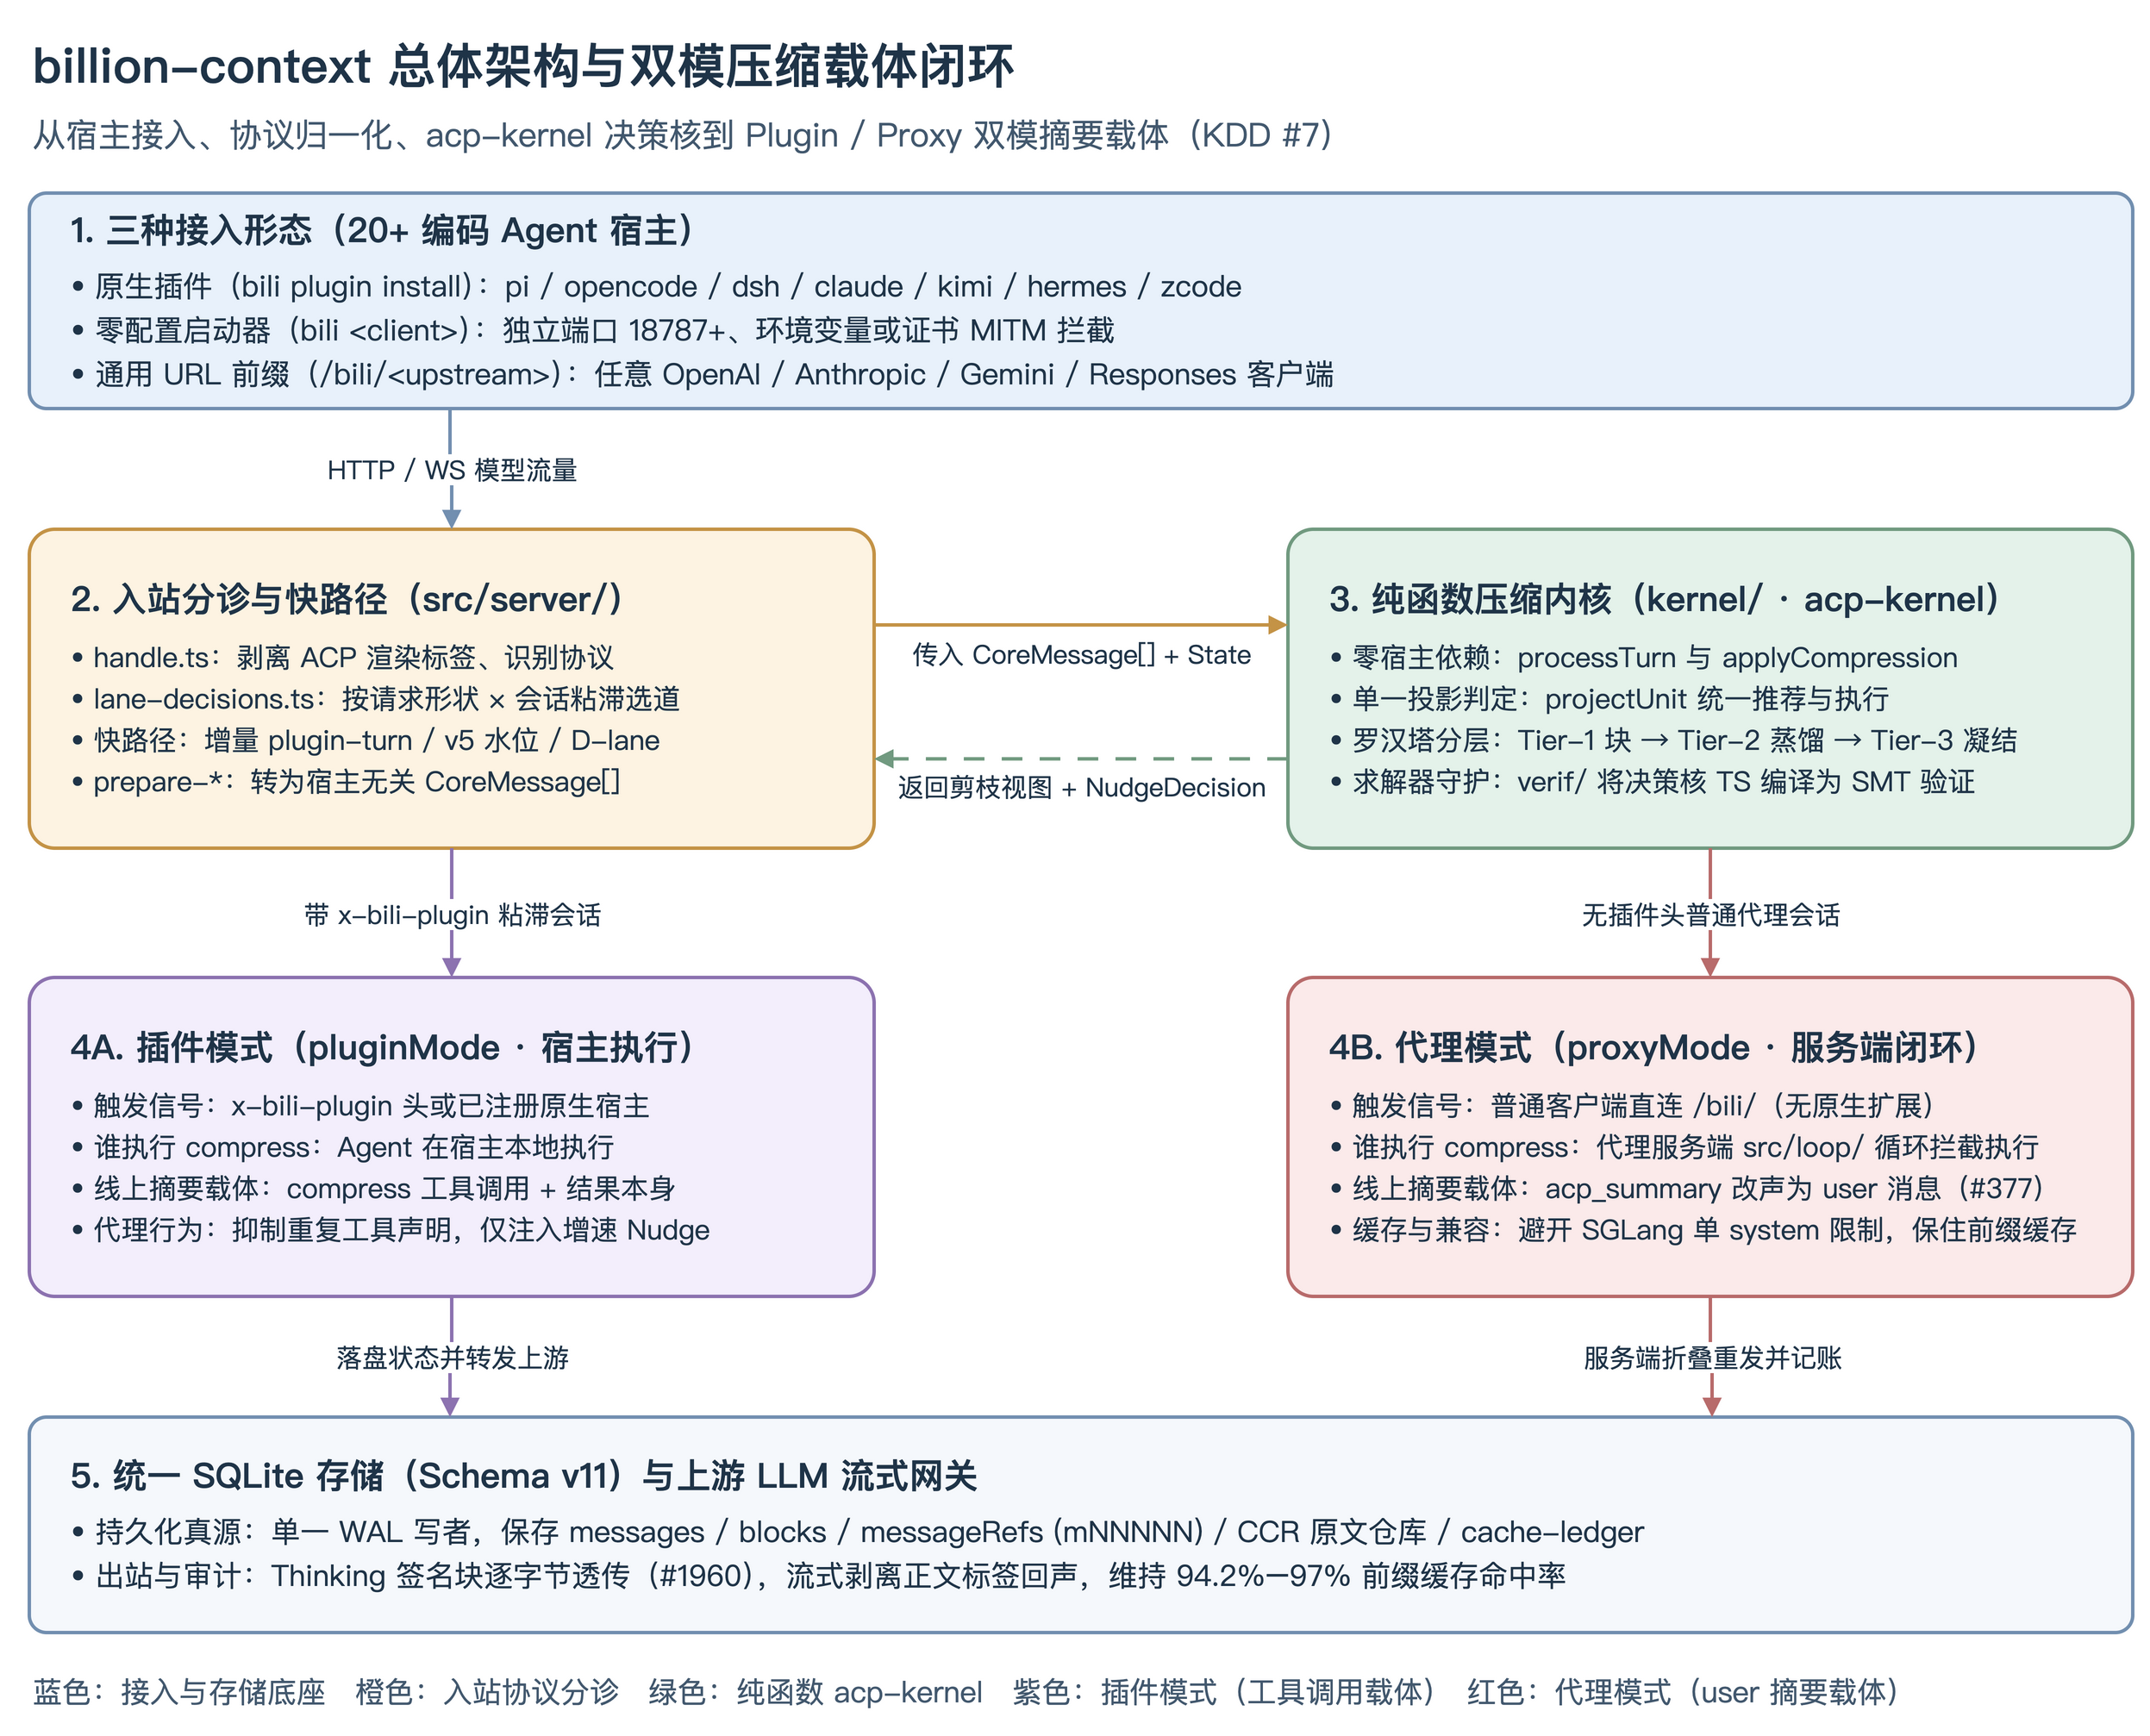
billion-context 总体架构与双模压缩载体闭环(基于 src/server/handle.ts、kernel/src/compress.ts 与 AGENTS.md KDD #7 绘制)。重点看第 2 步与第 3 步之间的纯函数交接,以及第 4A 与 4B 两条路径在摘要载体上的差异。4. 入口分析与双模压缩载体:Plugin 模式 vs Proxy 模式
理解 billion-context 源码的第一道门槛,是它在 AGENTS.md 第 7 条关键设计决策(KDD #7)中反复强调的:系统同时支持两种压缩模式,模式决定了由谁来执行 compress,进而决定了压缩后的摘要以什么形态(Carrier)发给上游模型。
当请求到达 src/server/handle.ts 时,代理首先剥离入站消息里的渲染标签,随后交由 src/server/lane-decisions.ts 做出全链路唯一的车道裁决:
// 来自 src/server/lane-decisions.ts:
// ① HostProfile — 每个宿主声明的默认属性
// ② WireObservation — 当前请求体上实际观测到的事实(声明了哪些 bili 工具)
// ③ LaneDecisions — 唯一裁决器,下游四个 prepare-* 与 loop 只读该冻结对象
function observeDeclaredTools(parsed: unknown, protocol: LaneProtocol): ReadonlySet<string> {
    const out = new Set<string>();
    for (const t of declaredToolEntries(parsed, protocol)) {
        if (t === null || typeof t !== "object") continue;
        const rec = t as Record<string, unknown>;
        if (typeof rec["name"] === "string" && biliToolsDeclaredOnWire({ tools: [t] }, protocol, rec["name"])) out.add(rec["name"]);
        // ... 同时检查 OpenAI function.name 与 Google functionDeclarations
这段代码的背景是早期的 Issue #3293 和 #3401:当时四个协议适配器各自用 pluginAgent === "..." 字符串判断客户端能不能调压缩工具,结果同一个 dsh 客户端在不同 profile 下工具可达性不同,导致有些配置下压缩被静默关掉。重构后的 lane-decisions.ts 改为“声明默认 + 线上实测工具表(observeDeclaredTools)”统一裁决,并通过 tests/lane-decisions-matrix.test.ts 的正负双向真值表锁死。
裁决完成后,会话分流为两种模式:
- 插件模式(
pluginMode,如bili pi或安装了原生插件的客户端):- 客户端自己是 ACP 原生的,已经在本地注册了
compress、decompress等工具。 - 谁执行压缩:Agent 在宿主进程内本地执行
compress。 - 线上摘要载体:
compress工具调用及其返回结果本身。因为这次调用就在客户端自己的对话历史里、每轮都会重发,所以代理不需要额外塞入合成摘要消息,只需把被该块覆盖的旧消息从出站请求里剪掉,并在上下文增长达标时注入 Nudge 提示。
- 客户端自己是 ACP 原生的,已经在本地注册了
- 代理模式(
proxyMode,普通客户端通过/bili/接入):- 客户端对压缩一无所知,由代理在请求中动态注入 4 个 ACP 工具定义。
- 谁执行压缩:当上游模型返回
compress工具调用时,代理在src/loop/core.ts(最多循环MAX_LOOP_ROUNDS = 10轮)中直接在服务端拦截并执行,更新会话状态后立刻向模型发起下一轮请求,客户端全程无感。 - 线上摘要载体:因为这次工具调用是代理私下拦截的,不在客户端的持久化历史里,下一轮客户端重发历史时必须由代理把摘要塞回去。内核默认把摘要块生成为
acp_summary_*的system消息,但在出站前,代理会通过systemToUser把它改声(re-voice)为user消息。
为什么要特意把 system 摘要改成 user 消息?docs/technical-notes.zh-CN.md 给出了明确解释:像 SGLang 这样严格的 OpenAI 兼容推理后端,强制要求对话流只在 index 0 处有一条 system 消息,对话中途出现第二条 system 会直接返回 HTTP 400(Issue #377)。把摘要块改成带 [Compressed conversation section] 标记的 user 消息留在原锚点位置,既绕开了后端的单 system 限制,又保证了头部的真实 system 消息字节完全不变,从而稳住前缀缓存。
5. 内核主流程拆解:acp-kernel 的 16 节点流水线
无论走哪条协议或哪种模式,归一化后的 CoreMessage[] 和当前会话的 CompressionState 最终都会交给 kernel/src/compress.ts 中的 processTurn。
acp-kernel 的定位在 kernel/DESIGN.md 第一句话里写得很清楚:
来自 kernel/DESIGN.md:
"ACP-style compression is not like zip in one essential way: the model writes the summaries; this library orchestrates everything around them."也就是说,acp-kernel 自己从不发起任何网络请求或大模型调用,它是一个纯函数状态机:输入 (messages, state, config, tokenCount),输出剪枝渲染后的新 messages、更新后的 state 和本轮是否要提示模型压缩的 NudgeDecision。
在最新的 kernel/src/compress.ts(第 1132–1153 行)中,processTurn 的逐轮流水线由论文早期的 9 个阶段演进到了职责更细的 16 个单职责节点:
// 来自 kernel/src/compress.ts:
function buildNodes(strategy: RenderStrategy): PipelineNode[] {
  const base: PipelineNode[] = [
    reconcileLiveIdsNode,
    createStampTimestampsNode(timestampsOn),
    assignRefsNode,
    syncBlocksNode,
    pruneNode,
    preTransformSnapshotNode,
    ccrStoreNode,
    absorbHideNode,
    crushNode,
    absorbPromptNode,
    filterNode,
    hideCompressCallsNode,
    viewLatchNode,
    recommendNode,
    nudgeNode,
    emergencyTruncateNode,
  ];
  if (strategy === "none") return base;
  return [...base, createRenderRefsNode(strategy, { timestamps: timestampsOn })];
}
我们把这 16 个节点串成一条清晰的 6 阶段执行链(见图 6):
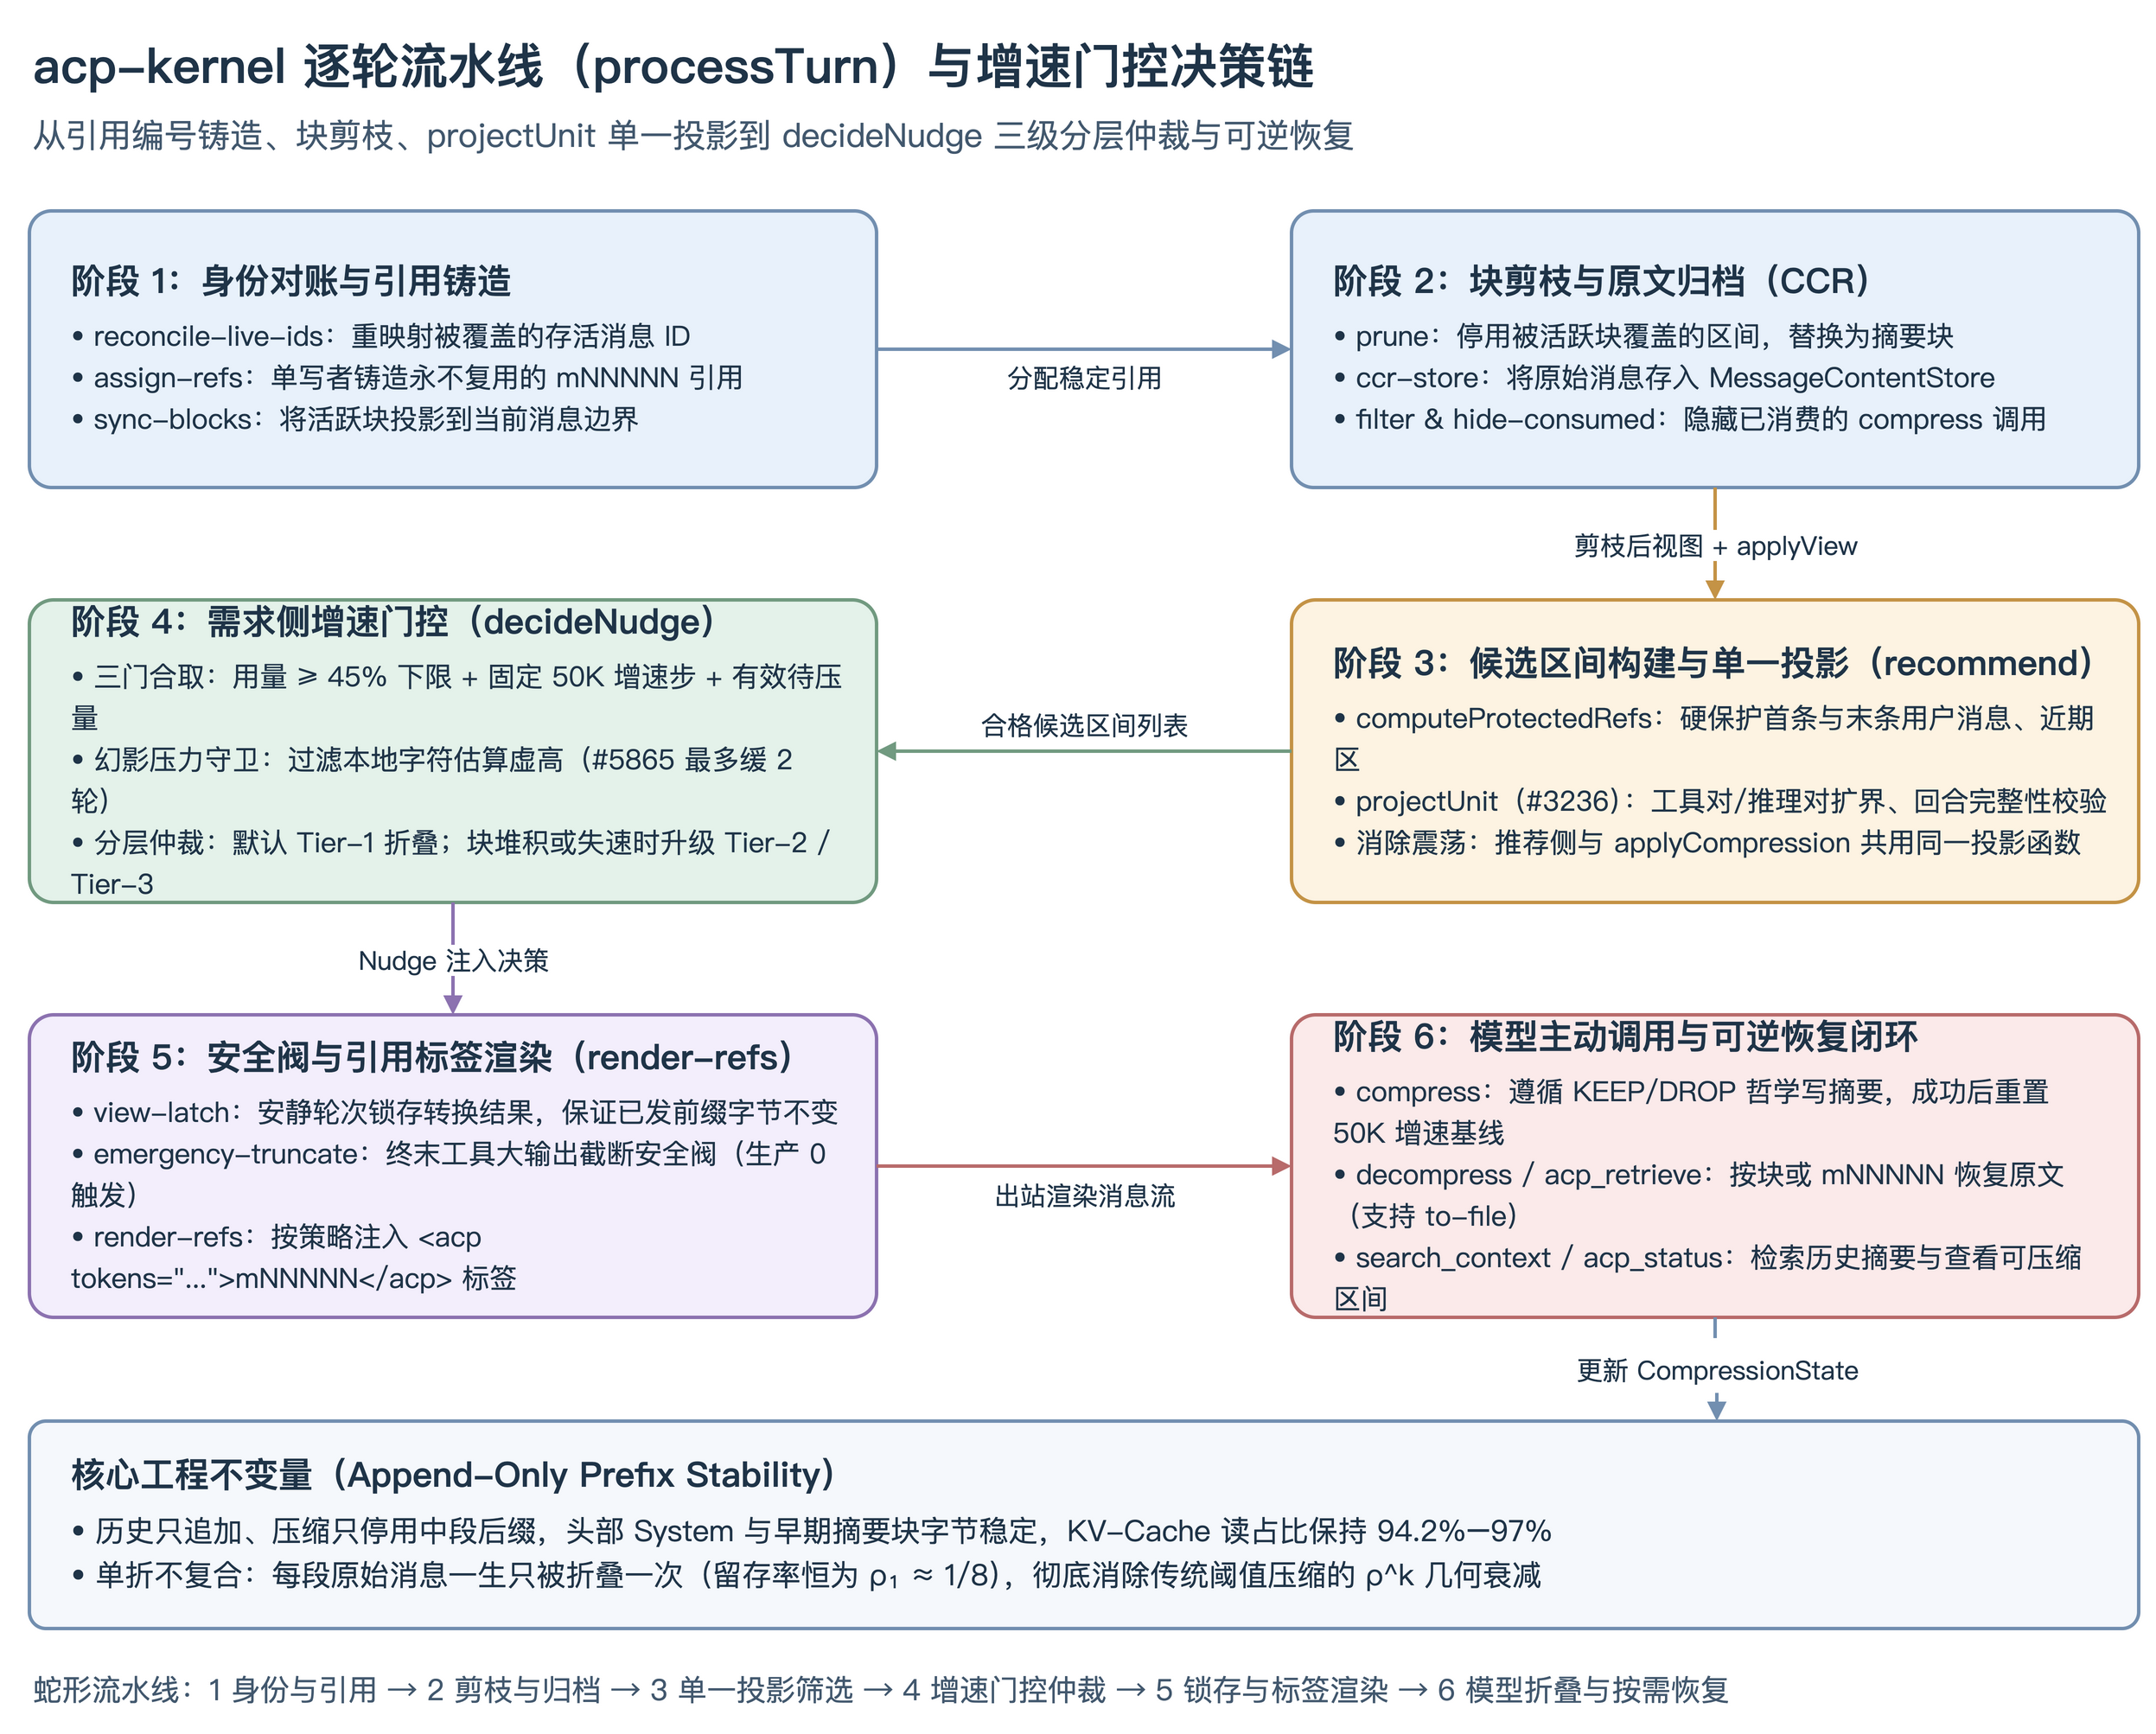
acp-kernel 逐轮流水线与增速门控决策链(基于 kernel/src/compress.ts、unit-projection.ts 绘制)。沿着图 6 的箭头,每一轮请求在内核里依次经历以下处理:
- 身份对账与稳定引用铸造(
reconcile-live-ids→stamp-timestamps→assign-refs→sync-blocks):assignRefsNode是引用映射表state.messageRefs的唯一写者。它为每条新到达的消息分配一个递增的mNNNNN编号(如m00001、m00002)。如果某条消息带有不可恢复的媒体载荷或属于受保护工具,则标记为BLOCKED。随后syncBlocksNode将已有的活跃压缩块对齐到当前消息流边界。 - 块剪枝与 CCR 原文归档(
prune→pre-transform-snapshot→ccr-store):pruneNode把已经被活跃CompressionBlock覆盖的原始消息区间从出站视图中剔除,在原锚点处替换为对应的摘要块。紧接着ccrStoreNode把原始消息存入会话级的MessageContentStore(CCR),供后续模型调用acp_retrieve或decompress时按引用编号无损取回。 - 变换、过滤与压缩调用隐藏(
absorb-hide→crush→absorb-prompt→filter→hide-compress-calls→view-latch):hideCompressCallsNode把已经被消费掉的compress工具调用本身从渲染视图里藏起来——这样模型在调用compress时能看到完整源内容,压完之后连同脚手架调用一起从活动窗口切除,不占后续轮次的上下文。viewLatchNode(Issue #3939)则在没有发生新折叠的“安静轮次”里,直接锁存并重放上一轮已发送消息的转换后字节,防止因动态过滤导致已缓存前缀发生哪怕一个字节的抖动。 - 候选区间筛选与需求侧增速门控(
recommend→nudge):recommendNode扫描未压缩的消息,剔除保护区后合并出推荐折叠的候选区间列表;nudgeNode运行decideNudge,判断本轮是否需要向模型注入压缩提示。 - 终末安全阀与引用标签渲染(
emergency-truncate→render-refs):emergencyTruncateNode是最后一道硬上限保险(只在逼近 100% 窗口时截断超大工具输出,生产 4.5 天快照中触发为 0 次)。最后,renderRefsNode在出站消息文本末尾渲染形如<acp tokens="42" type="text">m00015</acp>的引用标签(源码里用\x3c和\x3e十六进制转义,防止被外部工具误当成 HTML 标签剥掉),让模型在挑选压缩区间时能精确点名。
6. 四个关键工程机制:单一投影、50K 增速门控、压缩哲学与身份防错绑
如果只看论文概念,很容易以为“让模型自己调工具写摘要”几十行代码就能糊出来。真正去读 kernel/src/ 和 src/ 里带 Issue 编号的注释,才能看到作者在 4.5 个月生产踩坑中修补了多少棘手的工程边界。下面挑四个最核心的机制展开。
6.1 单一单元投影(projectUnit,Issue #3236):消除“推荐—拒绝”死循环
在早期版本里,“向模型推荐哪些区间可压缩(recommend.ts)”和“模型提交 compress 时校验该区间能否压缩(compress.ts)”是两套分开写的逻辑。推荐侧在全局消息上做粗筛,而执行侧在单区间上做严格的回合完整性(Turn Integrity)和工具配对(Tool Pair)检查。
这在生产中引发了一个致命死循环:Nudge 提示词热情地向模型推荐“请压缩 m00100–m00150”,模型乖乖照做,结果执行侧报错 Range would split 1 turn(s) 拒绝执行;下一轮 Nudge 又原封不动地推荐同一个区间,模型陷入永久的“被推荐 → 提交 → 被拒”震荡。
为了根治这个问题,Issue #3236 引入了 kernel/src/unit-projection.ts 中的 projectUnit 函数,作为全系统唯一的“该区间能否折叠”定义:
// 来自 kernel/src/unit-projection.ts:
/**
 * #3236: the ONE definition of "can this range fold" — the exact sequence
 * applySingleRange runs before it creates a block: boundary resolution →
 * checkpoint-carrier exclusion (#335/#2663) → pair-boundary widening
 * (tool/reasoning pairs) → nested-block rescan → protected-tool/media/zone
 * carves → turn-integrity withdrawal (#684) → empty check.
 */
export function projectUnit(input: UnitProjectionInput): UnitProjection {
  // ...
  const resolved = resolveBoundaries({
    startRef: input.startRef,
    endRef: input.endRef,
    messages: input.messages,
    state: input.state,
    indexByMessageId: byId,
  });
现在,无论是 applyCompression 真正执行折叠,还是 recommendNode 生成候选推荐列表,亦或是 acp_status 渲染状态面板,全都调用同一个 projectUnit,且强制运行在同一个未剪枝消息数组视图(applyView)上。任何会引发拆回合或触碰保护区的区间,在推荐阶段就会直接返回 fatal 并被降级为不可压缩的间隙(gap),从根源上消除了推荐与执行的分歧。
此外,在 applyCompression 处理多区间批量压缩时(kernel/src/compress.ts 第 785–891 行,Issue #3939),内核还会先克隆一份 preLoopState 快照。如果一个批次里有任意一个区间在执行阶段抛错,整个批次会原子性回滚到 preLoopState,绝不允许出现“前两个区间折成功了、第三个失败导致下一轮重试时二次改写前缀”的双接缝(Double-Seam)缓存击穿。
6.2 需求侧增速门控(decideNudge)与“幻影压力守卫”
传统系统看的是供给侧信号(窗口填满 80% 才动手),而 billion-context 在 decideNudge(kernel/src/compress.ts 第 2141–2551 行)中实现的是需求侧增速门控。
默认情况下,触发温和压缩提示需要同时满足三个门(三门合取):
- 上下文下限门:当前窗口占用率
usage >= minContextLimitPct(默认0.45,即 45%)。 - 固定 50K 增速步(Flat 50K Cadence,KDD #8):自上次压缩(或上次提示)以来,新增 Token 数达到
50,000(有效下限按minGrowthRatio = 0.45折算为22,500Token)。注意,这个 50K 步长是刻意不随窗口大小缩放的——哪怕在 1M 窗口的模型上,每消费 50K 新内容就折叠一次,也是为了让活跃上下文始终留在注意力最可靠的低位区间。 - 有效可压缩体量门:经过
projectUnit筛出的有效待压缩区间总和达到阈值。
在生产运行中,作者发现并修复了三个非常真实的极端工况:
// 来自 kernel/src/compress.ts:
const estimateHoldStreak =
  input.tokenCountSource === "estimate"
    ? (state.nudge.estimateHoldStreak ?? 0) + 1
    : 0;
state.nudge.estimateHoldStreak = estimateHoldStreak > 0 ? estimateHoldStreak : undefined;
const maxEstimateHoldRounds = Math.max(
  0,
  Math.floor(config.nudge.maxEstimateHoldRounds ?? 2),
);
const pressureDeferredNoSample =
  pressure &&
  input.tokenCountSource === "estimate" &&
  config.nudge.requireUsageSampleForPressure !== false &&
estimateHoldStreak <= maxEstimateHoldRounds;- 幻影压力守卫(Phantom-Pressure Guard,Issue #5865):当用户中途按 Ctrl+C 打断一轮生成,或者上游缓存刚过期尚未返回精确的计费
usage时,代理只能靠本地字符数估算tokenCount(标记为tokenCountSource === "estimate")。实测发现这种本地估算往往比实际送入模型的剪枝后账单虚高约 3 倍!如果轻信估算值立刻触发EMERGENCY紧急压缩,就会白白毁掉还没用完的上下文并打穿缓存。因此内核见到estimate来源的高压信号会先按兵不动,最多推迟maxEstimateHoldRounds = 2轮,等下一轮拿到真实的计费usage采样后再决定(同时防止从不返回 usage 的静默后端永久饥饿)。 - 频繁打断下的增速债务银行(Abort-Absorb Debt Bank,Issue #5415):如果用户习惯频繁打断模型(一段 4.5 小时日志里出现过 85 次打断),每次打断重锚定都会把
growthSinceReference清零,导致明明攒了 30 万 Token 待压缩内容却永远跨不过 33.75K 的增速门槛。内核为此在state.nudge.absorbedDebt里设立了“债务银行”:单次礼貌性打断保持安静,一旦连续打断absorbCount >= 2,就把攒下的增速债务计入当前增速,立刻恢复压缩节奏。 - Tier-1 收获失速升级(T1 Harvest Stall Escalation,Issue #5698):有时待压缩池里躺着 450K Token,但模型每次收到 Tier-1 提示只挑最边角的一小段(3K–6K Token)意思一下,导致块越攒越多却排不空(Issue #5671 跑步机现象)。内核会检查上一次折叠实际回收的 Token 是否低于推荐量的
STALL_HARVEST_RATIO;一旦证实 Tier-1 通道失速,只要 Tier-2 或 Tier-3 的摘要块体量达标,哪怕总 Token 数还没超过 Tier-1,也会直接越级触发 Tier-2 蒸馏或 Tier-3 凝结,一口气收掉 90% 以上的积压块。
6.3 压缩哲学(compression-rules.ts):六条交互机制与历史版本演进
模型为什么能写出不丢关键信息的高质量摘要?秘密全在 kernel/src/compression-rules.ts 的四段承重规则(COMPRESS_PHILOSOPHY、HOW_TO_COMPRESS_RULES、TIER2_DISTILL_RULES、TIER3_CONDENSE_RULES)里。
论文 §4 总结了让这套提示词规约真正可执行的六条交互机制:
- 节流的只压增量请求:攒够 ≥22.5K 已消费增量才触发,避免碎片化小折叠。
- 绝不告知窗口占用百分比:Nudge 提示词只给候选区间和它们的 Token 尺寸,从不告诉模型“当前窗口用了 20% 还是 50%”。作者实测发现,一旦告诉模型“目前只用了 20%”,模型就会觉得 200K 窗口还很宽裕而拒绝压缩;隐去百分比后,模型才会纯粹根据“当前任务步骤还需不需要这段内容”来做判断。
- 赋予拒绝压缩的权利:Nudge 明确表述为保持上下文精简的建议(
an efficiency nudge to compress early and keep context lean — not an overflow warning)。如果模型正处在修 Bug 或跨文件重构的半途,它可以不调compress继续干活。 - 对源内容的瞬态注意力:调用
compress那一轮,待压缩原文完整留在窗口内供模型阅读总结;调用一结束,原文连同compress调用一起被隐藏。 - 带真实尺寸的推荐列表:把内核算好的候选区间(起止
mNNNNN、Token 数、工具/文本构成)喂给模型,避免模型瞎猜边界。 - 唯一且永不复用的消息编号(
mNNNNN):无论用于区间选择、块血统追踪还是事后解压,全部按引用 ID 寻址。
更值得细看的是 kernel/src/compression-rules.ts 顶部注释记录的三次生产事故修订——每一条规则背后都是真实的线上踩坑:
// 来自 kernel/src/compression-rules.ts:
export const HOW_TO_COMPRESS_RULES = `HOW TO COMPRESS
...
KEEP VERBATIM — never paraphrase or abbreviate these:
- Full file paths with line numbers, directory prefix on every mention (\`lib/hooks.ts:347\`, \`src/index.ts:12-18\`, \`gatenet_v3/model.py:45\`). Never abbreviate to a bare filename (\`hooks.ts\`, \`model.py\`)...
- User intent — quote short user messages verbatim ONLY WITH their message ref, e.g. \`User said (m00132): "ship it tonight"\`. Without a verifiable ref, paraphrase (\`user previously asked (paraphrased): ...\`)...
- Open objectives carry-forward — if the range (or, when distilling, any source block's summary) contains a user-requested objective that is neither completed nor superseded by the end of the range, the summary MUST keep a one-line \`Open objectives:\` entry naming each still-open objective with its message ref...
- Media re-access handles — URLs and file IDs attached to the range (images or files referenced rather than inlined) MUST appear verbatim in the summary...`;- 2026-09-06 修订(修复模型捏造“当前指令”导致死循环,
billion-context-pi#309):在线上会话01a071dc的b60/b61块中,模型在摘要里自己编造了一句user verbatim '合并了 下一个'并标为CURRENT TASK,导致后续轮次反复重跑已完成的任务。修订后强制要求:引用用户原话必须附上可验证的mNNNNN编号,无编号一律标为转述(paraphrased);且摘要里的任务状态必须写成历史记录(TASK AS OF THIS BLOCK: ...),绝不能写成当前待执行的活指令。 - 2026-09-26 修订(修复多块合并弄丢未完成目标,Issue #1398):线上发现当块
b22合并蒸馏旧块b13时,把用户在b13里提出但尚未做完的一个分支目标给丢了。修订后在 Tier-1、Tier-2、Tier-3 全层级加入了Open objectives carry-forward硬规则:只要某个用户目标还没完成也未被取代,每一代蒸馏都必须原样保留一行Open objectives: ... (mNNNNN)。 - 2026-11-04 修订(保留多模态媒体重访问句柄,Issue #5620):支持折叠带有远程 URL 或 File ID 的图片/文件消息时,由内核机械式提取
MEDIA REFS段落附在摘要末尾,并要求模型在跨层蒸馏时逐字保留这些句柄,以便后续按需重新拉取原图。
6.4 身份层级与标签回声整治:永不模糊匹配、永不触碰签名思考块
在一个透明代理里,客户端每轮都会把历史消息重发一遍。如果客户端中途切换了模型、编辑了某条消息或重启恢复了会话,代理怎么认出“这一轮发来的第 15 条消息,就是上一轮被压进 b3 块里的 m00015”?
AGENTS.md 的 KDD #11 规定了严格的身份裁决层级:msgid > 顺序 (Order) > 内容哈希 (Hash),并且立下一条铁律:永不使用模糊文本相似度(Never fuzzy similarity)。因为一旦用模糊相似把两条长得很像的工具输出错绑在一起,后续调用 decompress 恢复出来的就是张冠李戴的错误代码。当原生插件通过私有信封上行了宿主的稳定 msgid 时,以 (session_id, msg_id, content_hash) 三元组定身份;没有 msgid 的裸代理流量,则走以位置顺序为主、单格内容哈希为硬门的同步阶梯(src/fold-reconcile.ts),遇到任何断链失步直接整轮回退到全量重发路径,绝不靠猜。
同样体现工程严谨性的是对模型输出通道的标签回声整治(KDD #10,Issue #1960 / #2023)。因为入站消息带了 <acp>mNNNNN</acp> 标签,模型有时会在回复正文里模仿写出这些标签,甚至伪造一行 📦 [ACP] Compressed... 假装自己已经调用了压缩工具(Issue #717 曾观察到模型在 2 小时内伪造了 17 次压缩标记,却一次工具都没调)。代理在出站流式过滤器(src/loop/tag-echo-filter.ts)中 enforces 四条不变量:
- 思考通道(Thinking / Reasoning)逐字节绝对不动:Anthropic 的
thinking/redacted_thinking块和 Gemini 的thoughtSignature带有加密签名,客户端落盘后会在下一轮原封不动回放给上游校验。早期 Issue #1882 曾把标签清洗器加在了思考通道上,结果改掉一个字符就导致签名校验失败、整个会话永久报 400 卡死。因此思考通道走createIdentityStreamFilter逐字节透传。 - 模型可见正文通道剥离回声:自动剥掉模型在正文里复读的
<acp>标签和伪造的📦 [ACP]标记。 - 工具调用参数(Arguments)逐字节不动(Issue #1039):模型调用
write或edit写代码文件时,哪怕参数里包含<acp>字符串(比如正好在开发billion-context自己),也绝不过滤,防止改坏用户代码。 - 用户自己发的消息逐字节不动(Issue #463)。
7. 核心数据结构与状态持久化:散文上的三层 LSM 树
打开 kernel/DESIGN.md 与 kernel/src/types.ts,内核围绕三个核心数据结构运转:CoreMessage(宿主无关的规范消息)、CompressionBlock(多代压缩块)与 CompressionState(会话压缩状态)。
// 来自 kernel/DESIGN.md 与 kernel/src/types.ts:
type CompressionBlock = {
  blockId: string;              // "b0", "b1", ...
  runId: string;                // 批次运行 ID(惰性分配,失败调用不递增)
  tier: 1 | 2 | 3;              // 1=原始消息折叠, 2=蒸馏块, 3=超凝结索引
  topic?: string;               // 阶段主题,如 "Issue #83 续作 + PR #86 验证"
  summary: string;              // 模型按 KEEP/DROP 规则生成的摘要文本
  directMessageIds: string[];   // 直接覆盖的原始消息 ID
  effectiveMessageIds: string[];// 传递性覆盖的全部底层原始消息 ID(跨代保留血统)
  directBlockIds: string[];     // Tier-2/3 直接吞并的下层块 ID
  createdAt: number;
  survivedCount: number;        // 存活轮数,驱动 young -> old 晋升
  generation: "young" | "old";
  active: boolean;              // true=当前渲染进窗口, false=已被高层块吞并或已解压停用
};
这里最精妙的字段是 directMessageIds、effectiveMessageIds 与 directBlockIds 的组合:
- 当模型把消息
m00010–m00035压成 Tier-1 块b0时,b0.directMessageIds和b0.effectiveMessageIds都记录这批消息的原始 ID,b0.active = true。 - 随着会话拉长,当场上攒够了多个 Tier-1 块(默认
tier2Trigger = 5个块,或摘要体量超过 1.5 倍增速步),模型收到 Tier-2 提示,把b0..b4蒸馏成一个 Tier-2 块b5。此时b0..b4的active被置为false(从上下文窗口退场,但仍留在状态数组里作为“已消耗血统”),b5.directBlockIds = ["b0", ..., "b4"],而b5.effectiveMessageIds则取b0..b4的并集。 - 当 Tier-2 块继续累积,再按
TIER3_CONDENSE_RULES(每源块仅留 30–60 Token 的纯事实索引)凝结成 Tier-3 块。
这就构成了一棵散文上的三层 LSM 树(罗汉塔效应)。在持久层(src/storage/schema.ts,Schema v11),所有进程重启后需要存活的数据都由单一 WAL 写者写入本地 SQLite 文件(~/.local/share/billion-context/),同时记录每次请求的缓存命中分解,供 Web UI 和 /acp-cache 生成可归因的审计报告:
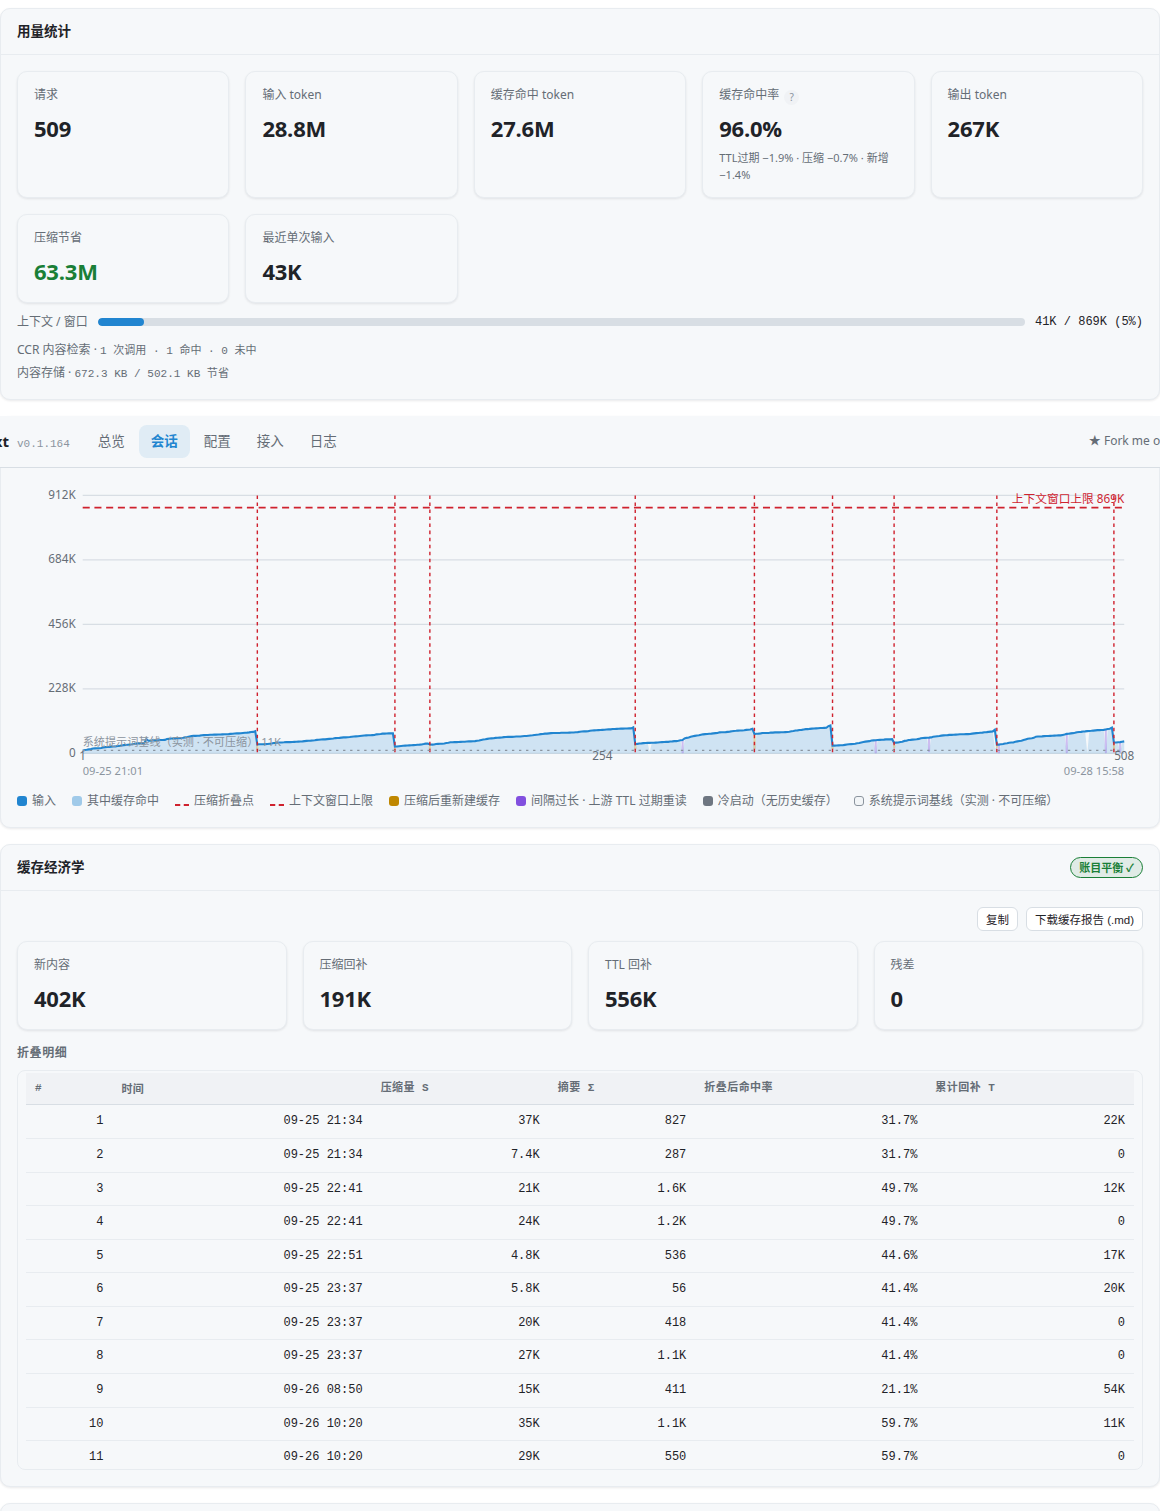
/acp-cache 的会话缓存审计视图(源自 docs/cache-web-session.zh-CN.png)。系统将每一次缓存未命中精确归因为四类:新增内容、压缩重算、上游缓存 TTL 过期,以及中途切换模型(MODEL SWITCHES)或中转号池切换 API Key(KEY SWITCHES)。健康会话的稳定前缀命中率保持在 95%–97%,压缩自身的缓存损耗不超过 2%。8. 形式化验证与安全护栏:把 TypeScript 决策核翻译成 SMT 求解
在 AI Agent 基础设施仓库里,billion-context 有一个非常少见的硬核模块:verif/(Issue #3848)。
为什么一个上下文压缩插件需要上 SMT 形式化求解器?因为在前缀缓存敏感的系统里,“安静轮次(没有发生新折叠的轮次)必须保证已发送的历史前缀字节绝对稳定” 是一条生死线。只要某段边界条件(比如紧急截断门限、孤儿工具调用清理、引用重打标、流式分块切分)写得有一点瑕疵,导致第 轮和第 轮渲染出来的历史消息哪怕多了一个空格或换了顺序,服务商侧几万 Token 的 Prefix Cache 就会瞬间清零,甚至引发每一轮交替翻转的震荡 Bug。
靠人工写几个单元测试很难穷尽所有消息组合。于是作者在 verif/ 下写了一套直接针对仓库真实 TypeScript 源码的符号执行与求解验证框架:
来自 verif/README.md:
"目标:把受保护文件里的真实 TypeScript 逻辑翻译成 SMT 约束,用求解器找违反缓存稳定不变量的反例;反例必须回放真代码复现才算数。
这不是‘根据代码写证明’,也不是‘自己建模’:被翻译的就是仓库里的源文件,翻译器只是镜头,镜头歪了会被回放当场抓住。"
它的工作流由五个部件闭环组成:
- 子语言守卫(
verif/subset-guard.ts+guarded-files.ts):锁定内核决策核文件只允许使用可翻译为 SMT 的确定性 TypeScript 语法子集;谁往守护文件里塞了async或node:fs,CI 秒级报错。 - AST 符号执行器(
verif/symbolic.ts):把真实 TS AST 编译为带ITE(If-Then-Else)值合并的符号值,内联本地函数与跨文件依赖。 - 自研 DAG Term 与 SMT-LIB2 发射器(
verif/terms.ts):绕开z3-solverWASM 版的 2GB 堆内存上限,生成带define-fun共享的 SMT-LIB2 公式。 - 外部求解器桥(
verif/solve.ts):调用cvc5或原生z3求解器,验证通用不变量(如verif-generic-append-stability任意输入下只增不删的字节稳定性,以及verif-induction-append-stability对任意消息数量的数学归纳证明)。 - 真代码反例回放(
verif/replay.ts):只要求解器给出一个SAT(找到反例 witness),立即把这组具体参数代回真实的acp-kernelTypeScript 函数跑一遍。
根据 verif/README.md 记录,这套求解器判官已经独立抓出了多个仅靠人工测试极难构造的深层 Bug——例如 Issue #3945(通用符号输入下自动发现:当两条消息 ID 撞车时会触发重打标,破坏前缀稳定)、Issue #4052(快照渲染判官发现:当最新一条消息与某条已被压缩的旧消息文本完全相同时,最新消息会被整条误丢弃),以及 Issue #4106 / #4107(标签清理器在特定流式分块边界下不幂等)。
与此同时,仓库在工程治理上也立下了严密的纪律(AGENTS.md):任何触碰 kernel/** 的 PR 必须在正文声明 kernel-change: <reason>,强制递增 kernel/package.json 版本号,禁止自动合并(与安全及自更新模块同处最高人工审核档),并通过 tests/golden/wire-contract/kernel.json 锁死所有行为常量。
9. 论文生产实测与 1,500 题第三方基准对比
billion-context 的性能证据分为两层:一是随仓论文报告的 4.5 个月生产遥测与单会话容量仿真,二是仓库 benchmarks/third-party-1500/ 下的 1,500 题跨基准独立盲测。
9.1 生产遥测:马拉松会话、缓存衰减与 286 亿 Token 容量仿真
在 2026 年 4 月 23 日至 9 月 7 日的 4.5 个月生产观察窗口中,论文对三个宿主(OpenCode 日常主力、Pi 编码 Agent、以及搭载本地 vLLM Qwen3.8-27B 的常驻 Linux 自治服务机 ework)进行了全量记账:
- 有界上下文与马拉松轨迹:在 42,986 次运行于 204,800 窗口模型(GLM-5.1)的调用中,峰值上下文停在 198,628 Token,窗口违规次数为 0。在干净的 Pi 宿主(40,574 次调用)上,实测单次调用上下文均值 88.2K、中位数 72.1K、p90 144.9K。最长的一场 OpenCode 马拉松会话连续执行了 12,049 次调用(累计输入 15.2 亿 Token),全程上下文在 50K–375K 的有界锯齿区间内平稳震荡(均值约 126K)。
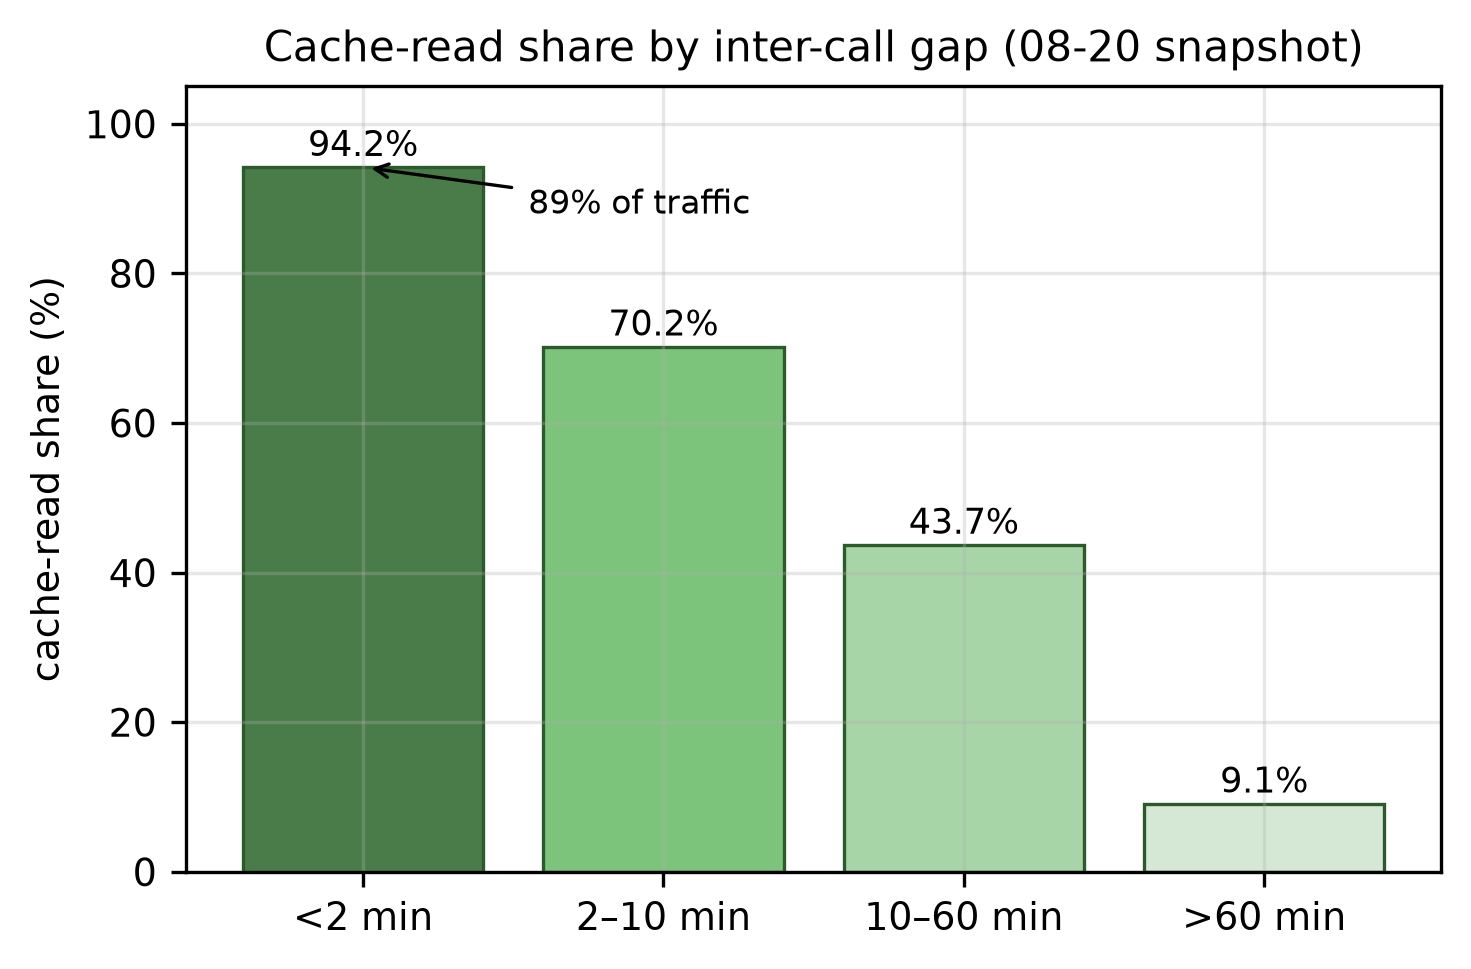
- 缓存命中率分层归因:由于历史只追加、压缩只停用中段后缀,压缩本身从不使 KV-Cache 前缀失效。对 32.7 万对连续调用的间隔分层显示(图 9):在调用间隔 < 2 分钟的活跃编码节奏下(占全部流量的 89%),实测缓存读占比高达 94.2%;间隔拉长到 10–60 分钟时降至 43.7%,超过 60 分钟降至 9.1%。未命中归因证实,仅 16% 的未命中来自新增后缀,其余 84% 均为休眠期间服务商侧缓存 TTL 自然过期。这也解释了为什么不需要把压缩拆给带外异步子 Agent:在带内执行
compress时,它读取的历史本身就是已经命中的稳定缓存前缀,输出又被限制在 2K Token 以内,带内压缩的边际成本本就接近地板。
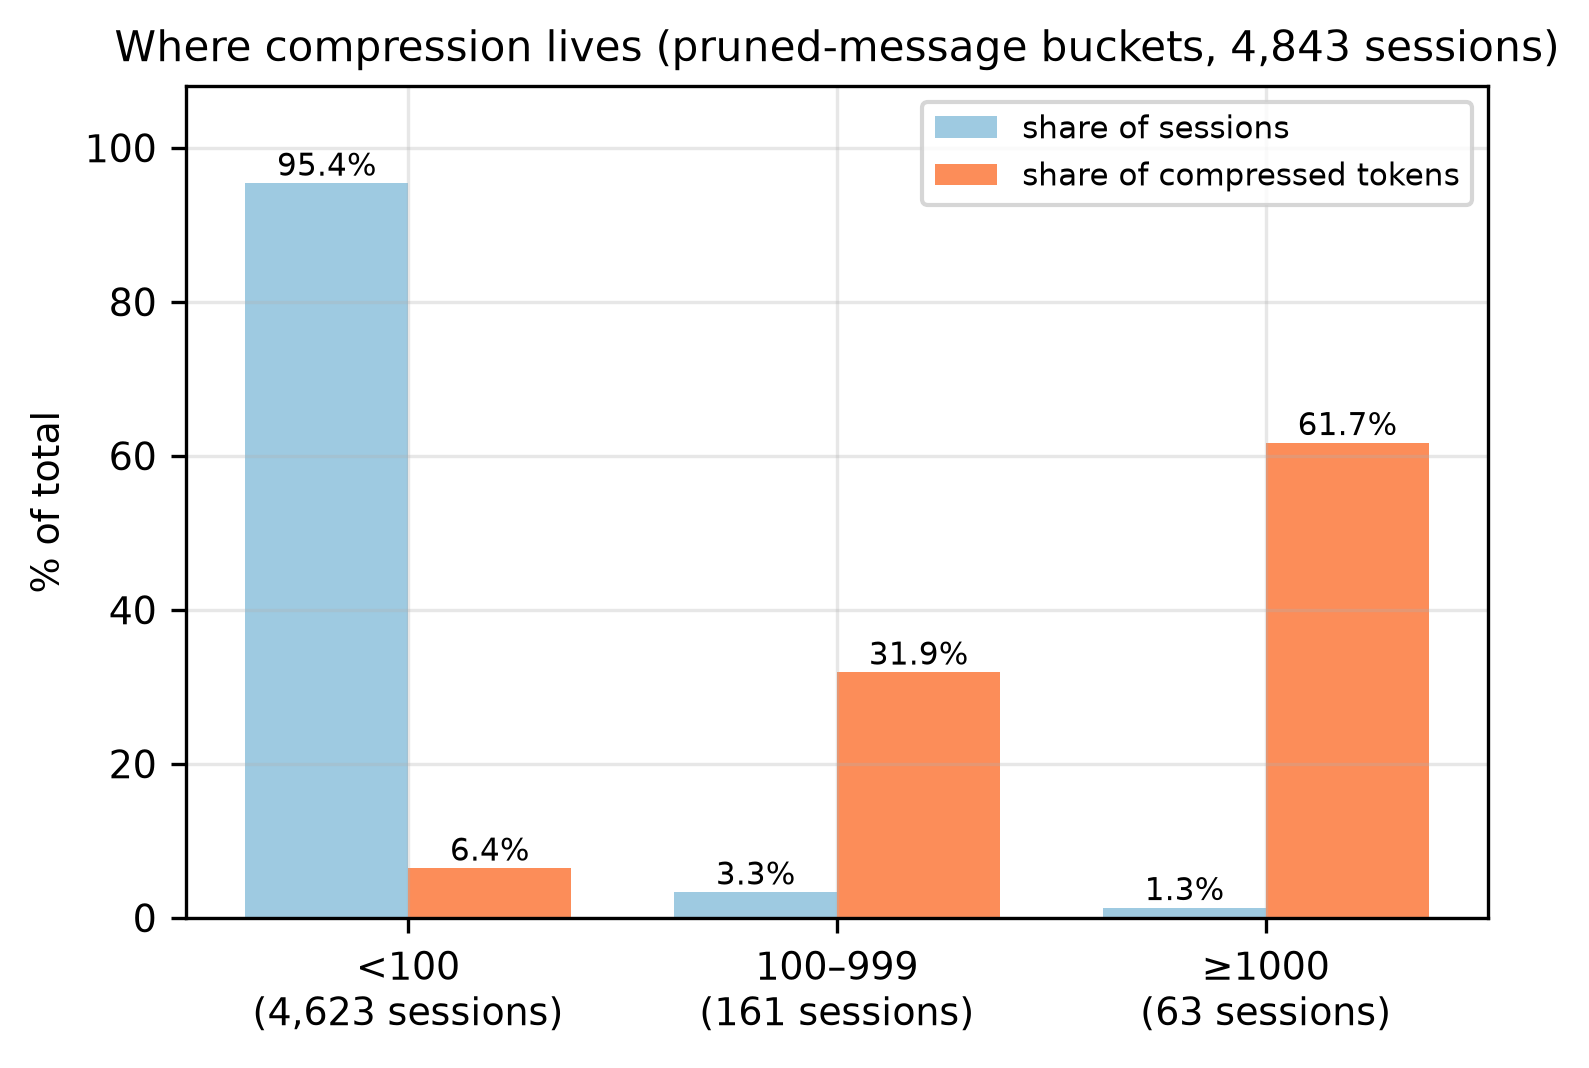
- 上下文管理是“马拉松现象”:统计全部 4,843 个会话的 2.29 亿被压缩 Token 可以发现(图 10),61.7% 的压缩活动集中在仅占总数 1.3% 的“超千条消息”长会话中(消息数 ≥100 的 4.4% 会话贡献了 93% 的压缩量)。这意味着短平快的十几个回合基准测试根本测不出上下文压缩的真实价值与退化问题。
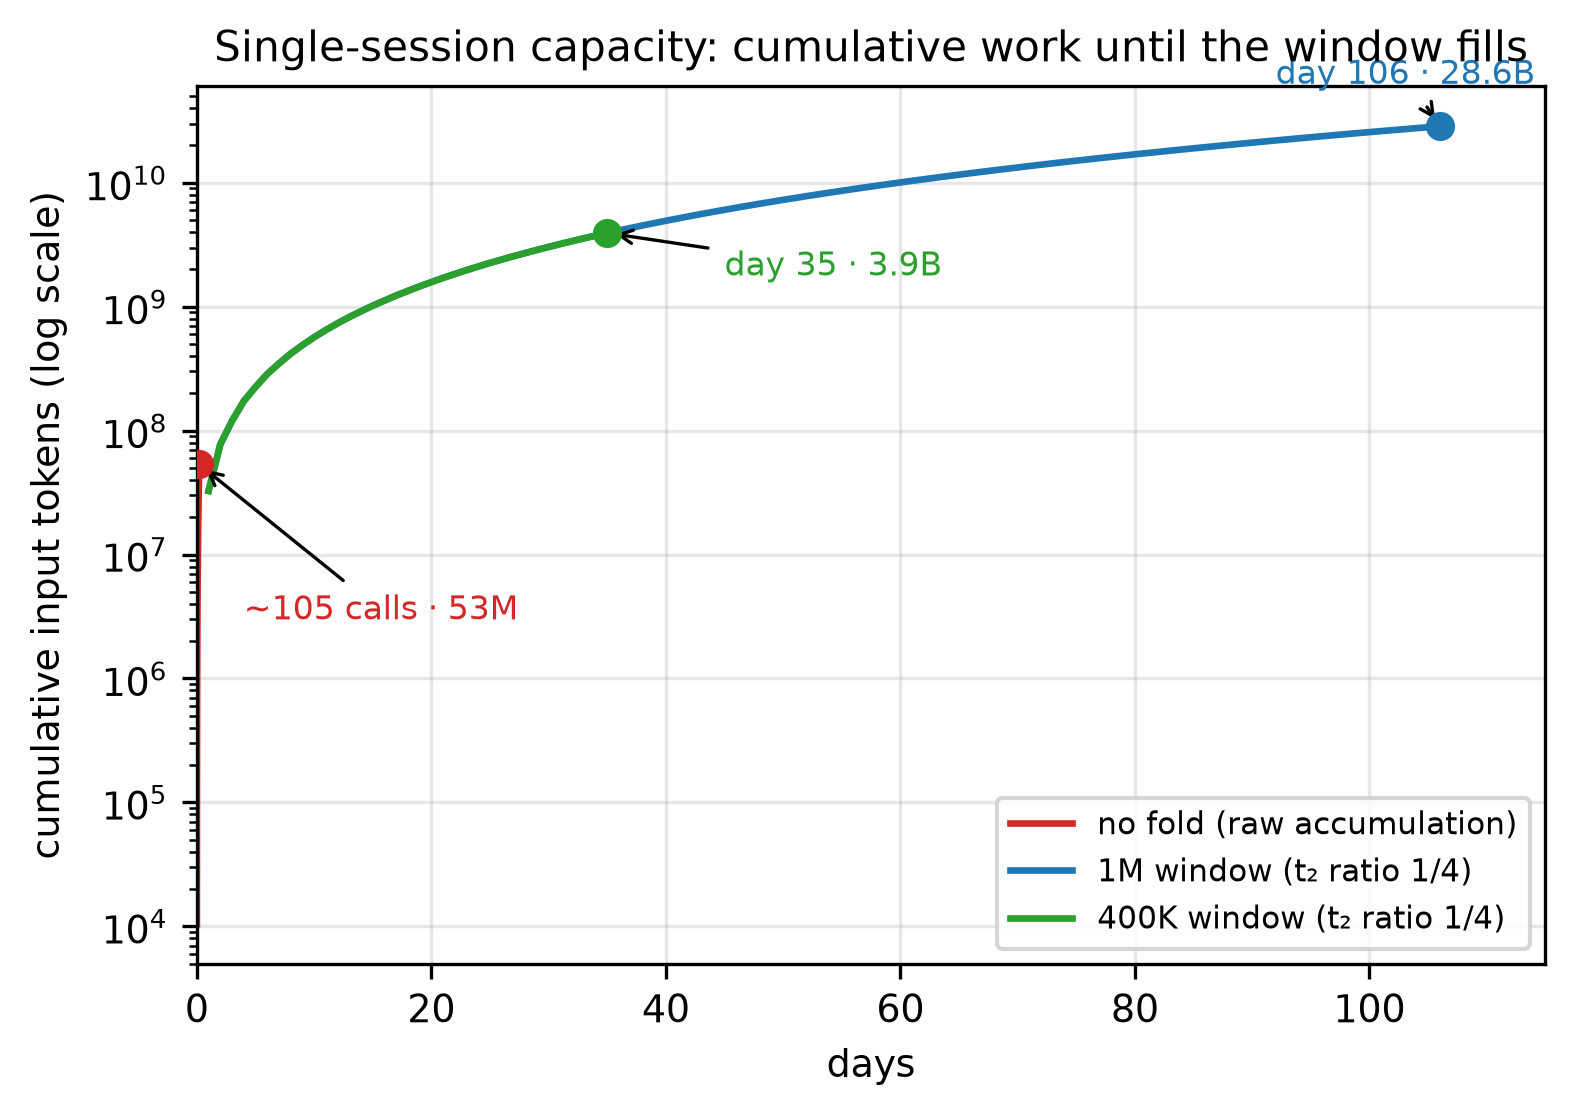
- 单会话容量天花板仿真(286 亿 Token / 106 天):凭借 Tier-1(中位约 1/8,工具密集块 p75 约 1/45)→ Tier-2(实测流量加权约 1/4)→ Tier-3(设计值 1/3)的三级罗汉塔递缩,按每天 500 次调用、每次新增 9.6K Token 的重度节奏做离散事件仿真(图 11):如果没有折叠,1M 窗口在 104 次调用(约 5,300 万累计输入 Token,不到半天) 就会撞窗死亡;而开启三级折叠后,400K 窗口可支撑 35 天(39 亿累计输入 Token),1M 窗口理论上可连续工作 106 天、处理 286 亿(28.6B)累计输入 Token 后才会被蒸馏摘要体本身填满——单会话可承载总工作量放大了约 550 倍。
9.2 1,500 题跨三大基准独立评测(对比 full 与 3 种 RAG)
为了在标准公开数据集上检验 billion-context(评测版本 v0.1.202,底座模型统一为 DeepSeek V4.1 Flash,向量与重排采用 Qwen3-Embedding-8B + Qwen3-Reranker-4B),项目在 benchmarks/third-party-1500/ 下公开了横跨 LongMemEval-S(500 题)、ContextBench(500 题,Pi Agent 跑 58 个真实代码库)与 MemoryAgentBench(500 题,最高 1.48M Token)共 1,500 道题的五臂盲测对比(bc、full、bm25、embedding、embedding-rerank):
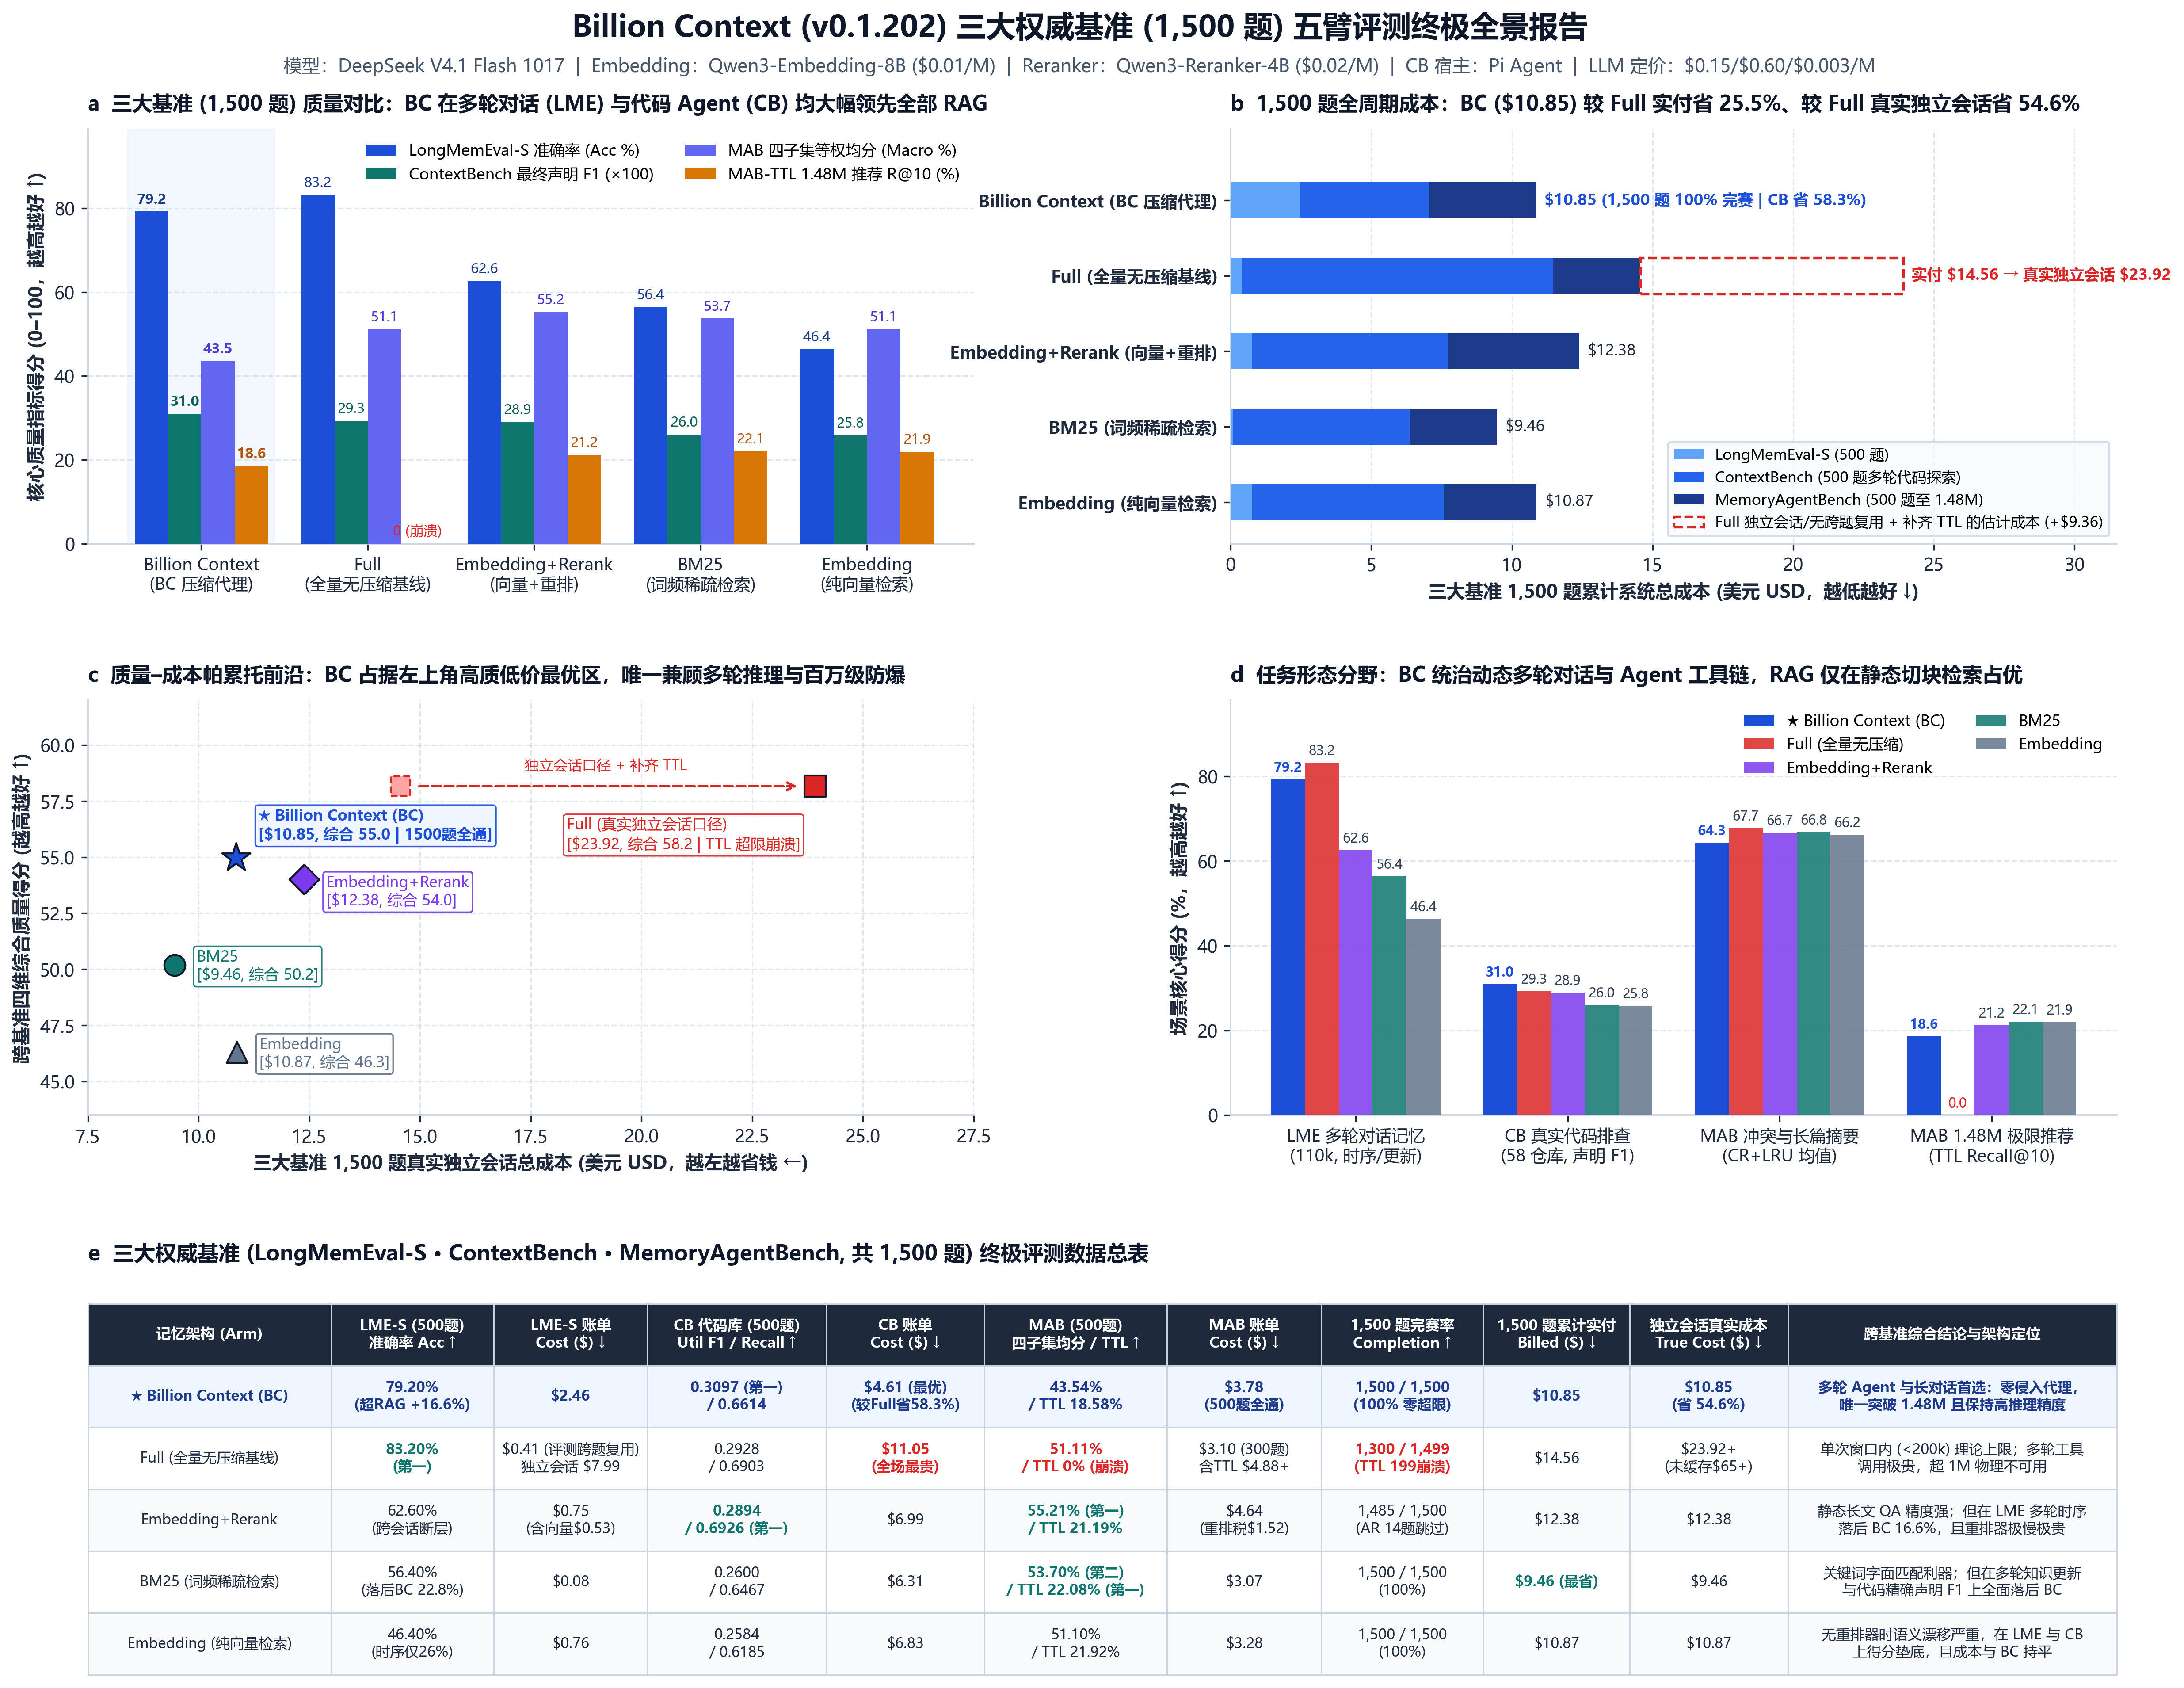
benchmarks/third-party-1500/all_benchmarks_5arms_summary.png)。三组基准的结果把 billion-context 的优势区间和能力边界照得非常清楚:
- 真实代码库多轮探索(ContextBench 500 题):质量与成本双杀,全场第一
在使用
Pi CLI对 58 个真实开源仓库做多轮 Bug 定位时,billion-context的端到端有效 F1(0.3097Utilized F1)和证据准确率(0.3358Precision)双双拿下全场第一,不仅显著压过三条 RAG 管线(0.2584–0.2894),甚至反超了不压缩的full原生全量上下文(0.2928),同时总账单($4.61)比full($11.05)节省 58.3%,比所有 RAG 管线($6.31–$6.91)都便宜。原因很直观:在多轮代码搜索中,中间轮次大量的grep试错和大文件读取会严重稀释模型对关键代码的注意力;主动把已消费的工具噪音折叠成结构化摘要,反而帮模型聚焦了注意力。
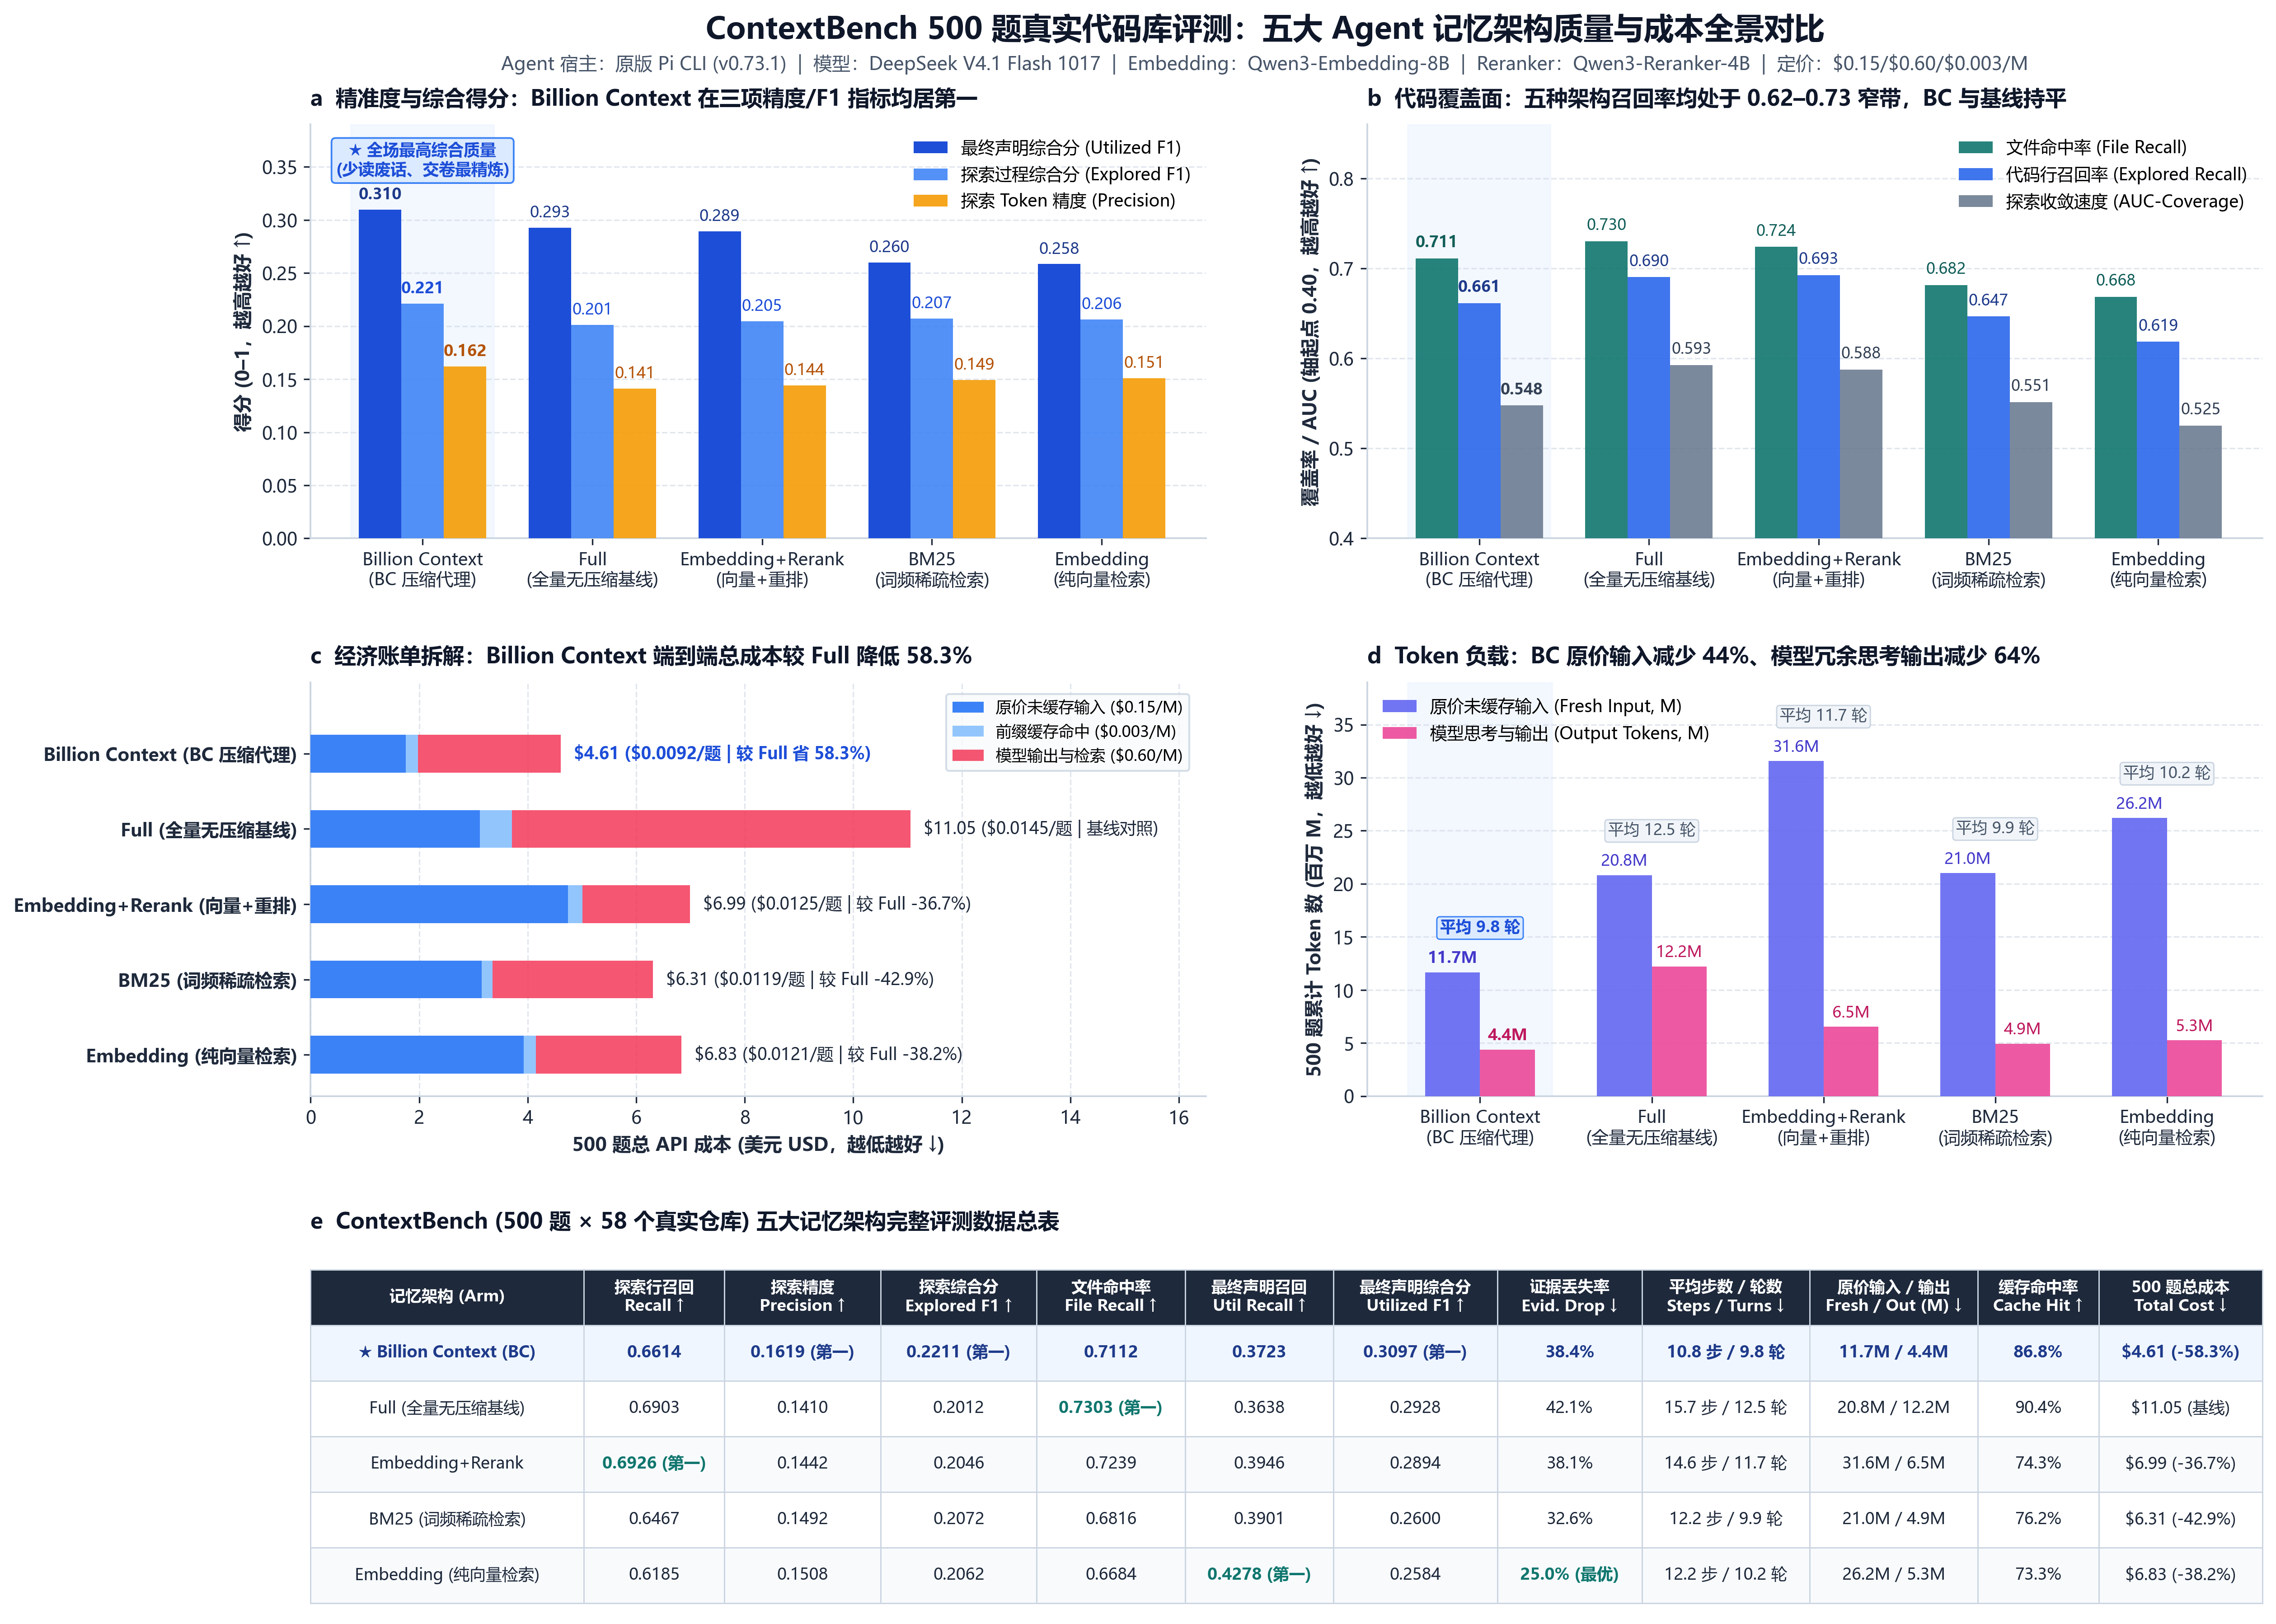
benchmarks/third-party-1500/contextbench_5arms_comparison.png)。bc 在 Utilized F1 与 Precision 上均超越 full 原生全量上下文及全部 RAG 臂,且总成本最低。- 伴随式多会话记忆与时序更新(LongMemEval-S 500 题):大幅领先 RAG,保留 95% 全量性能
在约 110K Token 的多会话历史中,
bc取得 79.20% 的综合准确率,逼近full(83.20%),比最强的embedding-rerankRAG(62.60%)高出 +16.60 个百分点。差距最大的是跨会话推理(MSR,bc79.70% vs RAG 45.11%)和时序推理(TR,bc70.68% vs RAG 49.62%)——传统分块 RAG 切碎了事件发生的前后顺序与状态覆盖关系,而分层摘要的KEEP VERBATIM与目标演进规则完整保住了时间线。在独立会话真实成本口径下,bc仅需$2.30,比full($7.97)节省 71.1%。
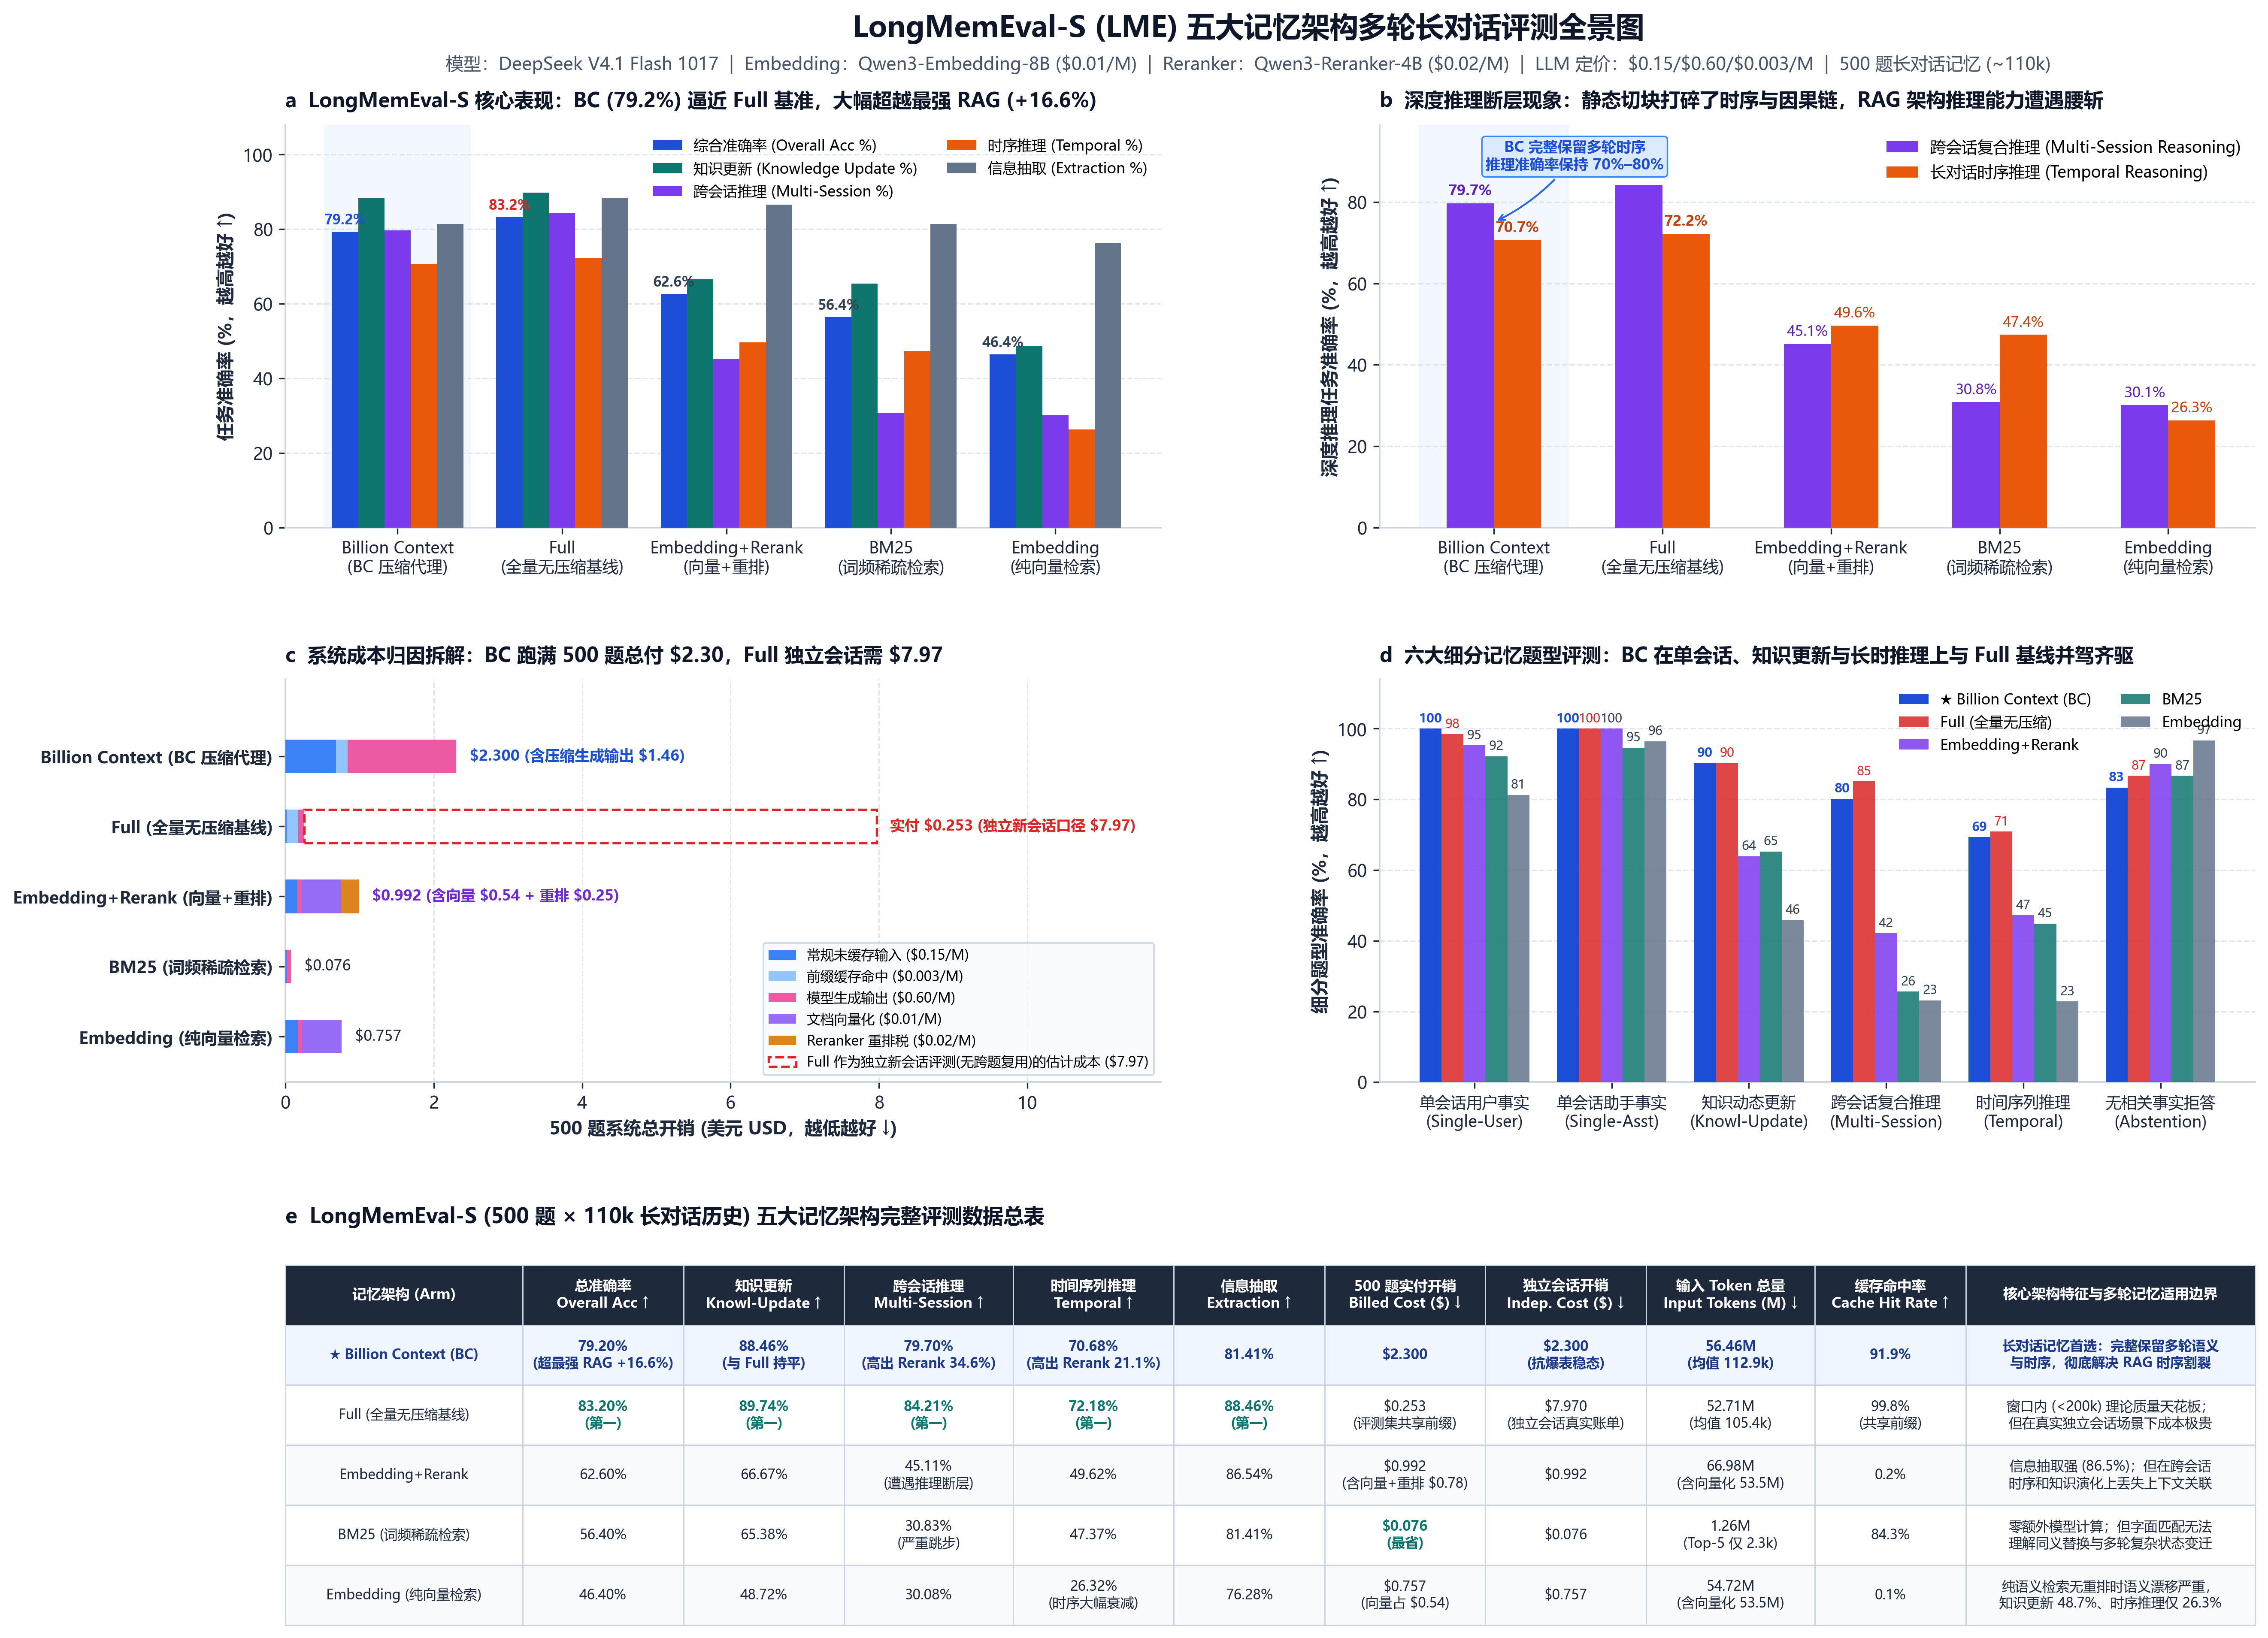
benchmarks/third-party-1500/longmemeval_5arms_comparison.png)。在跨会话推理(MSR)与时序推理(TR)上,bc 远超所有 RAG 方案。- 极端静态长文压力测试(MemoryAgentBench 500 题):1.48M Token 100% 存活,同时暴露逐字大海捞针边界
在高达 1.48M Token 的超长交互推荐任务(
TTL)中,原生full上下文 100% 触发爆窗崩溃(199/199 题全部 HTTP 400 失败,得分为 0);而bc将 148 万 Token 平滑折叠至约 16K 稳态窗口(均值 49.5K,约 30× 压缩比),实现 100% 零报错存活并拿到 18.58% Recall@10。但与此同时,在 19.7 万字静态长文中寻找单句孤立事实的**精准针尖检索(AR/ RULER QA)**子任务上,bc的精确匹配率(27.00%)明显低于full(69.00%)和embedding-rerank(66.33%)。
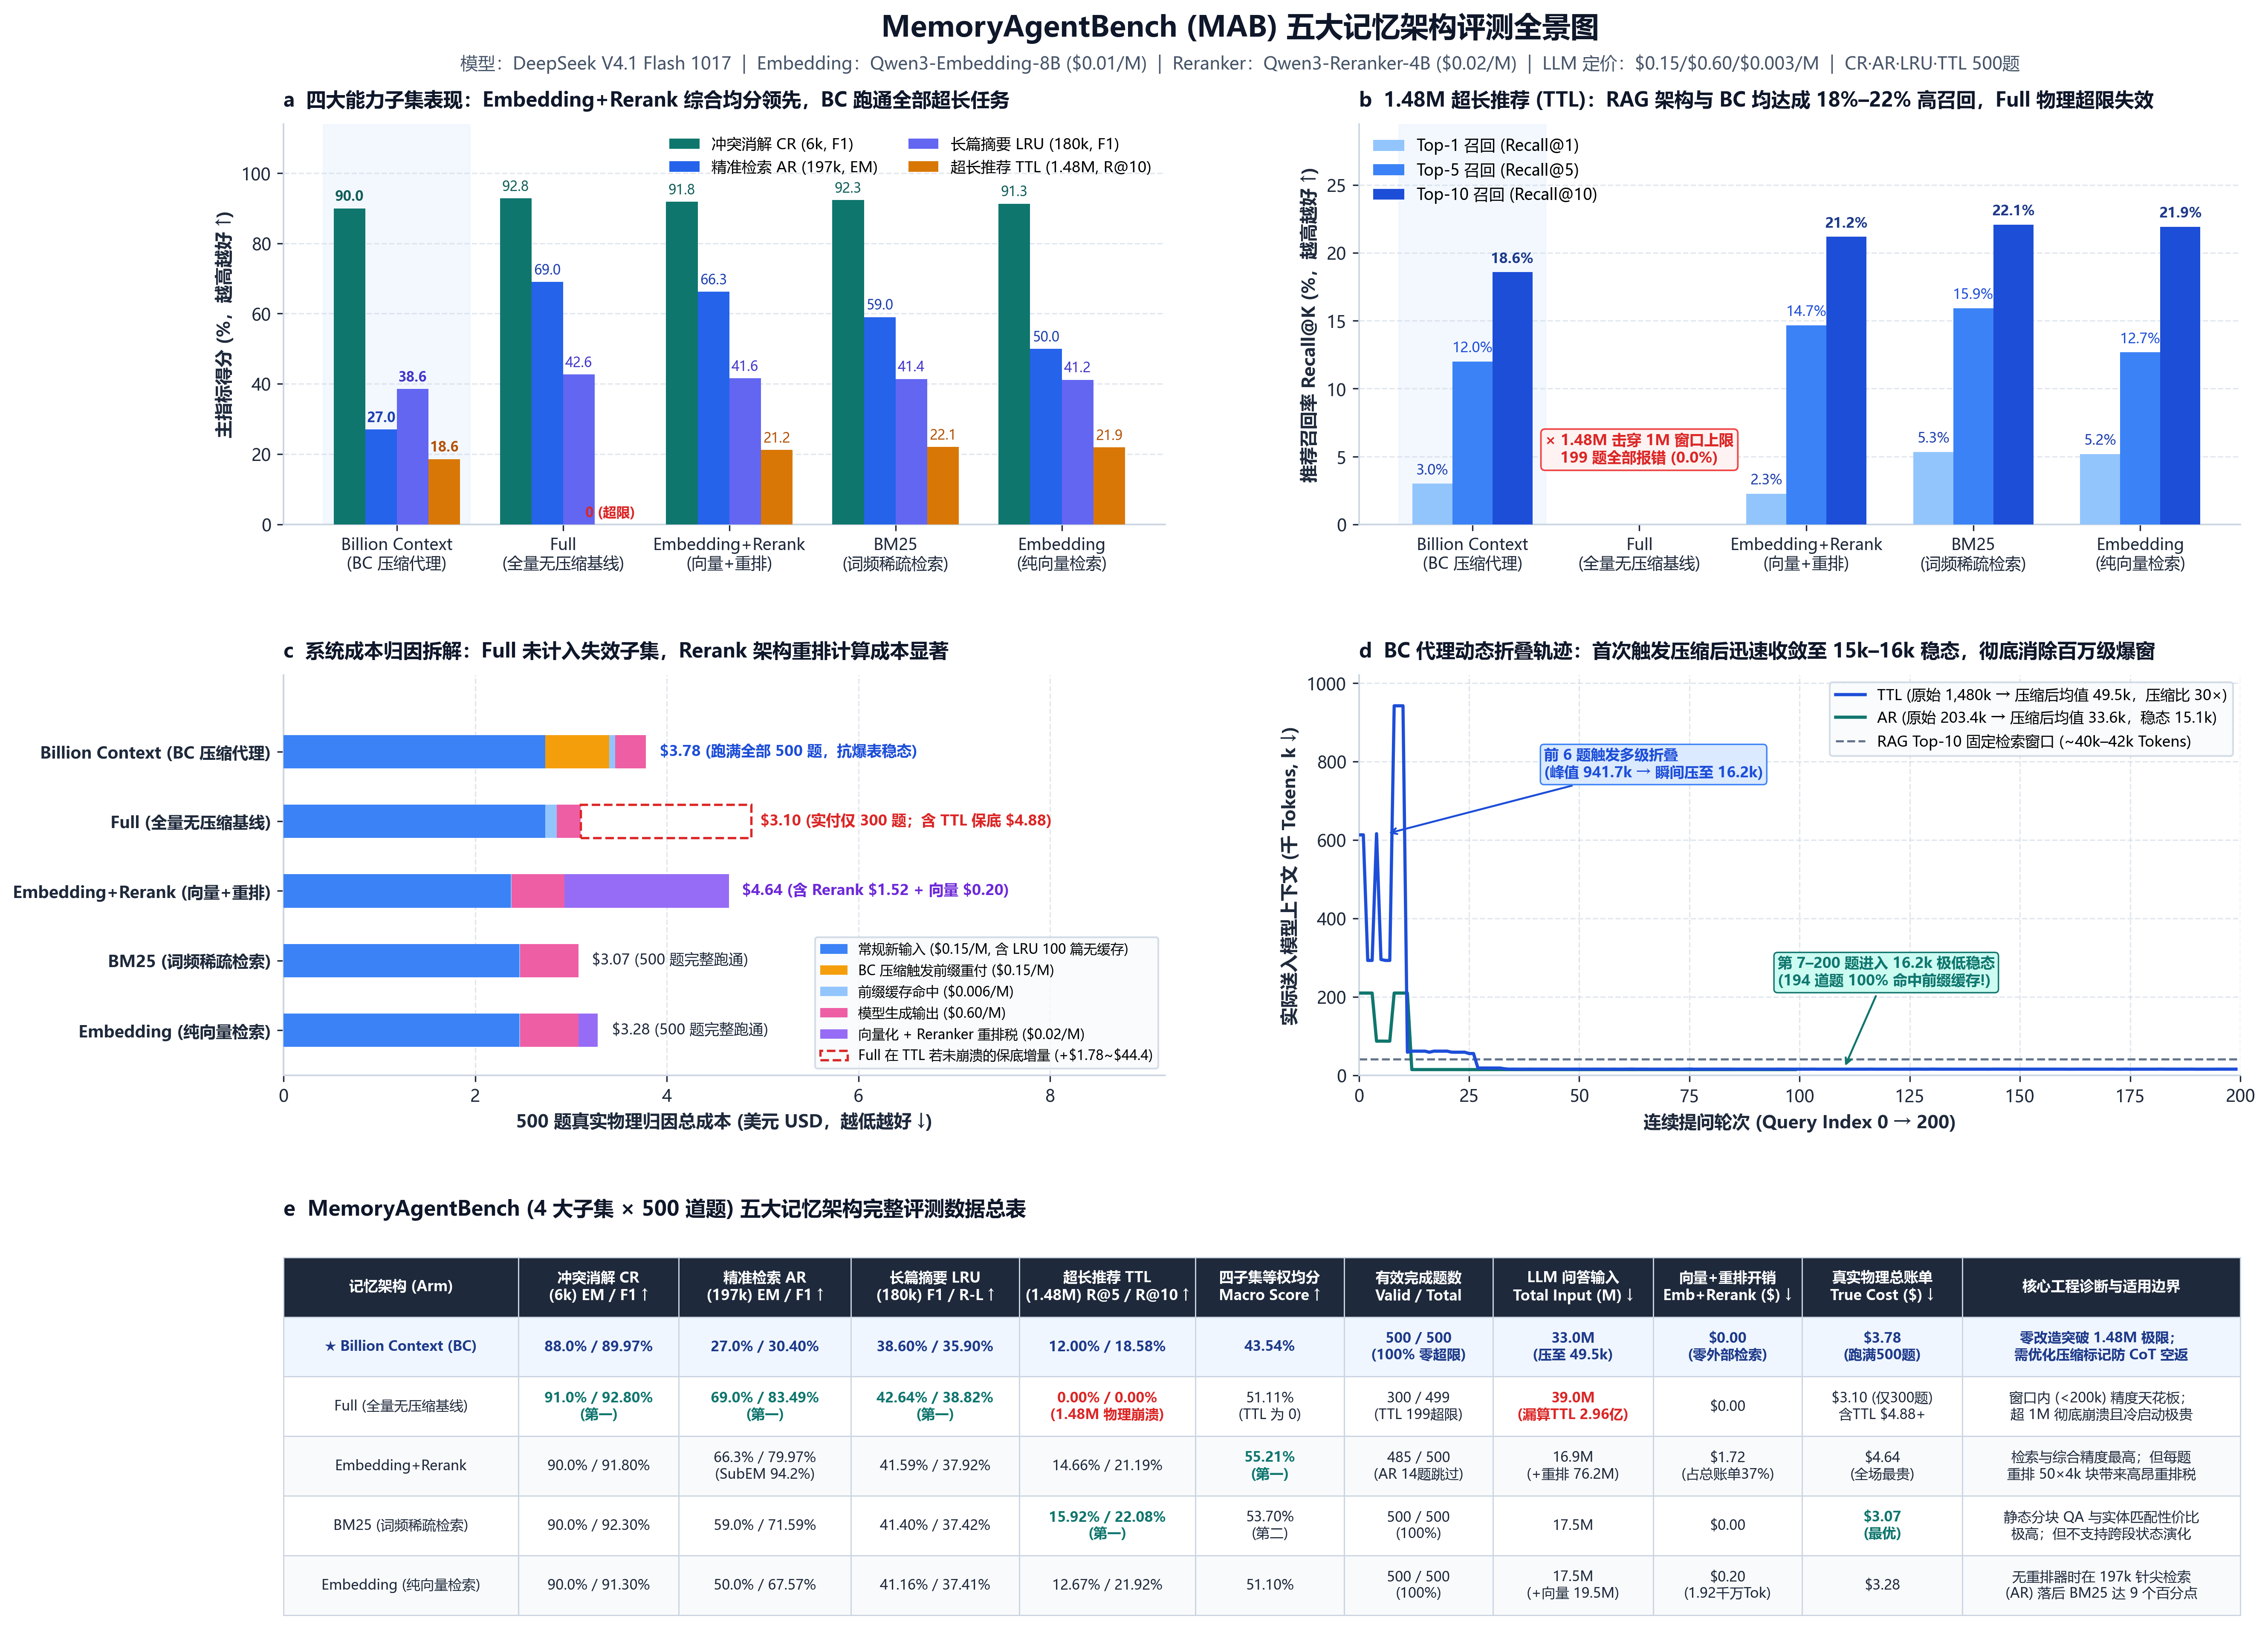
benchmarks/third-party-1500/mab_5arms_comparison.png)。bc 在 full 100% 崩溃的 1.48M TTL 任务上实现 100% 存活,但在静态单句逐字针尖检索(AR)上体现了有损语义压缩的客观边界。10. 适用边界与源码阅读索引
10.1 适用边界与局限性
作者在论文第 1 节“我们不宣称的(What we do not claim)”和第 9 节中,非常坦诚地划出了这套架构的边界:
- 不适合未经解压的“静态逐字大海捞针”:正如 MemoryAgentBench 的
AR子任务所示,如果任务要求在 20 万字静态文档里一字不差地背出某一句事前毫无征兆的孤立细节,有损语义摘要在折叠时必然会抹平非承重的局部字面细节。这类场景更适合用 RAG 索引或显式调用search_context+decompress。 - 中等规模模型尚不会“自发”调用解压工具:论文 §8.1 受控实验发现,虽然内核提供了完备的
search_context和decompress(含不破坏缓存的decompress-to-file),当提示词明确指示模型去搜索恢复时,6/6 轮全部成功还原了重命名前的标识符;但在没有任何外部提示时,当前评测规模的模型(如Qwen3.8-27B)自发调用解压工具的次数为 0——模型倾向于直接拿常驻摘要作答,而不是主动怀疑“摘要里是不是漏了细节、我该解压看看”。这也是作者在 §9 提出下一步将“压缩与恢复哲学通过 SFT 蒸馏进模型权重”的直接原因。 - 不缩小宿主本地的会话历史文件(Issue #5796):
billion-context压缩的是发往模型 API 的网络报文,绝不篡改客户端自己落盘的用户历史文件。同时为了防止两个压缩器打架,原生插件会关掉宿主的自动压缩。因此当单个会话跑到 3 万条消息以上时,宿主自己读取本地大文件会导致每轮变慢,此时仍建议开启新会话。 - 小窗口下的固定哲学开销:4 条承重压缩规则本身大约占 2K Token。在 ≥64K 窗口上这笔开销完全可以忽略且能被前缀缓存命中,但在 16K 这类极小窗口下会占掉约 25% 的每轮固定预算(为此内核提供了精简版
leanPack)。
10.2 源码阅读索引
如果你想动手读一遍 billion-context 的实现,或者把它的折叠思想移植到自己的 Agent 框架里,推荐按下面这条最短路径阅读:
- 全局契约与铁律:先读根目录
AGENTS.md(18 条关键设计决策 KDD 与内核边界规则)和docs/architecture.zh-CN.md。 - 纯函数内核设计:读
kernel/DESIGN.md与kernel/src/types.ts,理解CoreMessage、CompressionBlock与CompressionState。 - 压缩哲学提示词原文:直接打开
kernel/src/compression-rules.ts,看COMPRESS_PHILOSOPHY、Tier-1HOW_TO_COMPRESS_RULES、Tier-2TIER2_DISTILL_RULES和 Tier-3TIER3_CONDENSE_RULES是怎么写KEEP VERBATIM与DROP的。 - 单一单元投影与流水线:读
kernel/src/unit-projection.ts(projectUnit)和kernel/src/compress.ts(processTurn的 16 个节点、applyCompression批量事务与decideNudge增速门控)。 - 代理管道与双模循环:读
src/server/lane-decisions.ts、src/server/handle.ts与src/loop/core.ts。 - SMT 形式化验证:读
verif/README.md与verif/symbolic.ts,看如何用求解器锁死前缀字节稳定性。
总结
billion-context 最值得借鉴的地方,是它没有把长上下文问题推给“等模型厂商出 10M 窗口”或“自己训一个专用压缩小模型”,而是用一套极其克制的系统工程组合拳,把问题就地解掉了:
- 用只压已消费增量 + 停用后缀替代全量重写,保住了 94.2% 的 KV-Cache 前缀命中率,并消除了多轮摘要的 几何失真;
- 用**散文上的三层 LSM 树(Tier-1/2/3)**压住摘要体自身的膨胀,让窗口占用常驻在模型注意力最可靠的 100K 左右区间;
- 用版本化的压缩哲学 + 固定 50K 增速门控 +
projectUnit单一投影,让通用前沿模型零样本就能安全地管理自己的上下文; - 再用 SMT 求解器形式化验证 + 单写者契约 + 思考块签名透传,把透明 HTTP 代理在 20 多种真实客户端上最容易踩的缓存击穿和协议死锁全部钉死在测试里。
对于正在构建长周期编码 Agent、GUI Agent 或自动化测试 Harness 的团队来说,这套“纯函数压缩内核 + 显式提示词规约 + 前缀缓存友好布局”的架构,完全可以直接作为上下文层的参考蓝本。
参考链接
- GitHub 仓库:
ranxianglei/billion-context - 随仓开源论文(中文版):
paper/模型驱动的分层增量压缩-免训练多代上下文管理.md - 随仓开源论文(英文版):
paper/model-driven-incremental-hierarchical-compression-training-free-multi-generational-context-management-for-long-lived-coding-agents.md - 1,500 题跨三大基准独立评测报告:
benchmarks/third-party-1500/README.zh-CN.md - 实时架构总览文档:
docs/architecture.zh-CN.md