GUI-HARVEST 论文拆解:当模型权重冻结,如何从重复视觉执行证据中演化出可复用的 GUI Agent Harness
深度解析 arXiv:2610.00948 GUI-HARVEST:拆解 GAFT 视觉机械事实提取、K=3 同任务重复执行对照、两阶段跨任务失败模式聚类、带事前行为预测的源码补丁与双门禁校验,以及它在 OSWorld-Verified 与 WindowsAgentArena 上的实验证据和边界。
过去一年,自动优化 Agent Harness(包裹在模型外围的提示词、上下文拼装、工具接口、恢复与终止控制代码)的工作大多集中在数学推理、代码生成和命令行任务上,代表性方法包括 Meta-Harness、Self-Harness、GEPA 和 STOP。这些方法面对的主要是文本轨迹:工具返回什么字符串、单元测试报什么错,基本都写在日志里。
一旦把优化对象换成操作真实桌面软件的 GUI Agent,纯文本轨迹驱动的 Harness 优化器就会失灵。香港中文大学(深圳)、天津大学、哈尔滨工业大学(深圳)、华东师范大学与深圳市大数据研究院联合发布的 GUI-HARVEST: Self-Improving GUI Agents through Evidence-Driven Harness Evolution(arXiv:2610.00948,代码仓库 GaryYang12345/GUI-HARVEST)直接切中了 GUI 场景下自动演化 Harness 的三个耦合难题:
- 模型意图与实际视觉效果脱节:模型的思维链或动作日志可能声称“已点击保存并完成任务”,但屏幕截图上保存对话框依然打开,或者输入框仍处于带蓝色下划线的未提交编辑态。只看文本轨迹会把虚假完成当成正常结束。
- 执行结果存在高随机翻转(Flip):哪怕固定模型权重、固定 Harness 代码并采用确定性解码(Deterministic Decoding),同一个桌面任务跑三次也会因为系统时钟、后台弹窗、渲染延迟或焦点变化而走出截然不同的分支。论文实测在 OSWorld-Verified 全量 361 个任务上,六种基座模型跑 次时,有 11.8% 至 20.4% 的任务同时出现 0 分和正分。单条失败轨迹不足以代表模型与任务交互的全貌。
- 单任务修补难以跨任务泛化,且涨分不等于修对了根因:针对单个任务硬编码的补丁很容易过拟合;而即便候选 Harness 在搜索集上总分微涨,也可能是执行随机波动带来的巧合,未必真正消除了原先诊断出的失败模式。
围绕这三个问题,GUI-HARVEST 在完全冻结底层多模态模型权重的前提下,设计了一套从重复多模态执行证据到有界源码修改的自动优化流程。在 OSWorld-Verified 上,它仅用 15 步预算的搜索集轨迹做优化,就能让全部 6 个基座模型(涵盖通用开源模型 Qwen3-VL-8B/32B、GUI 专用模型 OpenCUA-32B/72B 与闭源前沿模型 Gemini 3.1 Pro、GPT-5)在密封测试集上取得 +1.49 至 +10.16 个百分点的提升,其中 Qwen3-VL-32B-Instruct 在全量 361 题上提升 12.33 个百分点(从 38.61% 升至 50.94%)。将演化后冻结的 Harness 直接迁移到 WindowsAgentArena(50 步预算、零 WAA 轨迹参与优化),GPT-5 的成功率从 50.88% 提高到 64.75%(+13.87 个百分点)。
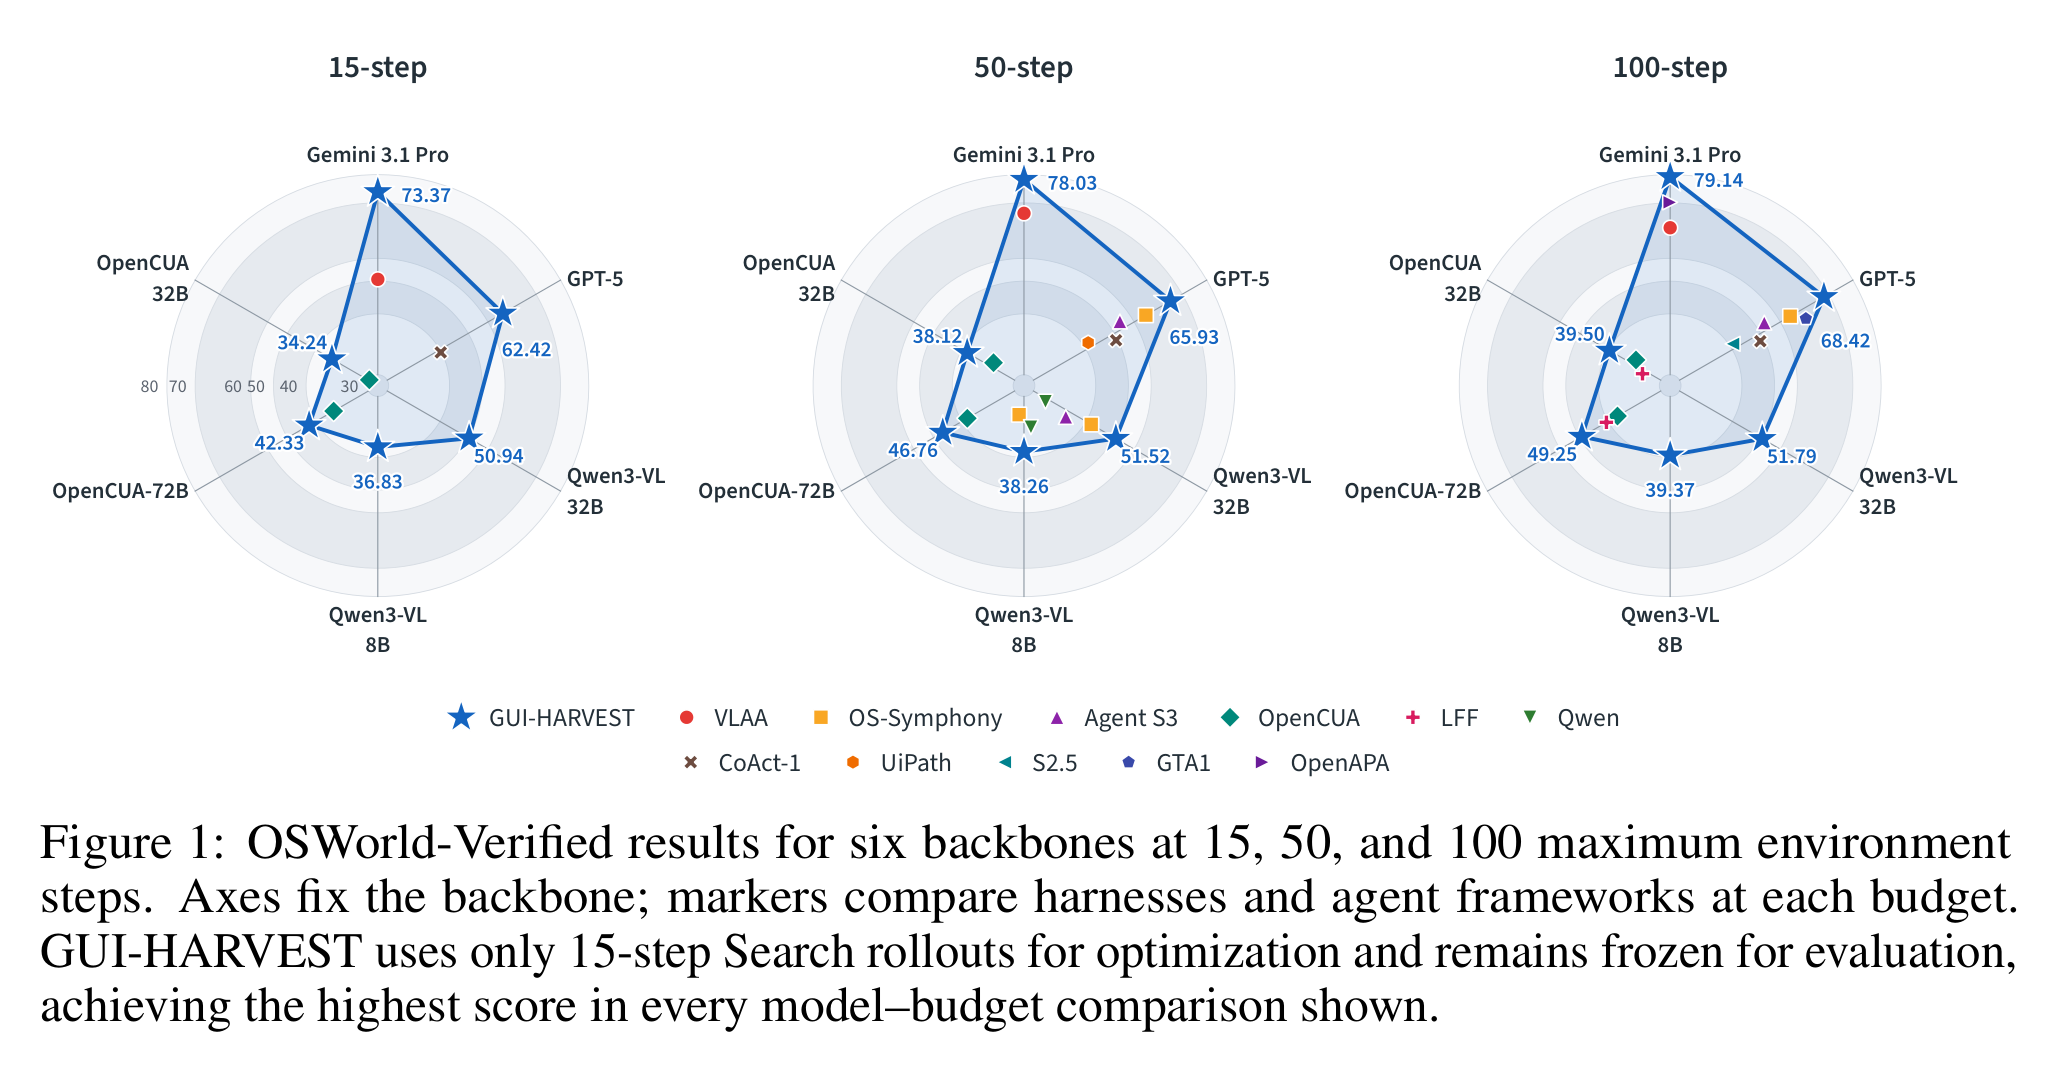
下文结合论文正文与附录中的完整算法、形式化定义、Prompt 契约与端到端真实演化案例,逐层拆解 GUI-HARVEST 的设计机制、实验数据与面向移动端自动化测试(Mobile QA)的工程启示。
目录
- 为什么通用 Harness 优化器在 GUI 场景水土不服
- 问题形式化与防泄漏实验协议
- 核心架构拆解:四个角色与五道校验门禁
- 真实案例追踪:一条
EDIT_NOT_COMMITTED_AT_DONE补丁是如何炼成的 - 实验结果全解析:跨基座泛化、优化器同台对比与跨平台迁移
- 深入诊断:不同模型家族到底缺什么 Harness 能力?
- 对 APP 自动化测试 / Mobile QA 的启发
- 专家点评:真正贡献、可能被高估的部分与可复现建议
- 总结
- 参考链接
1. 为什么通用 Harness 优化器在 GUI 场景水土不服
把 GUI Agent 拆开看,系统由两部分组成:一部分是基座模型 (负责看图、推理和吐出动作指令),另一部分是包裹在模型外围的可执行运行时 (Executable Harness)。在 Agent S3 或 OpenCUA 这类主流框架中,Harness 决定了屏幕截图如何裁剪与拼装、历史记忆如何保留、自然语言指向如何通过 Grounding 模型转成 pyautogui 坐标代码、动作何时重试、何时路由给代码执行器(Code Routing),以及模型喊出 done() 时系统是否允许它终止。
以 Self-Harness 和 Meta-Harness 为代表的通用优化器已经证明:不微调模型权重,只让优化器大模型根据执行轨迹修改 Harness 源码,就能提高任务成功率。但在桌面 GUI 环境中,直接套用文本 Agent 的优化套路会撞上两面墙。
1.1 桌面环境的天然非确定性与翻转率(Flip Rate)
桌面 GUI 环境不存在字节级可复现的状态转移。哪怕每次都从干净的虚拟机快照恢复,前后相隔一分钟的两次启动也会在屏幕细节上产生差异。
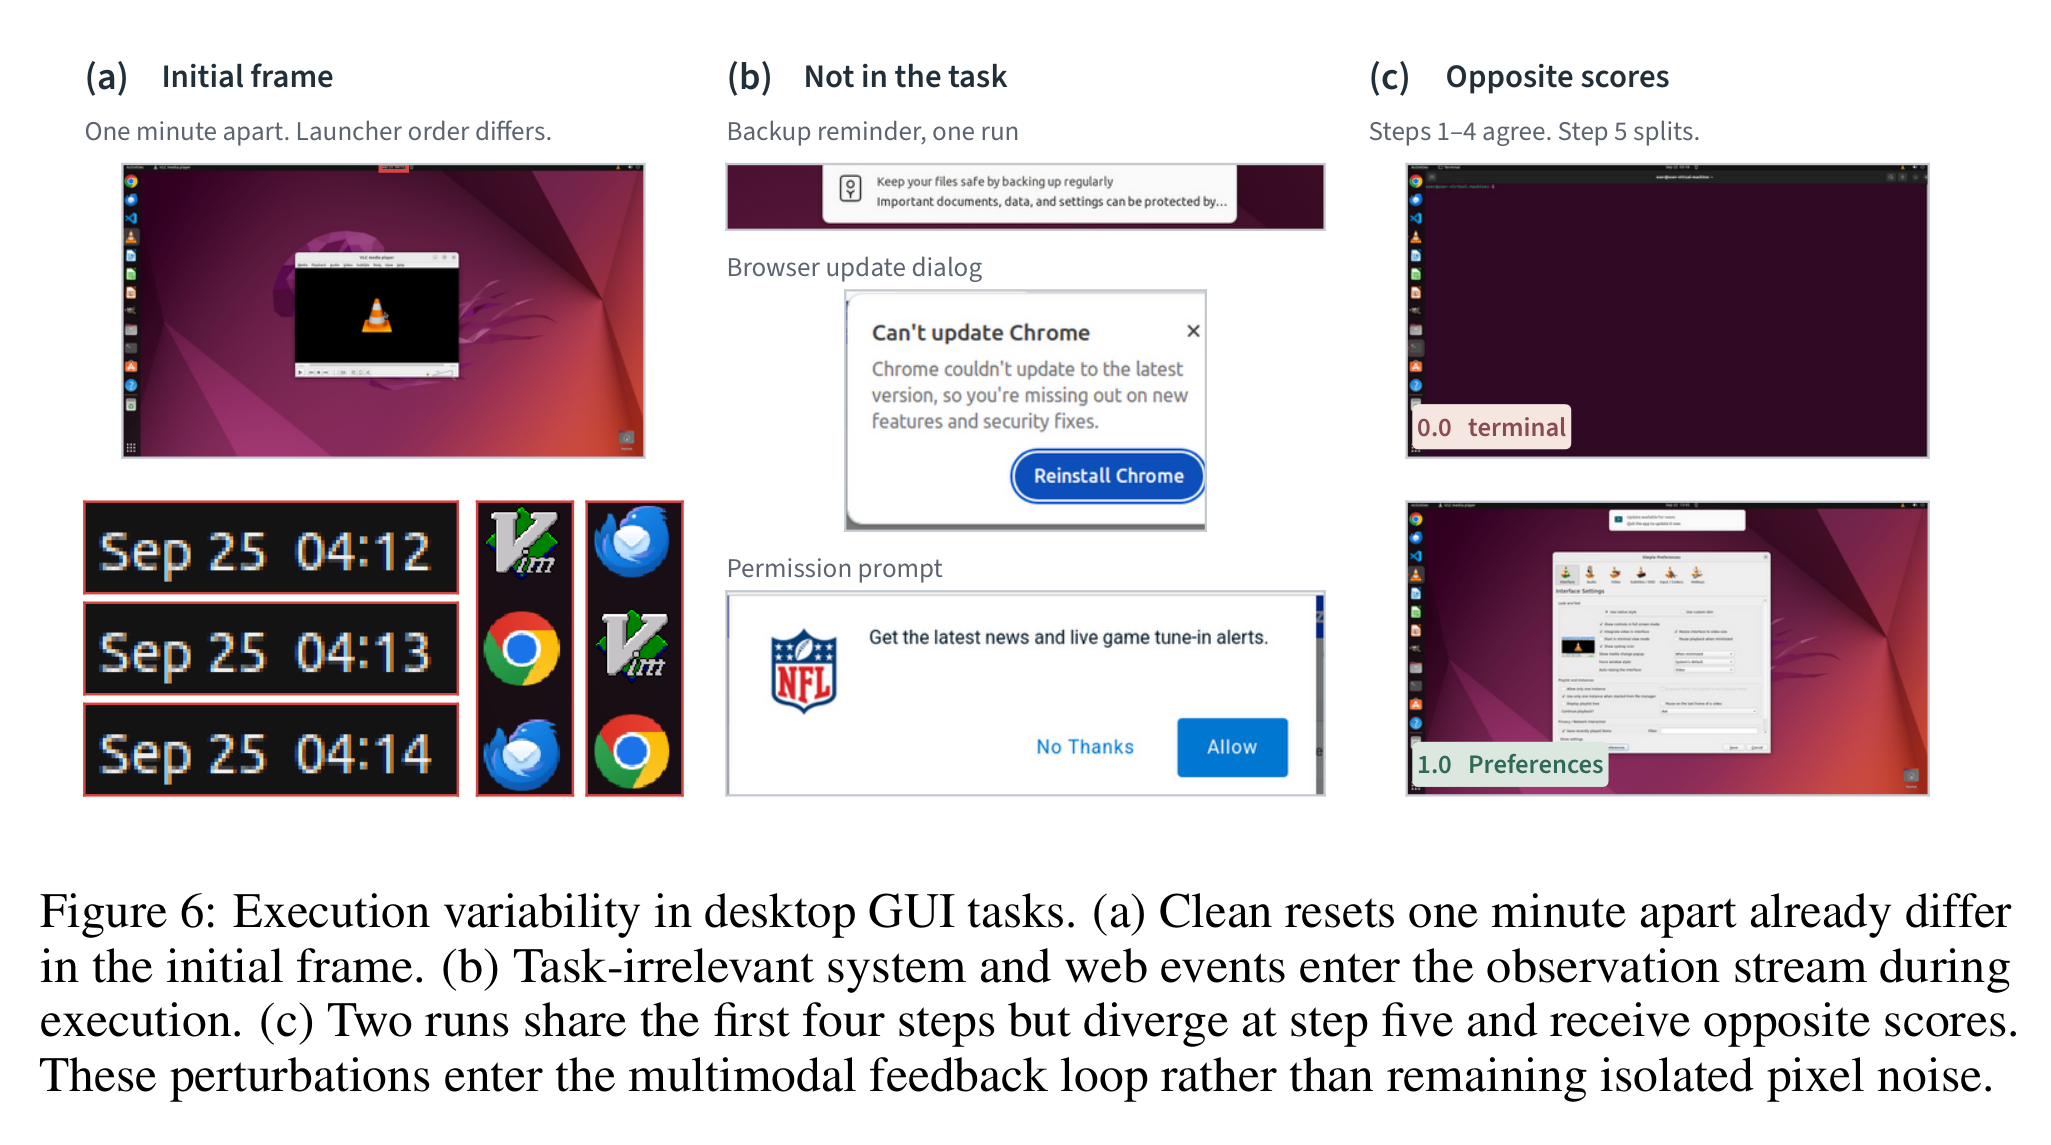
因为 GUI Agent 的每一步决策都以最新截图为条件,且动作直接落在像素坐标上,早期的微小视觉扰动或渲染延迟会被多模态反馈回路放大,最终导致同模型、同 Harness 在同一任务上有时成功、有时失败。论文在附录 Table 8 中统计了六个基座模型在初始 Harness 下跑满全量 361 个任务(每题独立跑 次)时的任务翻转率:
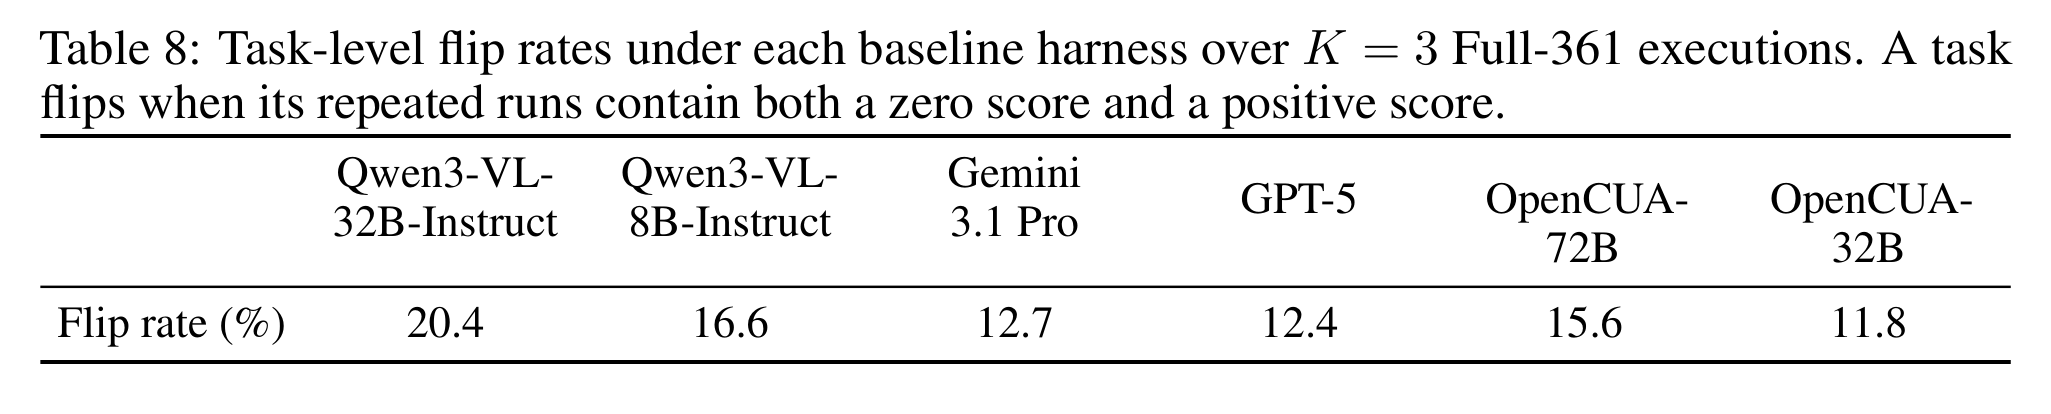
可以看到:
Qwen3-VL-32B-Instruct的翻转率高达 20.4%(每 5 个任务就有 1 个在成功与失败之间摇摆);Qwen3-VL-8B-Instruct和OpenCUA-72B分别为 16.6% 和 15.6%;- 即便是闭源前沿模型
Gemini 3.1 Pro(12.7%)和GPT-5(12.4%),也有约八分之一的任务会出现结果翻转。
这组数据直接动摇了单轨迹诊断(Single-run Diagnosis)的根基:
- 如果只采样 次,一条失败轨迹可能只是因为偶然弹出了浏览器更新框,优化器如果据此大改核心逻辑,反而会破坏原本正常的路径;
- 反过来,当同一任务的 次运行里既有失败又有成功时,那条成功的运行就是现成的、在当前模型能力范围内可达的“对照组(Reference Contrast)”。对比成功轨迹与失败轨迹在哪一步分道扬镳,远比对着单条失败轨迹凭空猜原因准确得多。
1.2 视觉状态转移缺失导致的归因失真
在实验的消融部分(Table 3),如果把 GUI-HARVEST 中的视觉截图证据拿掉,只给优化器看模型的思维链文本、计划和动作日志,测试集增益会从 +10.16 个百分点掉到 +1.52 个百分点(低于只做通用搜索的 Self-Harness +2.00 和 Meta-Harness +4.38)。
原因在于 GUI 动作的语义是由“执行前后的界面变化”定义的。例如模型发出 pyautogui.click(90, 75),代码返回执行成功、无异常抛出,但这并不代表菜单真的被点开了——可能点击时窗口还没拿到焦点,可能点偏了几个像素,也可能点完后弹出了模态确认框。没有前后截图与落点局部像素变化证据,诊断器根本分不清“动作没生效”和“策略方向错了”。
2. 问题形式化与防泄漏实验协议
在进入四角色架构之前,先看论文如何用严格的实验边界防止“面向测试集调参”。
设 为冻结权重的 GUI 多模态模型, 为初始可执行 Harness。一份能力清单(Capability Manifest)明确规定了允许编辑的源文件范围与允许新建模块的目录:
- 允许修改:提示词与上下文构造函数、记忆管理、动作与工具接口、控制流、完成校验、错误恢复与终止判定代码。
- 严禁修改:底层模型客户端与解码参数、Benchmark 任务定义、评分器(Evaluator)、虚拟机基础设施以及步数/超时限制。
在优化开始前,OSWorld-Verified 的 361 个有效任务(按惯例剔除 8 个 Google Drive 认证任务)通过固定随机种子的领域分层抽样,被切分为三个互不重叠的集合:
- 搜索集 (80 题):向优化器开放完整的任务卡片(Task Card)与多模态执行轨迹,作为诊断、聚类和行为验证的唯一证据来源。
- 验证集 (80 题):轨迹对优化器完全隐藏,外层运行器只向门禁校验器返回集合上的平均得分标量,用于拦截在搜索集上过拟合的改动。
- 密封测试集 (201 题):在优化彻底停止、最终 Harness 冻结 Commit 之前,任务 ID 和执行结果完全不可见。
对于任意任务集合 ,由于存在执行波动,论文将集合上的效用得分定义为每个任务重复独立运行 次(主实验 )的原始评分器得分均值:
整个演化过程最多进行 轮(Round)。每一轮围绕当前固定的 Harness 状态 展开,最多允许最多 个通过静态与单测检查(L0/L1)的候选补丁进入真实 GUI 环境评估:
- 一旦某个候选补丁 通过验证门禁并晋升(Promote),则令 ,直接进入下一轮并重置 5 次尝试额度;
- 如果候选补丁被拒绝(Reject),则回滚回 ,将失败尝试、预测与得分记入更新账本(Update Ledger),供工程师提出实质不同的下一版修改;
- 如果在同一个 上连续 次尝试全部被拒,优化提前终止,冻结当前 作为最终的 。
3. 核心架构拆解:四个角色与五道校验门禁
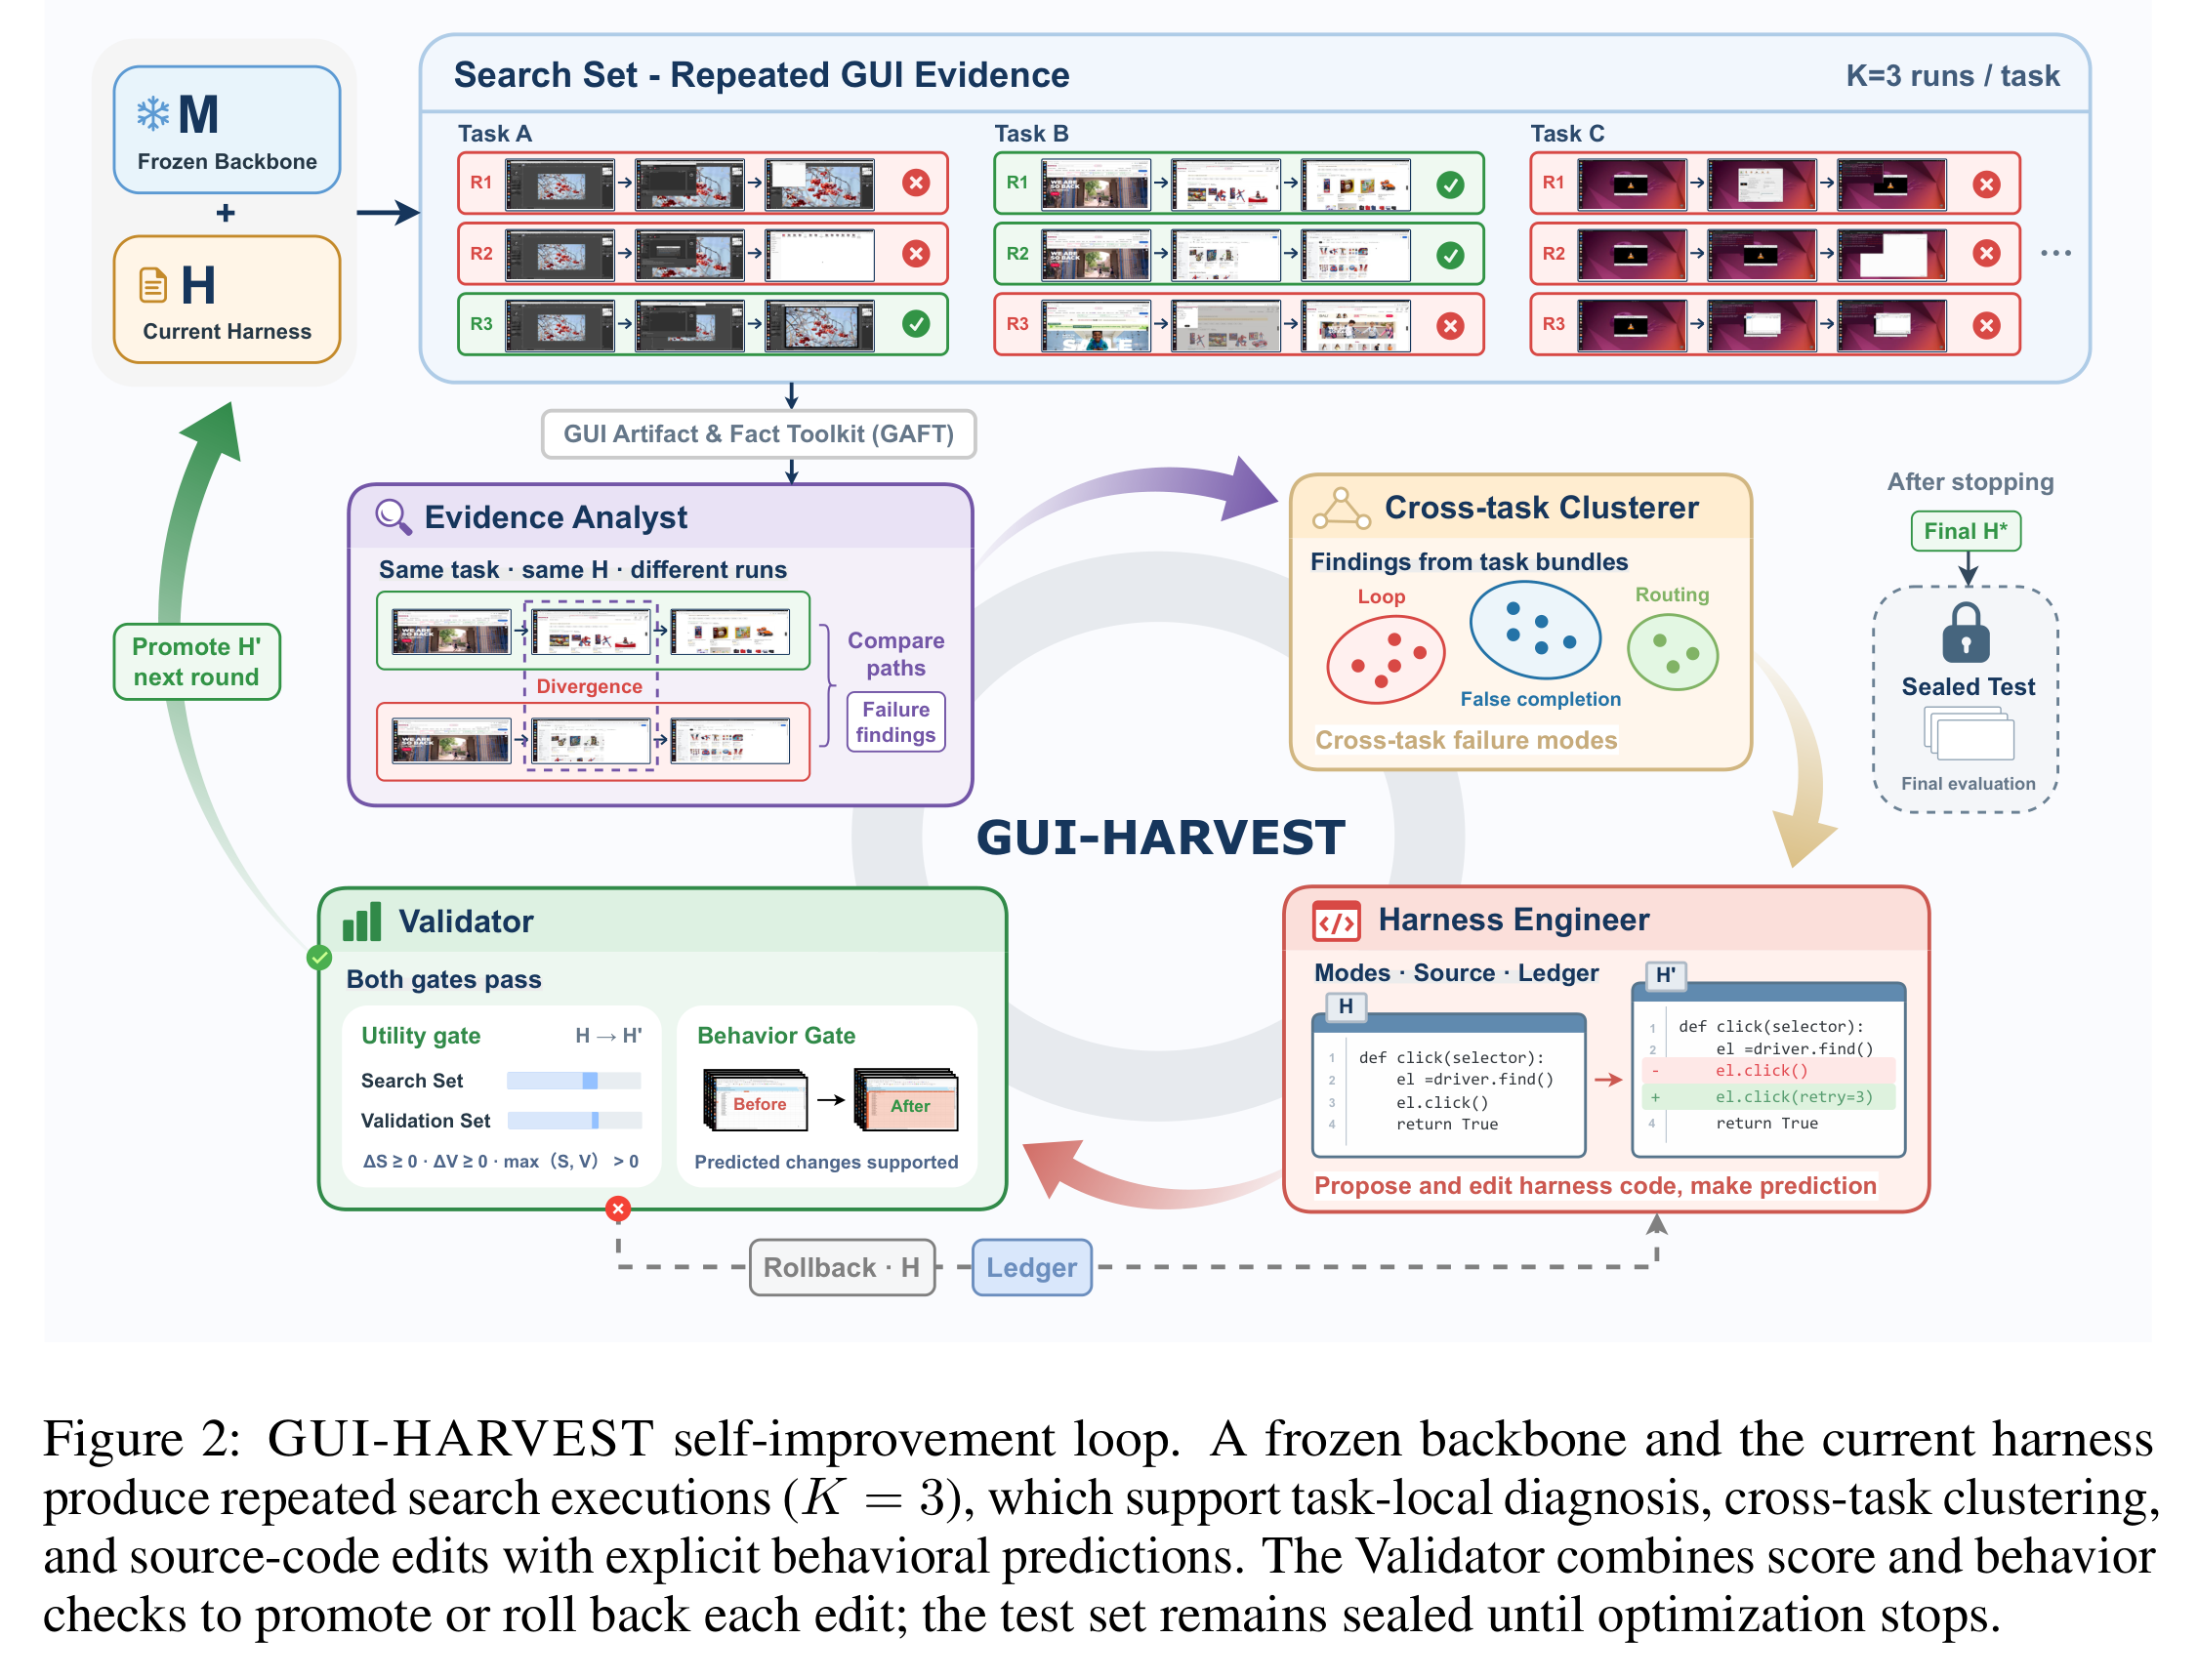
如图 2 所示,GUI-HARVEST 的核心是由确定性基础设施 GAFT 支撑的四个大模型角色(在实验中全部由 Claude Sonnet 5 担任,跨所有被测基座模型使用完全相同的角色 Prompt)。下面按数据流顺序拆解每个模块的内部机制。
3.1 基础设施:GAFT(GUI Artifact and Fact Toolkit)
如果直接把一个任务 3 次运行、每次 15 步的高清全屏截图一股脑塞给诊断模型,不仅 Token 成本极高,视觉注意力也会被大量无关背景稀释。
作者为此构建了确定性预处理工具包 GAFT。对于每一次运行 的每一步 ,GAFT 将模型输出文本、计划动作、实际执行的底层代码、工具返回以及执行前后的截图(Before / After Screenshots)对齐,并计算两项纯机械、可复现的视觉事实指标:
- 全屏像素变化率 :前后两帧全屏范围内发生改变的像素占比;
- 落点局部像素变化率 :针对点击、拖拽等指向性动作(Pointing Actions),以实际落点坐标为中心裁剪固定大小的局部窗口,计算窗口内的像素变化占比。
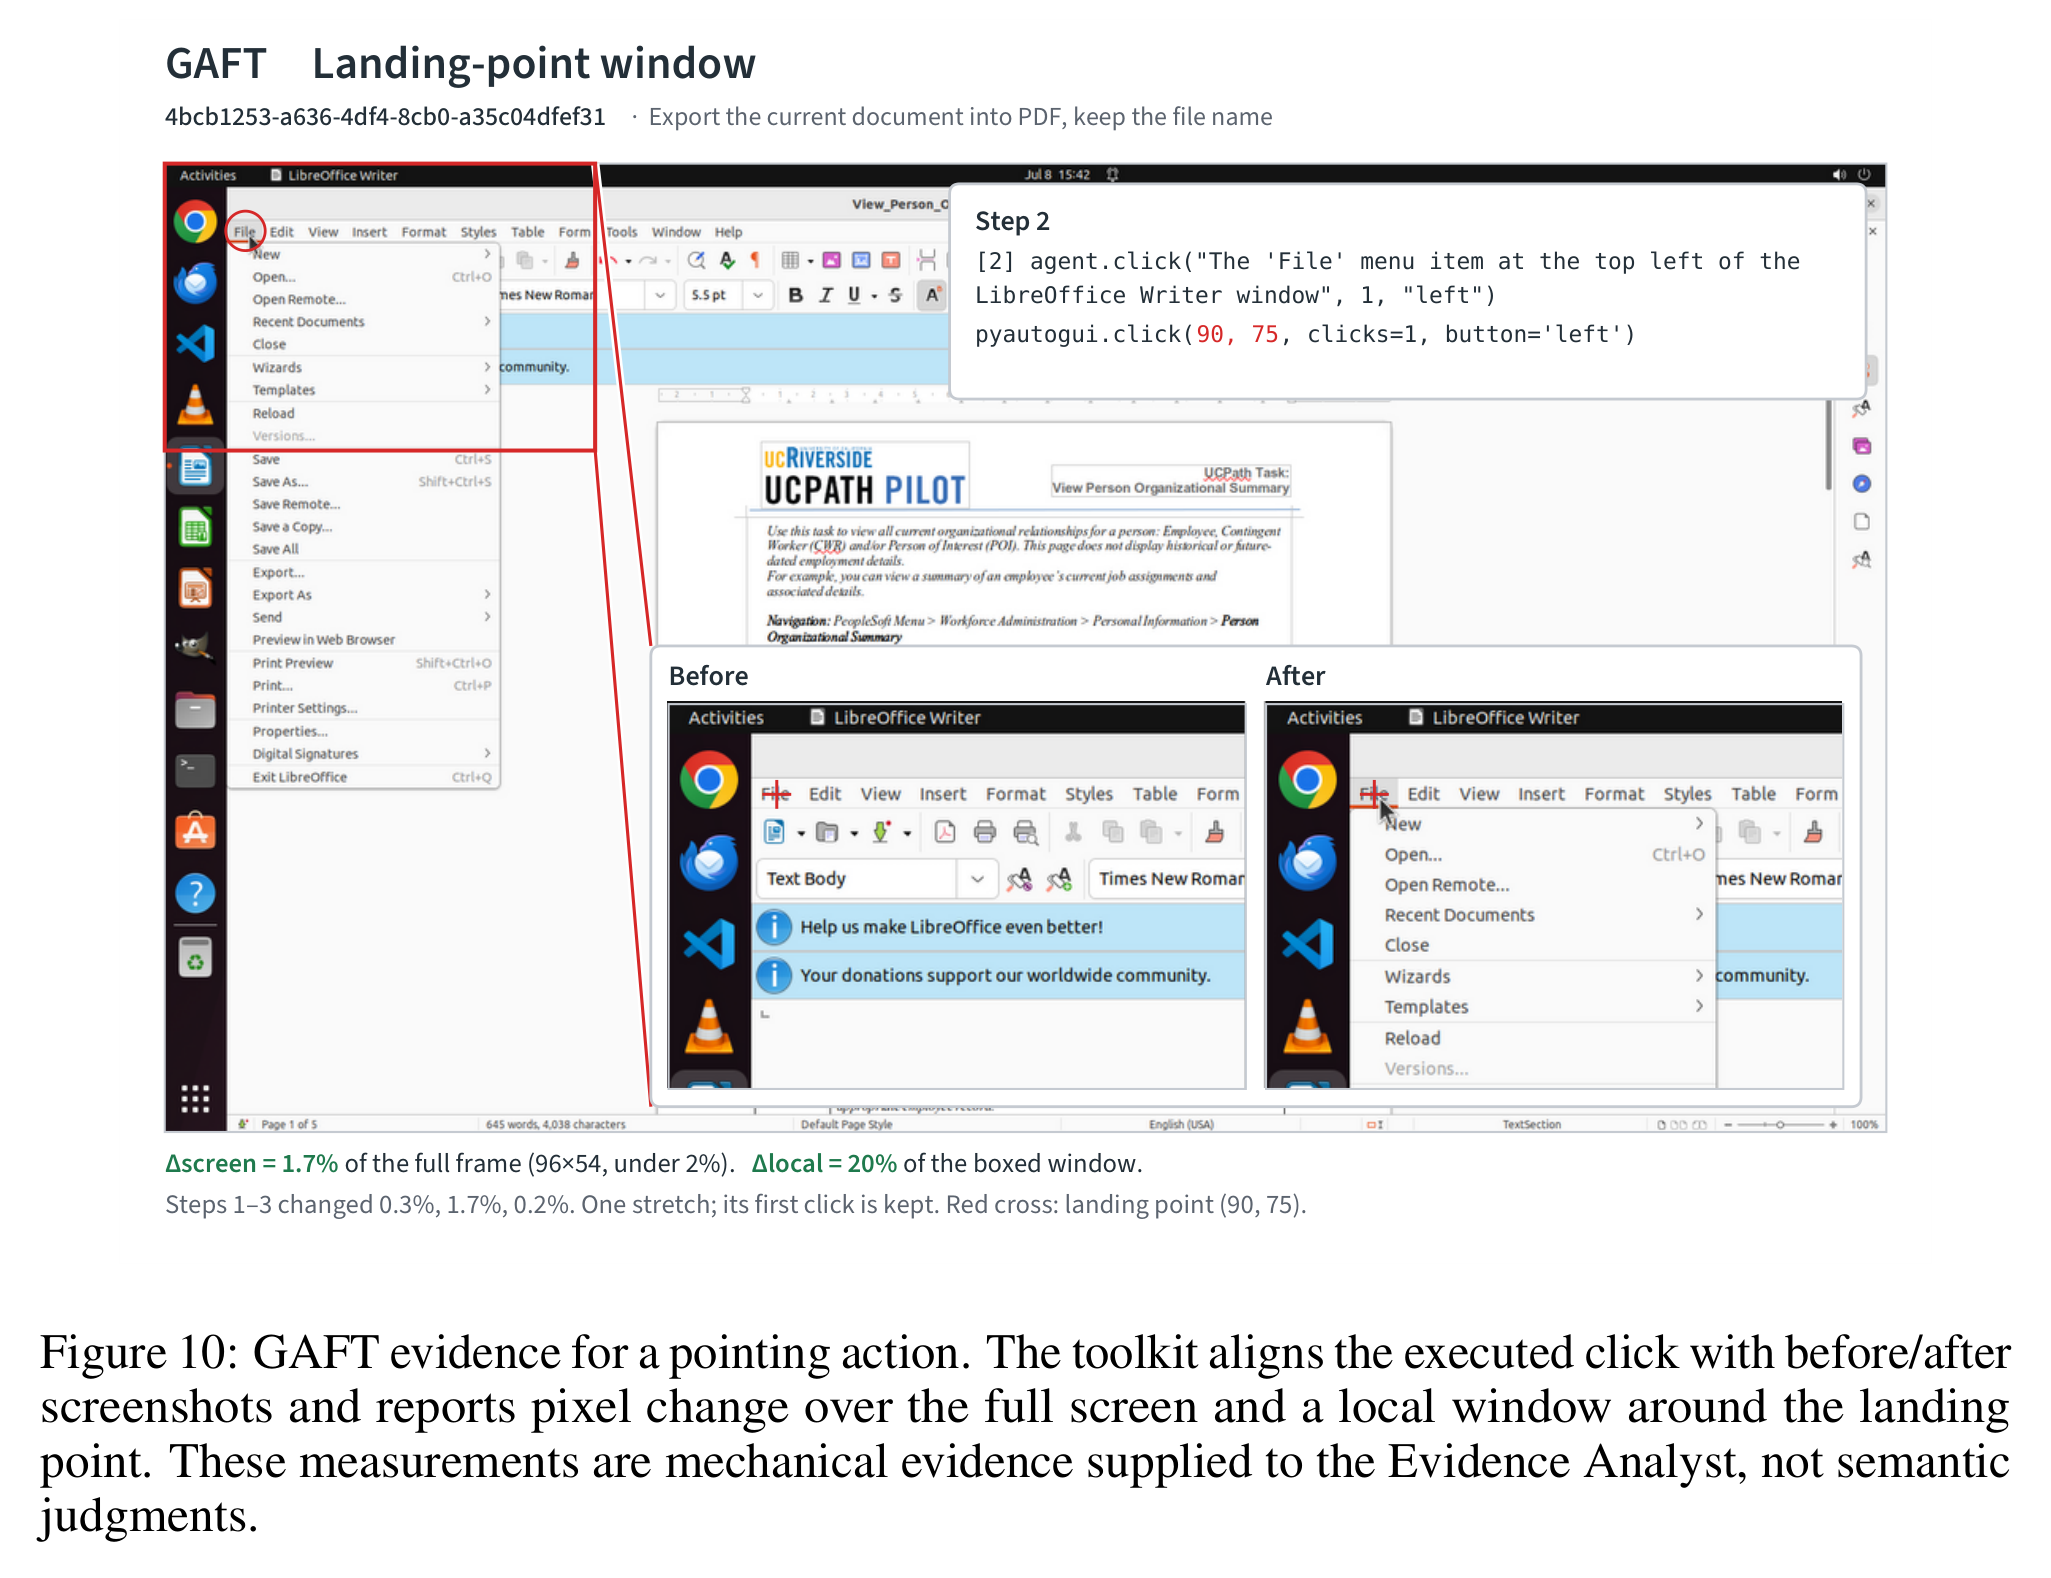
File 菜单 (90, 75)。因为弹出的下拉菜单只占 1920×1080 屏幕的一小块,全屏像素变化率 仅为 1.7%(低于 2%),但落点局部窗口内的变化率 高达 20%。GAFT 将全局帧、落点红十字标记与 Before/After 局部放大图一并交给分析师,只陈述机械事实而不越俎代庖做语义判断。如图 10 所示,这种“全屏 + 落点局部窗口”的双尺度设计非常实用:在桌面高分辨率屏幕下,点开一个菜单、勾选一个复选框或输入框出现光标,全屏变化率往往不到 2%,很容易被粗粒度帧差忽略;而 立刻就能证明这次点击确实触发了局部 UI 响应。
为了控制上下文体积,GAFT 初始只向分析师提供事件筛选后的关键帧(初始帧、终止帧、大面积屏幕跳转帧、连续无变化区间的起始帧)以及高价值的落点局部裁剪图;分析师在阅读过程中可以通过 JSON 接口(screens_wanted)按需点名调取任意运行、任意步数的原分辨率全屏截图。
3.2 角色一:Evidence Analyst(基于同任务重复执行的对比诊断)
每个搜索集任务 在当前 Harness 下的 次运行被打包成一个任务轮次包(Task-round Bundle):
其中 是包含指令、所属领域、关联应用和可行性标注的 Task Card, 是描述当前 Harness 控制流与输出格式的 Harness Card, 则是第 次运行的轨迹、得分与终止元数据。
只有当包内至少有一次有效运行得分为 0 时,该任务包才会进入诊断。每个任务包由一个独立、受预算限制的 Evidence Analyst 实例分析(视野严格限制在单任务内部,防止跨任务串味)。它的核心分析流程在附录 Prompt 中规定得很清楚:
- 优先寻找内部对照:如果 3 次运行中有正分运行(即发生 Flip 的任务),必须将正分运行设为参考运行(Reference Run),找出 0 分运行与参考运行第一次发生影响结果的实质分叉步(First outcome-relevant divergence);
- 定位决定性错误步(Decisive Step ):找出引入了后续未能修复的错误的最早一步;
- 坚持观测描述而非主观归因:Prompt 明确要求 “Answer in observations, not in causes”——记录模型实际做了什么(
did)、机器界面发生了什么(machine)、可观测机制(mechanism)、基于证据的反事实替代方案(counterfactual),并附带决定性步骤的逐字原文引用(Verbatim Quotes)。
产出的每条诊断发现(Finding)形式化为:
在交给下一阶段之前,一段**确定性校验程序(Deterministic Verifier)**会先核查每条 Finding:引用的 Harness 版本是否匹配、运行编号 和步数 是否存在、逐字引文是否真的出现在该步日志里、声称的机械事实(如重复动作或像素变化)是否与轨迹一致。未通过核查的幻觉诊断会被直接丢弃。
3.3 角色二:Cross-task Clusterer(两阶段跨任务失败模式归纳)
拿到搜索集各个任务包验证通过的 Findings 后,如何把零散的单题病历提炼成值得改代码的共性模式?
此前的工作(如 CUADebug 的实验)已经揭示过一个现象:如果让大模型从零开始自由发明错误分类学(Open-ended Taxonomy Discovery),不同随机种子演化出的类别名称完全对不上,粒度极不稳定。反过来,如果预先写死一套僵硬的固定小类,又无法覆盖不同基座模型千奇百怪的运行时交互缺陷。
GUI-HARVEST 采用了**“确定性结果大类约束 + 开放词汇表细粒度归纳”的两阶段折中方案**:
- 第一阶段(确定性映射):根据每条 Finding 的决定性动作签名 (Decisive action + Observed machine outcome),由确定性规则将其分配到一个粗粒度结果类别 (例如
PREMATURE_DONE、LOOP、ROUTING等)。这一步的作用是收窄对比空间,不允许聚类器跨大类乱拼。 - 第二阶段(跨任务模式合成):在每个类别 内部,Cross-task Clusterer 根据各条 Finding 的可观测机制 和反事实方案 ,归纳出开放词汇表的行为模式(Behavior Mode):
其中 是跨任务可观测机制, 是判断一条 Finding 是否属于该模式的成员谓词(Membership Test), 是期望改变后的目标行为。
这里有三条严格的防过拟合纪律:
- 默认合并原则:Prompt 规定默认只产出一个模式,只有当两批问题的目标修复行为(
behavioral_target)存在实质差异、且各自的成员谓词互斥时才允许拆分; - 跨任务最小支持度(Independent-task Support ):一个模式必须至少包含来自 2 个不同任务 ID 的 Finding 才允许发布;单任务孤立问题被放入残差集(
residue); - 禁止越界点名代码:聚类器只准描述可观测行为机制,严禁在模式定义里直接点名 Harness 模块名、代码文件、Prompt 措辞或特定任务的业务答案。
3.4 角色三:Harness Engineer(有界源码修改与事前可检验预测)
Harness Engineer 运行在一个受能力清单约束的代码工具会话中。它接收当前轮次的跨任务行为模式、代表性轨迹证据、Harness Card 以及更新账本 中记录的此前被拒尝试(Rejected Attempts)。
与直接让大模型改完代码就去跑分不同,GUI-HARVEST 强制要求工程师在动手改代码和送交评测之前,先冻结一份结构化的更新计划 proposal.pre.json:
这份计划必须明确绑定:
- 目标模式与源码区域 :具体到文件路径、函数符号与锚点;
- 有界代码补丁 :只针对一个模式或共享同一机制的一小批兼容模式做最小修改,并在同一次编辑中同步更新
HARNESS_CARD.md; - 事前行为预测 (Observable Predictions)与目标核验任务集 :明确写出“打上这个补丁后,在搜索集任务 的执行轨迹中,当触发条件满足时,将观察到什么具体行为变化”;
- 不变式 (Invariants)与预期回归风险:声明哪些原有接口和行为绝不能被破坏。
“先写下可观测行为预测,再跑评测”是整篇论文最核心的工程设计——它把一次源码修改变成了可证伪的科学实验:如果补丁跑完后总分碰巧涨了 0.5 分,但在它自己点名要修的任务 上,预期行为变化根本没发生(甚至背道而驰),说明涨分只是噪声,补丁依然会被淘汰。
3.5 角色四:Validator(L0/L1 代码检查 + 效用硬门禁 + 行为软门禁)
候选 Harness 想要晋升为下一代主干 ,必须依次闯过四道关卡:
- L0 静态门禁(不消耗尝试额度):检查修改文件是否在白名单内、Diff 行数是否超限、Python 语法与静态规则是否通过;
- L1 接口与单测门禁(不消耗尝试额度):检查模块导入、接口兼容性、本地单元测试与冒烟测试(Smoke Test)。L0/L1 报错允许工程师在本地会话内直接修复,不扣减每轮 的 GUI 评估预算;
- Utility Hard Gate(效用硬门禁):在搜索集 (80 题)和验证集 (80 题)上各跑 次(共 480 次桌面任务 rollout)。记 ,硬门禁要求两个集合均不退化,且至少有一个集合严格提升:
-
Behavioral Soft Gate(行为软门禁,同样为必过项):针对事前预测 中的每一个目标搜索集任务 ,启动一个独立的验证器实例,对比修改前的 Finding、冻结预测文本以及修改后新跑出的 条多模态轨迹(注意:此时不向行为验证器透露评分器的得分,防止它看分下菜碟)。验证器必须给出精确到运行编号和步数的引证,并输出三种裁决之一:
supported:触发条件出现,且观察到的行为符合预测;contradicted:触发条件出现,但实际行为违背预测;inconclusive:触发条件未出现或证据不足。
随后由确定性聚合器按固定规则汇总:每一条必选预测都必须至少拿到一个确定性裁决(
supported或contradicted),且supported的任务数必须严格多于contradicted。
只有当四道门禁同时满足时,候选补丁才正式晋升:
4. 真实案例追踪:一条 EDIT_NOT_COMMITTED_AT_DONE 补丁是如何炼成的
为了直观展示这套流程如何在代码层面运转,论文在附录 I(Figure 11)中完整导出了一条真实的端到端演化记录。这个案例把“为什么必须看图”、“为什么需要 对照”以及“如何写出不卡死正常任务的防呆门禁”交代得很清楚。
4.1 第 1 步:Evidence Analyst 从 翻转中揪出“未提交的输入框”
任务指令是:“把 Chrome 浏览器个人资料的用户名修改为 Thomas。”
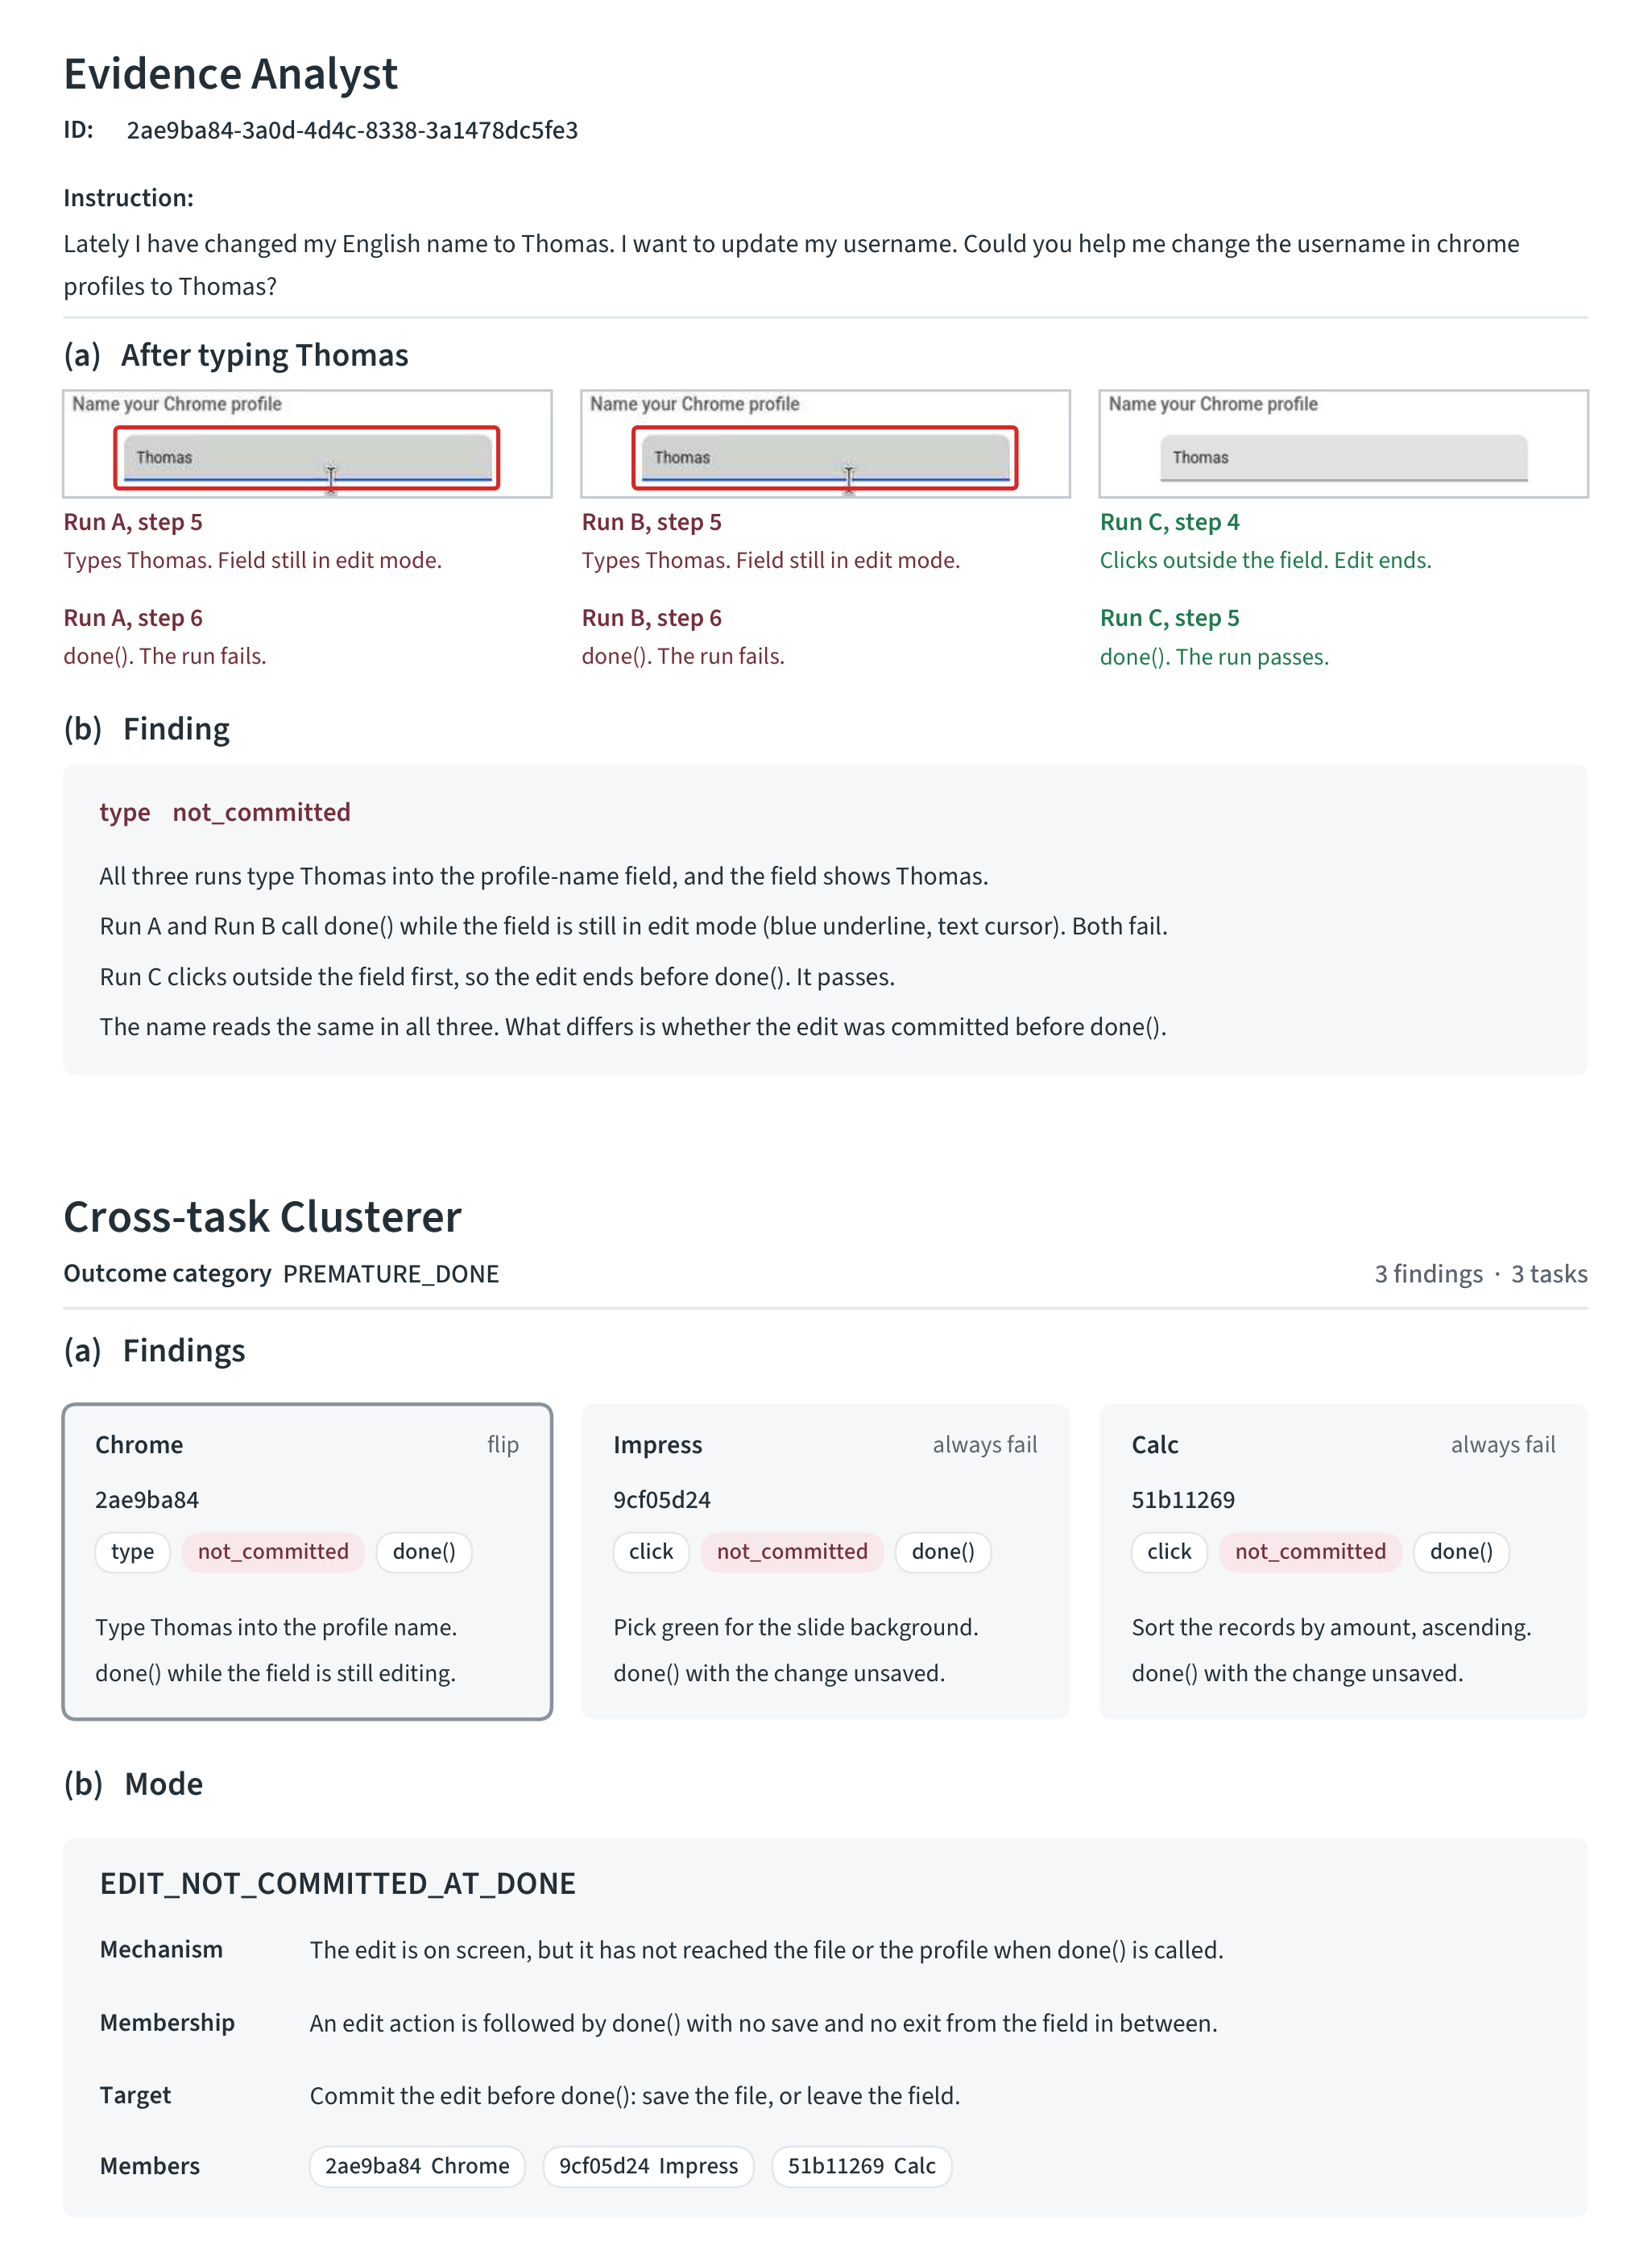
EDIT_NOT_COMMITTED_AT_DONE 模式。看图 11a 上半部分:在修改前的 3 次运行(Run A、Run B、Run C)中,Agent 都成功点开了设置页面,并在名称输入框里敲入了 Thomas。如果只看截图里的文字或者只看动作日志(type("Thomas") done()),三次运行看起来一模一样。
但得分却是 Run A 得 0 分、Run B 得 0 分、Run C 得 1 分(满分)。
Evidence Analyst 对比三次运行的局部截图与步骤序列后发现:
- 在 Run A 和 Run B 的第 5 步,敲完
Thomas后,输入框底部仍然带着蓝色高亮下划线和闪烁的文本光标(处于未失焦提交的 Edit Mode),模型在第 6 步直接调用done()结束任务,导致修改根本没有写入 Chrome 配置文件; - 而在成功的 Run C 中,模型敲完字后,在第 4 步先点击了输入框外部的空白区域,输入框失去焦点、蓝色下划线消失(编辑正式提交生效),第 5 步再调
done(),顺利通过评测。
于是,Analyst 产出了编号为 2ae9ba84 的 Finding:问题不在于没输入 Thomas,而在于编辑动作尚未提交(not_committed)就提前调用了 done()。
4.2 第 2 步:Cross-task Clusterer 跨三个应用合成共性模式
接着看图 11a 下半部分:如果只针对 Chrome 设置页写一条规则,那就成了题库作弊。但 Cross-task Clusterer 在 PREMATURE_DONE 大类下扫描其他搜索集任务时,发现了另外两个独立应用的同类病历:
- LibreOffice Impress 任务(
9cf05d24,3 次全败):把幻灯片背景改成绿色后,未保存文件直接调done(); - LibreOffice Calc 任务(
51b11269,3 次全败):把表格按金额升序排列后,未保存文件直接调done()。
这三个任务横跨浏览器与办公套件,表面操作各异(敲字 vs 选颜色 vs 排序),但底层机制完全一致:屏幕上已经显示了修改后的视觉效果,但在调用 done() 时,修改尚未持久化到文件或配置中。
聚类器由此合成出跨任务模式 EDIT_NOT_COMMITTED_AT_DONE:
- 触发成员谓词(Membership):发生编辑类动作后,中间既没有保存操作、也没有离开当前编辑控件,紧接着就调用了
done(); - 目标行为(Target):在允许
done()终止之前,先完成编辑提交(保存文件或让输入控件失焦)。
4.3 第 3 步:Harness Engineer 编写状态追踪与“单次拦截门禁”
拿到 EDIT_NOT_COMMITTED_AT_DONE 模式后,Harness Engineer 在 Agent S3 的 gui_agents/s3/agents/grounding.py 和 worker.py 中打上了一个精巧的有界补丁(见图 11b):
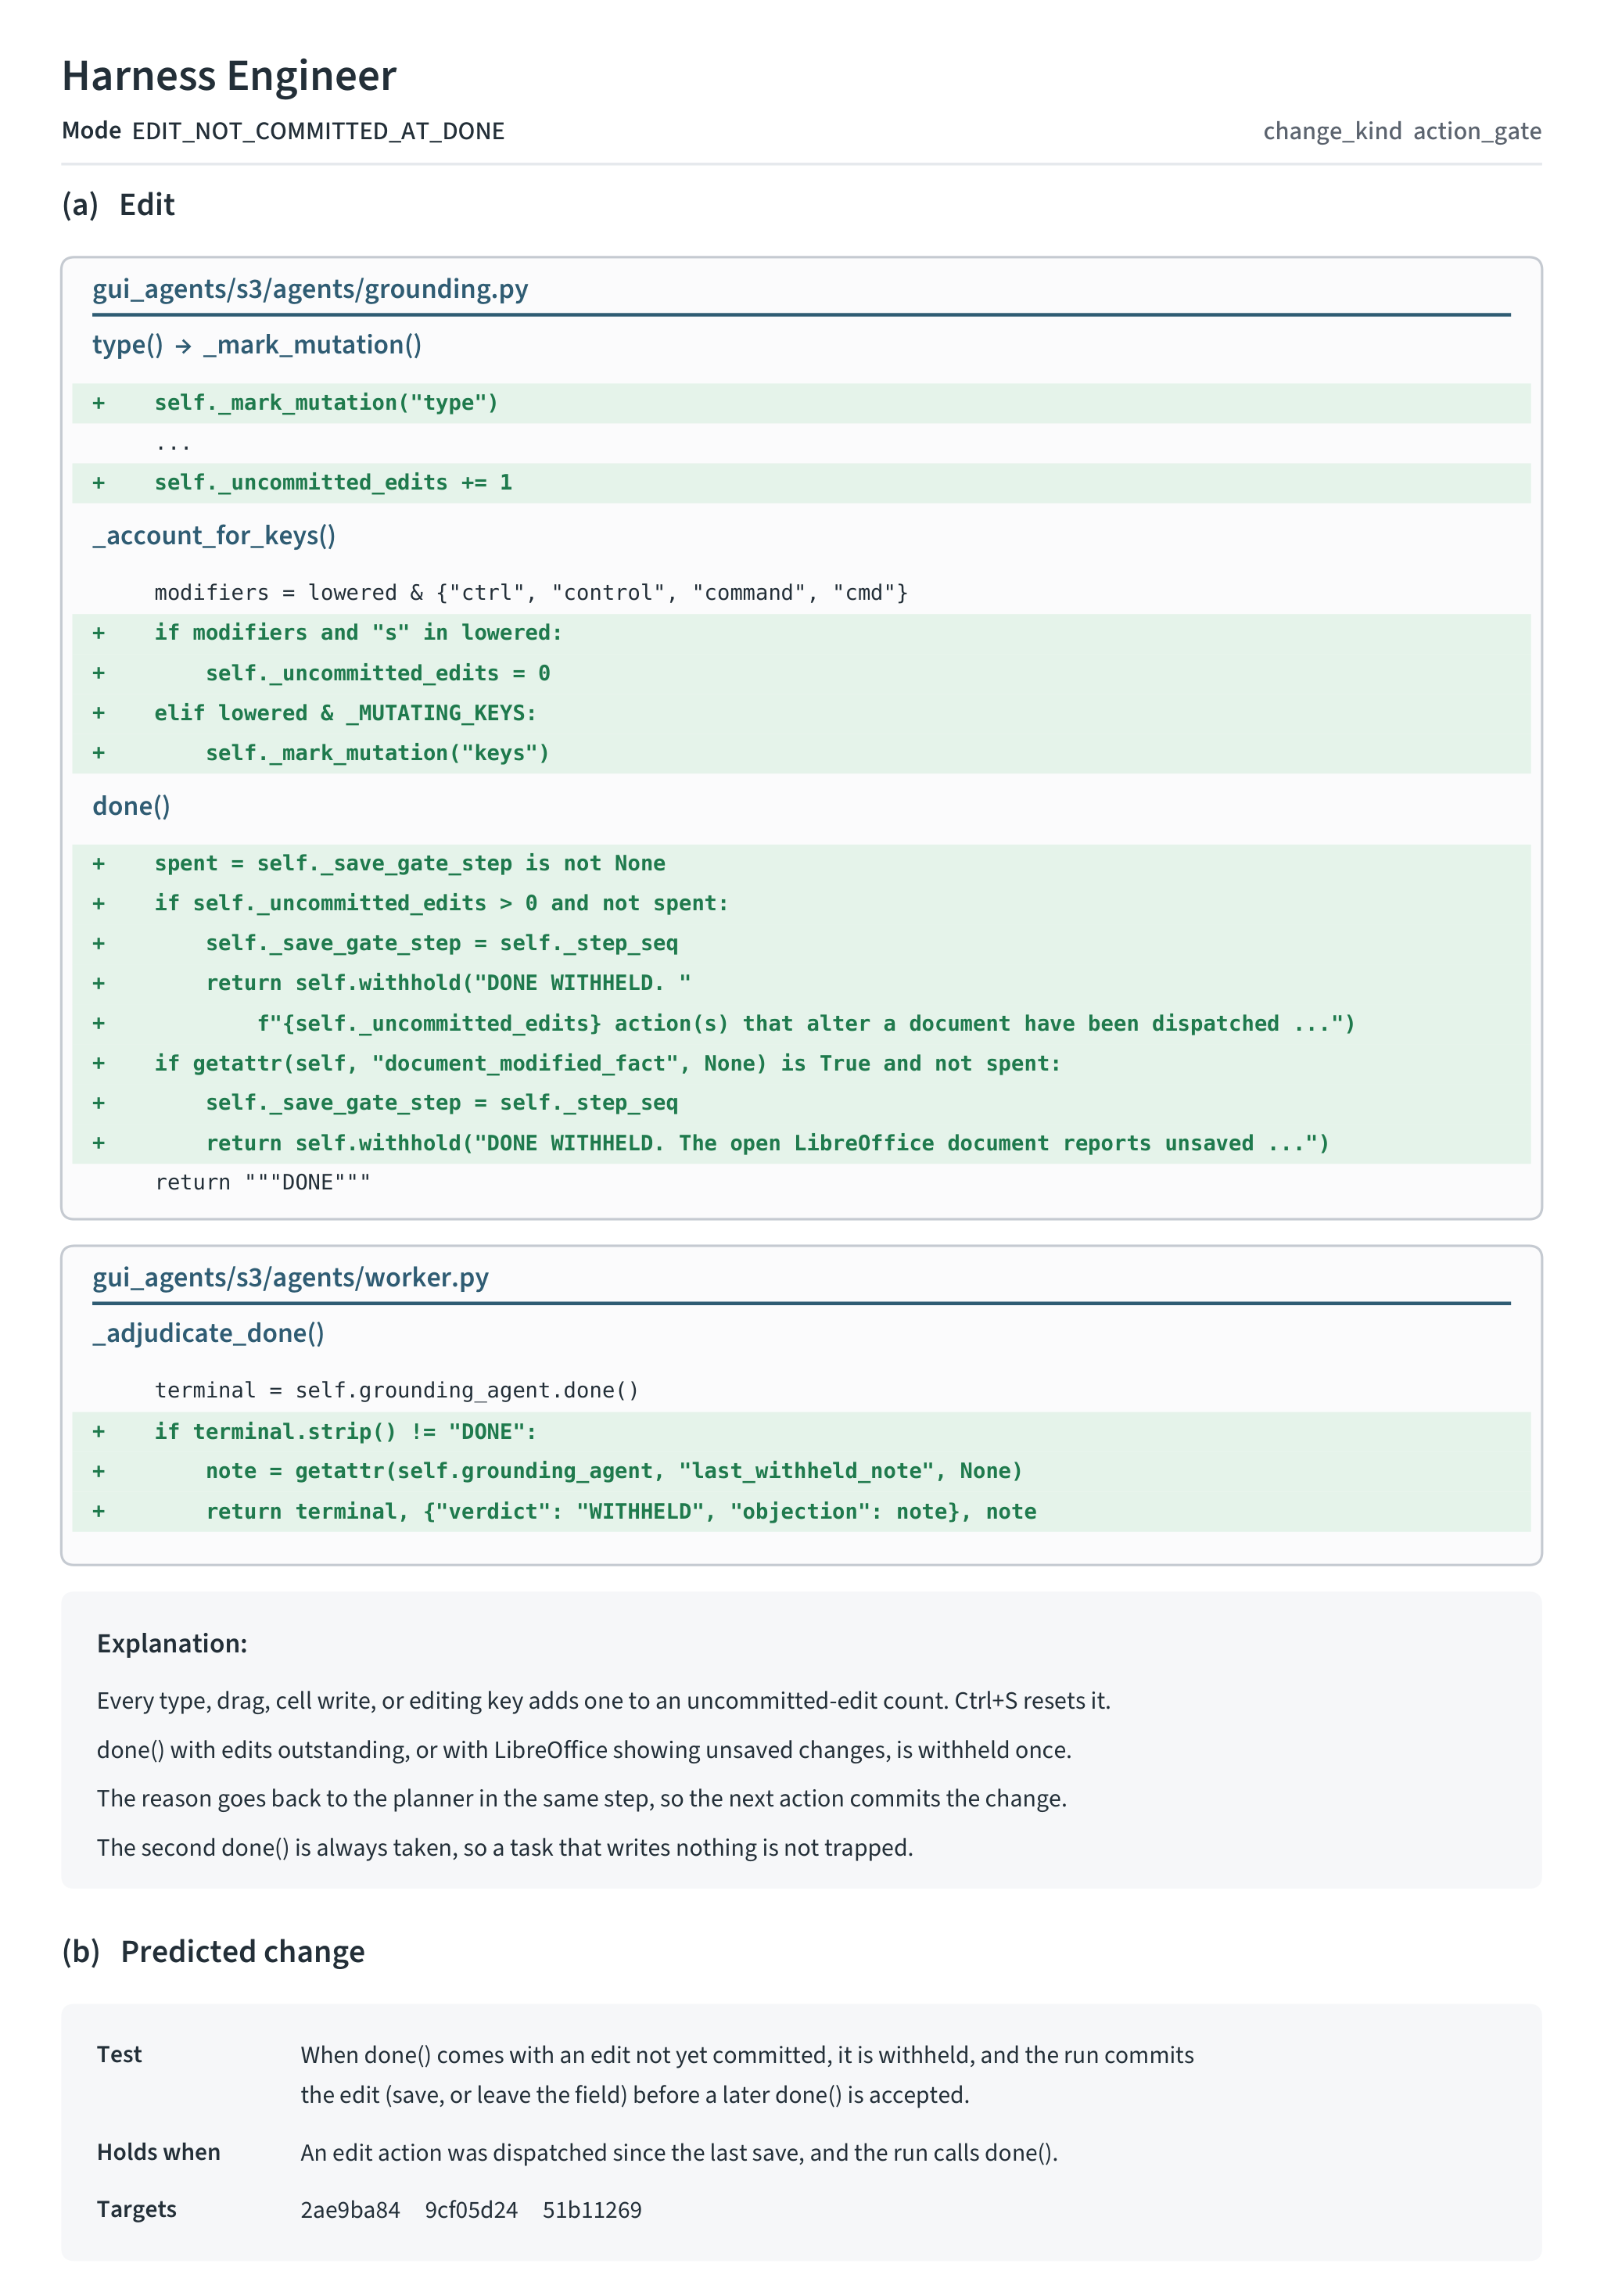
grounding.py 与 worker.py,引入 _uncommitted_edits 计数器与单次 done() 拦截反馈机制,并在评估前冻结可检验预测。这段代码的设计非常值得工程借鉴:
- 维护未提交编辑计数
_uncommitted_edits:每当分发type、拖拽、写单元格或会修改内容的按键(_MUTATING_KEYS)时,调用self._mark_mutation()将_uncommitted_edits加 1;每当检测到Ctrl+S/Cmd+S保存快捷键时,将该计数器清零。 - 拦截首次过早
done()并向 Planner 返回拒绝理由:当模型调用done()时,如果self._uncommitted_edits > 0或者 LibreOffice 文档状态标记为未保存(document_modified_fact is True),且当前轮尚未拦截过(not spent),Grounding Agent 不会返回真正的"DONE",而是调用self.withhold("DONE WITHHELD. N action(s) that alter a document have been dispatched ..."),由 Worker 的_adjudicate_done()把这条反对意见(objection)当场塞回给 Planner,促使其在下一步补做保存或失焦确认。 - 单次消费锁(
spent = self._save_gate_step is not None)防止死循环:为什么只拦截一次?因为有些任务(如在网页里敲搜索词看结果)不需要按Ctrl+S,或者模型通过点击外部提交后计数器未必归零。记录_save_gate_step确保第一次过早done()被拦截提醒,但如果模型在后续步骤再次调用done(),系统一定放行,绝不会把不需要保存文件的正常任务困死在无限循环里。
同时,工程师在 proposal.pre.json 中写下了冻结预测:“当 done() 在存在未提交编辑时被调用,它会被拦截(withheld),随后运行会在下一次 done() 被接受前提交该编辑(保存或离开输入框)。”
4.4 第 4 步:Validator 在新轨迹上逐帧核验预测行为
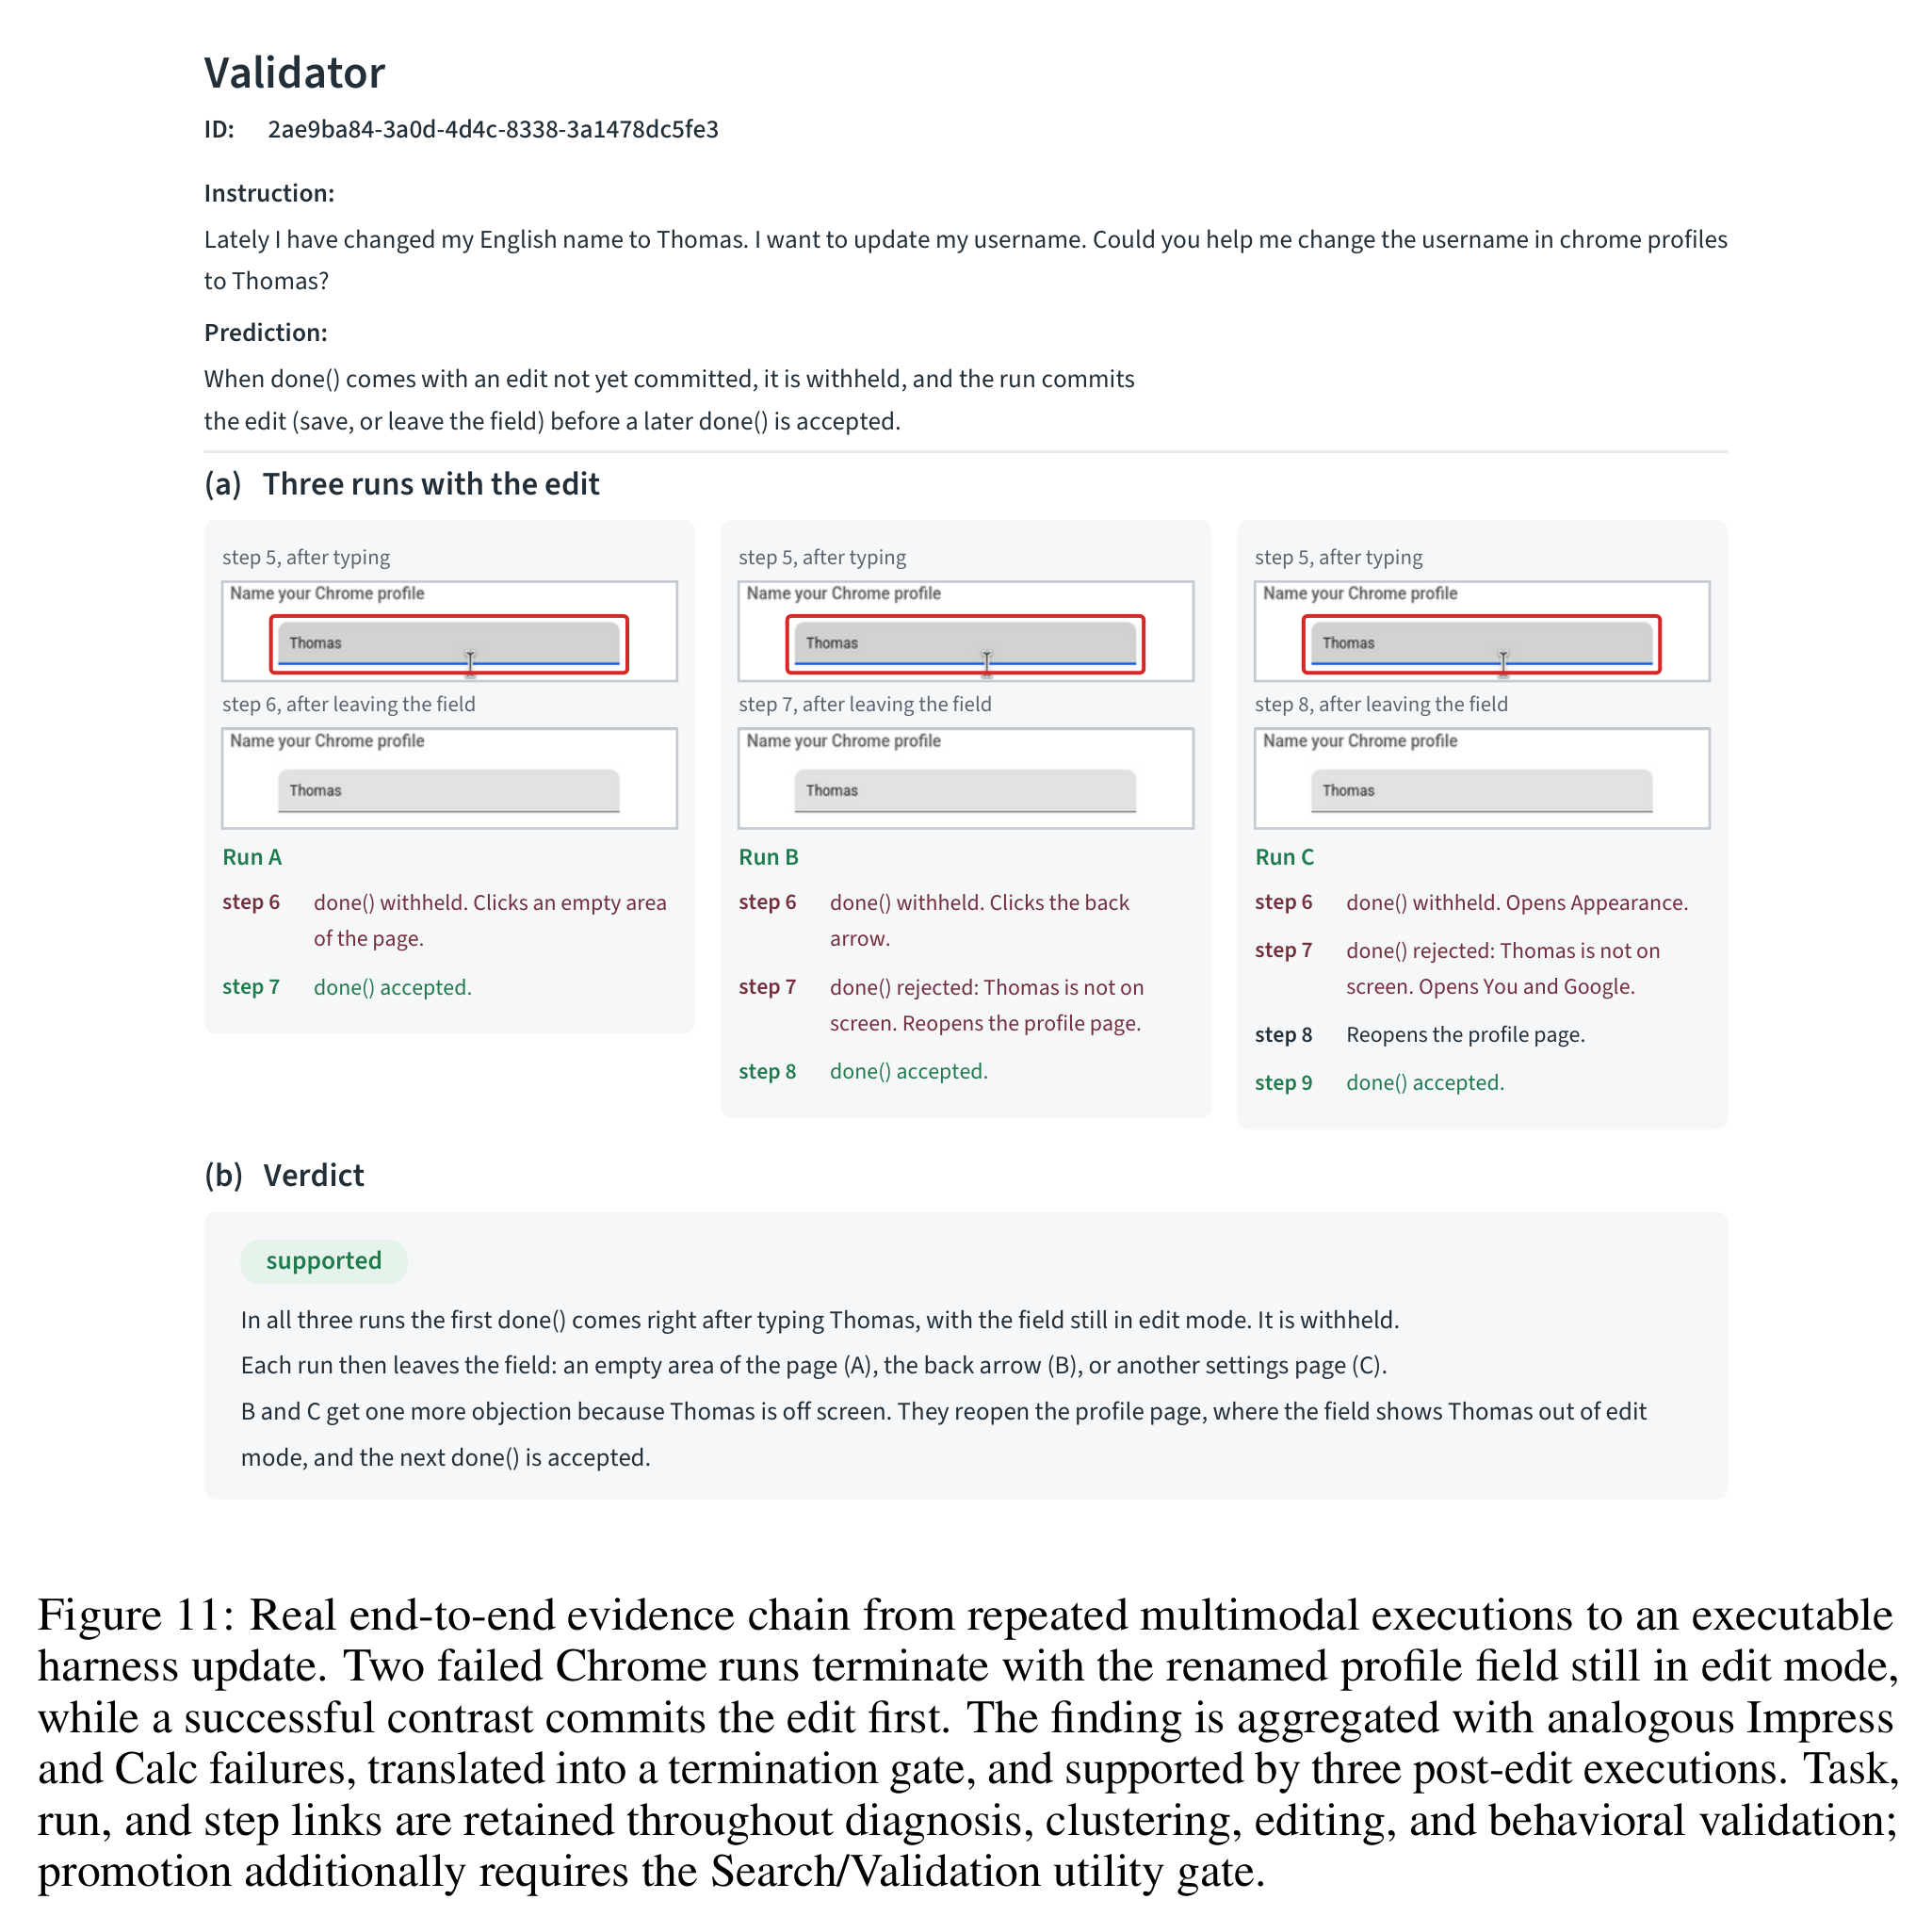
done() 均被成功拦截,随后各自通过点击空白处或切换页面完成失焦提交,最终全部拿到 supported 裁决并晋升。看图 11c:打上补丁后重新跑 Chrome 改名任务的 3 次运行(Run A、B、C):
- 在第 5 步输入完
Thomas后,三次运行依然习惯性地在第 6 步尝试调用done(),但全部被新加的门禁拦截(done() withheld); - 收到拦截提示后,Run A 点击了页面空白区域,输入框蓝色下划线消失,第 7 步再次调用
done()被接受,任务通过; - Run B 和 Run C 则分别点击了返回箭头和左侧的
Appearance菜单离开当前输入框(同样触发失焦提交),随后系统因为当前画面看不到Thomas又给出一次可见性提示,它们重新点回 Profile 页面确认Thomas已处于非编辑态后,调用done()顺利通过。
行为验证器核对三组前后截图与日志后,给出 supported 裁决;结合搜索集与验证集硬门禁得分双双上涨,这条补丁正式晋升。
5. 实验结果全解析:跨基座泛化、优化器同台对比与跨平台迁移
5.1 六个基座模型在 OSWorld-Verified 上的全面提升
在统一的 15 步预算、 重复评估协议下,GUI-HARVEST 在全部六个冻结基座模型上都取得了密封测试集(Test,201 题)和全量集(Full,361 题)的一致提升:
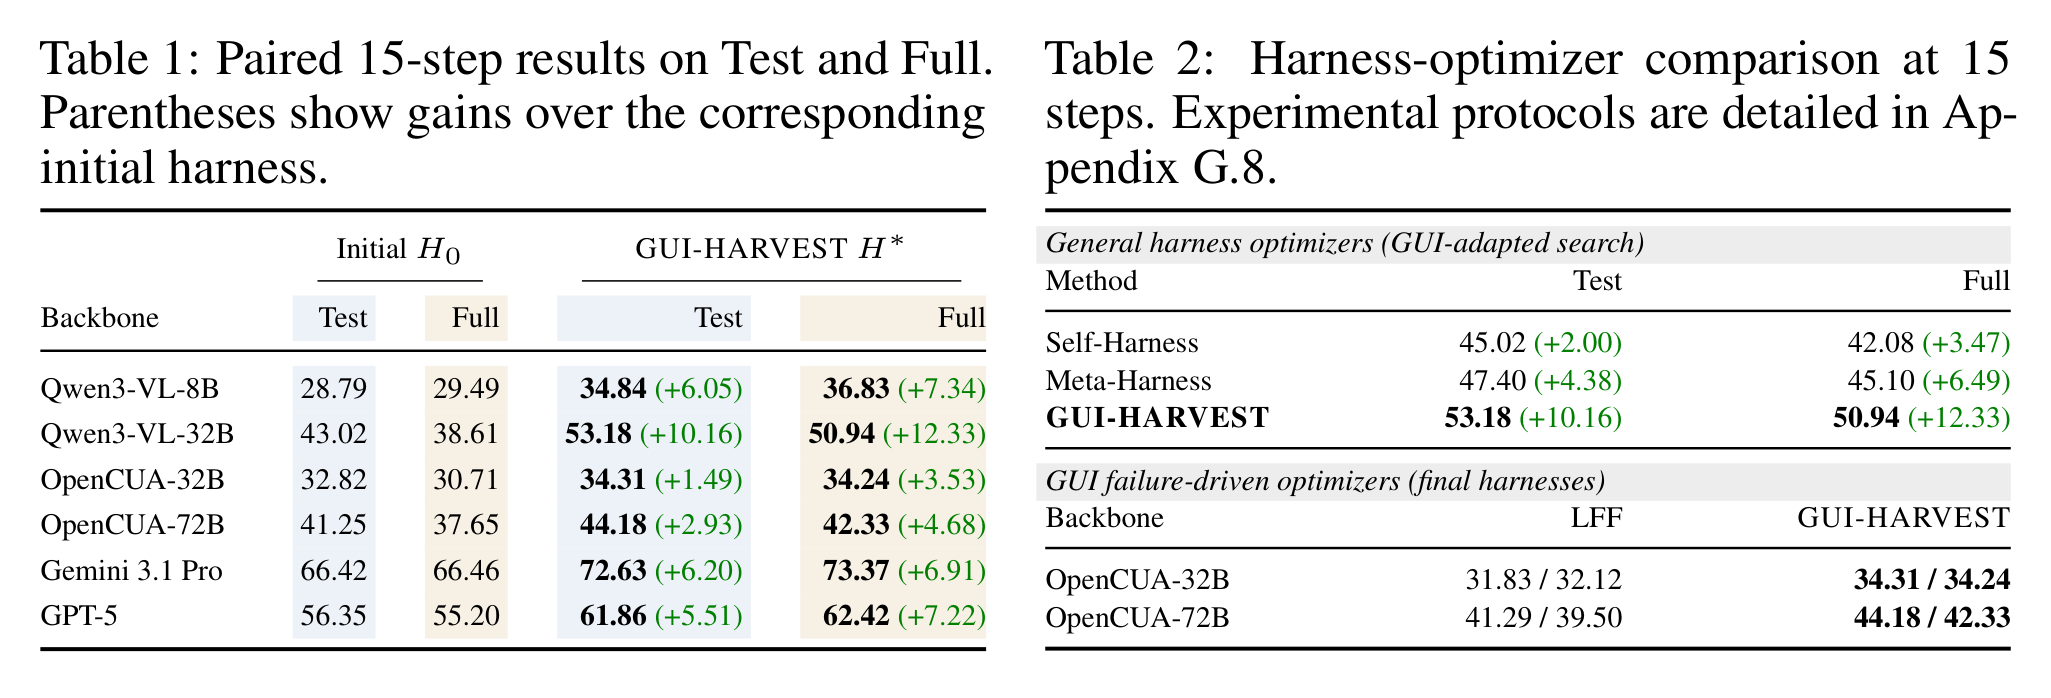
结合附录 Table 4 的完整四集合(Search / Val / Test / Full)数据,可以整理出如下全貌对比表:
| 基座模型家族 | 具体模型 | 初始运行底座 | Search () | Validation () | Sealed Test () | Full-361 () |
|---|---|---|---|---|---|---|
| 通用开源模型 | Qwen3-VL-8B-Instruct | Agent S3 | 31.01 41.43 (+10.41) | 29.72 37.22 (+7.50) | 28.79 34.84 (+6.05) | 29.49 36.83 (+7.34) |
| 通用开源模型 | Qwen3-VL-32B-Instruct | Agent S3 | 31.07 46.25 (+15.18) | 35.06 50.00 (+14.94) | 43.02 53.18 (+10.16) | 38.61 50.94 (+12.33) |
| GUI 专用开源 | OpenCUA-32B | Official OpenCUA | 27.40 33.69 (+6.29) | 28.75 34.63 (+5.88) | 32.82 34.31 (+1.49) | 30.71 34.24 (+3.53) |
| GUI 专用开源 | OpenCUA-72B | Official OpenCUA | 36.25 42.50 (+6.25) | 30.00 37.50 (+7.50) | 41.25 44.18 (+2.93) | 37.65 42.33 (+4.68) |
| 闭源前沿模型 | Gemini 3.1 Pro | Agent S3 | 65.33 72.68 (+7.35) | 67.69 75.92 (+8.23) | 66.42 72.63 (+6.20) | 66.46 73.37 (+6.91) |
| 闭源前沿模型 | GPT-5 | Agent S3 | 52.50 66.25 (+13.75) | 55.00 60.00 (+5.00) | 56.35 61.86 (+5.51) | 55.20 62.42 (+7.22) |
这里有三个值得注意的实验现象:
- 通用开源多模态模型受益最大:
Qwen3-VL-32B-Instruct在完全不训权重的情况下,仅靠演化外围 Harness 就在密封测试集上涨了 10.16 个百分点,全量集涨了 12.33 个百分点,15 步得分(50.94%)直接跨过了 50% 大关,甚至超过了许多系统在 50 步或 100 步下的表现。 - 闭源顶尖模型同样存在明显的 Harness 瓶颈:即便强如
Gemini 3.1 Pro(初始 66.46%)和GPT-5(初始 55.20%),演化 Harness 依然分别带来了 +6.91 和 +7.22 个百分点的的全量提升,Gemini 3.1 Pro在短短 15 步预算下就达到了 73.37%。 - GUI 专用模型的增益相对温和:
OpenCUA-32B/72B的全量增益为 +3.53 和 +4.68 个百分点(Test 上为 +1.49 和 +2.93)。原因在于 OpenCUA 在后训练阶段已经围绕其原生的pyautogui坐标动作空间做了深度绑定,对外部新增工具、代码路由和复杂控制流的适应弹性不如通用指令模型。
5.2 同台对比:大幅领先 Self-Harness、Meta-Harness 与 LFF
在 Table 2 中,作者控制所有变量(统一固定 Qwen3-VL-32B-Instruct 基座、同一个 Agent S3 初始代码树、统一用 Claude Sonnet 5 作为优化器、最多演化 10 轮),对比了把通用优化器迁移到 GUI 场景的效果:
- Self-Harness:Test 得分 45.02%(+2.00),Full 得分 42.08%(+3.47);
- Meta-Harness(即使给它的文件系统同时塞入了源码、轨迹和截图):Test 得分 47.40%(+4.38),Full 得分 45.10%(+6.49);
- GUI-HARVEST:Test 得分 53.18%(+10.16),Full 得分 50.94%(+12.33),在密封测试集上的净增益是 Self-Harness 的 5 倍、Meta-Harness 的 2.3 倍。
而与此前专门针对 OpenCUA 失败轨迹做运行时干预的 LFF(Learning from Failure) 相比,在相同的 15 步协议下,GUI-HARVEST 在 OpenCUA-32B(34.31% vs 31.83% Test)和 OpenCUA-72B(44.18% vs 41.29% Test)上也均胜出。
5.3 演化轨迹与搜索工作量:轮次少不代表容易改
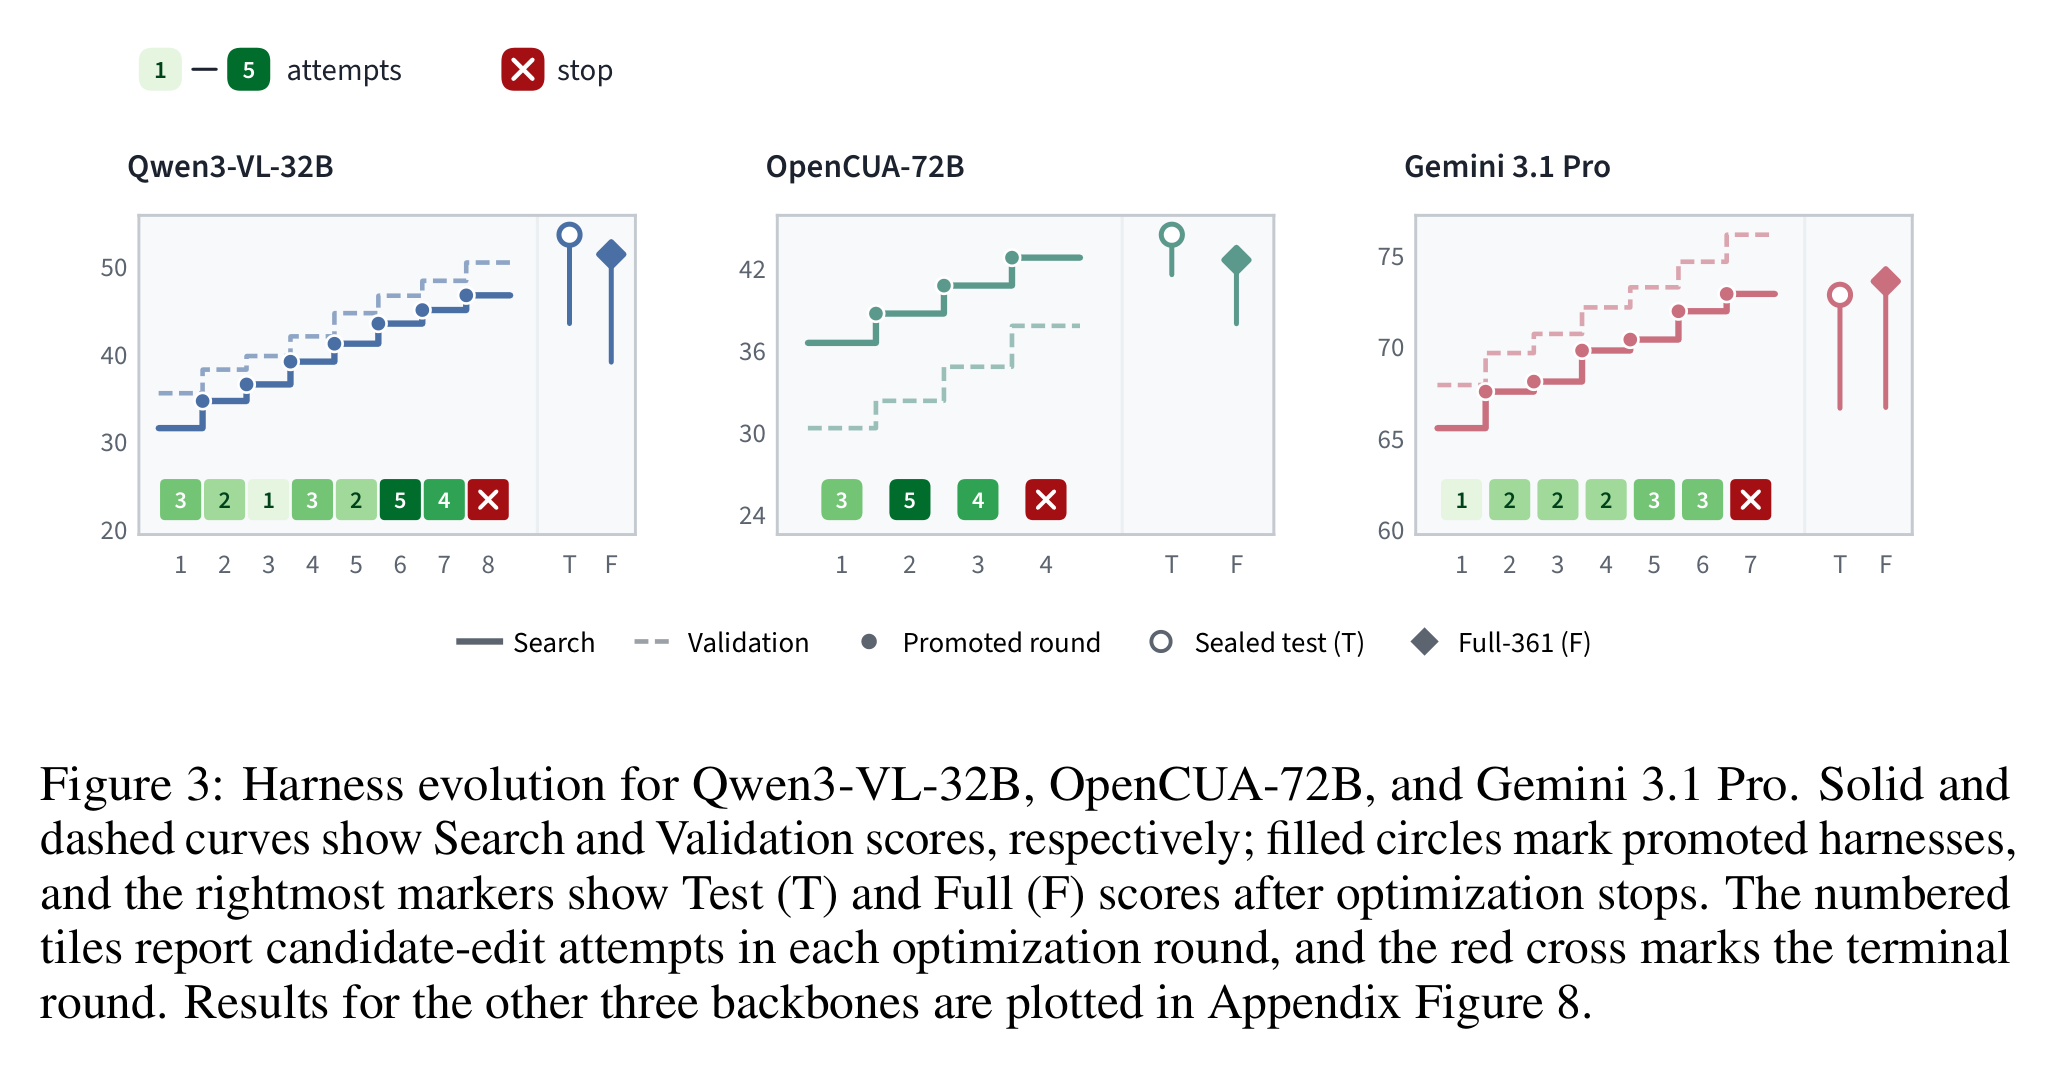
Qwen3-VL-32B、OpenCUA-72B 与 Gemini 3.1 Pro 的 Harness 演化过程(源自论文 Fig. 3)。实线为 Search 得分,虚线为 Validation 得分,底部绿色方块内的数字代表每一轮为获得晋升所消耗的候选补丁尝试次数(1–5 次),红色叉号代表连续 5 次尝试被拒后触发终止。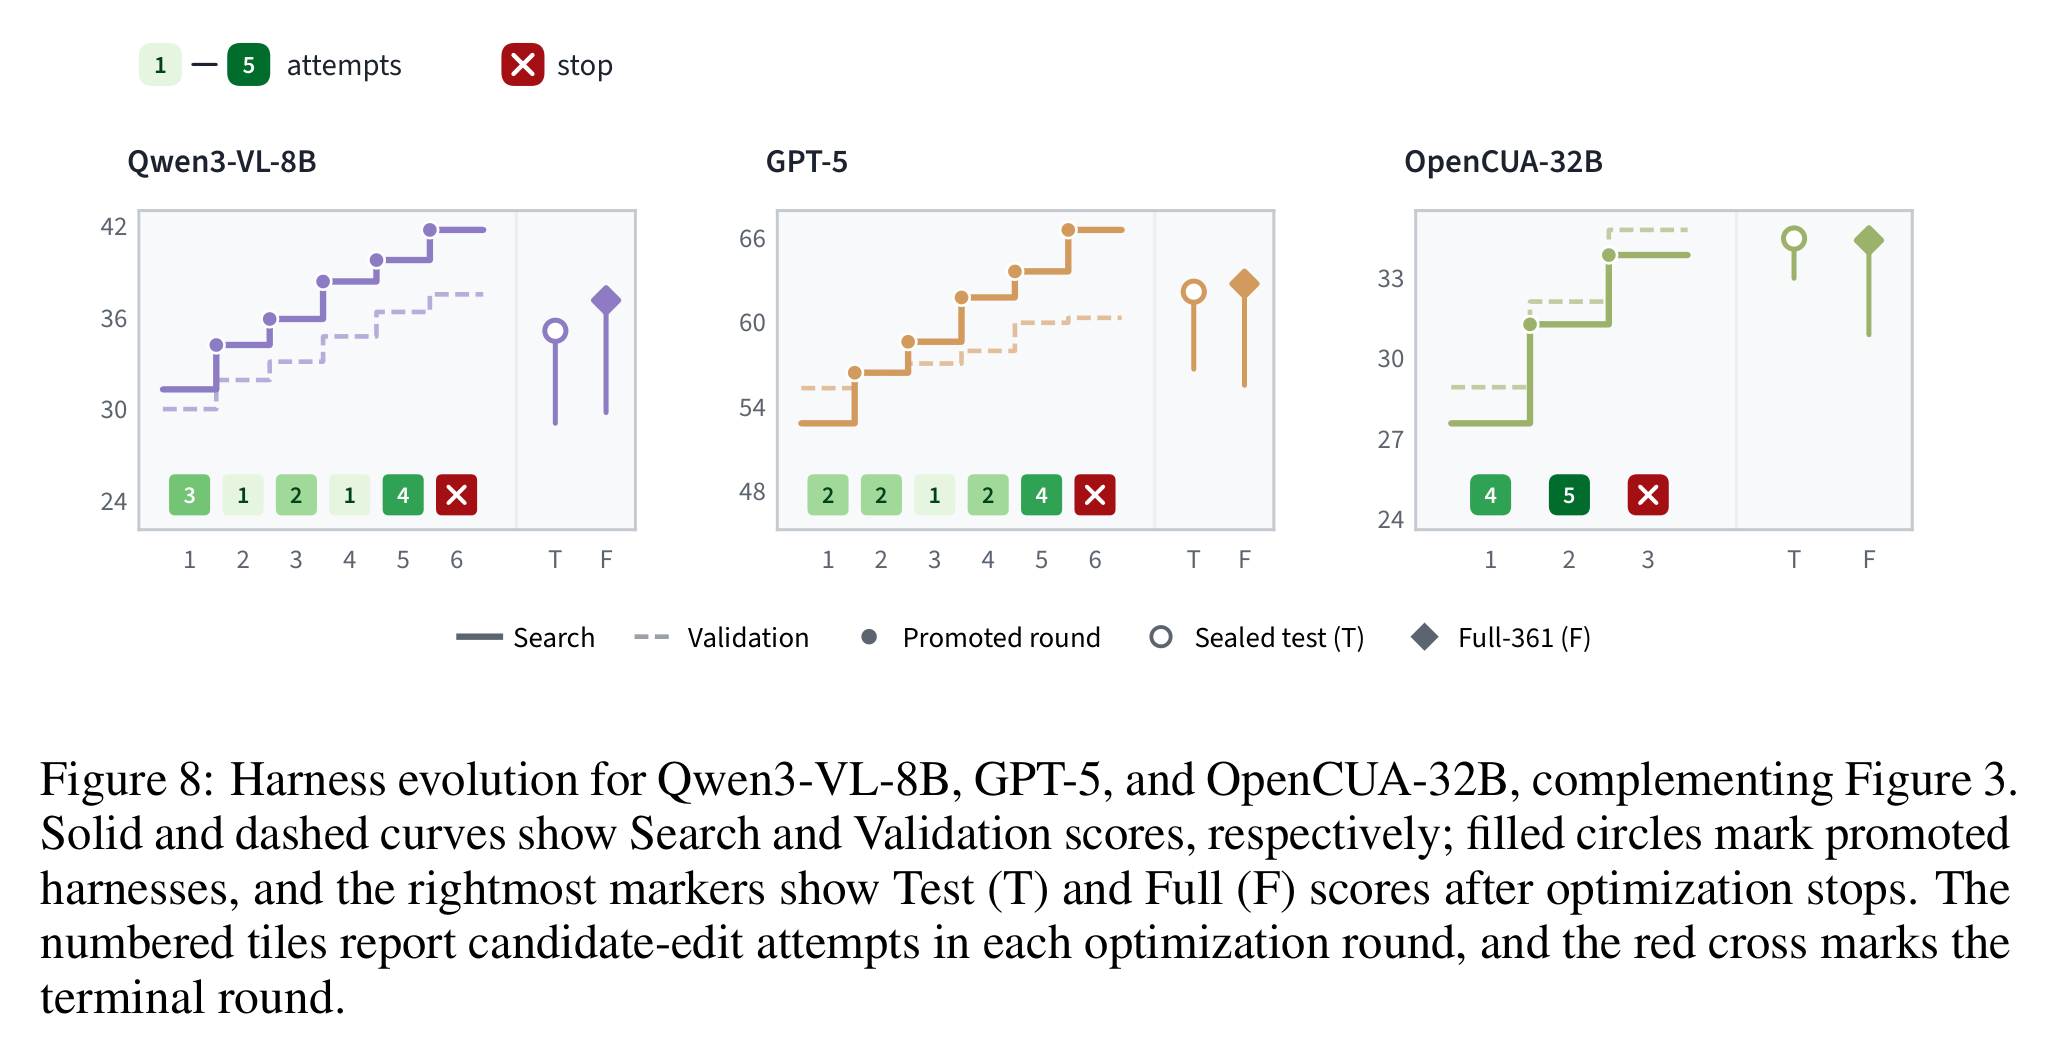
Qwen3-VL-8B、GPT-5 与 OpenCUA-32B 的 Harness 演化过程(源自论文 Appendix Fig. 8)。把图 3 和图 8 合在一起看,六个基座模型的演化深度与每次晋升的搜索代价差异明显:
Qwen3-VL-32B走了 8 轮,成功晋升 7 次更新(共消耗 25 次候选评估,最后一轮第 8 轮连续 5 次被拒后停止);Gemini 3.1 Pro走了 7 轮,晋升 6 次更新(18 次尝试);GPT-5和Qwen3-VL-8B均走了 6 轮,晋升 5 次更新(各消耗 16 次尝试);OpenCUA-72B(4 轮晋升 3 次,17 次尝试)与OpenCUA-32B(3 轮晋升 2 次,14 次尝试)则更早撞上天花板,且每一轮晋升平均要试 4 到 5 个补丁。
5.4 步数预算外推(15 50 100 步)与跨基准零样本迁移(WAA)
一个自然的问题是:只在 15 步短预算下优化出来的 Harness,放到 50 步、100 步长周期预算下会不会失效?放到另一个操作系统的 Benchmark 上还能不能用?
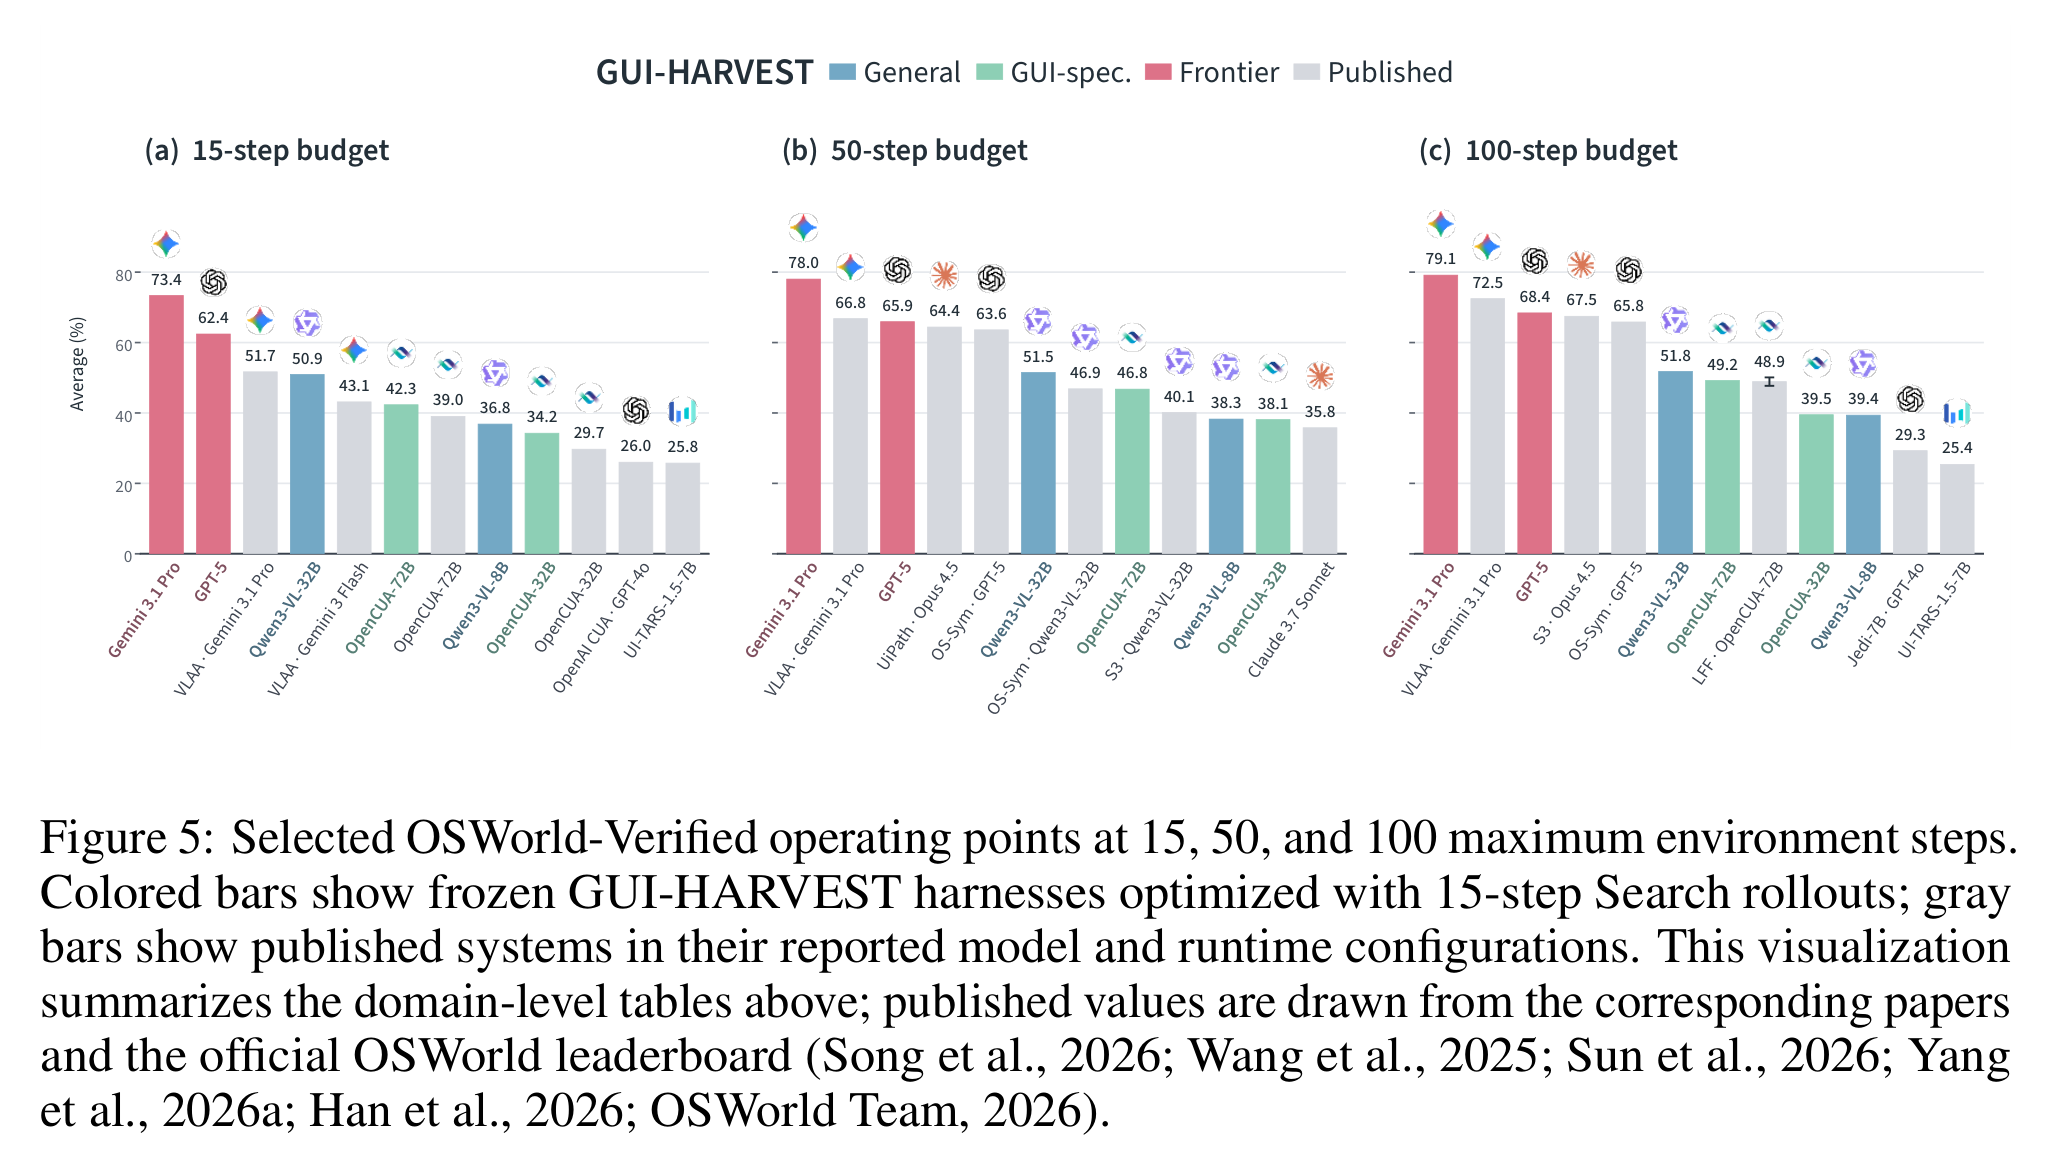
从图 5 和附录 Tables 5–7 可以看到:
- 步数外推能力:直接拿 15 步冻结的 Harness 去跑 50 步和 100 步,
Gemini 3.1 Pro从 73.37%(15 步)进一步升至 78.03%(50 步) 和 79.14%(100 步),超越了榜单上 100 步的VLAA-GUI / Claude Opus 4.6(77.45%)和OpenAPA / Gemini 3.1 Pro(78.34%);GPT-5也从 62.42%(15 步)升至 65.93%(50 步) 和 68.42%(100 步)。 - 开源模型与前沿模型的长程差距暴露:当步数预算从 15 步放宽到 100 步时,
Gemini 3.1 Pro和GPT-5还能再涨 +5.77 和 +6.00 个百分点;但Qwen3-VL-8B和32B只涨了 +2.54(36.83% 39.37%)和 +0.85 个百分点(50.94% 51.79%)。这说明 15 步演化已经帮 Qwen 摘掉了大部分短程低效与死循环问题,但在超过 15 步的复杂多应用长程任务上,开源模型受限于底层跨源推理和长程状态追踪能力,多给步数也很难救回来。 - 跨操作系统零样本迁移(OSWorld Linux WindowsAgentArena):作者把在 OSWorld(Ubuntu 桌面)上演化冻结的
Qwen3-VL-32B和GPT-5Harness 直接搬到 WindowsAgentArena(WAA,154 个 Windows 真实任务,50 步预算),仅替换了平台底层的观察、动作与 Shell 命令适配器,完全不使用任何 WAA 轨迹做优化:Qwen3-VL-32B-Instruct从 Agent S3 基线的 38.21% 提升至 44.68%(+6.47 个百分点)(对比官方 Qwen 基线 31.68% 高出 13 个百分点);GPT-5从 Agent S3 基线的 50.88% 提高到 64.75%(+13.87 个百分点),在 WAA 50 步榜单上超过了OS-Symphony / GPT-5(63.45%)和 100 步的VLAA-GUI / Gemini 3 Flash(61.00%)。
这说明 GUI-HARVEST 学到的不是“Ubuntu 某个软件按钮在哪个坐标”的局部补丁,而是“完成前检查未保存状态”、“死循环拦截与重路由”、“代码执行结果回执核验”这类跨操作系统的运行时控制机制。
5.5 推理成本与准确率:为什么优化后反而更省钱?
通常往 Agent 外围加校验、加恢复逻辑会让推理步数变长、API 账单变贵。但 GUI-HARVEST 给出了一个相反的实测结果:对于前沿大模型,演化后的 Harness 在提高准确率的同时,端到端 API 推理成本反而下降了。
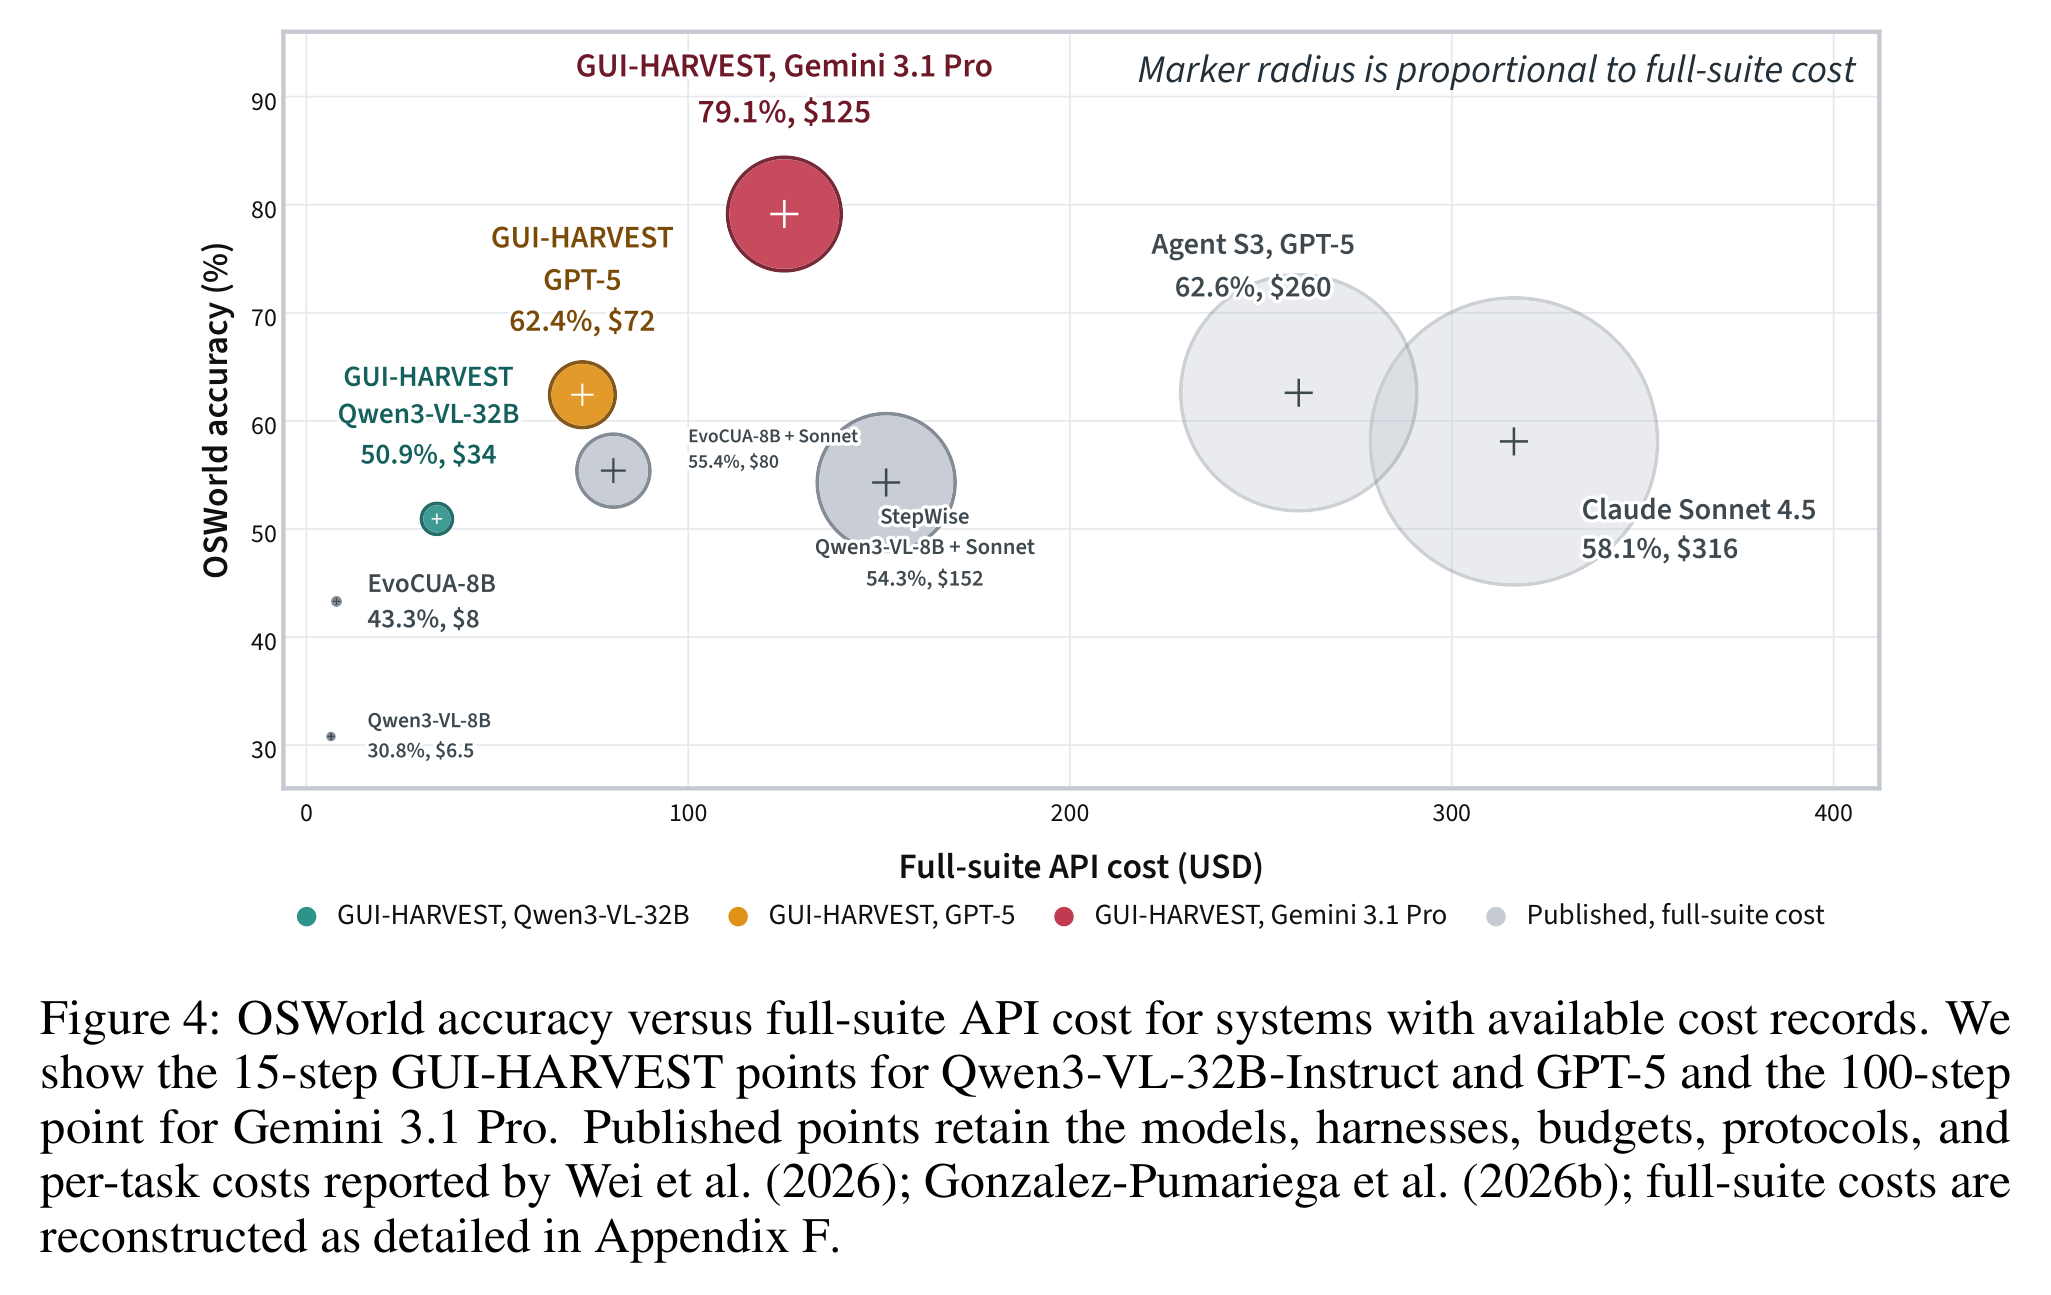
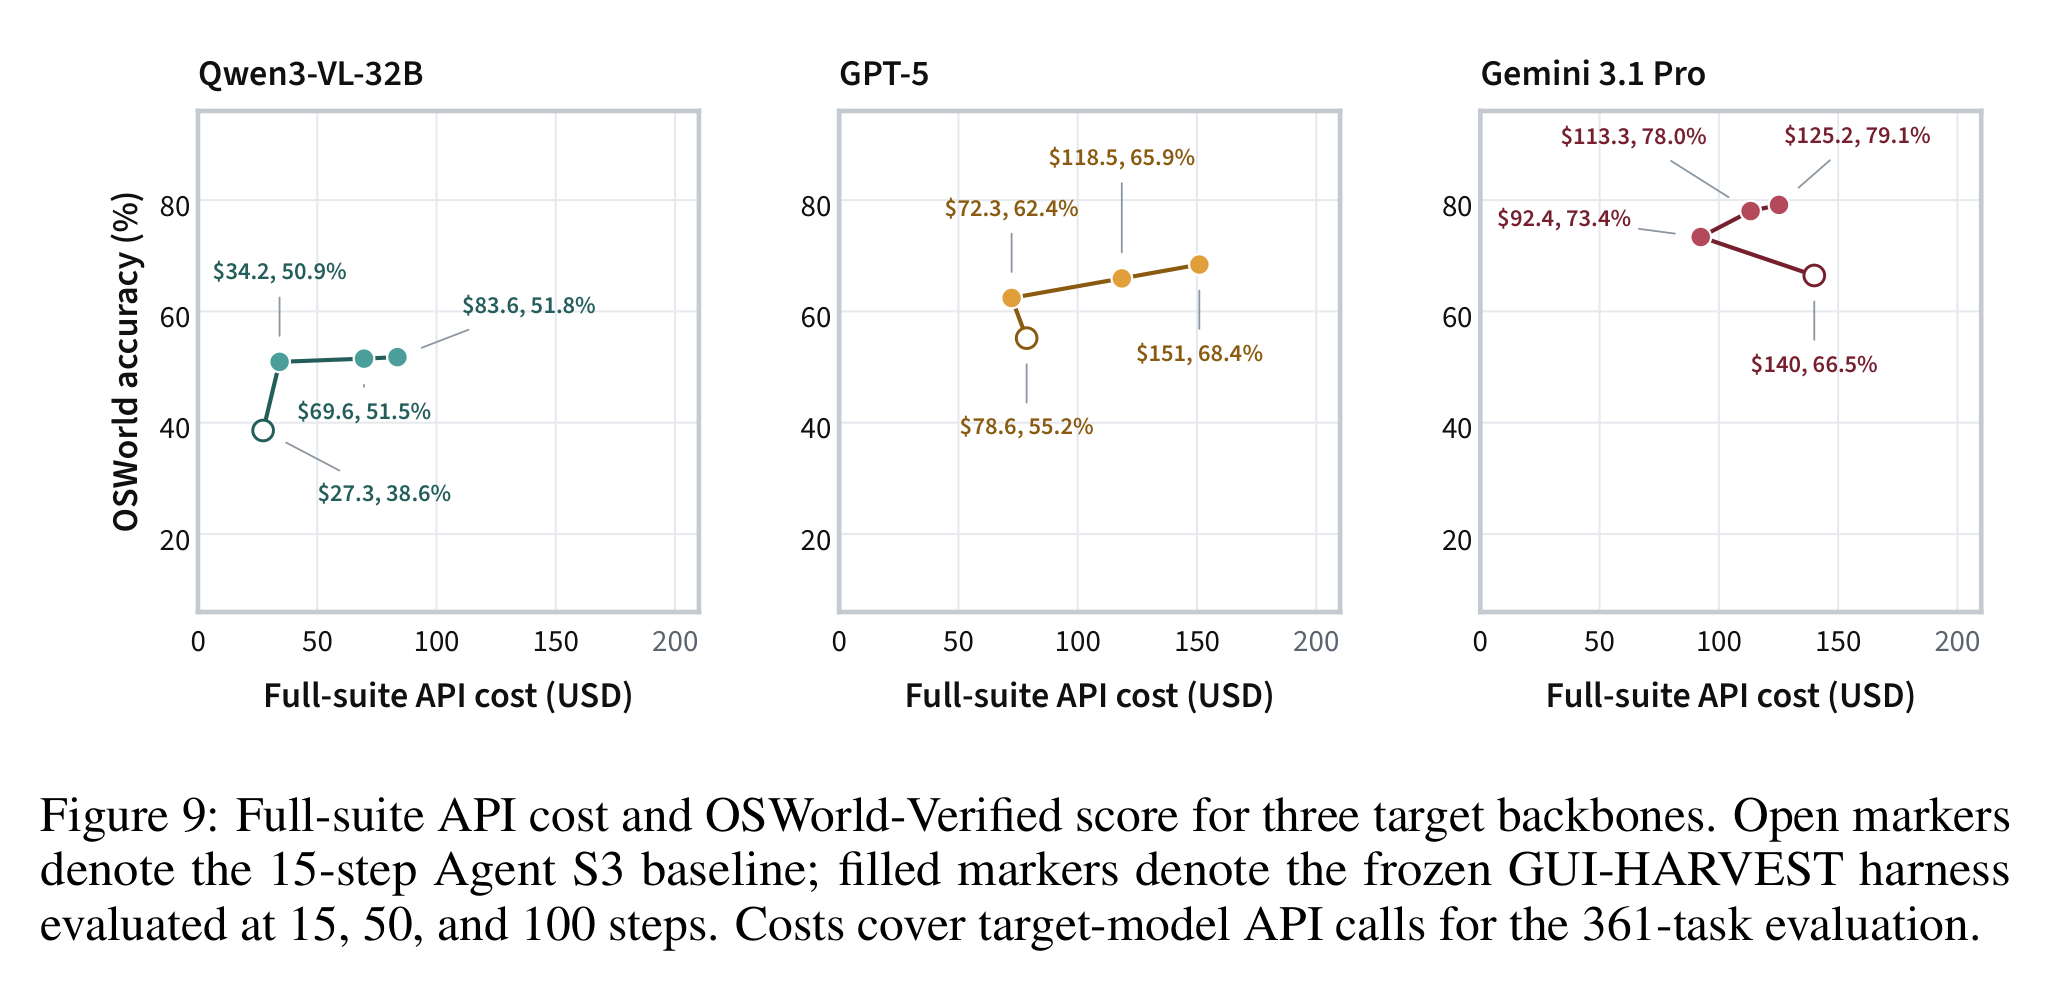
结合图 4 与图 9 的具体账单数据(按跑完 361 题的 API 费用计算):
- 在同为 15 步预算的同基座对比中(图 9):
Gemini 3.1 Pro:初始 Agent S3 跑满全集要花 $140.0(66.5%),而演化后的 Harness 在 15 步下只需 $92.4(省了 34% 的费用),准确率提高到 73.4%;即便放宽到 50 步($113.3,78.0%)和 100 步($125.2,79.1%),总账单依然低于初始 15 步基线。GPT-5:15 步下从 $78.6(55.2%)降至 $72.3(62.4%),同样同时改善了准确率和推理开销。Qwen3-VL-32B:15 步下从 $27.3(38.6%)增加到 $34.2(50.9%),多花 $6.9 换来了 +12.33 个百分点的提升。
- 跨系统对比中(图 4):
GUI-HARVEST / GPT-5(15 步)拿到了 62.4%,基本追平了 100 步的Agent S3 / GPT-5(62.6%),但全量 API 成本从 $260 降到了 $72(节省约 72%);GUI-HARVEST / Gemini 3.1 Pro(100 步,79.1%,$125)相比Claude Sonnet 4.5(58.1%,$316),准确率高出 21.0 个百分点,而 API 费用降低了约 60%。
为什么加了门禁反而更省钱?原因在失败轨迹的形态里:未经优化的初始 Harness 一旦遭遇无效点击或策略卡壳,就会陷入重复无效动作死循环,或者在工具执行完后继续做无意义的冗余操作,把 15 步预算耗尽;而演化出的代码路由(Code Routing)和死循环拦截机制,让原本需要点十几步 UI 的批量操作通过一两步脚本完成并及时终止,减少了无效的 VLM 多模态长上下文调用。
5.6 消融实验与重复次数 的权衡
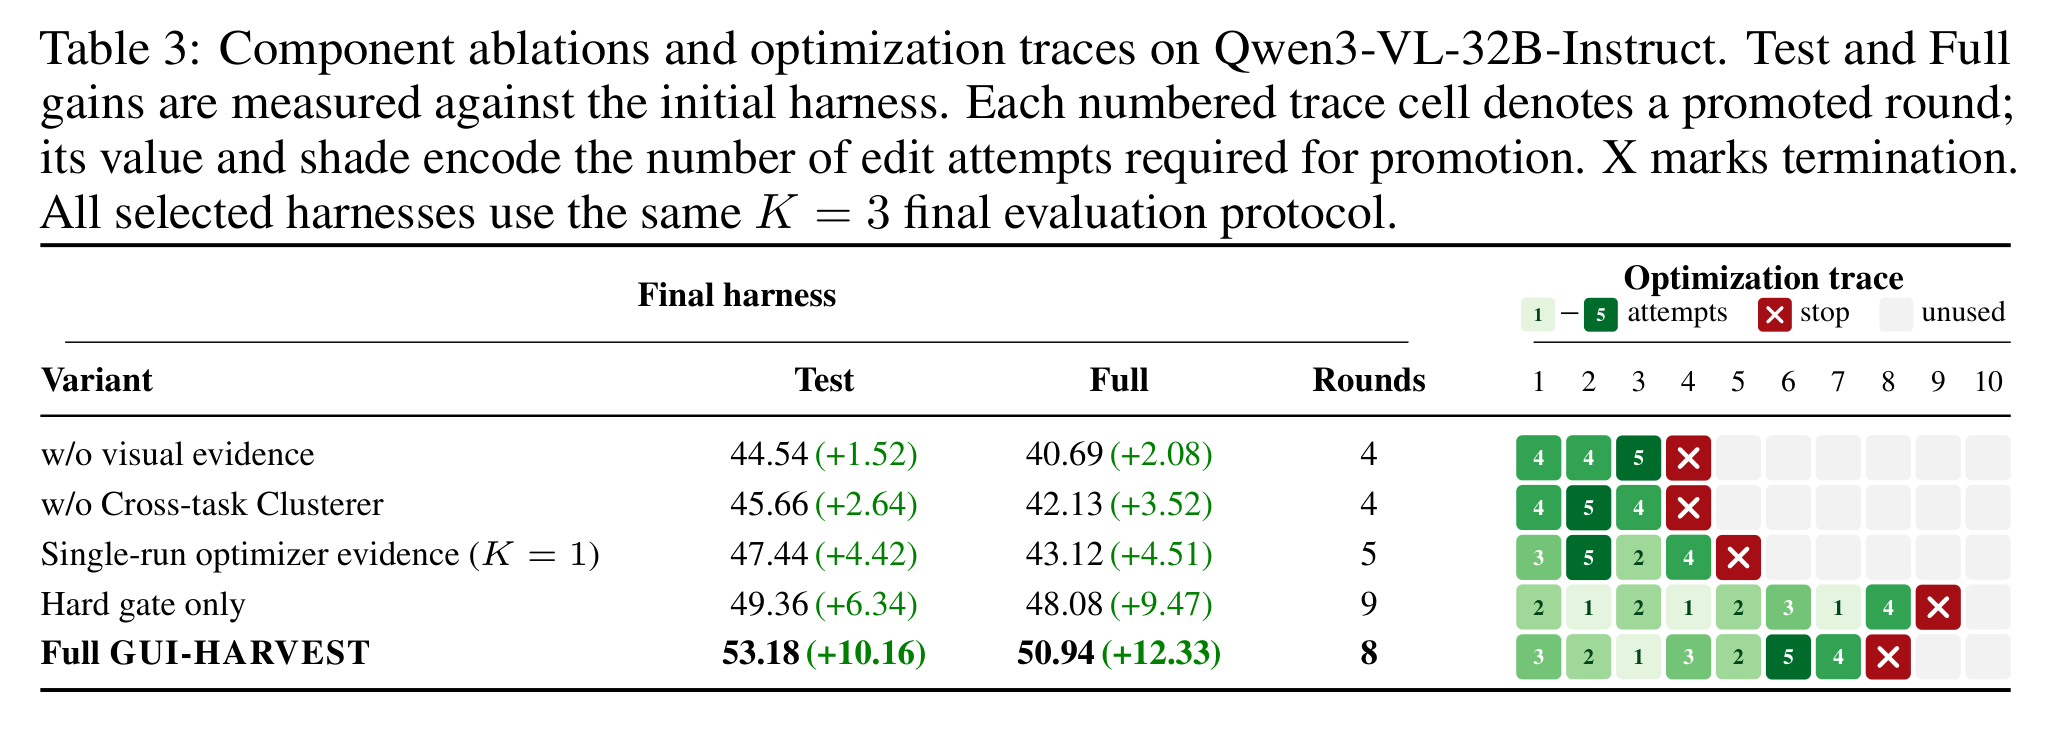
Qwen3-VL-32B-Instruct 上逐一移除核心组件的消融实验(源自论文 Table 3)。所有最终选出的 Harness 均采用相同的 协议评估。Table 3 的四个消融变体逐一验证了论文的核心设计:
- 去掉视觉证据(
w/o visual evidence):Test 增益从 +10.16 降至 +1.52(44.54%),且演化到第 4 轮就因连续 5 次尝试被拒而停止。没有截图证据,优化器无法判断动作是否真正在界面上生效。 - 去掉跨任务聚类器(
w/o Cross-task Clusterer):Test 增益跌至 +2.64(45.66%),同样在第 4 轮早停。单任务局部发现如果直接拿去改代码,写出的补丁缺乏跨任务共性支撑,很难通过验证集门禁。 - 单次运行证据(
Single-run optimizer evidence, K=1):Test 增益为 +4.42(47.44%),比完整版低了 5.74 个百分点。 - 去掉行为软门禁(
Hard gate only):只看 Search 和 Validation 分数涨不涨,不核验事前行为预测。结果优化器一路跑了 9 轮(晋升了 8 次补丁),比完整版(8 轮晋升 7 次)改得更多,但最终密封测试集得分反而只有 49.36%(比完整版低 3.82 个百分点)。这说明:只靠分数门禁会把趁着评测波动混进来的补丁放行,而事前行为预测门禁过滤掉了这类伪改进。
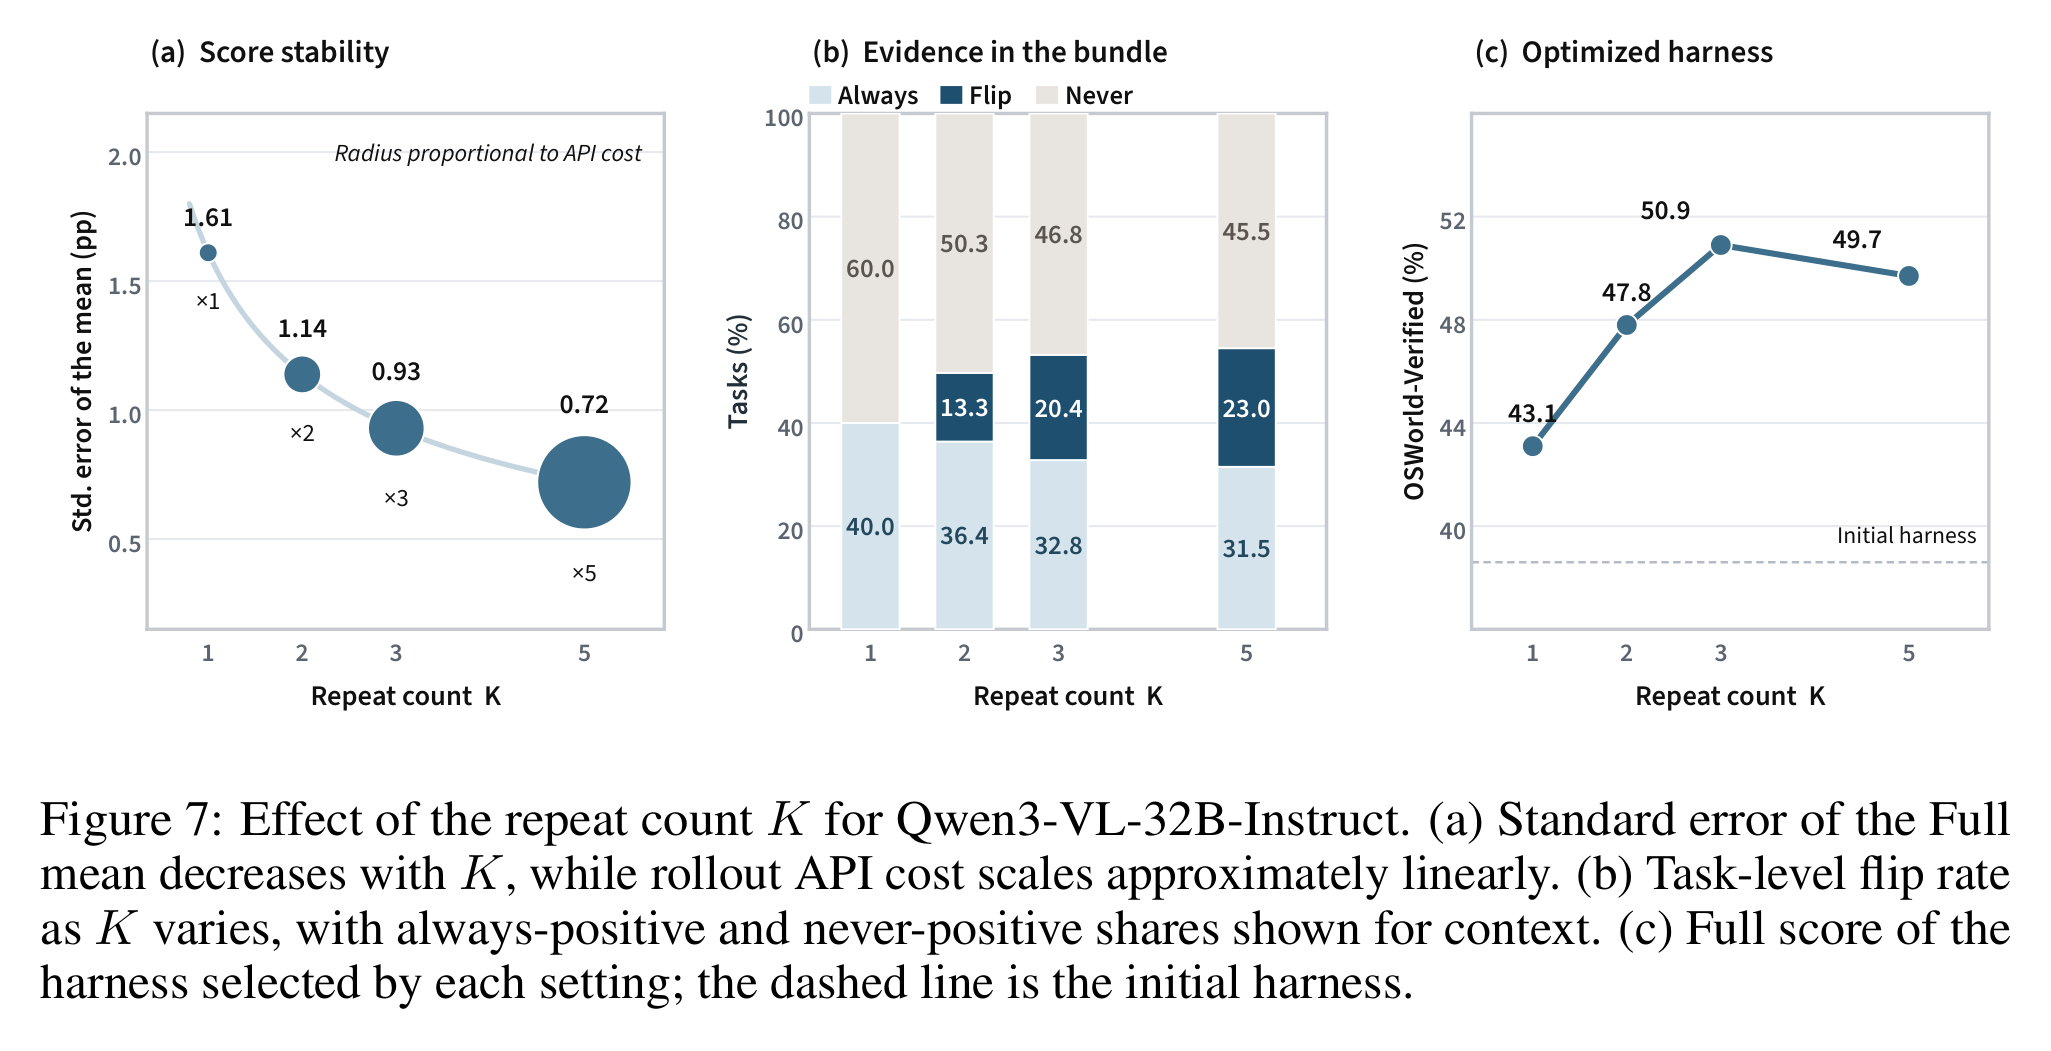
Qwen3-VL-32B-Instruct 的影响(源自论文 Appendix Fig. 7)。(a) 全集均值标准误随 增大而下降,采样成本线性增长;(b) 任务翻转率随 从 0%( 无法观测翻转)升至 13.3%()、20.4%()和 23.0%();(c) 最终演化出的 Harness 全集得分在 时达到峰值 50.9%, 时反而略降至 49.7%。图 7 进一步解释了为什么选择 :当 从 1 增加到 3 时,均值标准误从 1.61 个百分点降至 0.93 个百分点,暴露出的翻转任务比例达到 20.4%,为 Evidence Analyst 提供了充足的“同题成败对照”,使最终 Full 得分从 43.1% 提高到 50.9%。而继续加到 时,虽然翻转任务比例微增到 23.0%,但采样成本翻了 5 倍,且过多偶发分支反而让优化器选出了稍弱的 49.7% Harness。 兼顾了诊断信息量与采样预算。
6. 深入诊断:不同模型家族到底缺什么 Harness 能力?
这篇论文最具长期参考价值的部分,其实是附录 D 中的 Table 9 和 Table 10——它相当于用同一套自动化显微镜,把当前三大类主流基座模型(通用开源、GUI 专用开源、闭源前沿)在真实桌面环境中的常见病灶和对应的有效药方做了一次全面体检。
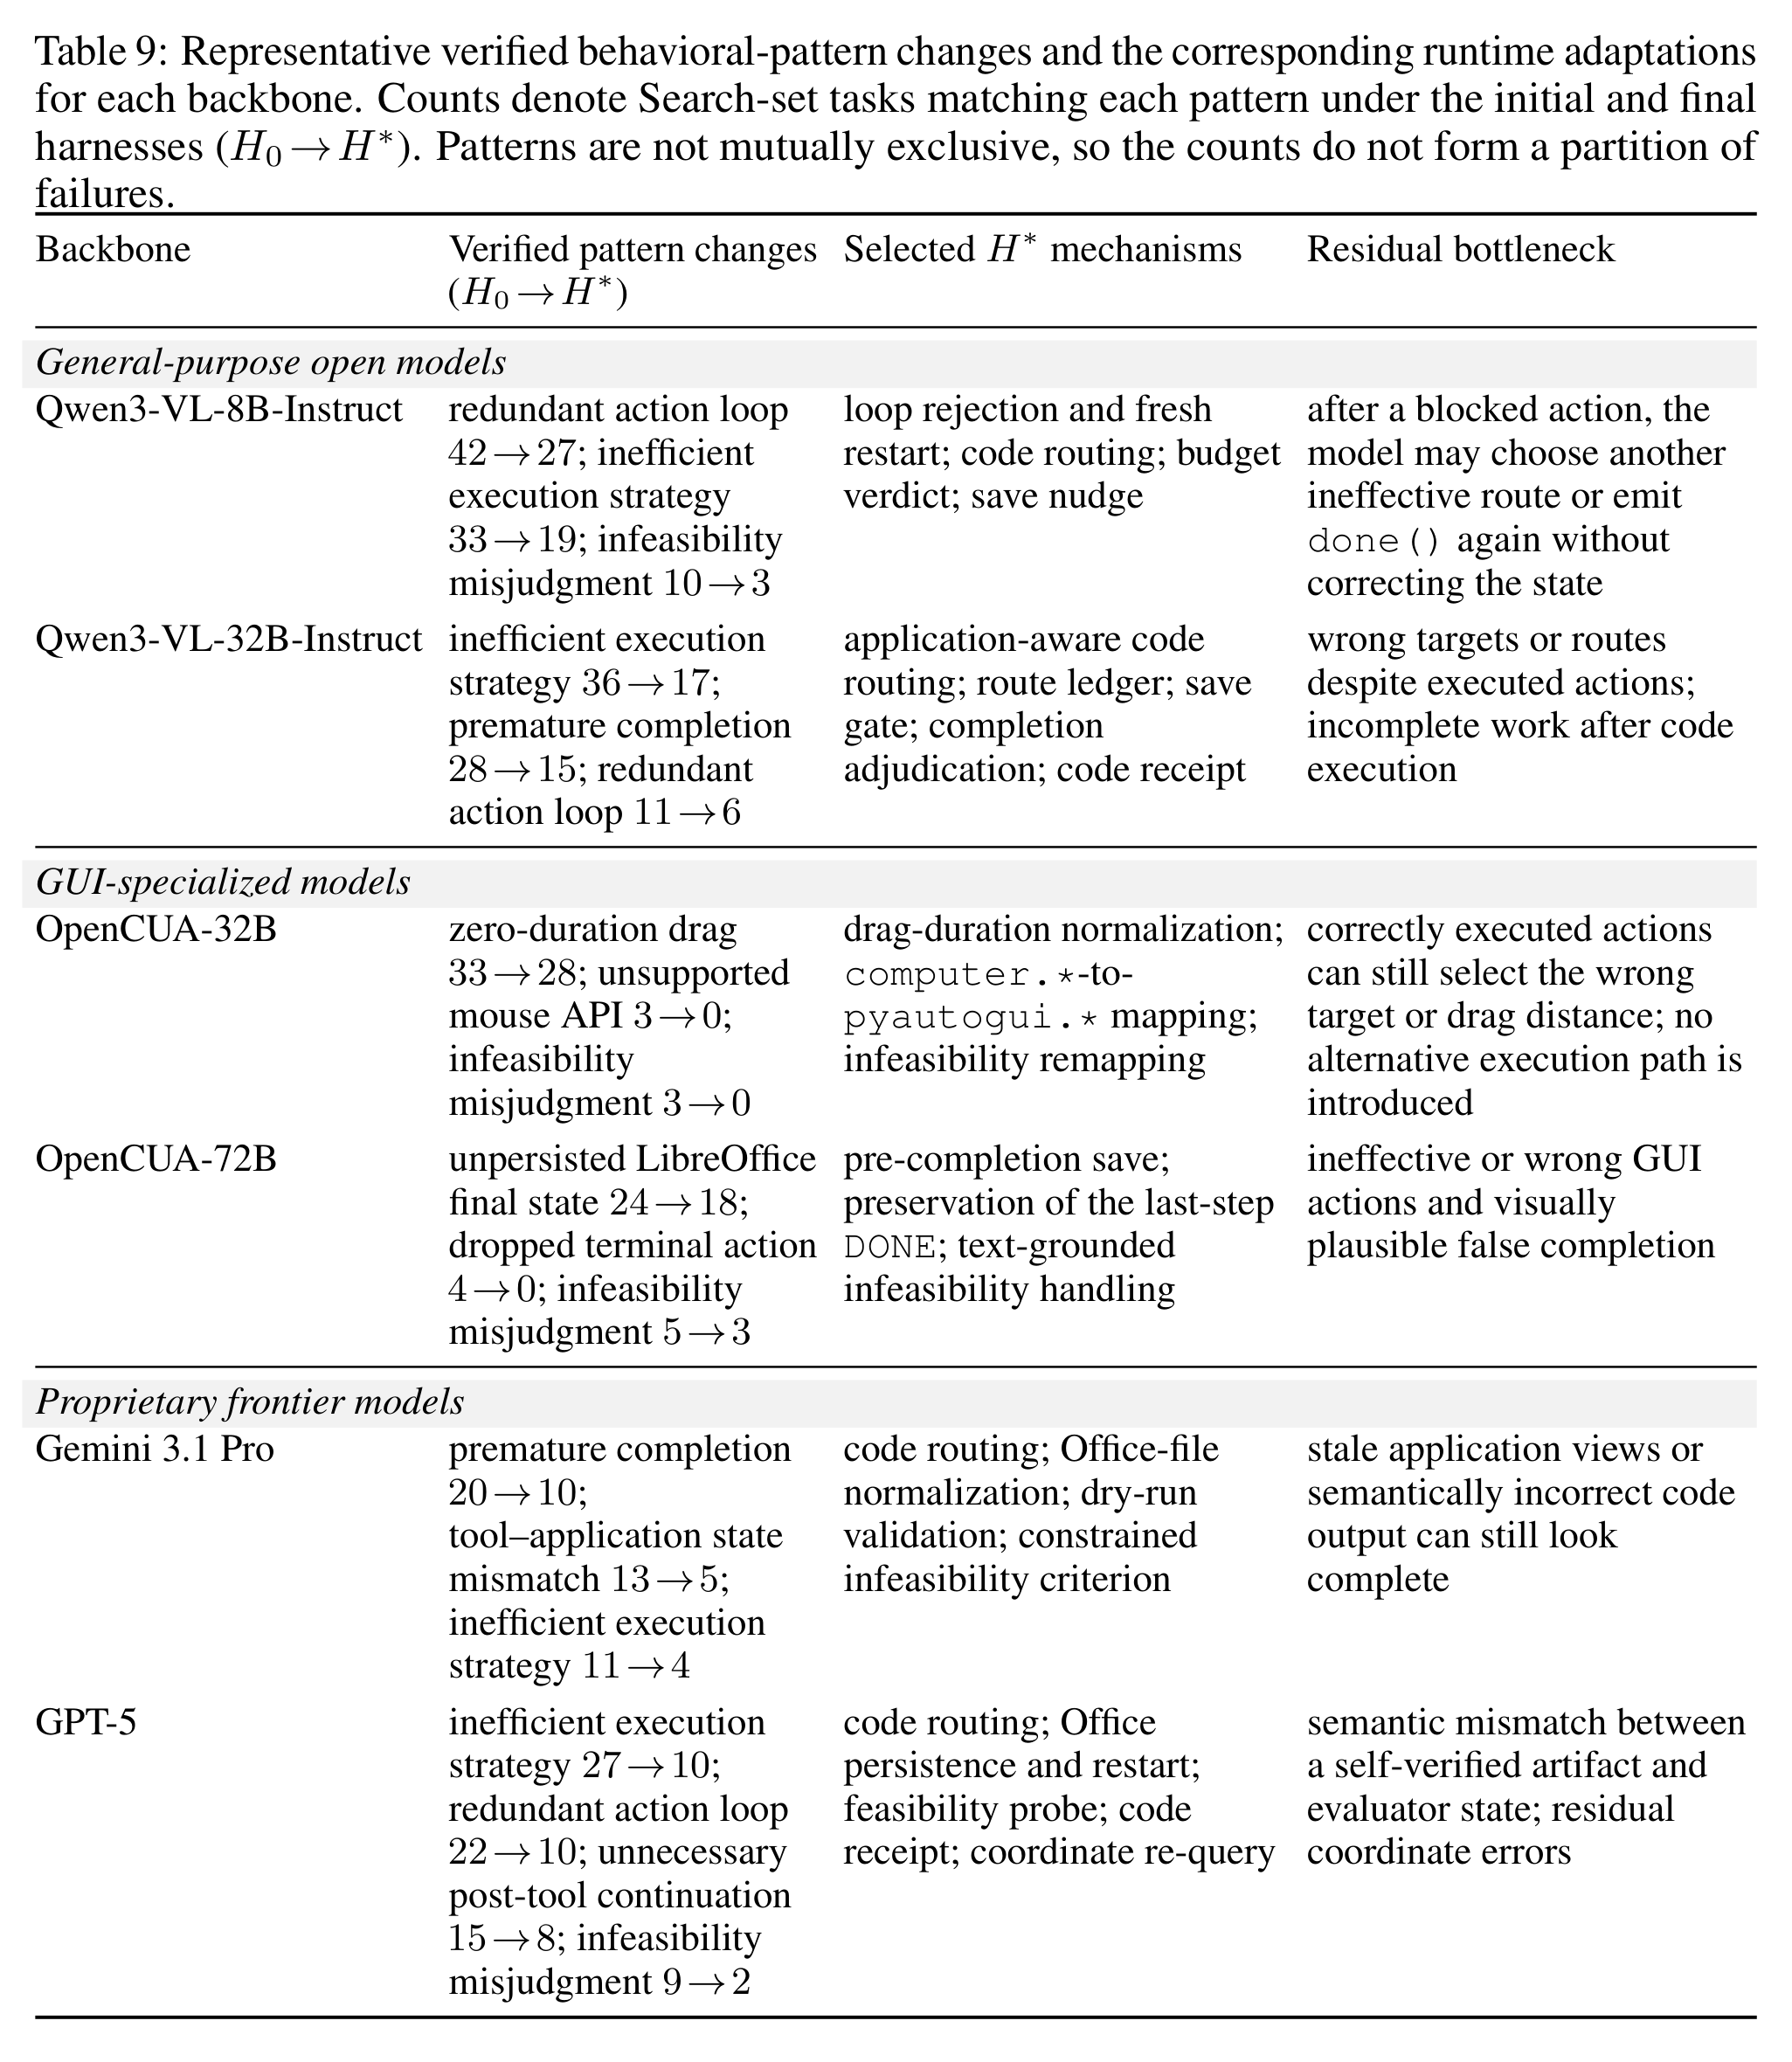
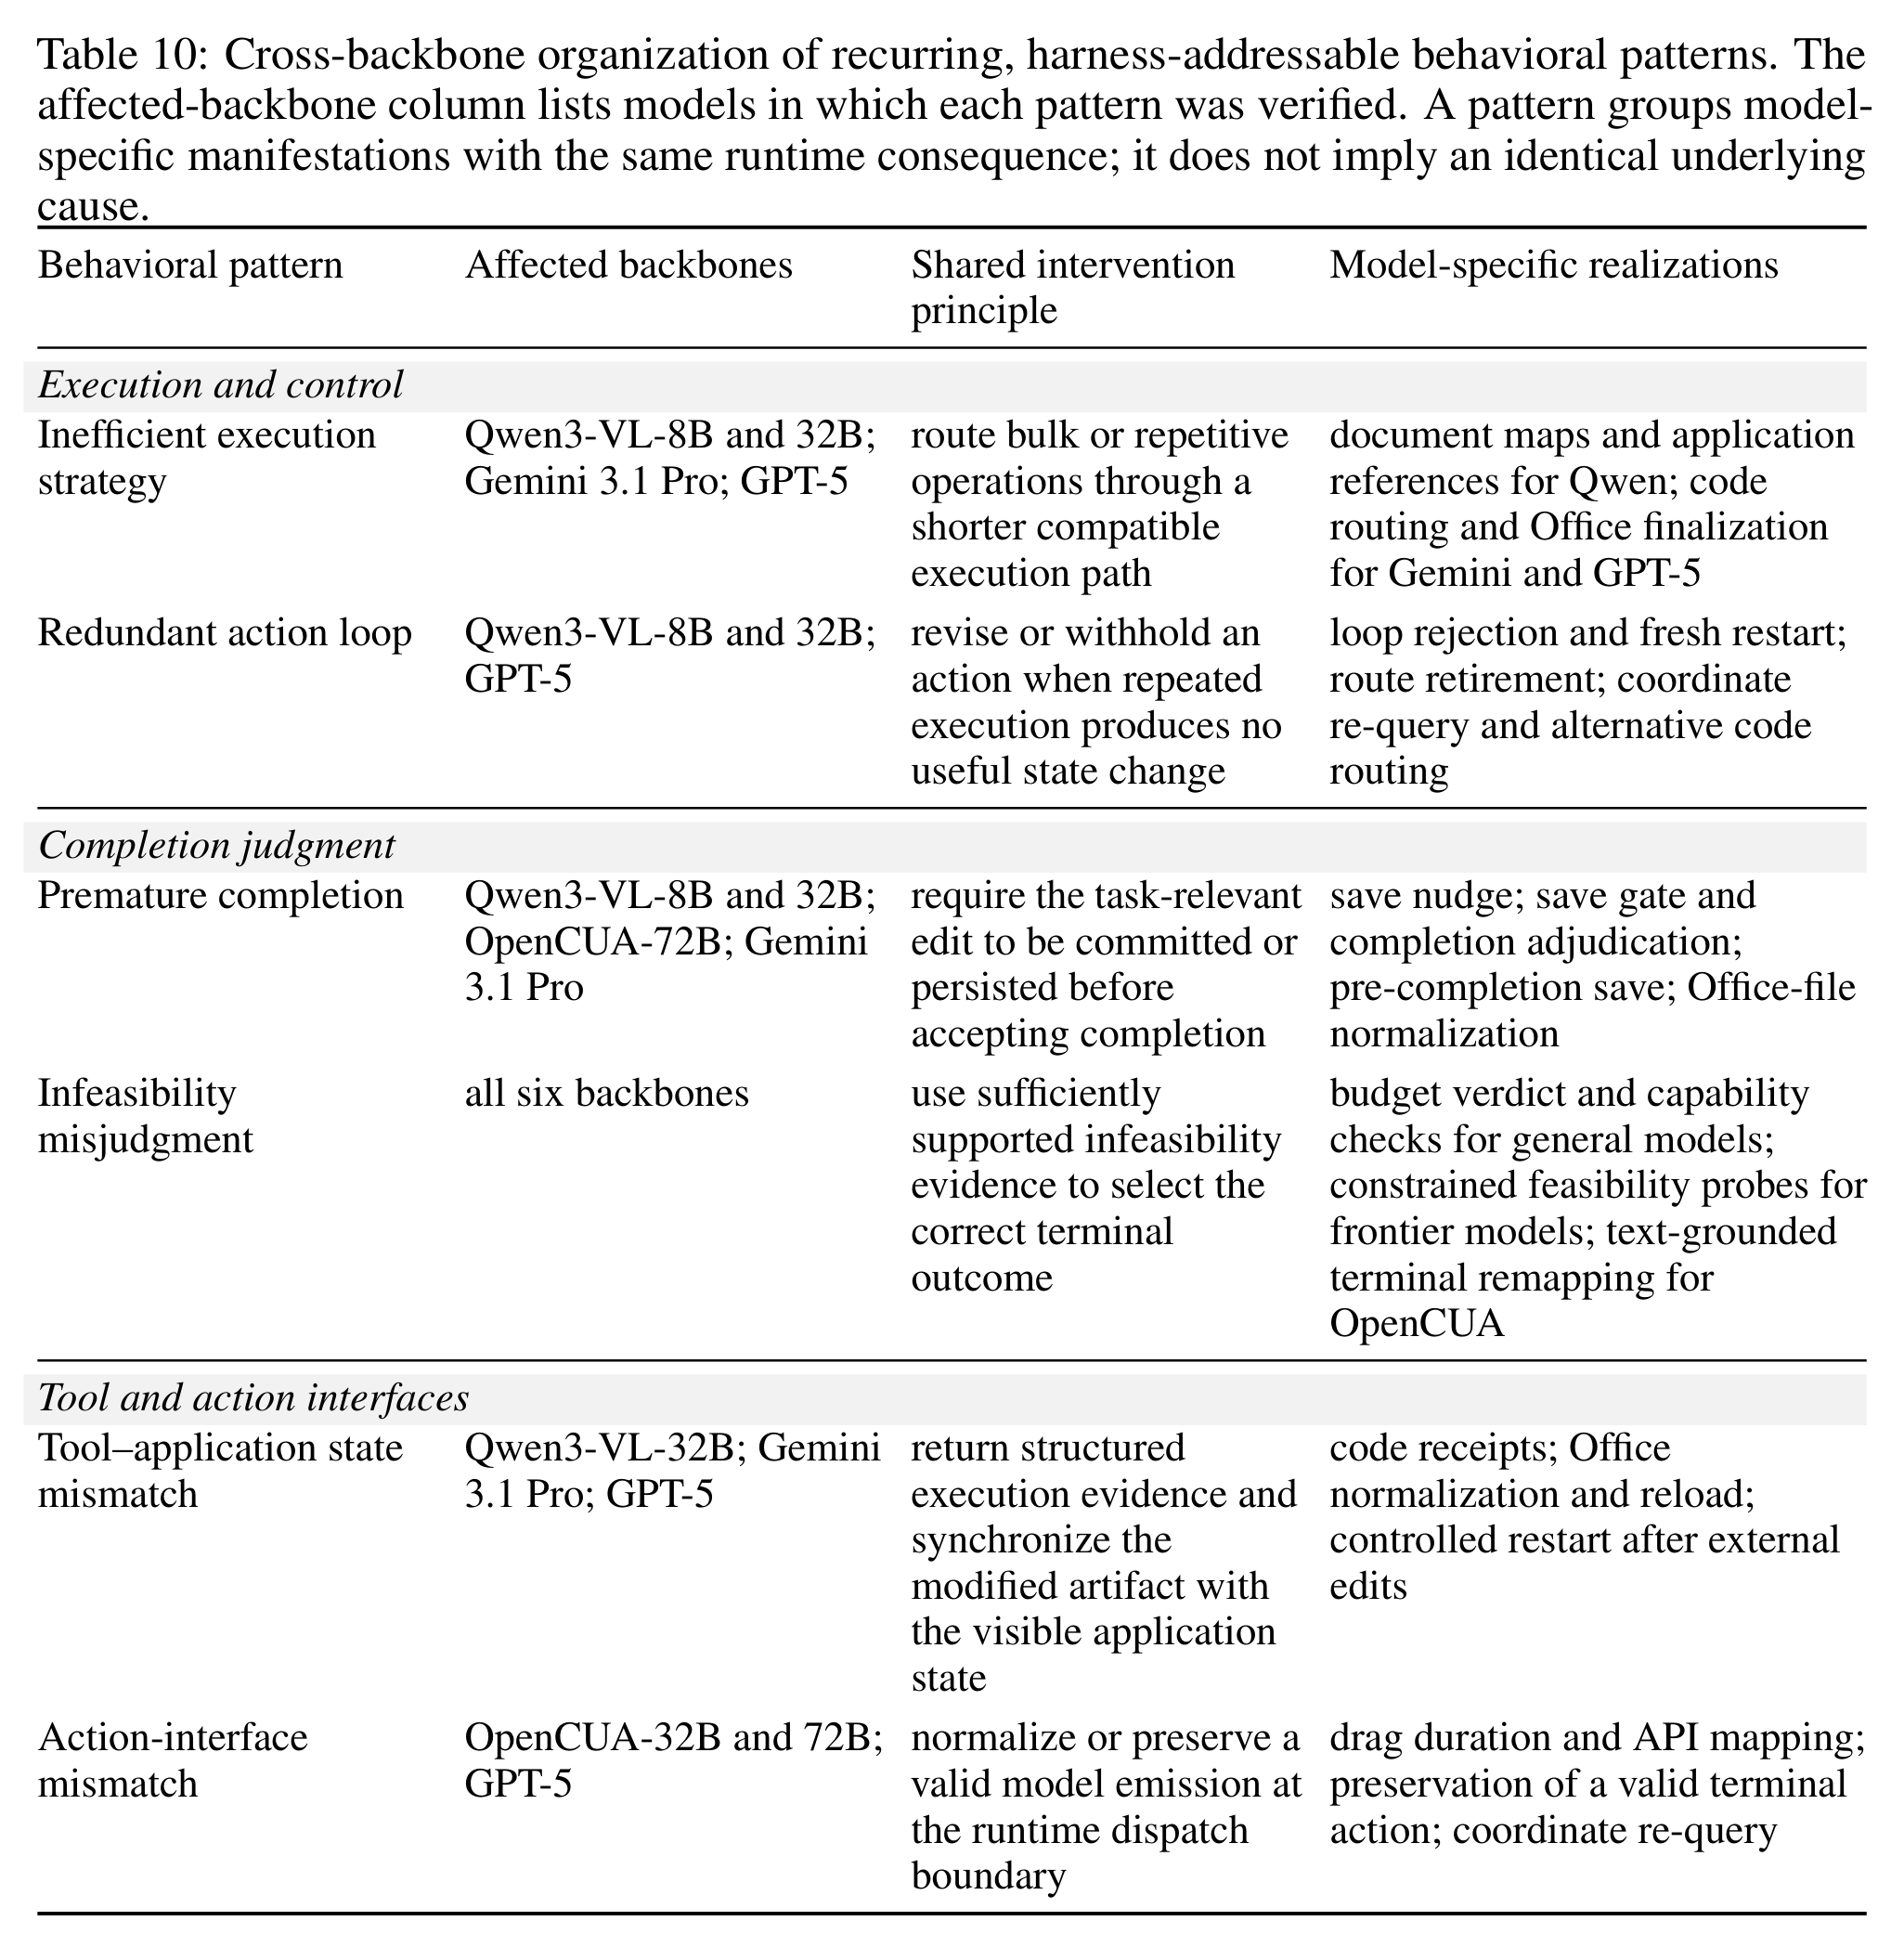
仔细对照 Table 9 与 Table 10,可以提炼出三条非常关键的领域规律:
6.1 六大共性可修复病灶(Harness-Addressable Patterns)
跨所有模型,能够通过外围 Harness 显著缓解的失败集中在三大类、六个模式:
- 执行与控制(Execution and control)
- 低效执行策略(Inefficient execution strategy):明明可以通过写一段 Python/Bash 脚本批量处理表格或文件,模型却偏要一下下点 GUI 菜单,把 15 步预算耗光。在
Qwen3-VL-32B上该类失败从 36 题降至 17 题,GPT-5从 27 题降至 10 题,Gemini 3.1 Pro从 11 题降至 4 题。 - 冗余动作死循环(Redundant action loop):同一个点击或快捷键连续执行却没有任何屏幕状态推进。在
Qwen3-VL-8B上从 42 题降至 27 题,GPT-5从 22 题降至 10 题。
- 低效执行策略(Inefficient execution strategy):明明可以通过写一段 Python/Bash 脚本批量处理表格或文件,模型却偏要一下下点 GUI 菜单,把 15 步预算耗光。在
- 完成判定(Completion judgment)
- 过早宣布完成(Premature completion):如前文图 11 案例,改完内容没按保存或没失焦提交就调
done()。Qwen3-VL-32B从 28 题降至 15 题,Gemini 3.1 Pro从 20 题降至 10 题,OpenCUA-72B未持久化 LibreOffice 状态从 24 题降至 18 题。 - 不可行任务误判(Infeasibility misjudgment):OSWorld 中包含一部分故意设置的不可行任务(考察 Agent 能否识别并主动报
FAIL),或者模型遇到一点阻碍就草率放弃报不可行。该问题在全部六个基座模型中均被修补(例如Qwen3-VL-8B从 10 题降至 3 题,GPT-5从 9 题降至 2 题)。
- 过早宣布完成(Premature completion):如前文图 11 案例,改完内容没按保存或没失焦提交就调
- 工具与动作接口(Tool and action interfaces)
- 工具—应用状态不同步(Tool–application state mismatch):Agent 调用后台 Python 脚本直接改了磁盘上的
.xlsx或.docx文件,但桌面上正打开着的 LibreOffice 窗口里显示的还是旧缓存视图,或者关闭窗口时旧缓存把脚本改好的文件覆盖了!修复方案是引入结构化代码执行回执(Code Receipts)、Office 文件规范化重载与受控重启(Gemini 3.1 Pro从 13 题降至 5 题)。 - 动作接口失配(Action-interface mismatch):典型代表是
OpenCUA-32B的“零时长拖拽(zero-duration drag,33 题降至 28 题)”——模型吐出的dragTo缺少持续时间参数,导致桌面合成器把拖拽当成了瞬间移动而丢失选中态;以及模型偶发吐出computer.*命名空间而非pyautogui.*导致解析报错(3 题降至 0 题)。
- 工具—应用状态不同步(Tool–application state mismatch):Agent 调用后台 Python 脚本直接改了磁盘上的
6.2 同病不同药:为什么不存在一套通吃所有模型的万能补丁?
论文强调了一个核心发现:相同的失败症状,在不同能力的模型上需要完全不同硬度的干预粒度(Intervention Granularity)。
- 对
Qwen3-VL-8B这类小模型,仅仅在 Prompt 或反馈里温柔提醒“你刚才的动作没生效”是没有用的,它下一步照样重犯;因此优化器选出的机制是动作级强制拦截(Action-level enforcement)——直接拒绝重复动作并强制重启路由; - 对
Qwen3-VL-32B,最佳方案是強制门禁 + 应用感知代码路由(Application-aware code routing)+ 路由账本的组合; - 对
Gemini 3.1 Pro和GPT-5,模型自身的反思纠错能力很强,过度死板的硬拦截反而会束缚手脚,它们主要受益于干跑校验(Dry-run validation)、执行回执、Office 持久化同步和受约束的可行性探针(Feasibility probe); - 对
OpenCUA-32B/72B,由于模型被严格后训练在坐标动作空间上,强加复杂的外部代码工具它根本不会用,因此演化出的补丁高度贴合其原生接口,集中在拖拽时长归一化、API 映射和末步DONE信号保护。
6.3 Harness 演化的天花板在哪里?
看 Table 9 最右列“残余瓶颈(Residual Bottleneck)”,作者非常诚实地指出了纯靠外围 Harness 演化无法解决的硬伤:
早期的演化轮次之所以进展神速,是因为它们处理的是**带有明确运行时局部信号(Explicit Runtime Signals)**的失败——比如屏幕像素完全没变、API 抛出了语法异常、或者修改计数没清零就调了 done()。这些信号可以被确定性代码抓个正着。
然而,当这些显性漏洞被补齐后,剩下的失败越来越多地变成**“动作成功执行了、界面也按预期跳转了、文件也保存了,但模型一开始就选错了操作对象、走错了业务路径,或者改出来的文档语义跟题目要求对不上”**。在屏幕截图和执行日志看来,每一步都合法合规,没有任何局部异常信号能触发运行时护栏。这类错误触及了基座模型本身的视觉语义理解与规划上限,单靠外围 Harness 打补丁便会进入平台期。
7. 对 APP 自动化测试 / Mobile QA 的启发
将视角转回移动端自动化测试(Android / iOS / HarmonyOS / H5 / Hybrid App 的 UI 自动化与智能探索测试),GUI-HARVEST 的设计机制可以直接转化为四项高 ROI 的工程实践:
7.1 用“全屏 + 落点局部窗口()”升级移动端动作生效校验
在移动端 Appium / UIAutomator / XCUITest / Maestro 或视觉 Agent 执行中,“点下去了但没反应”是导致用例 Flaky 的头号杀手(例如点击时正处于转场动画、WebView 尚未 hydrate 完成、软键盘收起瞬间吃掉了点击事件,或点击的是勾选框/点赞心形图标等微小控件)。
很多团队做动作后校验(Post-action Verification)时,要么只看全屏图片相似度(SSIM),要么每次都去拉取整棵 Accessibility Tree(在复杂 Hybrid 页面动辄耗时 1~3 秒)。借鉴 GAFT 的做法:
- 在移动端执行引擎中,每次执行
tap(x, y)或longPress(x, y)前后,以毫秒级开销截取屏幕,同时计算全屏变化率 和以(x, y)为中心(例如200×200像素)的局部窗口变化率 ; - 当勾选协议复选框、切换底部 Tab 或聚焦输入框时, 往往小于 1%,但 会显著跳变;反之,如果 和 同时趋近于 0,无需调用大模型,运行时即可立即判定为无效点击(No-op Tap),触发等待重试或焦点恢复。
7.2 把 Flaky 重跑从“掩盖失败”改造成“同题成败对照诊断( Bundle)”
在移动 QA 的夜间回归流水线(Nightly CI)中,开启 retry=2 或 retry=3 是行业标配。但绝大多数测试平台的做法是:只要第 3 次跑过了,前两次的失败录像和日志就被标记为“Flaky 忽略”直接丢进冷宫;只有 3 次全挂才报红给研发。
GUI-HARVEST 的 Table 8 和 Figure 7 证明:恰恰是那些“3 次里过了 1 次、挂了 2 次”的翻转用例(Flip Cases),包含了最高价值的诊断信息!
- 3 次全挂的用例,没有现成的正确路径,排查Agent需要从头猜怎么过;
- 而发生 Flip 的用例,在同一台真机、同一个测试包版本下,已经同时给你提供了一条完整走通的黄金轨迹(Reference Run)和两条失败轨迹。
- 在测试平台建设中,应当专门构建 Flip 轨迹对比分析器:将同一次构建中先败后成的多次运行自动打包,对齐它们的步骤序列,定位“失败运行与成功运行在哪一步首次发生页面状态分叉(First Divergence Step)”,立刻就能区分出是权限弹窗/营销弹窗偶发拦截、接口弱网超时,还是 Agent 在某个分支页面选错了操作路径。
7.3 移动端同样普遍存在的 EDIT_NOT_COMMITTED 与“混合执行状态不同步”
论文揭示的两类跨基座高频缺陷,在移动端自动化测试中几乎每天都在发生:
- 移动端输入未提交就断言/跳转:在 Android
EditText、iOSUITextField或 H5 输入框中,Agent 调用input_text填入搜索词、收货地址或昵称后,屏幕上文字已经显示,但如果没有点击软键盘右下角的Search / Done / 完成键(IME Action),或者没有点击空白处收起键盘触发onBlur校验,直接点页面顶部的返回或下一步,App 往往不会保存刚才输入的值。在移动端 Agent Harness 中植入类似图 11b 的_uncommitted_edits状态机——跟踪input_text动作,强制要求后续必须伴随一次 IME 提交键、失焦点击或显式保存按钮才允许进入断言阶段——可以一举消灭大量“明明填了字却没生效”的假失败。 - Deeplink / 接口造数与前台 UI 缓存不同步(Tool–Application State Mismatch):在混合型移动测试 Agent 中,为了加速测试,我们常让 Agent 混合使用后台 API 造数/改配置(如调接口清空购物车、修改用户权益)与前台 GUI 操作。就像论文中脚本改了磁盘文件但 LibreOffice 窗口还停留在旧视图一样,移动端 App 前台页面往往持有内存缓存,后台接口改完数据后前台 UI 并不会自动刷新。Harness 必须在每次外部工具/API 调用后,强制织入确定性的状态同步动作(如下拉刷新 Pull-to-refresh、切换 Tab 重进、或通过 Deeplink 重新拉起目标 Activity/ViewController)。
7.4 测试脚本/Harness 自愈(Self-Healing)必须引入“事前行为预测门禁”
不少团队正在尝试让大模型自动修复挂掉的 UI 自动化脚本或 Agent 提示词。常见痛点是:模型改完脚本重跑一次通过了,合入主干后第二天却把别的用例搞挂了,或者只是因为重跑时弹窗恰好没出来而“蒙混过关”。
GUI-HARVEST 的 Behavioral Soft Gate 提供了一套准入规则:任何自动生成的 Harness 或测试脚本补丁,在合入前除了要保证回归集通过率不降(Utility Hard Gate),还必须先声明可检验的行为预测(例如“本次修改后,在第 4 步遇到实名认证弹窗时,应点击右上角关闭按钮而非直接退出”),并在重跑轨迹中由独立验证器核实该动作确实发生且生效,避免靠重跑运气晋升伪修复。
8. 专家点评:真正贡献、可能被高估的部分与可复现建议
站在 GUI Agent 与 Agent Harness 演化的领域视角,对这篇工作做三点审视:
8.1 真正贡献(What Actually Advances the Field)
- 串起了 GUI 领域“多模态观察—同题多轨迹对照—跨题模式归纳—有界代码修补—行为级核验”的完整流程:相比只在文本轨迹上打转的通用 Harness 优化器,以及只给一次性补丁的 LFF,GUI-HARVEST 第一次把视觉状态转移(GAFT 全屏+落点局部变化)和重复执行变异性( Flip 对照)变成了优化器的一等证据。
- 用“事前行为预测 + 独立行为验证器”抑制了离线演化中的伪改进:Table 3 的
Hard gate only消融很有说服力——没有行为软门禁,优化器会多晋升一轮补丁,但泛化到测试集反而倒退 3.82 个百分点。把“预测什么行为会变”写进冻结契约并在执行后验真,是对其他 Agent 自我改进框架也适用的做法。 - 跨六个基座模型与跨操作系统的实证:覆盖了 8B 到 72B 的开源模型和两大闭源旗舰,给出了 15 50 100 步预算外推与 OSWorld WindowsAgentArena 的零样本冻结迁移结果,实验设计的防泄漏控制(Search / Validation / Sealed Test 三集合隔离)比较规范。
8.2 可能被高估或需要注意的边界(What Might Be Overestimated)
- 离线优化阶段的真实总账单并未计入图 4 与图 9:论文在 Section G.10 中明确说明,图 4 和图 9 展示的 $34、$72、$125 仅包含最终冻结 Harness 在 361 个任务上跑一次评估的目标模型推理成本,不包括演化搜索阶段的虚拟机 rollout 成本和
Claude Sonnet 5优化器调用成本。可以算一笔账:在Qwen3-VL-32B的演化过程中,一共评估了 25 个候选补丁;每个候选补丁要在 Search(80 题)和 Validation(80 题)上各跑 次,即每次候选评估需要跑 条桌面轨迹(如果候选未晋升,Search 轨迹复用上一轮,但每个被测候选至少要跑新 rollout),25 次尝试累计涉及上万次桌面环境 rollout。这说明它是一套高投入产出比的“离线编译期优化方案”(一次离线演化,换来线上冻结部署的长期高准确率与低推理成本),但不能误以为优化过程本身是廉价的。 - 15 步搜索预算对超长周期任务的覆盖盲区:为了控制搜索阶段的 rollout 成本,所有演化都在 15 步上限下进行。虽然对
Gemini 3.1 Pro和GPT-5而言,15 步学到的补丁在 100 步下依然有效,但那些只有在第 30~80 步才会暴露的长程记忆退化、上下文污染与跨多应用状态丢失问题,在 15 步的搜索轨迹里来不及浮现。这也部分解释了为什么Qwen3-VL-32B从 15 步放宽到 100 步时几乎不再涨分(50.94% 51.79%)。 - 对基座模型代码生成能力的隐式依赖:从 Table 9 可以看出,无论是 Qwen、Gemini 还是 GPT-5,提分明显的核心手段之一都是 Code Routing(将繁琐的 GUI 点击路由给 Python/Bash 代码执行)。这要求运行环境开放本地代码/Shell 权限,且基座模型本身具备较强的代码编写能力;在纯黑盒、无 Shell 权限的封闭移动端 App 环境中,这一路线的收益会打折扣,更多要靠完成门禁、死循环恢复与接口归一化来提分。
8.3 可复现与可落地建议(What to Reproduce in Practice)
如果团队打算在自己的 GUI Agent 或移动端测试框架中借鉴 GUI-HARVEST,建议按以下优先级分步落地,而不必一开始就照搬全套 10 轮自动代码生成:
- 第一优先级(零大模型成本,见效快):复现 GAFT 的双尺度像素变化计算( + ) 与 图 11b 的单次
done()提交门禁(_uncommitted_edits+spent锁)。这两项属于确定性运行时基建,代码量不到 200 行,却能直接拦截大量无效点击和未保存提前终止。 - 第二优先级(改造测试/评测流水线):在回归评测中引入 任务打包与 Flip 轨迹分叉定位。把偶发通过与偶发失败的同题轨迹配对送给诊断模型,用附录 J 中 Evidence Analyst 的 JSON Schema 提取决定性分叉步。
- 第三优先级(构建受控的 Harness 自动演进流程):当积累了足够多的跨任务 Finding 后,再引入两阶段聚类与带
proposal.pre.json事前预测的补丁门禁,保留“独立验证集均值不降 + 事前行为预测被新轨迹支持”的双门禁准则。
9. 总结
GUI-HARVEST(arXiv:2610.00948)回答了一个具体问题:当多模态大模型的权重已经固定时,如何根据执行证据改进外围运行时 Harness?
它没有让大模型对着单条文本报错日志做泛泛的“自我反思”,而是针对 GUI 环境的两项特征——动作效果体现在像素变化上,以及执行过程经常出现随机分叉——做了专门设计。通过 GAFT 提取全屏与落点局部视觉事实、用 同任务重复运行构建内部成败对照、用两阶段聚类提炼跨任务共性模式,再用事前行为预测与效用硬门禁双重把关源码修改,这套方法让从 8B 开源模型到 GPT-5 / Gemini 3.1 Pro 的六个基座模型都在 OSWorld-Verified 与 WindowsAgentArena 上获得了实测提升。
对于正在构建 GUI Agent 或移动端 UI 自动化测试系统的团队来说,比起单纯等待下一代基座模型发布,先把运行时里的“无效点击、未提交就结束、前后台状态不同步、单次失败乱归因”用证据驱动的 Harness 机制管起来,往往是投入产出比更高的一步。
10. 参考链接
- 论文原文:GUI-HARVEST: Self-Improving GUI Agents through Evidence-Driven Harness Evolution (arXiv:2610.00948)
- 开源代码仓库:https://github.com/GaryYang12345/GUI-HARVEST
- 相关基准与前序工作:
- OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments (arXiv:2404.07972)
- Windows Agent Arena: Evaluating Multi-Modal OS Agents at Scale (ICML 2025)
- Scaling Agents for Computer Use / Agent S3 (arXiv:2510.02250)
- On the Reliability of Computer Use Agents (arXiv:2604.17849)
- Meta-Harness: End-to-End Optimization of Model Harnesses (arXiv:2603.28052)
- Self-Harness: Harnesses that Improve Themselves (arXiv:2606.09498)