EchoPath:GUI Agent 的记忆不是一段上下文,而是一条可重放的执行程序
拆解 EchoPath 如何把经过工件校验的 GUI 轨迹编译成带前置条件、参数绑定、视觉证据和生命周期治理的执行级记忆,并复核它在 OSWorld-Verified 上的重放收益与边界。
GUI Agent 有个成本特别容易被忽略:一件事做过一遍,下次还得从头看屏幕、重新规划、重新找控件。
企业里那些活——填表、导报表、搬文件夹、改桌面配置——大多不是一次性任务。每次让模型从第一张截图重新推理,成功率不一定差,但 token 和墙钟时间会随步骤数一起涨。涨出来的这部分,几乎全花在重复劳动上。
EchoPath 想算的就是这笔账:一次已经跑通、结果也被验证过的 GUI 执行,能不能变成下次直接拿来用的”执行级记忆”?
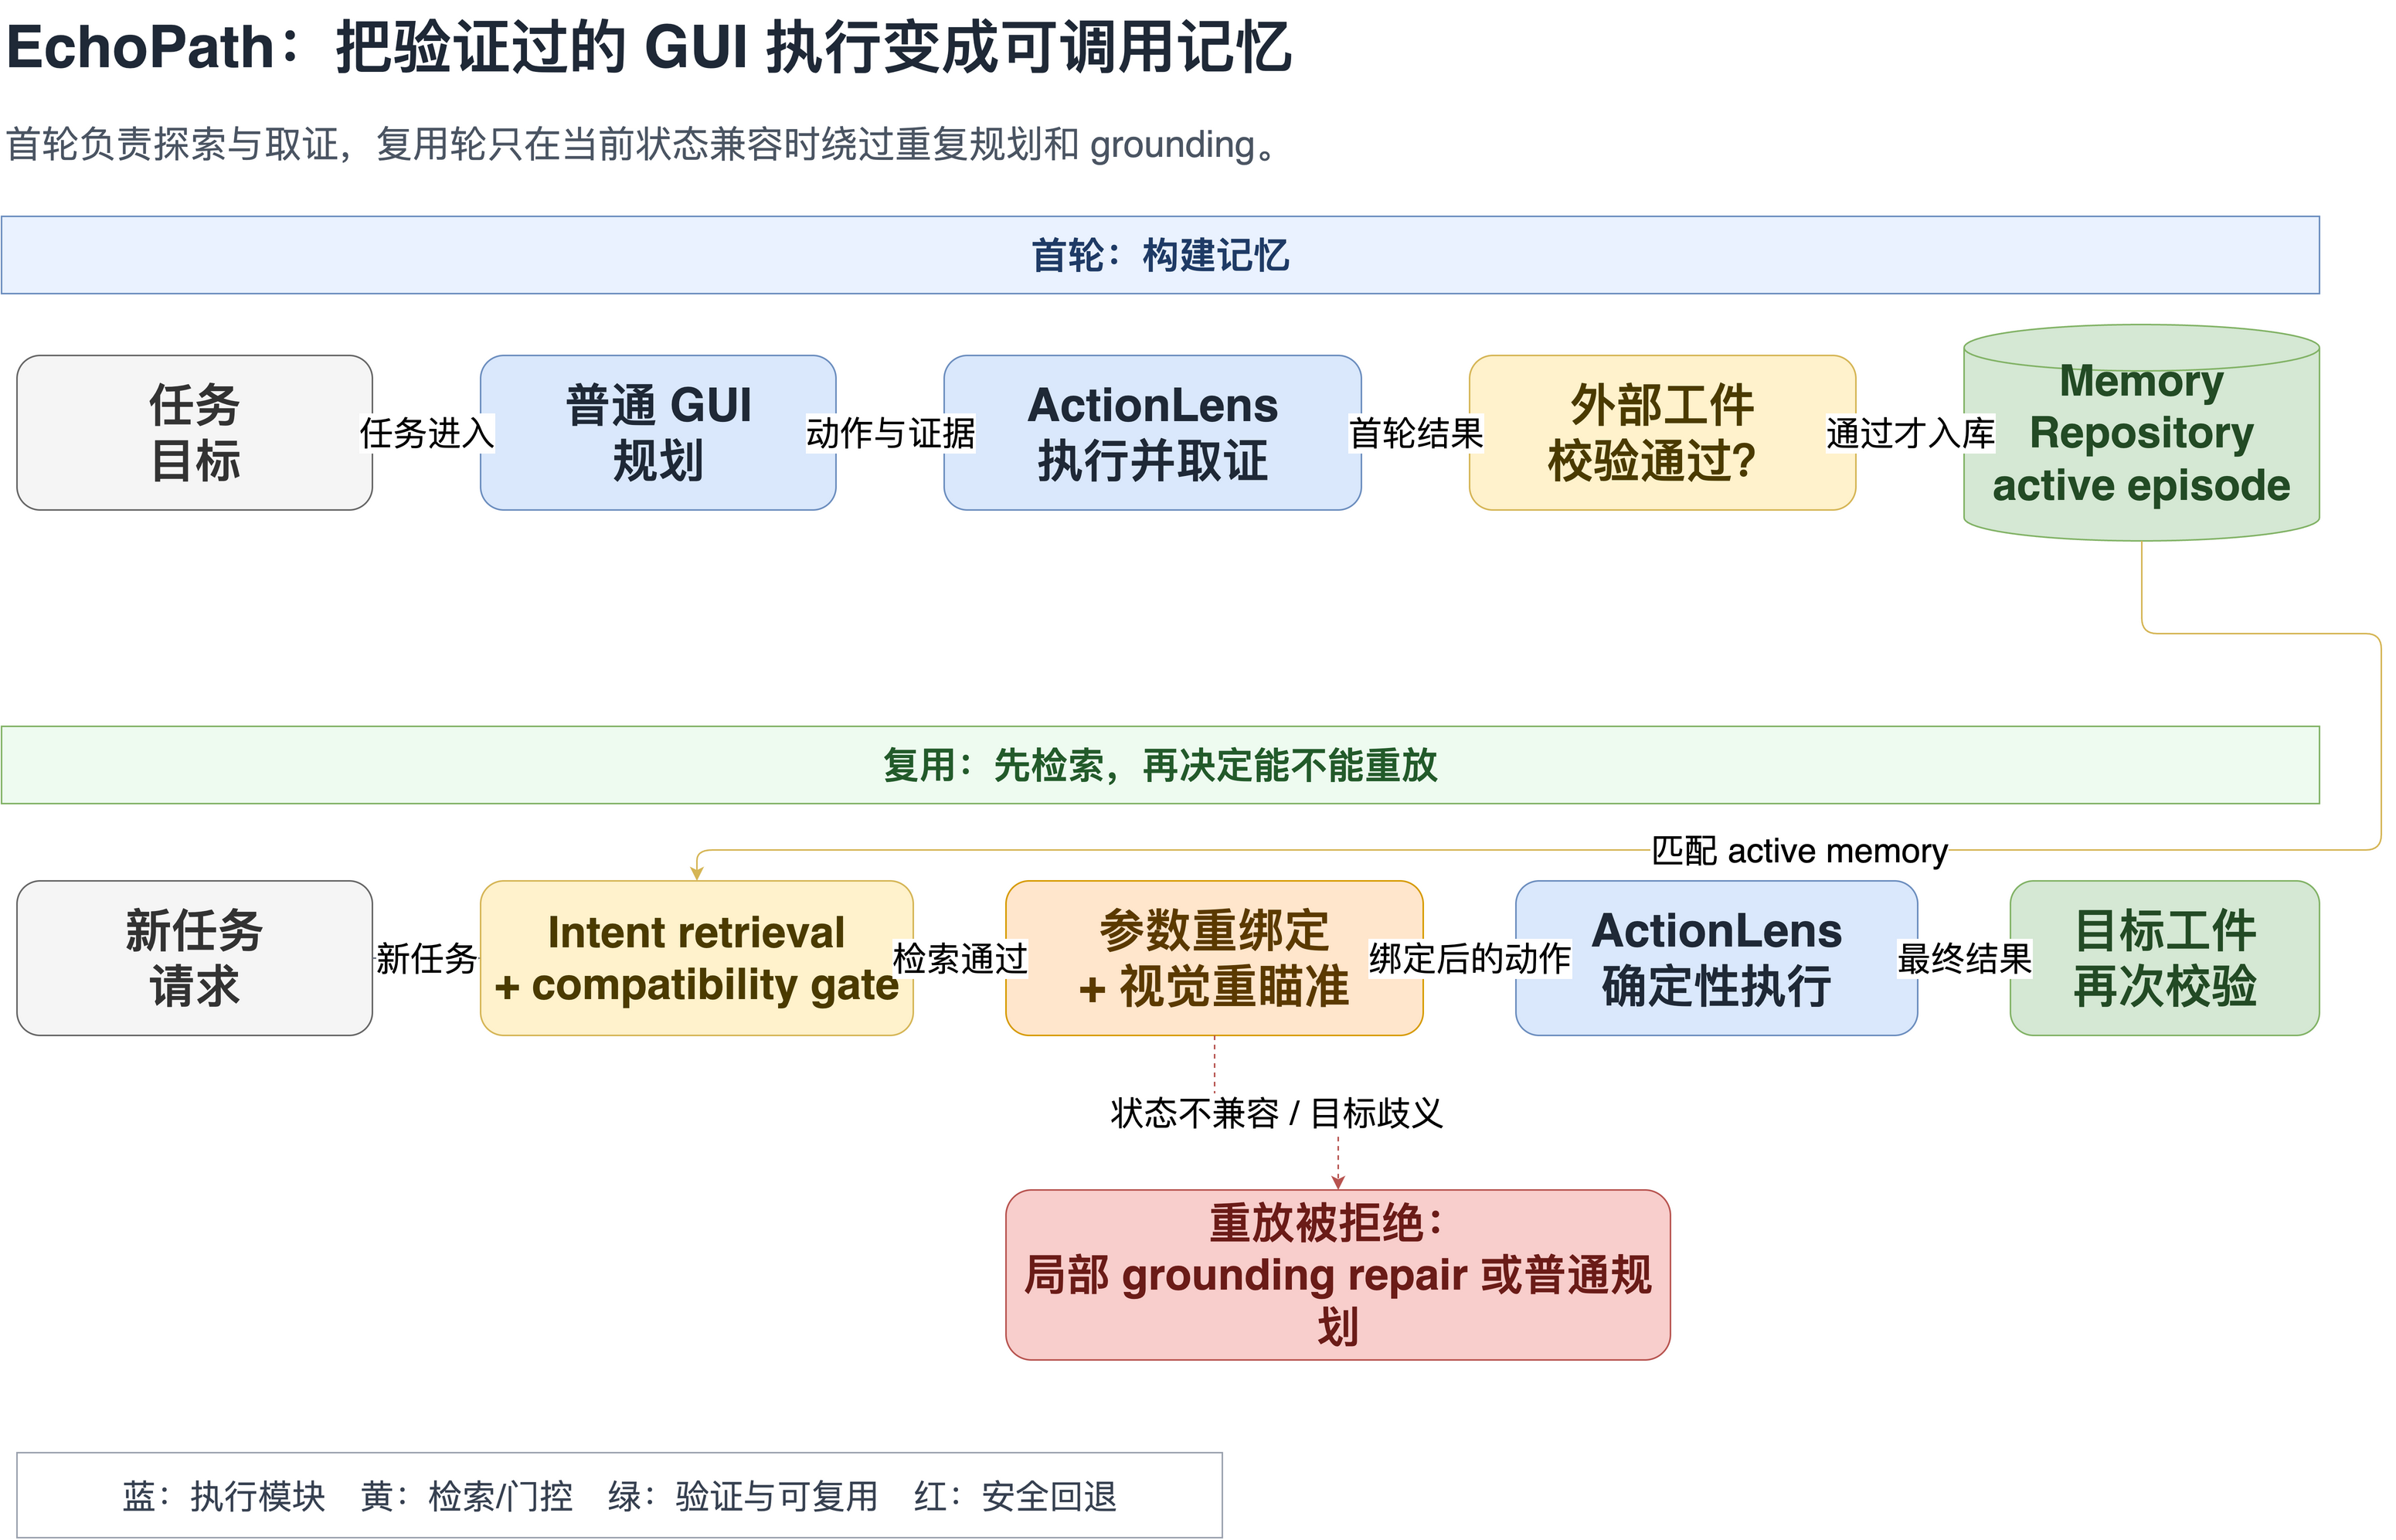
它没有选择”把旧轨迹塞回 prompt 让模型参考”。整条流程分四步:
- 把首轮探索整理成结构化记忆,记下任务意图、应用和状态前置条件、哪些输入可变、每一步的视觉证据、结果怎么验证的、这条记忆当前处于什么生命周期状态;
- 新任务来了先检索,判断是不是同一类事;
- 再做兼容性门控,判断当前桌面是不是这条路径的合法起点、目标能不能重新定位、需要变的输入是不是被允许变;
- 全过了,才跳过逐步规划和 grounding,直接重放。
任何一步不满足就拒绝重放,退回局部修复或者普通规划。拒绝是这里的正常出口,不是报错。
论文是 Yao Zhao、Aditya Shanmugham、Swastik Roy 和 Yanxun Xu 的 arXiv 预印本 arXiv:2609.16635,2026 年 9 月 15 日提交。下面按正文和补充材料拆。数字都按实验口径写,不做”所有 GUI 任务都能复用”这种延伸。
目录
- EchoPath 到底要解决什么
- 它把什么东西叫作记忆
- 第一次执行:ActionLens 先把运行过程变成证据
- 第二次执行:检索和门控先于重放
- IBTR / IMTR:坐标不是目标,只是视觉证据
- 生命周期:记忆不是写入后永久有效
- 实验结果:省下来的到底是什么
- 这篇论文证明了什么,没有证明什么
- 对 GUI Agent 和自动化测试的启发
- 总结
一、EchoPath 到底要解决什么
1.1 重复任务不该每一步都重新推理
一个典型的 GUI Agent loop 长这样:
observe → plan → ground → act → observe → plan → ground → act这里混着两种开销,性质完全不同:
- 规划开销:模型根据任务和当前状态,决定下一步干什么;
- grounding 开销:把”点击保存按钮”落成当前屏幕上的某个坐标或控件。
第一次做任务,这两步省不掉,模型必须看、必须想。可到了第二次,很多系统还是把它当新任务处理。有些方案加了记忆模块,看着像”记住历史”,实际是把旧轨迹、反思、工作流摘要取出来重新塞回上下文,让模型照着再规划一遍。模型确实少犯了点错,但这次规划一分钱没省。
EchoPath 把问题收窄了,问得更实在:一段已经成功走完的动作序列,在当前桌面状态下,能不能被安全地实例化?
这个问题能验证,也有明确的失败态。答不了就拒绝,不是含糊地”试着复用一下”。
1.2 三种复用方式,各自卡在哪
| 复用方式 | 下次怎么用 | 主要问题 |
|---|---|---|
| 轨迹放回 prompt | 让模型参考旧步骤重新计划 | 每一步的推理和 grounding 成本照付 |
| 原始 record-and-replay | 原样执行旧坐标或脚本 | 窗口一挪、分辨率一变、布局一漂,坐标就废了 |
| Accessibility Tree 绑定 | 依赖系统暴露的控件节点 | 第三方桌面应用、Canvas、残缺的可访问性树都是盲区 |
| EchoPath | 先判断状态是否兼容,再重绑输入和视觉目标 | 依然依赖相对稳定的界面和足够有区分度的视觉目标 |
论文引言里就是这么定位自己的:既不认”记忆只是一段上下文”,也不认”坐标脚本就是可复用程序”。它在这两者中间加了一层可以检查的执行边界。背景见 Introduction。
有个地方容易读岔。论文把这种记忆的接口形态类比成 MCP-style tool call,但这不代表它实现了 MCP 协议。准确说法是:它把记忆包装成了一个有输入、有前置条件、有结果的类工具对象,仅此而已。
二、它把什么东西叫作记忆
2.1 记忆单位是一条 episode,不是一段对话
论文把可重放记忆写成这样:
字段看着多,每个对上一个具体问题就不难懂:
| 字段 | 含义 | 重放时回答的问题 |
|---|---|---|
| 检索键和任务意图 | 这是不是同一类任务 | |
| 应用或环境标签 | 当前打开的是不是同一个应用 | |
| 状态前置条件和预期效果 | 当前桌面是不是这条路径的起点 | |
| 有序的动作程序 | 具体要执行哪些 GUI 原语 | |
| 每一步的截图、crop、坐标和状态证据 | 当前界面能不能重新绑定目标 | |
| 可变输入绑定 | 哪些字段允许换成这次任务的值 | |
| 外部工件校验证据 | 首轮结果是否真的成立 | |
| consolidation / reasoning 报告 | 这条路径为什么值得晋升 | |
| 生命周期状态 | 这条记忆现在是否还能被默认检索 |
这个对象真正有用的一点,是把原本糊成一块的三件事拆开了:
- 首次成功的轨迹,够不够格成为记忆;
- 新任务该不该检索这条记忆;
- 检索到了,当前 GUI 允不允许安全重放。
绝大多数”记忆失效”的案例,都是把这三个问题压缩成了一个相似度分数:越相似就越用,用挂了才发现状态早就不对了。EchoPath 让拒绝成为一条正常出口,这比相似度公式本身更有价值。
2.2 固定动作和可变输入必须分开
举个具体的。任务是”把一份新的 CSV 导入桌面应用”:文件名每次都不一样,但打开应用、进菜单、点导入入口、确认这几步,不该让模型随手改写。
所以 EchoPath 把动作分成两类:
- fixed action:导航、聚焦、热键、等待、保存、结构性操作;
- flexible action:输入框里的 URL、文件名、表单值、搜索文本。
重放时,只有记忆里明确声明过的 action_index 和 parameter_path 才允许替换值。没声明成可变的字段,哪怕模型觉得它应该变,也改不了。
这条限制看着保守,但恰恰是执行记忆能不能被审计的分界线。放宽一步,“复用旧流程”就退化成”让模型拿旧流程当灵感再写一遍新的”,前面的门控全白做。
三、第一次执行:ActionLens 先把运行过程变成证据
3.1 记忆的来源不是 agent 的私有日志
EchoPath 没把 host agent 的思维链或 SDK 事件流直接当记忆源。它把 GUI 操作包进一个叫 ActionLens 的 controller-compatible wrapper:底层本地或远程控制器的动作接口保留不动,但所有真正碰到桌面的动作都被统一记下来。
一次 action step 记的东西包括:
- 动作原语和参数;
- 动作前后的截图与观察;
- UTC 时间、耗时、执行器输出;
- 异常文本和错误状态;
- 逻辑屏幕尺寸、截图尺寸、鼠标位置;
- 截图区域,以及像素到 controller 坐标的换算比例。
补充材料还提到,运行会落盘 manifest、action-step JSONL、standalone-observation JSONL、lifecycle-event JSONL 和截图资产。这么设计的好处很实在:host agent 的内部日志格式以后怎么改,重放层手里始终有一份结构稳定的动作证据。
3.2 “点击成功”不等于”任务成功”
每个 GUI 原语都返回成功,不代表整条轨迹可以晋升成 active memory。首轮结果还得过一道外部 artifact evaluator。
拿”导出报表”举例,不能只看鼠标确实点过导出按钮,得去检查文件在不在、内容对不对、最终页面状态是不是预期的样子。
论文的晋升逻辑压成伪代码大致是:
执行轨迹
  ├─ 有动作失败 / 不支持的原语
  ├─ 没有正向 artifact validation
  ├─ consolidation 报告不可晋升
  └─ 仍有 blocker
       → 留在仓库中用于诊断或修复
       → 不暴露给默认 replay retrieval

外部工件通过 + 路径可行
       → candidate
       → active memory
这一刀把”程序跑完了”和”事情办成了”分开了。对桌面自动化来说,业务真正关心的是后者。
3.3 consolidation 不是简单截断轨迹
一次成功的探索通常很脏:试探性点击、被覆盖重输的输入、走过去又回来的移动、中途失败的动作。consolidator 的任务是从里挑出一条保持顺序的成功子序列,去掉探索和冗余,但保留那些为了进入状态必需的步骤,比如:
- 关掉首次启动提示;
- 处理登录或权限弹窗;
- 把被遮挡的菜单恢复出来;
- 等一个必须发生的状态转移;
- 拿到后续输入需要的焦点。
截图和视觉 crop 走 content-addressed blob 单独存,动作节点里只留引用、尺寸、坐标框和来源运行 ID。审计证据还在,多条记忆还能共享同一份视觉资产,同一张按钮截图不用存十遍。
四、第二次执行:检索和门控先于重放
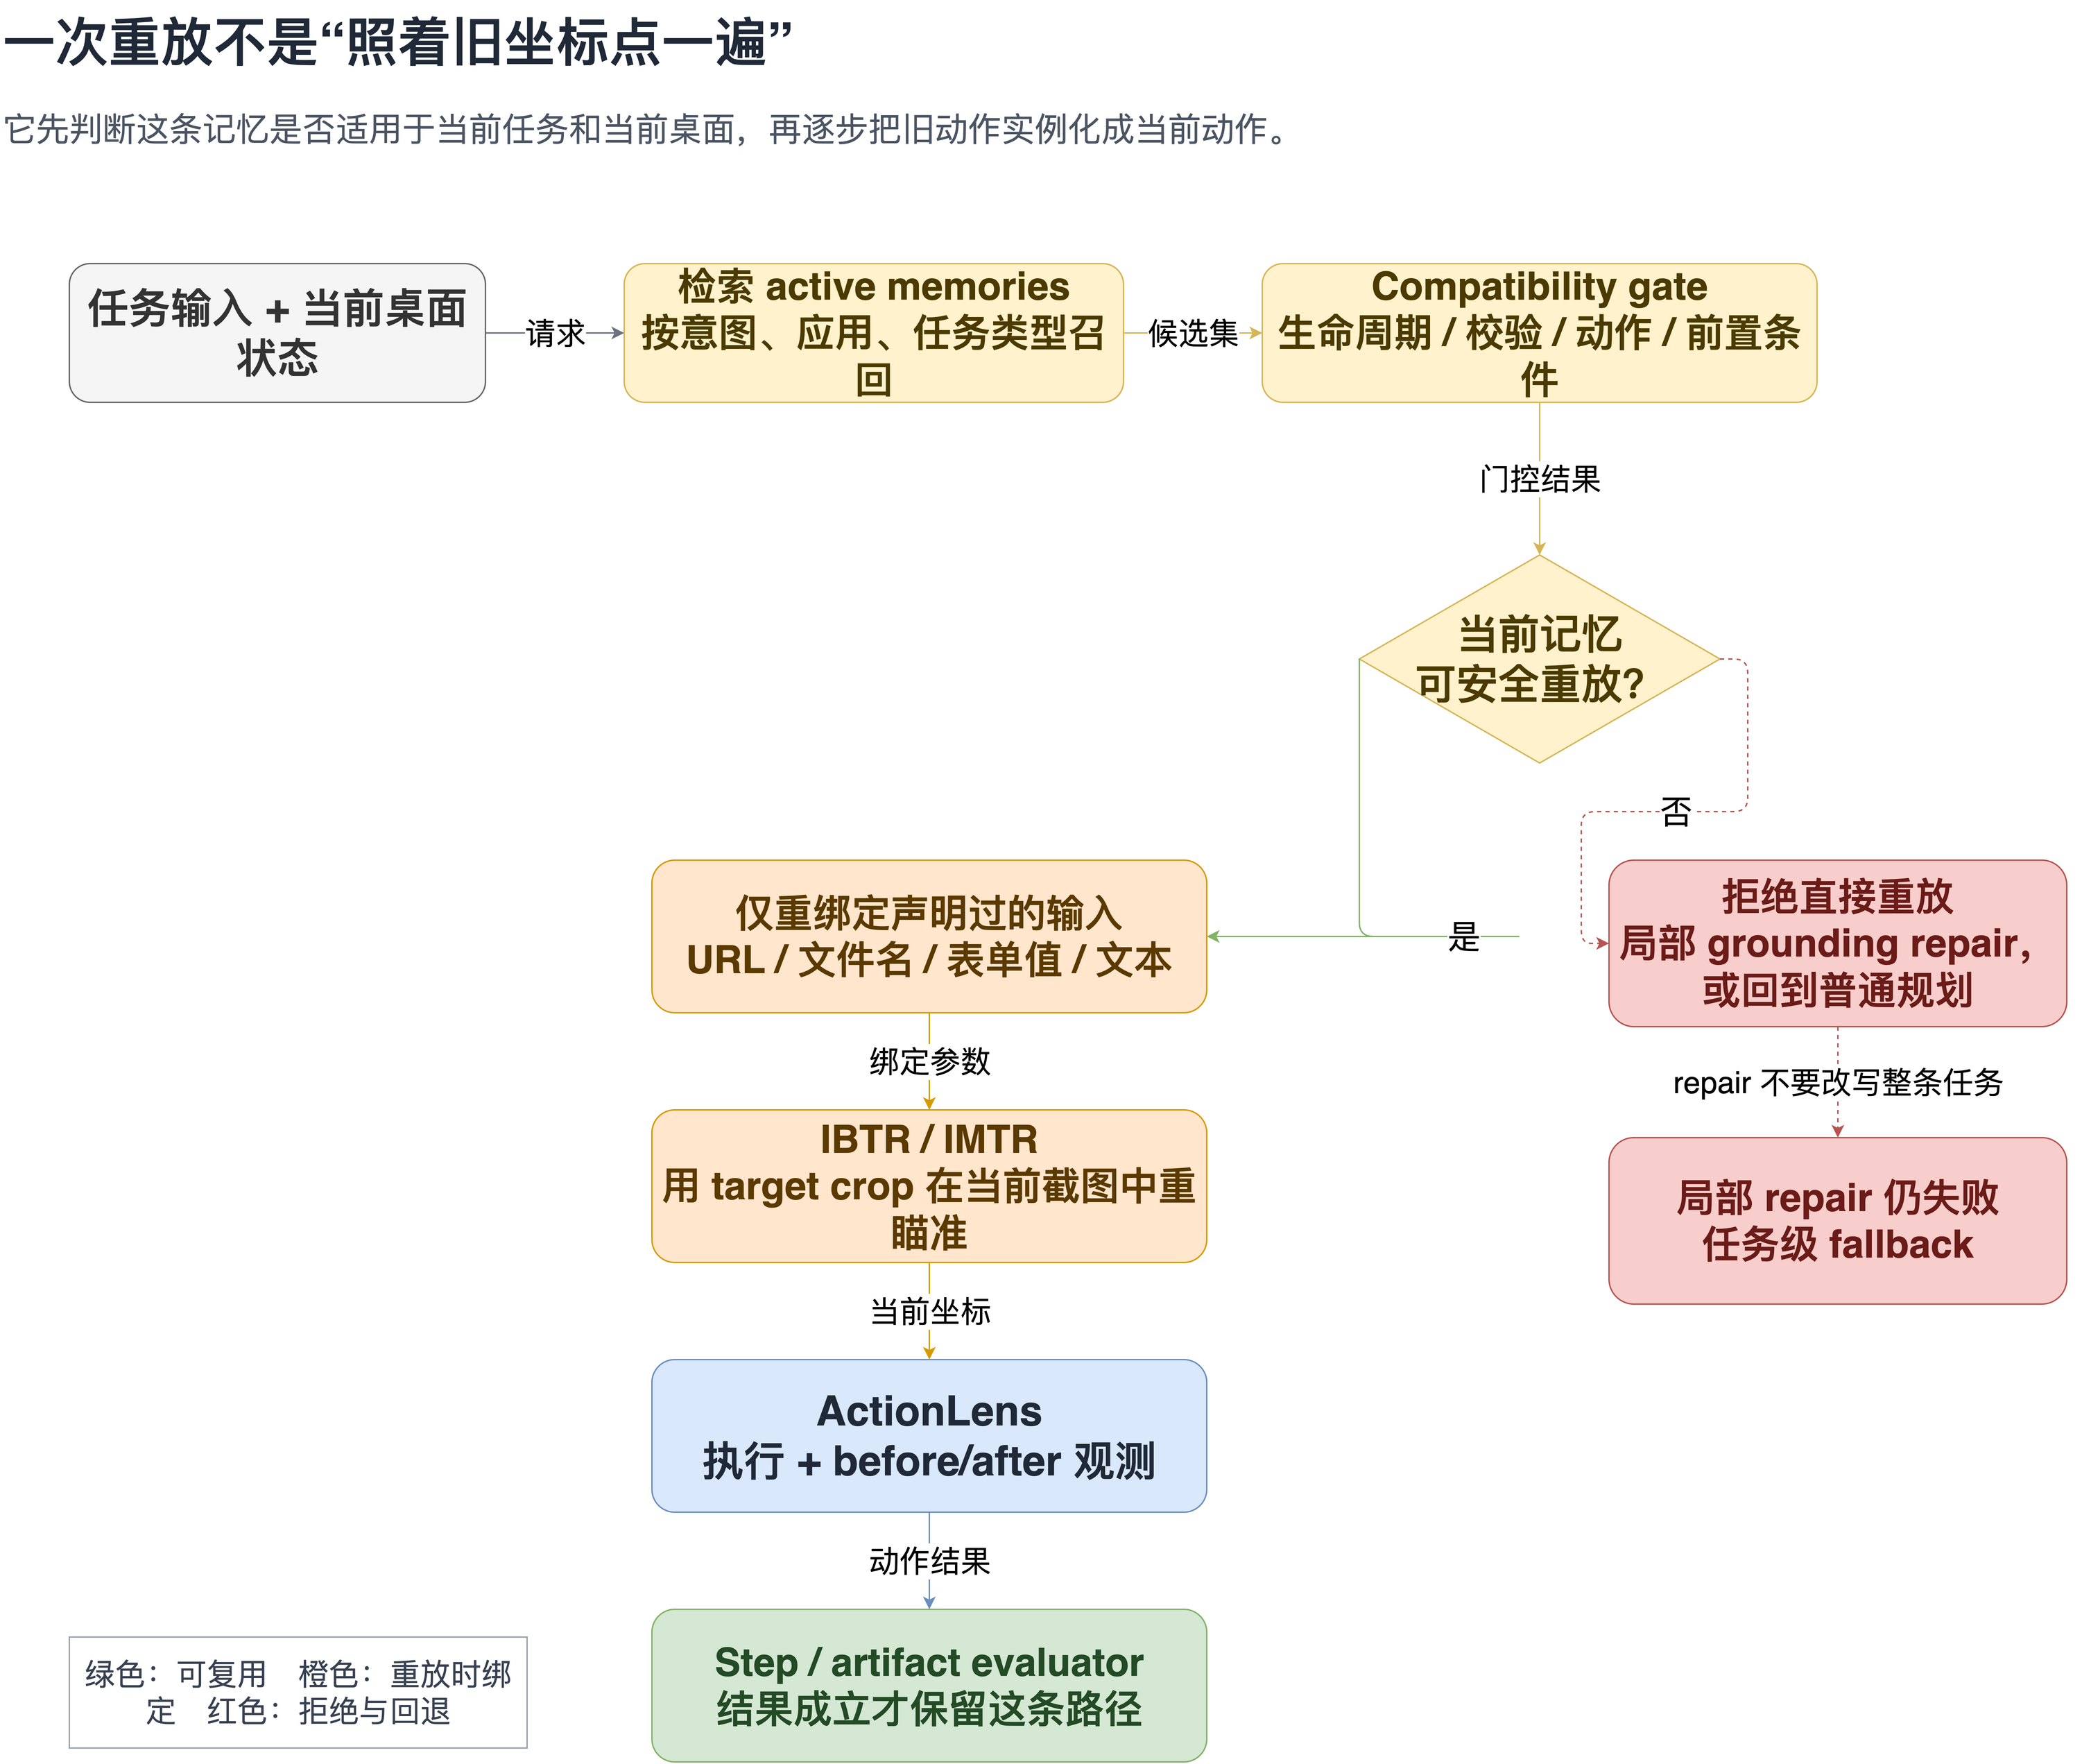
重放的顺序很关键。EchoPath 不是先甩出第一个点击再看会不会翻车,而是先把候选记忆筛到足够窄,再逐步绑定。
4.1 第一层:按任务意图检索
补充材料里的检索流程大致是:
- 对当前请求和记忆里的意图短语做大小写、空白和常见动词归一化;
- 去掉常见功能词,把 save/store、find/search、replace/overwrite 这类操作词归并到一起;
- 用任务目标、调用方给的意图短语、嵌套任务描述等字段拼出查询;
- 先用意图分数筛候选,再加载完整 path 和 action-node 记录做兼容性检查。
当前实现有两道阈值:第一阶段 intent 过滤用 ,最终兼容性分数用 。这两个数只是这版实现的选择,别当成什么环境都适用的通用超参数。
4.2 第二层:compatibility gate
过了检索的候选还要逐项过 gate:
- 生命周期必须是 active;
- 任务类型和应用上下文对得上;
- 首轮 artifact validation 为正;
- consolidation reasoning 认为这条路径可用;
- 动作原语都在 replay 支持范围内;
- 任务意图达到更严格的匹配条件。
应用标签的规则挺克制:一侧没有标签就放行;两侧都有,要求归一化后精确匹配。最终挑的是过了所有 gate、兼容性分数最高的那条;一条都没过,系统记一个 miss 或 rejection,然后走普通规划。
这就是 EchoPath 和”从历史里找最像的一条”的分水岭。相似只是入场券,安全是另一道关卡。
4.3 第三层:只绑定声明过的变化
重放时,路径上的导航、热键、等待、保存原样执行,只有 flexible_action_inputs 里声明过的字段能被替换。论文在 50 条 active memory 上做了离线测试:
- 合法的柔性文本替换:50/50 接受;
- 改固定字段这类非法操作:50/50 拒绝。
这不是为了让系统显得更聪明,而是让记忆的修改面看得见、能审计、能回归。
五、IBTR / IMTR:坐标不是目标,只是视觉证据
5.1 为什么不能直接缩放旧坐标
假设首轮在 1920×1080 的桌面上点了 (x, y)。第二轮屏幕换成 1600×900,按比例缩放坐标是个挺合理的 baseline,但它压根没回答几个更要紧的问题:
窗口挪了没有?工具栏重排了没有?页面里是不是插了个新控件?旧坐标附近有没有冒出两个长得差不多的按钮?
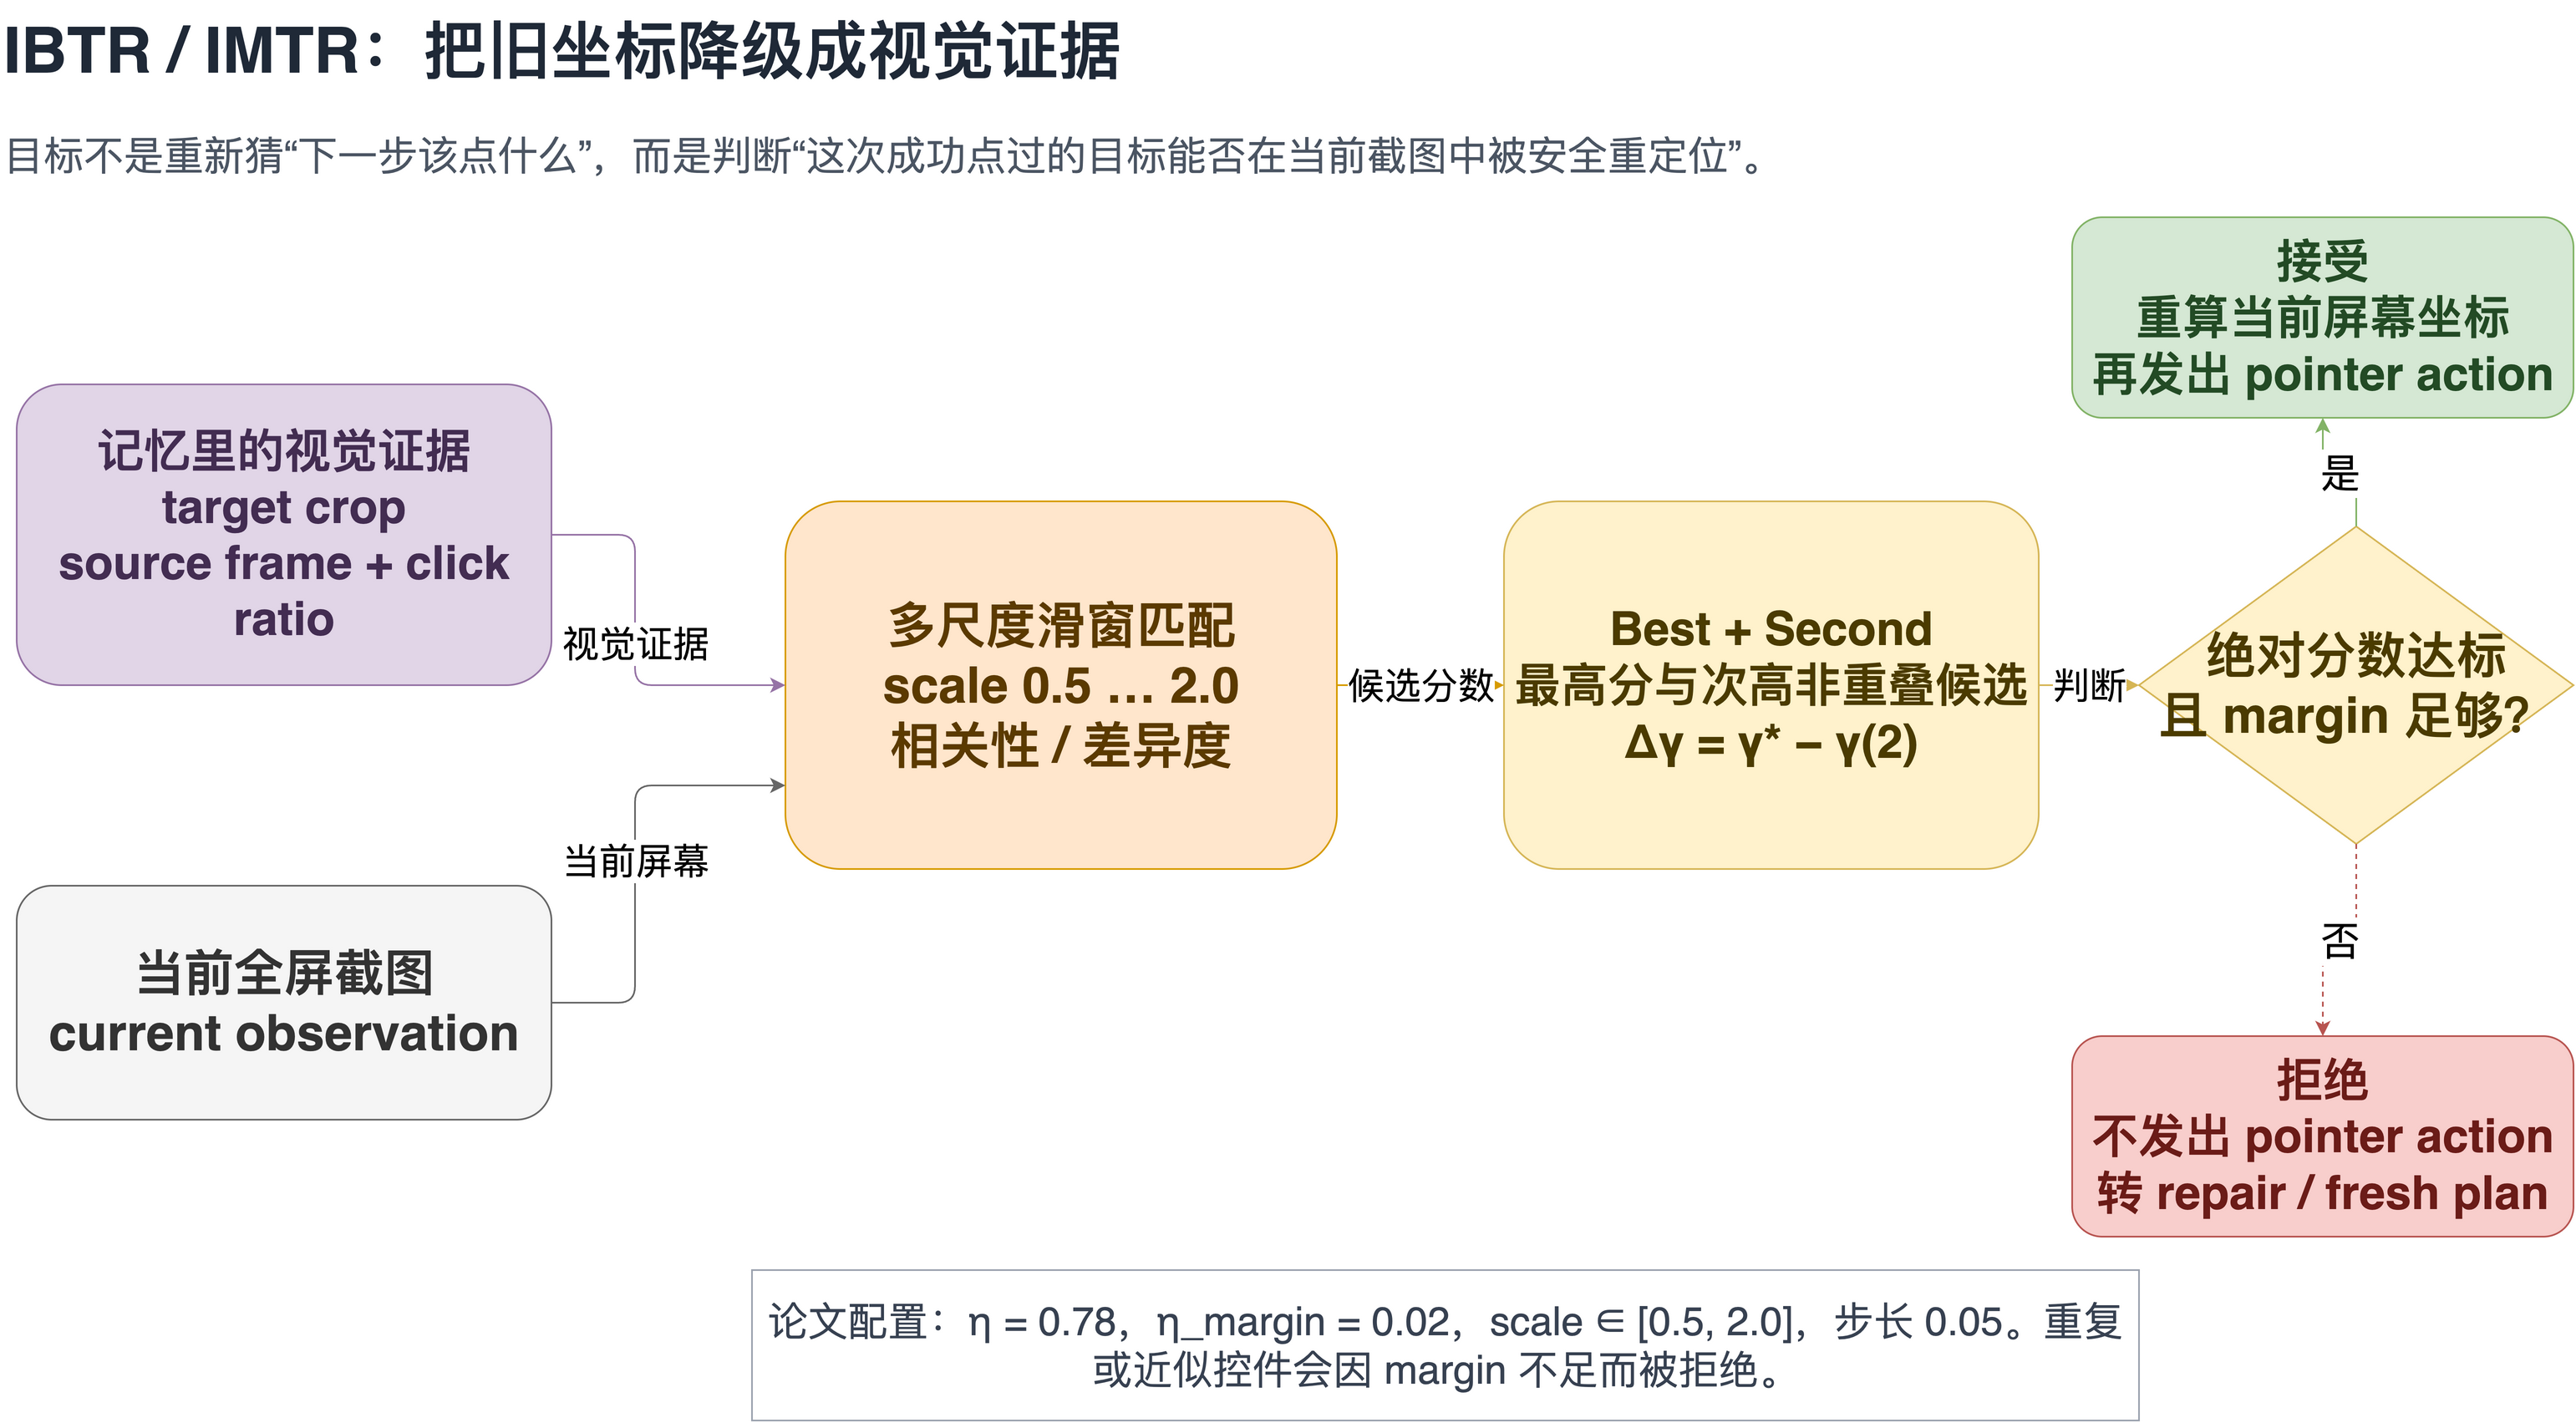
EchoPath 换个思路:旧坐标不是目标,它只是”去哪里截 target crop”的线索。记忆里存着 target、context、wide_context 几种 crop 候选,同时记录点击点在这块 crop 里的相对比例。重放时,拿这些 crop 去当前全屏截图里找匹配位置,再把相对点换算成新的 controller 坐标。
5.2 算法流程
补充材料里的算法可以拆成五步:
- 当前截图转成匹配表示,默认灰度;
- 每个存储 crop 按多个 scale 重采样,当前实现的范围是 0.5 到 2.0,步长 0.05;
- 在当前全屏截图上滑窗,算归一化相关性;如果 crop 本身太平坦,改用归一化平方差;
- 找到最高分候选 ,再找一个空间上不和它重叠的次高分候选 ;
- 绝对分数阈值和差值阈值都满足,才把点击点变换到当前 controller 坐标。
当前配置是:
其中 ,。任一条件不满足,系统会在发 pointer event 之前就把这一步拒掉。
这个拒绝条件是整套机制里最该抄的一处。GUI 里最危险的情况不是”完全找不到目标”,而是”找到了一个看起来也很像的目标”。重复列表项、相似图标、满屏一样的按钮,都足够让只挑最高分的算法点错。EchoPath 用 best-versus-second margin 把这种不确定性暴露出来:宁可回退,也不把低置信度坐标当成确定动作。
5.3 它不是通用视觉理解器
IBTR 的职责窄得有点过分:
- 不根据自然语言去找一个从没见过的目标;
- 不理解页面的业务语义;
- 不负责把失败的任务重新规划一遍;
- 只判断一个已经成功用过的视觉目标,当前还能不能被明确定位。
所以它和 grounding model 不在一个层次上。视觉重瞄准负责在已知路径上少调几次模型,新目标和回退路径仍然归 grounding model。
还有个命名细节要留意:正文和摘要写的是 IBTR(image-based target-reaiming),补充材料 B.3 和 Algorithm 1 的标题又写 IMTR(image-match target-reaiming)。本文用”IBTR / IMTR”并列标注,指的是同一个机制,不用替论文把这个术语不一致抹平。
六、生命周期:记忆不是写入后永久有效
EchoPath 的 memory repository 更像一个小型版本库,而不是只增不减的向量表。
candidate
   ↓ artifact + reasoning gate
active
   ├─ replay 成功:累计复用证据
   ├─ 状态变化:branch / repair
   ├─ 等价路径:merge
   ├─ 风险或失效:quarantine
   └─ 过时或不安全:deprecate
有几条工程含义值得单独说:
- 失败轨迹不会因为”有诊断价值”就自动变成可调用技能。 它可以留在仓库里,但默认检索只看 active 子集。
- 修复要留下 lineage。 新分支和旧路径之间能追溯,不该静默覆盖原记忆。
- 过期不等于物理删除。 deprecate 或 quarantine 之后审计线索还在,方便日后解释某条路径为什么不再被调用。
- 动作图和视觉资产分开存。 路径可以共享 action-node 前缀和 content-addressed 截图 blob,省存储,也保住了来源。
这里比”Token 降了多少”更值得借鉴:可执行记忆得有版本、有证据、有生命周期。否则它只是把旧的错误保存得更久而已。
七、实验结果:省下来的到底是什么
7.1 实验设计是 paired two-pass,不是随手抽样
主实验在 OSWorld-Verified 上用的是 paired two-pass:
- 第一轮:从新任务开始执行,形成候选轨迹并构建记忆;
- 第二轮:同一批任务再跑一遍,看记忆能不能被召回、过门控、完成参数绑定和视觉重瞄准。
为了防止”其实是在复制原坐标”,第一轮用 1920×1080,第二轮换成 1600×900。论文把这次变化当作反坐标复制的实验条件,但这不意味着真实生产环境只会发生分辨率变化这一种漂移。
主分析池里有 159 条 active executable memory。首轮任务长度在 2–29 个 GUI action 之间,多数是 4–13 步;首轮 median token cost 约 572k,median execution time 约 4.5 分钟;consolidation 去掉了大约 30% 的探索步骤。
7.2 和 trajectory-prompt baseline 比
论文表 1 的第二轮结果:
| 方法 / 客户端 | 成功率 | median tokens | median time |
|---|---|---|---|
| Codex + EchoPath | 91.2% | 20,370 | 127.5 秒 |
| Claude Code + EchoPath | 92.8% | 30,503 | 139.3 秒 |
| Kimi Code + EchoPath | 87.3% | 19,928 | 130.5 秒 |
| Synapse + Codex | 91.8% | 586,386 | 315.7 秒 |
拿 Codex 那行和 Synapse baseline 的中位数粗算:
- token 少了约 96.5%;
- 执行时间少了约 59.6%;
- 成功率低 0.6 个百分点。
摘要里”median token cost 降低超过 90%、median execution time 约降 60%“就是从这来的。但更准确的说法是:在这批已经建好、已经匹配上、状态也兼容的重复任务上,EchoPath 用确定性执行替掉了大部分重复调用,成功率基本持平。它没有在一个全新任务集合上让模型凭空变强。
7.3 组件诊断比总成功率更能说明问题
论文还做了几组离线或半离线诊断:
| 组件 | 条件 | 结果 |
|---|---|---|
| Retrieval | 记忆库从 159 增加到 659 条,加入非目标轨迹干扰 | 正确召回率始终 100% |
| Retrieval | 上述库规模变化 | median lookup 208.9ms → 573.8ms |
| Target reaiming | 原始截图,200 个 pointer cases | 接受 95.5%,接受样本偏差 0 像素 |
| Target reaiming | 随机缩放,200 个 cases | 接受 95.0%,94.0% 在 2 像素内 |
| State gate | 兼容起点 | 接受准确率 98% |
| State gate | 已经过可选准备步骤的部分变化起点 | 接受准确率 92% |
| State gate | 不兼容应用起点 | 拒绝准确率 78% |
| Flexible rebinding | 合法柔性输入 / 非法固定字段修改 | 100% / 100% |
这些数字讲了两件不同的事。
第一,目标重瞄准在受控的视觉诊断里确实准,但碰到重复控件和近似控件它照样会拒。拒绝不是实验失败后的补丁,是算法设计的一部分。
第二,state gate 认”兼容起点”明显比拒”不兼容起点”强。78% 的不兼容拒绝准确率说明,单靠一个视觉 probe 去兜通用桌面控件还不够;要是把 gate 当成绝对的安全证明,风险就被盖住了。
八、这篇论文证明了什么,没有证明什么
8.1 确实证明了三件事
一、GUI 记忆可以落到执行层。 记忆不必只当 prompt 上下文,在任务、状态、输入和验证证据都明确的前提下,它可以是一条能实例化的 action program。
二、坐标重放能被视觉证据约束住。 旧坐标不需要被完全信任,也不需要每次都丢给大模型重新定位。target crop、scale search、best-versus-second margin 和屏幕坐标变换合起来,就是一个确定性的中间层。
三、拒绝和回退本来就该是正常分支。 状态不兼容、固定字段冲突、动作不支持、目标有歧义,都可以在发出危险动作前拦住。
8.2 还没证明的四件事
对广泛 UI 漂移是否稳健,没证。 论文自己把适用环境限定在应用版本、窗口系统、浏览器 profile、字体、主题和软件配置相对稳定的场景。工具栏重排、本地化、响应式布局、显示缩放、近重复控件,都会影响视觉重瞄准。
企业规模的长期治理成本,没证。 检索压力、局部存储和生命周期结构都做过诊断,但没展示长时间运行、多人并发写入、隐私隔离、组织级回收这些情况。
记忆获取变便宜这件事,没做到。 第一轮照样得让 agent 从任务说明开始完整探索,里面可能有失败动作和冗余尝试。论文把交互式示范、用户引导录制和增量 consolidation 列为后续方向。
“代码可以直接复现”,也没证。 论文正文写的是”OpenPath package is provided at”,给了 github.com/JackZhao1998/EchoPath;我在 2026-09-21 发布前检查该地址,返回 404。所以本文没把它当成可用源码或复现入口。顺便记一笔,论文里 OpenPath / EchoPath 这个名字也不统一。
九、对 GUI Agent 和自动化测试的启发
9.1 把记忆写入当成一次发布,而不是一次缓存
要往自己的 agent runtime 里搬 EchoPath 的思路,最该照搬的不是某个相似度公式,是写入门槛:
raw trajectory
  → normalized action evidence
  → external outcome validation
  → consolidation
  → active / quarantine / deprecated
这条链会让 memory write 变慢,换来的是”任何成功调用过的工具都自动变成技能”这种事不会发生。对 GUI 来说,动作原语执行成功只是个局部事实,工件最终状态才是任务事实。
9.2 让 replay 和 repair 共用一套动作边界
ActionLens 的工程价值在于:首次规划、重放、局部 grounding repair、最终校验,全都走同一个 controller-compatible action boundary。好处是这些东西能用一套格式记下来:
- 计划动作和真正执行的动作;
- before / after 截图;
- 目标坐标和坐标变换;
- 失败类型、耗时、执行器输出。
要是 replay 一套接口、repair 另一套接口,出了问题根本分不清是记忆错了、grounding 错了,还是底层控制器抽风。
9.3 测试框架可以直接抄 fixed / flexible 的分法
APP 或桌面自动化里,同一个测试流程往往一半是固定导航,一半是随 case 变的测试数据。所有参数都交给模型,回放就变成一次不可控的重新规划;所有参数都锁死,又没法复用。
比较稳的拆法是:
- 固定:进页面、关弹窗、选菜单、提交、保存;
- 可变:账号、文件名、搜索词、表单值、日期、URL。
然后在测试报告里写清楚”这次替换了哪些参数”,而不是只写整条脚本跑没跑通。参数边界本身就是一份可审计的测试资产。
9.4 失败要分”局部能修”和”任务已经不适用”
EchoPath 把失败拆成两层:
- 局部 grounding failure:任务和路径都还合理,只是当前这个目标没被确定地绑上;
- 结构性 failure:应用、起点、固定参数、动作能力或后置状态已经对不上了。
前者可以给一个受限的 repair operator,后者必须回普通规划。这个区分对自动化测试一样有用:按钮位置漂了,和被测流程改版了,根本不该进同一个重试队列。
十、总结
EchoPath 的核心可以压成三句话:
- 写入端:只有通过外部工件校验的 GUI 轨迹,才有机会成为 active memory;
- 读取端:先检索、先做状态兼容性门控,再做声明过的参数重绑定和视觉重瞄准;
- 执行端:确定性重放一旦失败,拒绝发出不确定动作,转去局部修复或普通规划。
这条路线不是想让 GUI Agent 永远不用思考。它要解决的是把”什么时候可以不思考”变成一个运行时判断:有证据、有边界、能被拒绝。论文目前最有说服力的结果,是在受控重复任务上用差不多的完成率换来了更少的模型调用和更短的执行时间;最需要继续验证的,是界面漂移、长期记忆治理、隐私和首次采集成本。
如果一定要给 agent memory 一个更准确的说法,EchoPath 给的版本是:经验只有在被校验过、被参数化、被门控住,并且能安全落到当前界面时,才配叫可执行记忆。