ARTEMIS 源码深度拆解:Android Agent 如何同时做到单步秒级响应与 99%+ 准确率
基于 google/artemis 最新源码,从宏观双引擎架构到七项底层创新,全面拆解端侧无障碍原子快照、五步 UI 树几何净化、三级渐进定位、Safety Net 200px 坐标自愈、四区 KV Cache 稳定账本与零模型死循环检测。
做真机 Android GUI Agent 时,“快”和“准”往往是一对死敌。
想让执行变快,最直接的做法是砍掉规划、校验和复盘,只留一个多模态模型看图下发点击;但真机界面充满异步加载、滚动惯性、底部导航栏遮挡、自动消失的 Toast 以及没有无障碍节点的 Canvas/Flutter 自绘控件,一旦点偏一步,后面十几步就会在错误页面上越走越远。反过来,想让准确率变高,如果在每一步前后都拉起独立的 Planner、Grounding、Validator、Repair 和 Verifier 多轮对话,单步耗时动辄膨胀到三四十秒,跑到第 50 步时上下文还会被历史截图和冗长的 XML 树撑爆。
Google 开源的 ARTEMIS 在 Google Research 的 AndroidWorld 基准(覆盖 20+ 款真实应用、116 个动态多步任务)上报告了 99.1%(99%+)的任务完成率,同时在常规任务上保持 3–5 秒/步 的反应速度,并支持 10 小时以上、100+ 步 的长程探索不崩。
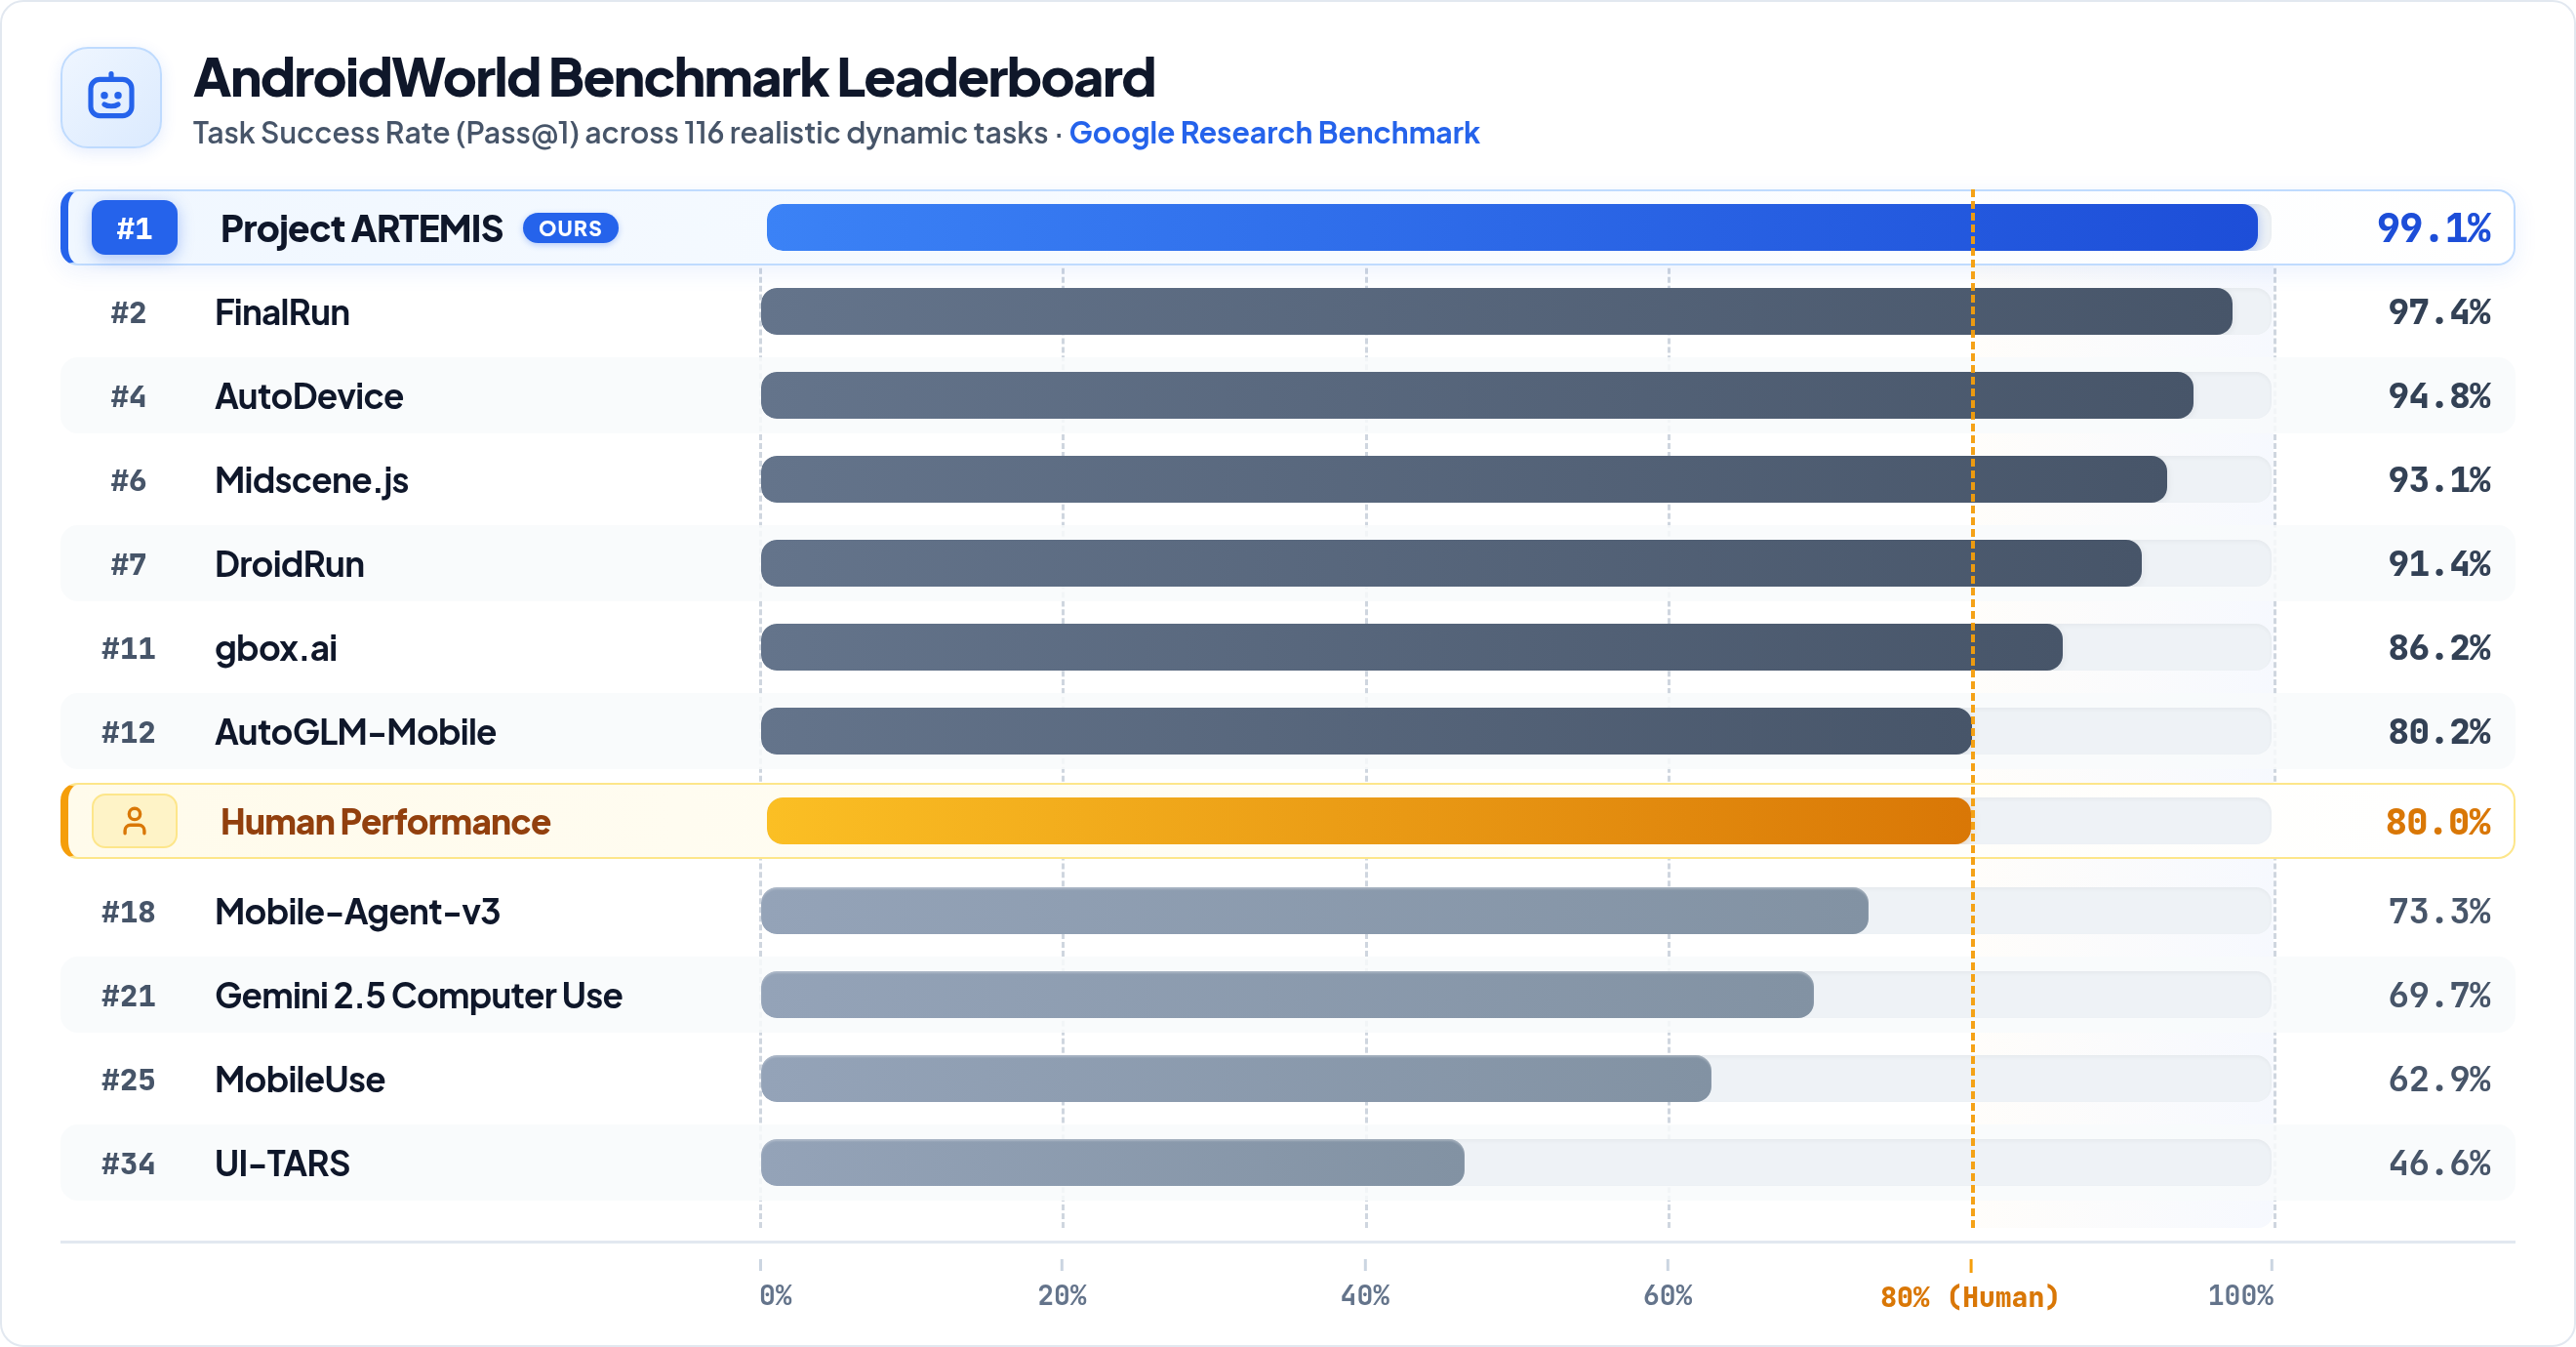

docs/assets/androidworld_leaderboard.png。注:仓库当前主要开源了完整运行时代码,未内置 AndroidWorld 评测脚本与原始跑分轨迹,因此本文将 99.1% 作为项目方报告的背景指标,重点从源码实证它如何解决真机执行的延迟与误点问题。拉取 google/artemis 最新源码(本文基于 main@351ca84 提交,核查时间 2026 年 10 月 29 日)通读后会发现,ARTEMIS 的核心思路不是靠某一个更大的多模态模型硬扛,而是遵循了一条非常清晰的工程准则:凡是能用确定性几何算法、本地哈希和规则在亚毫秒内解决的,绝不调大模型;凡是必须调模型的地方,尽量用前缀缓存、后台异步和局部轻量模型移出热路径;凡是动作真正落到屏幕前的最后一刻,必须用实时证据兜底。
下面先从宏观架构看一次任务是如何从入口流转到真机的,再逐一拆解源码里让它“既快又准”的七个关键设计。
1. 宏观全景:从统一调度入口到双轨引擎与三大支柱
先看官方仓库给出的系统架构总览图与 Web 控制台界面:
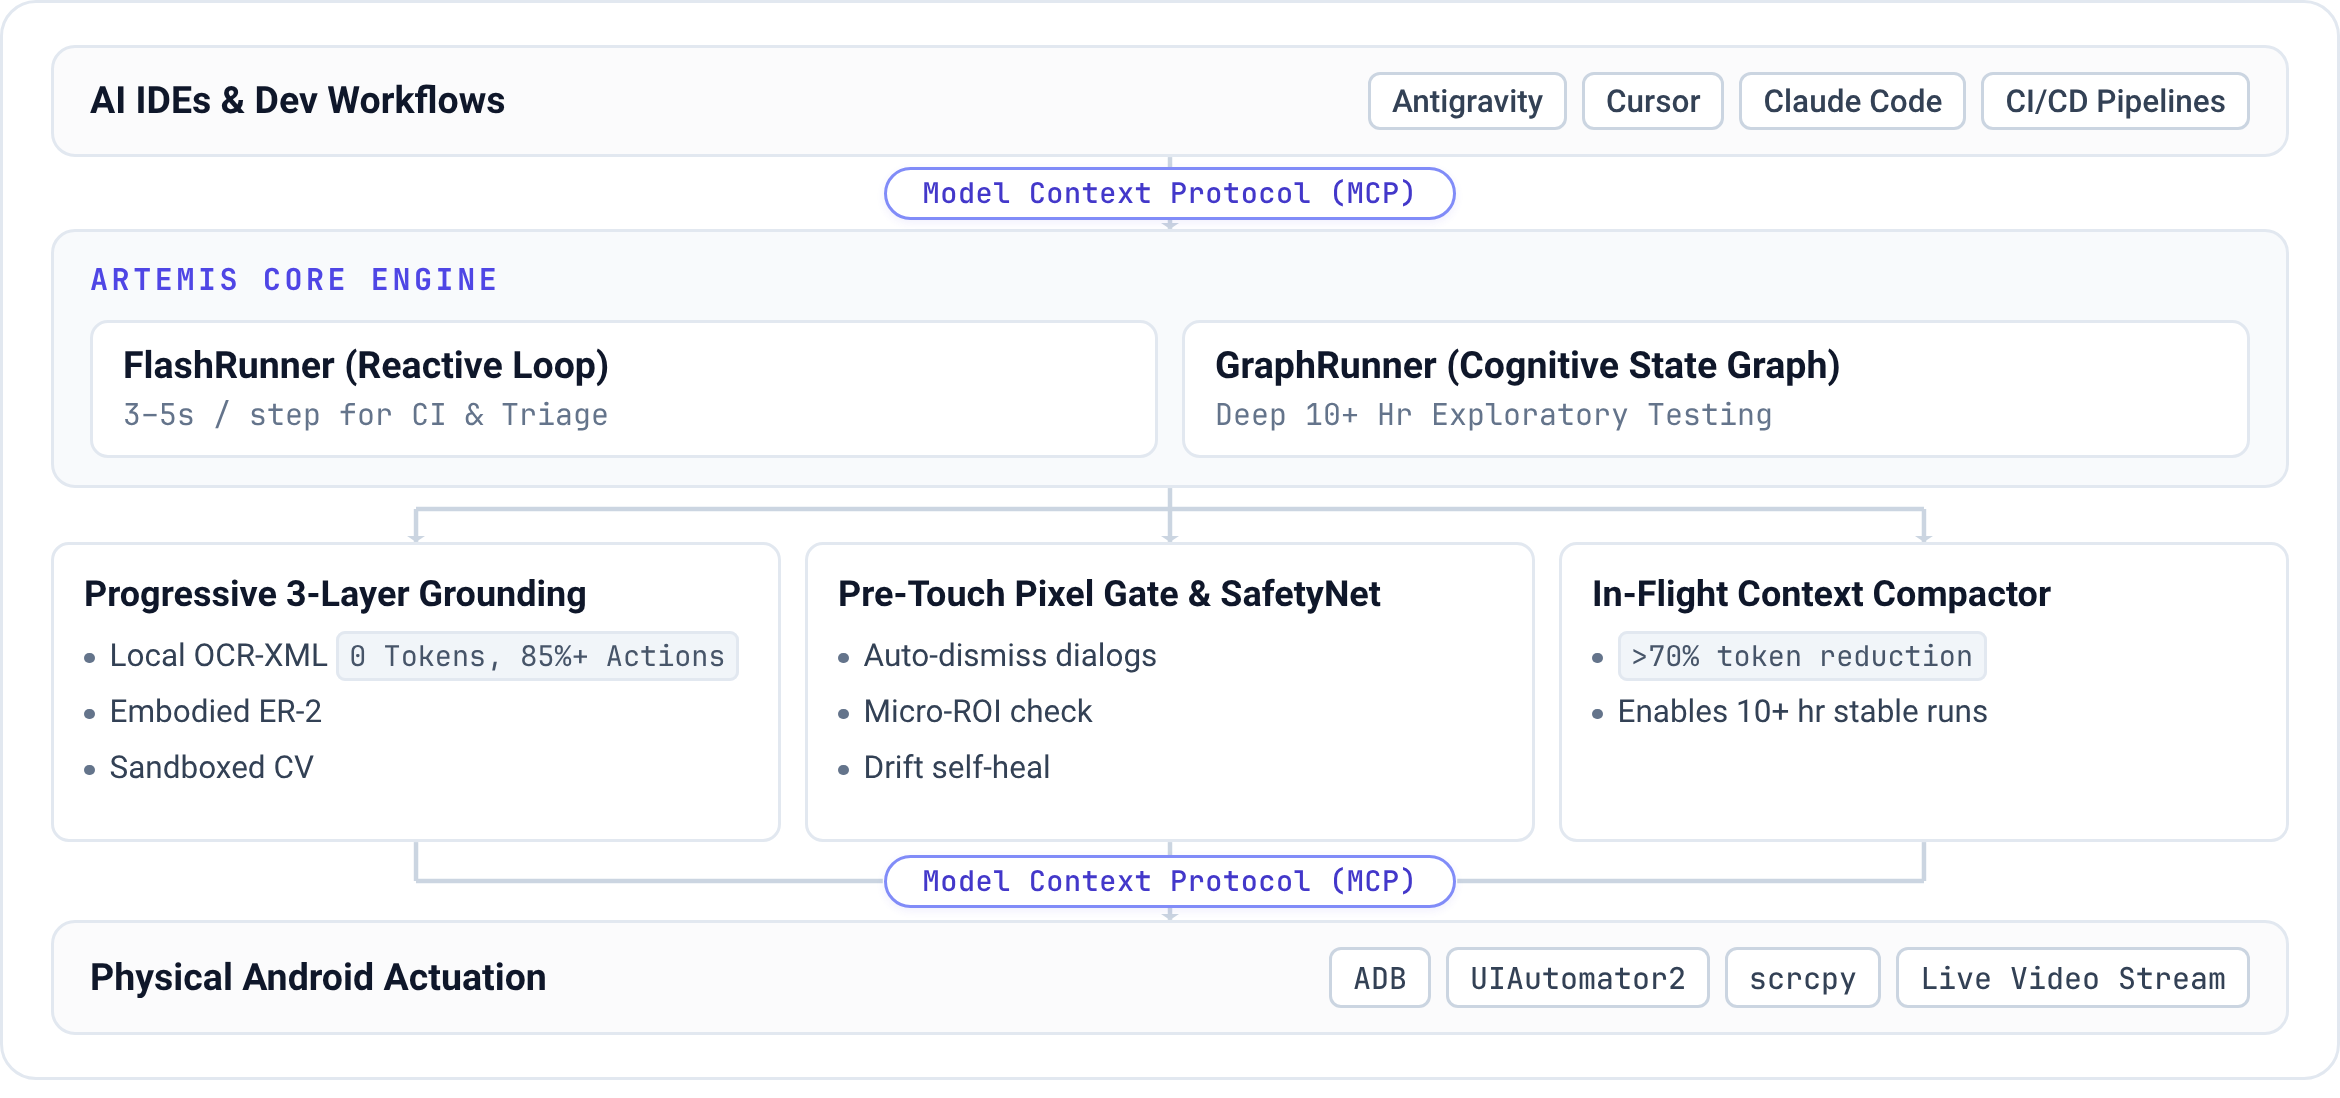

docs/assets/artemis_architecture_diagram.png。核心引擎由双运行模式(FlashRunner / GraphRunner)和底层的三大能力支柱(Progressive 3-Layer Grounding、Pre-Touch Pixel Gate & SafetyNet、In-Flight Context Compactor)组成。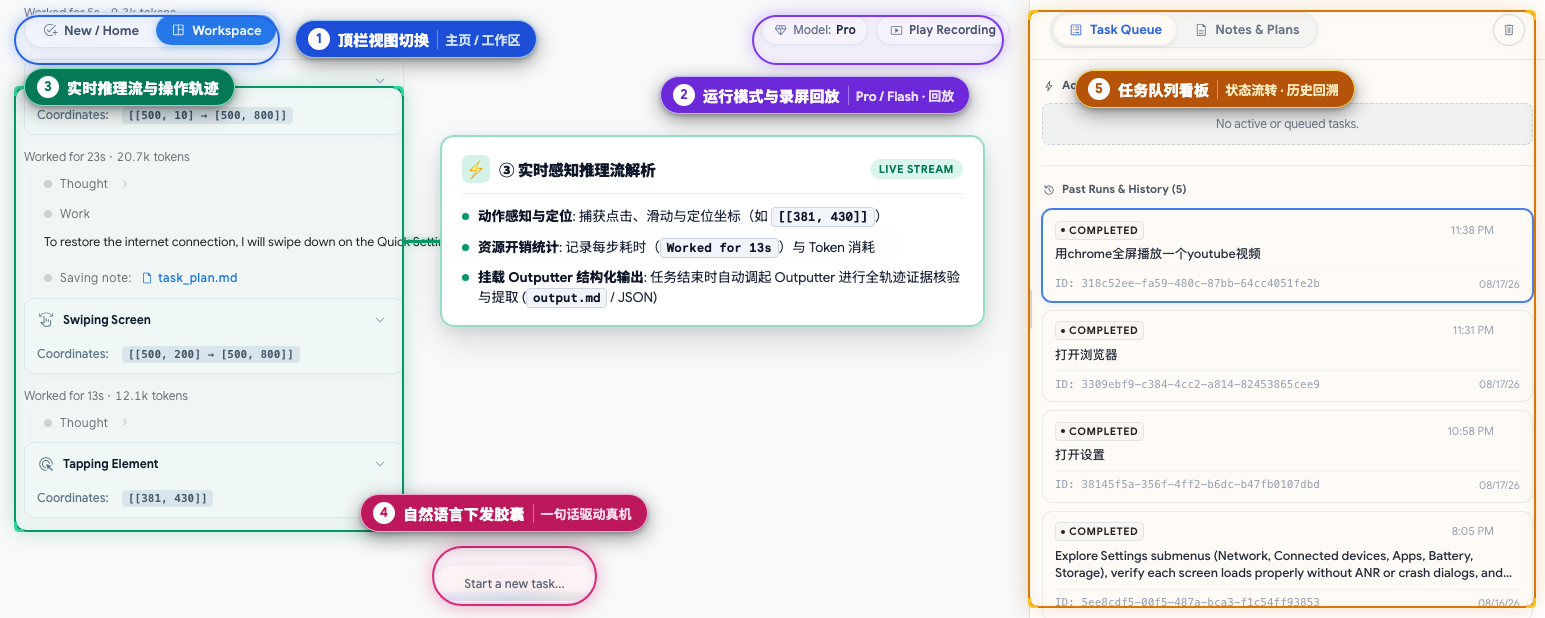
uv run artemis ui)。来源:
docs/assets/artemis-ui-showcase.png。如果顺着代码追踪一条自然语言指令(无论来自 CLI artemis run、Web 控制台、Python SDK 还是 Claude Code / Antigravity 的 MCP 工具 mobile_run_task),它在系统内部的真实流转链路可以用下面这张机制图概括:
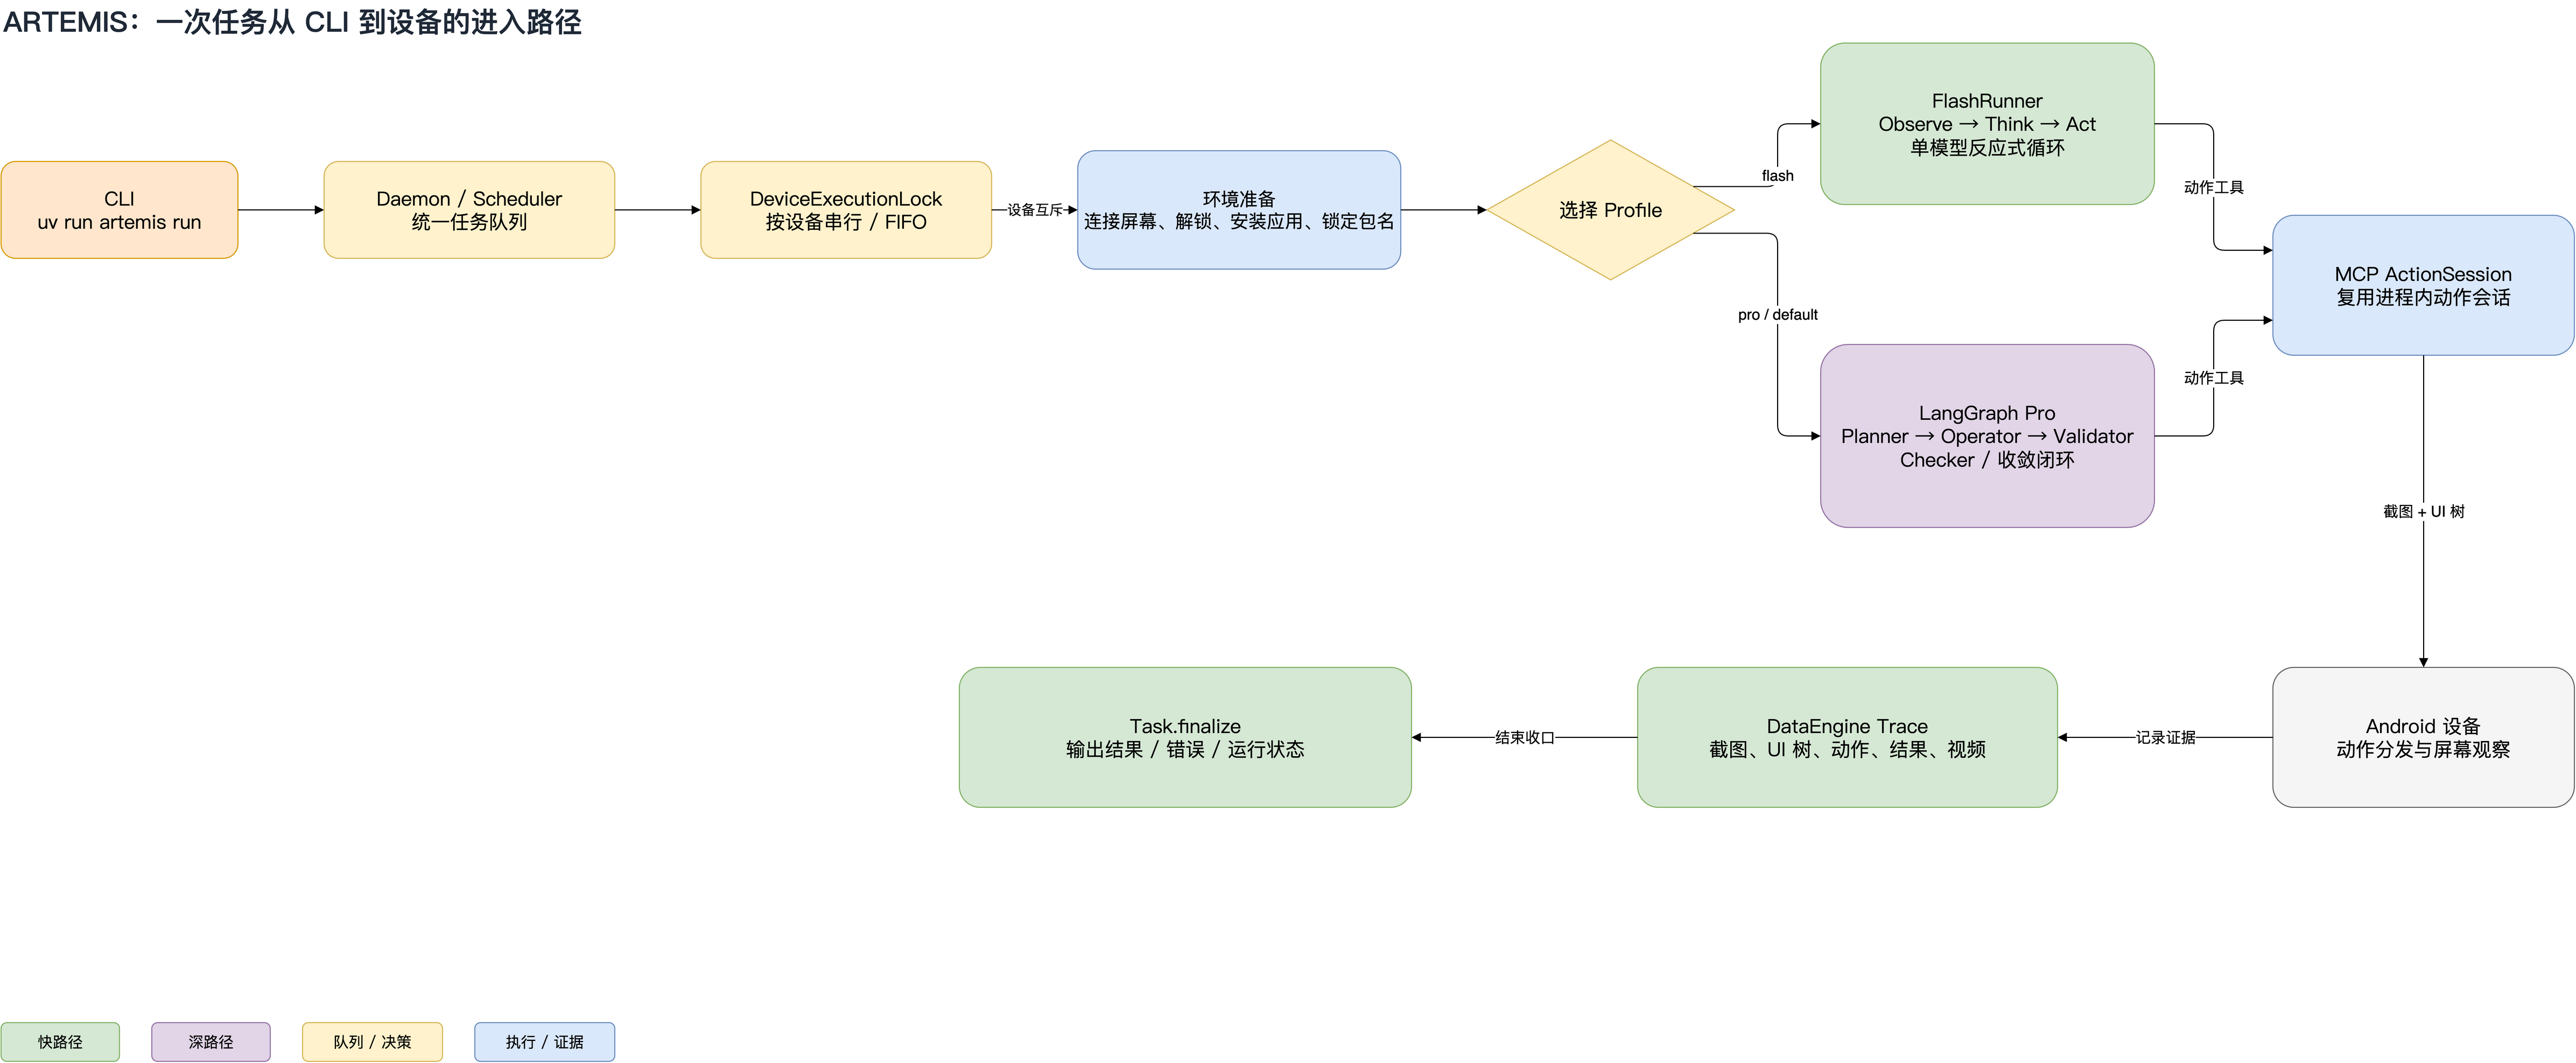
run.py、sdk/agent.py、flash/runner.py、graph/graph.py 和 clients/accessibility_client.py 整理的总体执行链路。在进入算法细节前,先立住宏观上的三个关键设计边界:
1.1 设备互斥锁为什么卡在“连接屏幕和初始化环境”之前?
很多自动化框架只在实际发 ADB 点击命令时加锁,结果两个任务同时连上一台手机时,任务 B 在初始化阶段清后台、设输入法或拉起首页的动作,直接把任务 A 正在看的页面顶掉了。
在 artemis/sdk/agent.py 的 Agent._run_task() 中,ARTEMIS 先根据 device_serial 申请跨进程文件与内存锁 DeviceExecutionLock,只有排到 FIFO 队列队首、真正拿到锁之后,才允许执行唤醒屏幕、挂载无障碍服务、安装 APK 和启动 scrcpy 录屏:
device_lock = DeviceExecutionLock(target_serial)
# All device mutations and UI initialization MUST happen strictly inside this lock
# after reaching the head of the global FIFO queue.
async with device_lock.acquire(trace_id=trace_id, goal=request.goal, ...):
    await self._prepare_device_environment(context, request)
不同 device_serial 的手机互不阻塞、完全并发;同一台手机上的任务严格串行,保证单次任务的截图、UI 树、录屏和日志绝对不会被其他任务交叉污染。
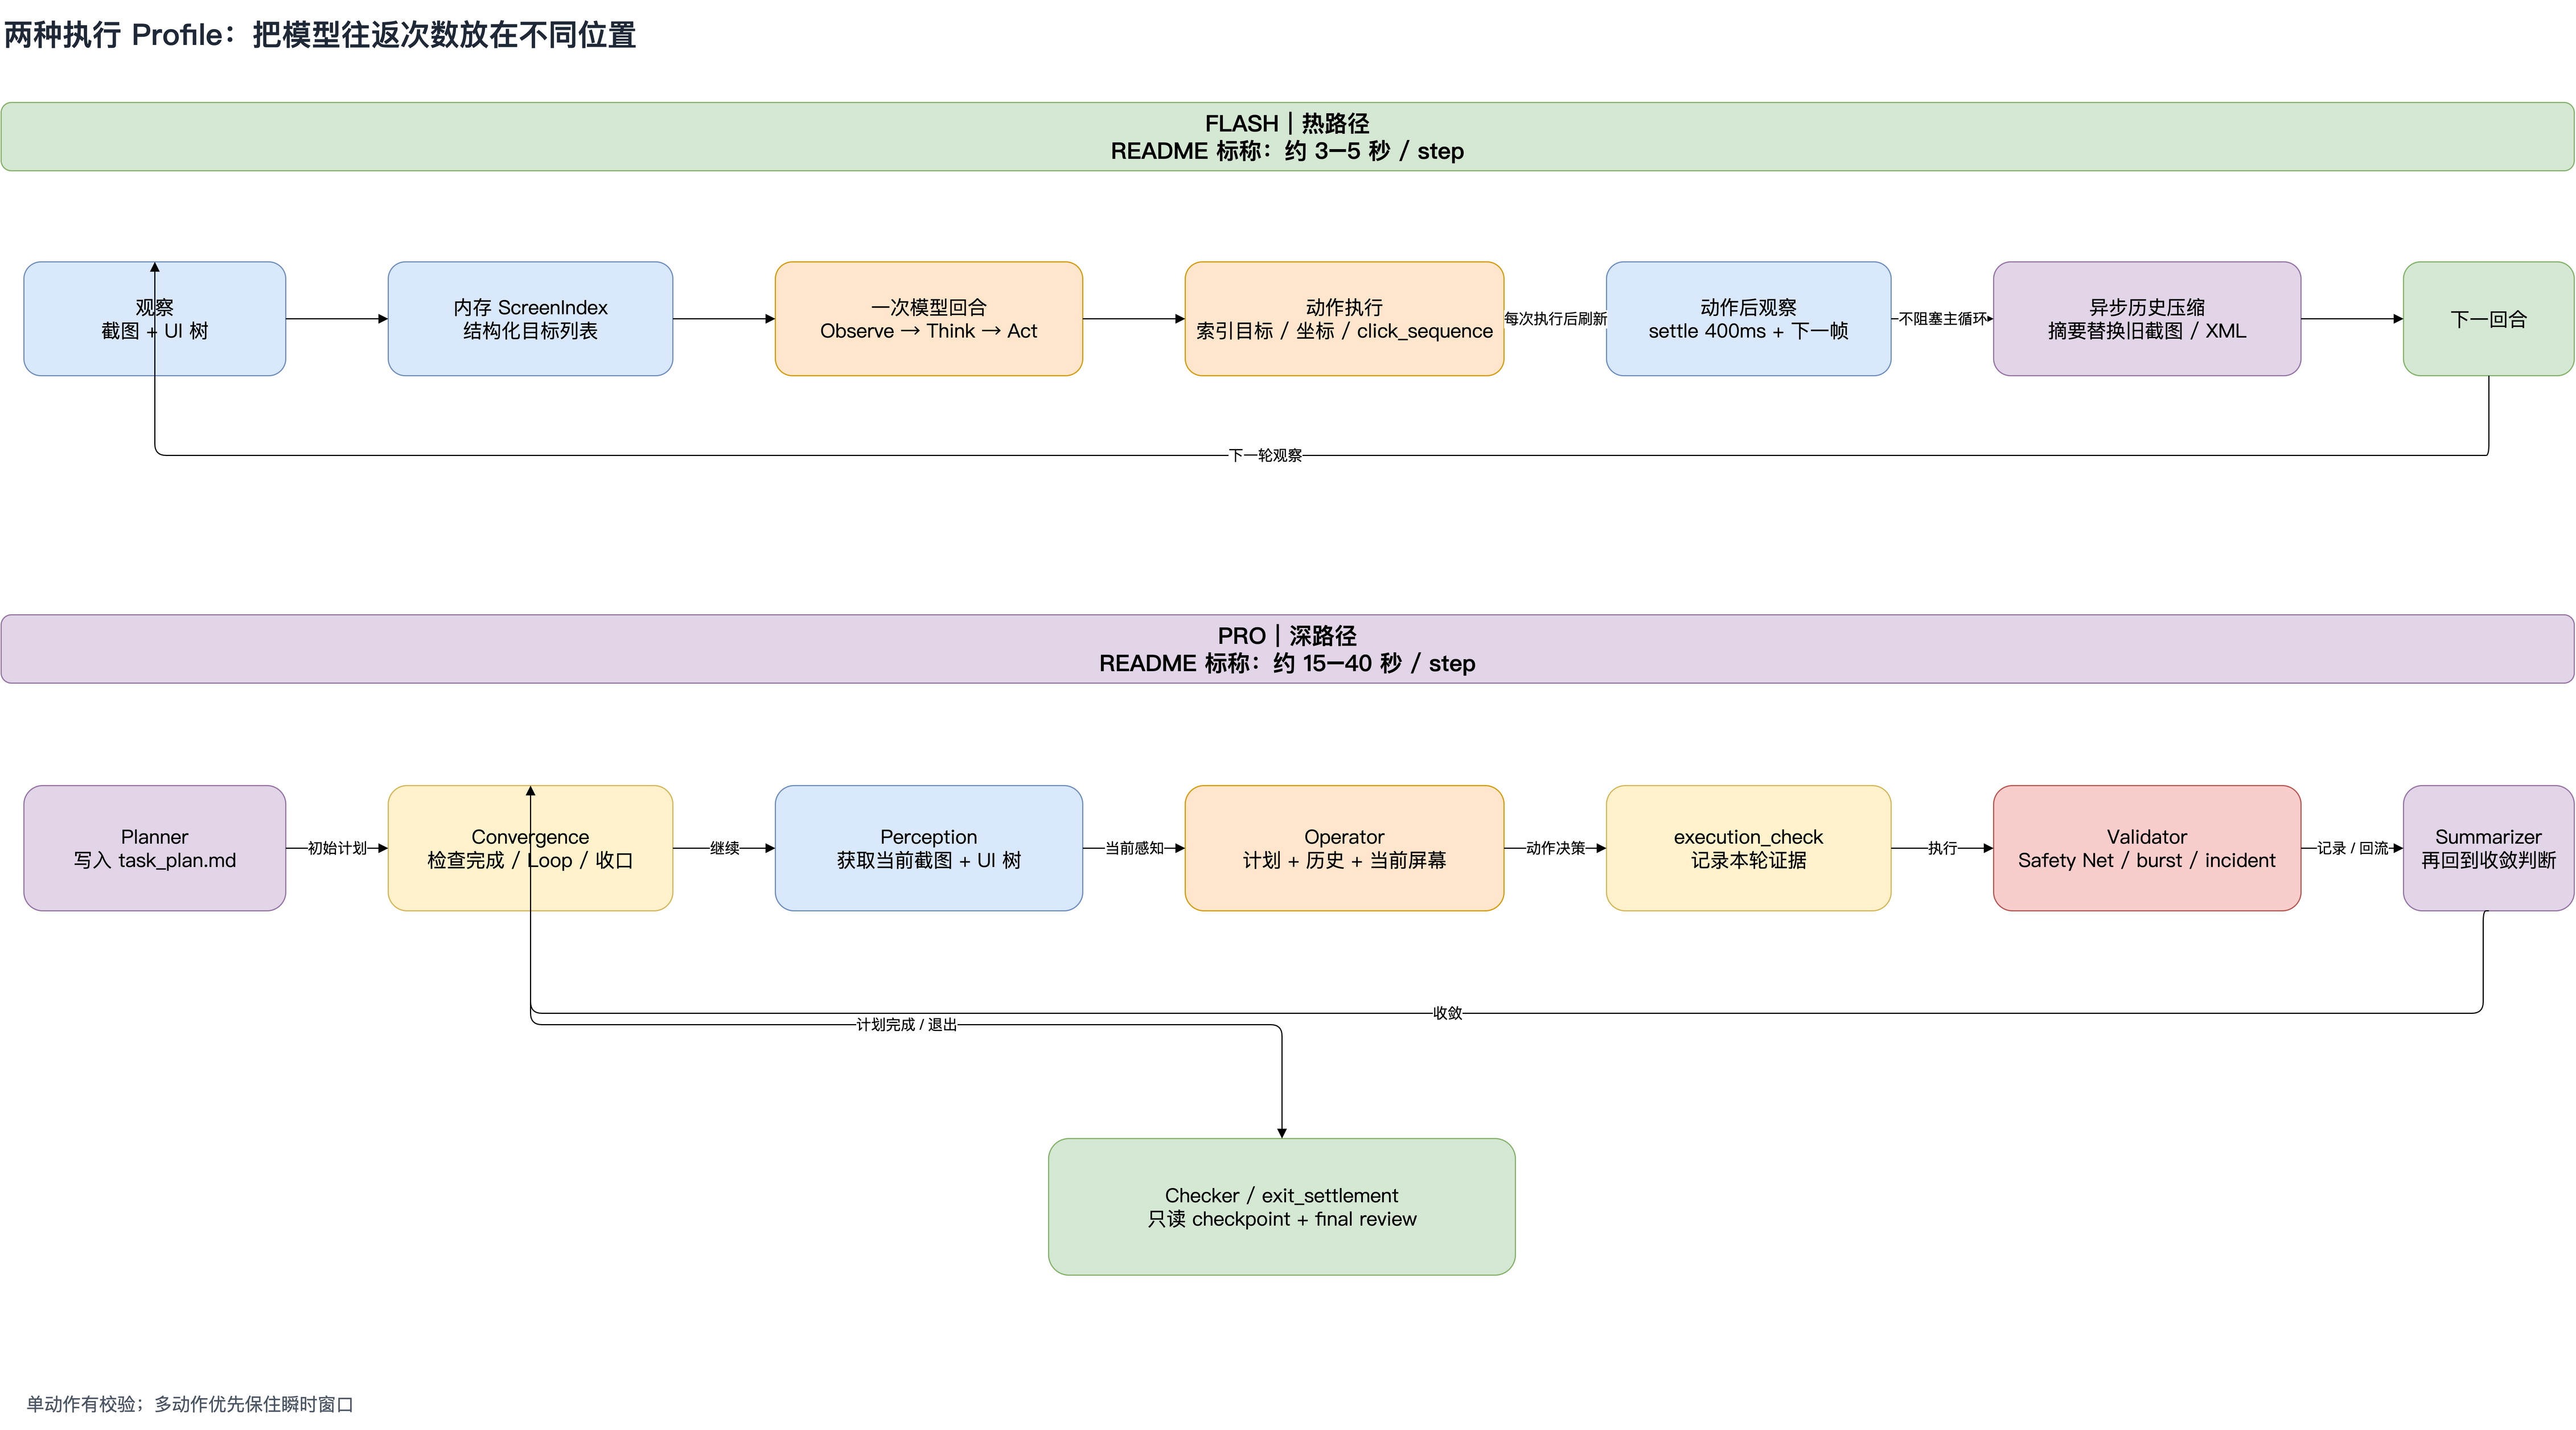
1.2 Flash 与 Pro 不是“少跑几步”,而是两条共享底座的独立引擎
拿到设备锁并初始化好 ArtemisContext 后,Agent._run_task() 根据 request.profile 分流到两条截然不同的执行路径:
--profile flash(FlashRunner,单步约 3–5 秒):见artemis/agents/flash/runner.py。它完全绕开 LangGraph 状态机、Planner 和 Checker,由单个模型在一个紧凑的while循环里直接完成“观察实时屏幕 思考并调用动作工具 400ms 后抓下一帧”。值得注意的是,artemis.jsonc中agent.flash.max_turns默认是0(无步数上限),因为它与 Pro 共享了同一套在线上下文压缩账本——任务长短本身不再是必须切到 Pro 的理由。--profile pro(LangGraph 多节点闭环,单步约 15–40 秒):见artemis/graph/graph.py的get_graph()。它把长程复杂任务拆成plannerconvergenceperceptionoperatorexecution_checkvalidatorsummarizerexit_settlement (checker)的有向状态图。每一步都有活体 Markdown 计划约束、动作前 Safety Net 校验与退出前的只读终审。
两条路径虽然控制流不同,但底层完全复用了同一套端侧感知客户端(AccessibilityClient)、进程内动作会话(ActionSession)、三级定位器(Explorer)和四区会话账本(TranscriptLedger)。这就引出了本文最核心的问题:这些底层模块到底用了什么巧思,才让执行既快又准?
2. 快且准的设计一:端侧无障碍原子快照与进程内 ActionSession
在 Android 真机上做 Agent,第一个隐形的性能杀手不是大模型,而是截图与 dump 无障碍树(UI Hierarchy)。
传统方案普遍依赖 uiautomator dump(或 UIAutomator2):
- 慢且容易卡死:
UiAutomation在导出布局树前默认会等待主线程进入空闲(Idle)状态。遇到带有轮播图、加载骨架屏、弹幕或视频播放的动态页面时,一次 dump 经常卡满 2~5 秒甚至超时报错。 - 独占单例连接:Android 系统只允许一个进程持有
UiAutomationConnection。一旦 Agent 挂上UIAutomator2,手机上的 Appium、Espresso 或 Mobly 测试进程就会因为连接被抢占而直接崩溃。 - 帧不同步(撕裂):先调
adb exec-out screencap抓图、再调uiautomator dump导 XML,两次调用相隔几百毫秒,截图里的按钮位置和 XML 里的bounds经常对不上。
2.1 端侧 AccessibilityClient:单次 /snapshot 同帧抓取 XML 与截图
打开 artemis/clients/accessibility_client.py 可以看到,ARTEMIS 在手机端安装了一个极轻量的无障碍服务 Artemis Accessibility Helper(只监听手机本机回环端口,携带 X-Artemis-Token 鉴权)。它彻底绕开了 UiAutomationConnection 单例限制,并且在 Android 11+ 上提供了 /snapshot?fields=xml 原子接口:
def _snapshot(self) -> dict[str, Any]:
    """``/snapshot?fields=xml``: hierarchy plus, on Android 11+, the screenshot."""
    data = json.loads(self._http("/snapshot?fields=xml", timeout=8.0).decode("utf-8"))
    if not isinstance(data, dict):
        raise HelperRequestError(200, "/snapshot", "non-object answer")
    if not data.get("success"):
        raise HelperEmptyHierarchy(...)
    return data
一次本机端口转发的 HTTP 请求,端侧服务在同一瞬间把当前窗口的 XML 树和屏幕位图一起打包返回,既消除了“图和树不同步”的时间差,又把单次观察的端侧耗时压到了百毫秒级。
更稳妥的是 artemis/clients/screen_client_factory.py 里的 FallbackScreenClient:默认 auto 模式下优先走 Helper;万一 Helper 通道断开或返回空窗口(HelperEmptyHierarchy),客户端会自动降级到 UIAutomator2,同时设置 retry_after: float = 30.0 秒的冷却窗口——在接下来的 30 秒内直接使用 UIAutomator2,避免每一步都先傻等 5 秒 Helper 超时再回退。
2.2 进程内 ActionSession:消除跨进程 MCP 建连开销与半截取消故障
在动作执行侧,artemis/mcp/action_session.py 将原本每次工具调用都要新建的 MCP Client/Server 会话改造成了单任务复用的进程内持久会话 ActionSession。
这里有一个非常细腻的异步工程细节:如果外层给工具调用加了 asyncio.wait_for(..., timeout=...),一旦超时取消直接穿透进底层 MCP 内存管道(in-memory stream),整个会话就会处于半截损坏状态(bricked),后续所有点击都会报通道错误。为此,ActionSession 专门启动了一个独立的后台 _owner_task 持有上下文管理器,所有工具调用通过队列投递给 Owner 执行,把“单次调用超时”与“底层会话生命周期”彻底隔离开。
3. 快且准的设计二:送入模型前的五步 UI 树几何净化
拿到原始 XML 树和 OCR 结果后,如果直接把几百个节点原封不动塞进 Prompt,不仅浪费数千 Token,还会引发三种高频误操作:
- 点中滚出屏幕的半截节点:ScrollView 里的列表项虽然有一大半已经滑到底部导航栏下面,但它的原始
bounds中心点恰好落在底部导航栏的“首页/我的”图标上,模型一点列表项,结果触发了底栏切换页面; - 被悬浮按钮(FAB)挡住:列表项右侧被右下角悬浮的“新建
+”按钮遮盖,模型却毫无察觉; - 自绘界面盲区:Canvas、Flutter、Compose 或内嵌网页里的文字没有无障碍节点。
对照图 5 第一层,我们看 artemis/utils/ui_filter.py、ocr_xml_fusion.py 和 visualization.py 是如何在 0 次模型调用 下用五步几何算法把脏数据洗干净的:
ui_filter.py、ocr_xml_fusion.py、visualization.py、explorer.py 和 validator/ 整理的感知净化、三级定位与动作前自愈全链路。3.1 第一步:祖先容器边界递归裁剪(_clip_bounds)
在遍历 UI 树时,_filter_and_prune() 会把父节点的可见 bounds 作为 ancestor_bounds 一路向下传递。子节点的矩形会被强制裁剪到父容器内部(left = max(child.left, ancestor.left) 等),并且连同缓存的 parsed_bounds 一起原地更新。裁剪后宽高不足屏幕短边 0.5%(至少 5px)的碎片节点会被直接过滤。
3.2 第二步:顶/底固定系统栏三重识别与安全钳制(_clamp_by_fixed_bars)
即便做了父容器裁剪,全屏滚动容器往往和底部导航栏同级(平铺在 FrameLayout 下)。为此,_detect_fixed_system_bars() 先用三重守卫识别屏幕顶部状态栏和底部固定导航栏:
- 紧贴屏幕上沿(
top <= 0)或下沿(bottom >= screen_height),且宽度占屏幕 ; - 自身、祖先及所有子孙节点均不可滚动(
scrollable == false); - 包名为
com.android.systemui或资源 ID 命中bottom_navigation / tab_layout / navigation_bar且高度在合理比例内。
随后,_clamp_by_fixed_bars() 遍历所有候选元素,将与顶/底固定栏重叠的区域切除。如果某个滚动列表项被切掉后剩余可见高度不足 20px(bottom - top <= max(min_size, 20)),直接返回 False 将该露头细条静默丢弃。这一步直接消除了“想点列表最后一行却误触底部导航栏”的经典 Bug。
3.3 第三步:父子同文去重与互补兄弟合并
Android 布局经常出现外层 LinearLayout(clickable=true) 包着一个 ImageView 图标和一个 TextView("设置")。如果直接平铺,模型会看到两个甚至三个重叠的节点。
_prune_parent_child_redundancy():若父子节点文本完全相同,擦除子节点重复文本或移除纯文本子节点;_merge_complementary_children():若可点击父容器下恰好只有 1 个文本子节点 + 若干纯装饰图标子节点(且不含 CheckBox/Switch/EditText 等表单控件),自动将它们合并为一个联合边界节点,并把无描述图片补标为[Icon]。
3.4 第四步:双频段 OCR-XML 几何融合与行聚合(fuse_ocr_with_xml)
当开启 OCR 补充时,fuse_ocr_with_xml() 不会把 OCR 文本框胡乱塞进根节点:
- 排除巨型背景容器:先剔除面积超过全屏
10%且类名不含text/button/edit/search/input的巨型容器节点; - 双频段重叠匹配:计算每个 OCR 框落在 XML 节点内的面积占比(),分为 Band 1() 和 Band 2() 两档,优先挂载到面积最小的精细 XML 节点上;
- 行内聚类与相似度去重:按垂直中心
< 10px归为同行、水平间距< 30px合并词块;若聚合后的 OCR 文本已被 XML 原生文本包含或SequenceMatcher相似度> 0.8,直接丢弃以免重复,否则作为ocr_elements挂载并为节点类名打上[OCR]标记。
3.5 第五步:非同心互遮挡警告注入与输入框 Hint / Error 暴露
最后,在生成喂给模型的 --- Visible UI Elements --- 文本列表时,visualization.py 做了两件极其实用的事:
第一,把空输入框的 Hint 和校验报错 Error 直接渲染出来(第 401–418 行):空输入框没有 text,但无障碍服务能读到 hint="Search settings" 或表单报错 error="Password too short",代码会将它们格式化为 [idx] Hint: 'Search settings' | Bounds: ... | Error: 'Password too short',让模型一眼看懂为什么表单提交失败。
第二,_inject_mutual_occlusion_warnings() 对所有上榜元素做两两交集检测。怎么区分“正常的父子嵌套”和“悬浮窗/FAB 遮挡”?代码算了一个非常巧妙的几何判据——圆心偏移度(Concentricity):
center_dist = ((center_i_x - center_j_x) ** 2 + (center_i_y - center_j_y) ** 2) ** 0.5
max_dim = max(r_i - l_i, r_j - l_j, bot_i - t_i, bot_j - t_j)
is_concentric = center_dist < (max_dim * 0.20)
只有当一个框完全包住另一个框、外框面积大于内框 2 倍、**且两者中心点距离小于最大边长的 20%(同心嵌套)**时,才算正常的容器包裹;反之,如果像右下角悬浮按钮盖住了长列表项的右端(中心点明显偏移),且重叠面积达到任一元素的 ,代码就会在该元素行末尾自动追加软告警:
[12] Text: 'Submit Order' | Bounds: [50,880][950,940] (WARNING: may overlap with [15], possible occlusion)这相当于在完全不消耗视觉 Token 的前提下,提前给大模型戴上了一副防遮挡透视镜。
4. 快且准的设计三:三级渐进式定位(Explorer)与具身空间模型
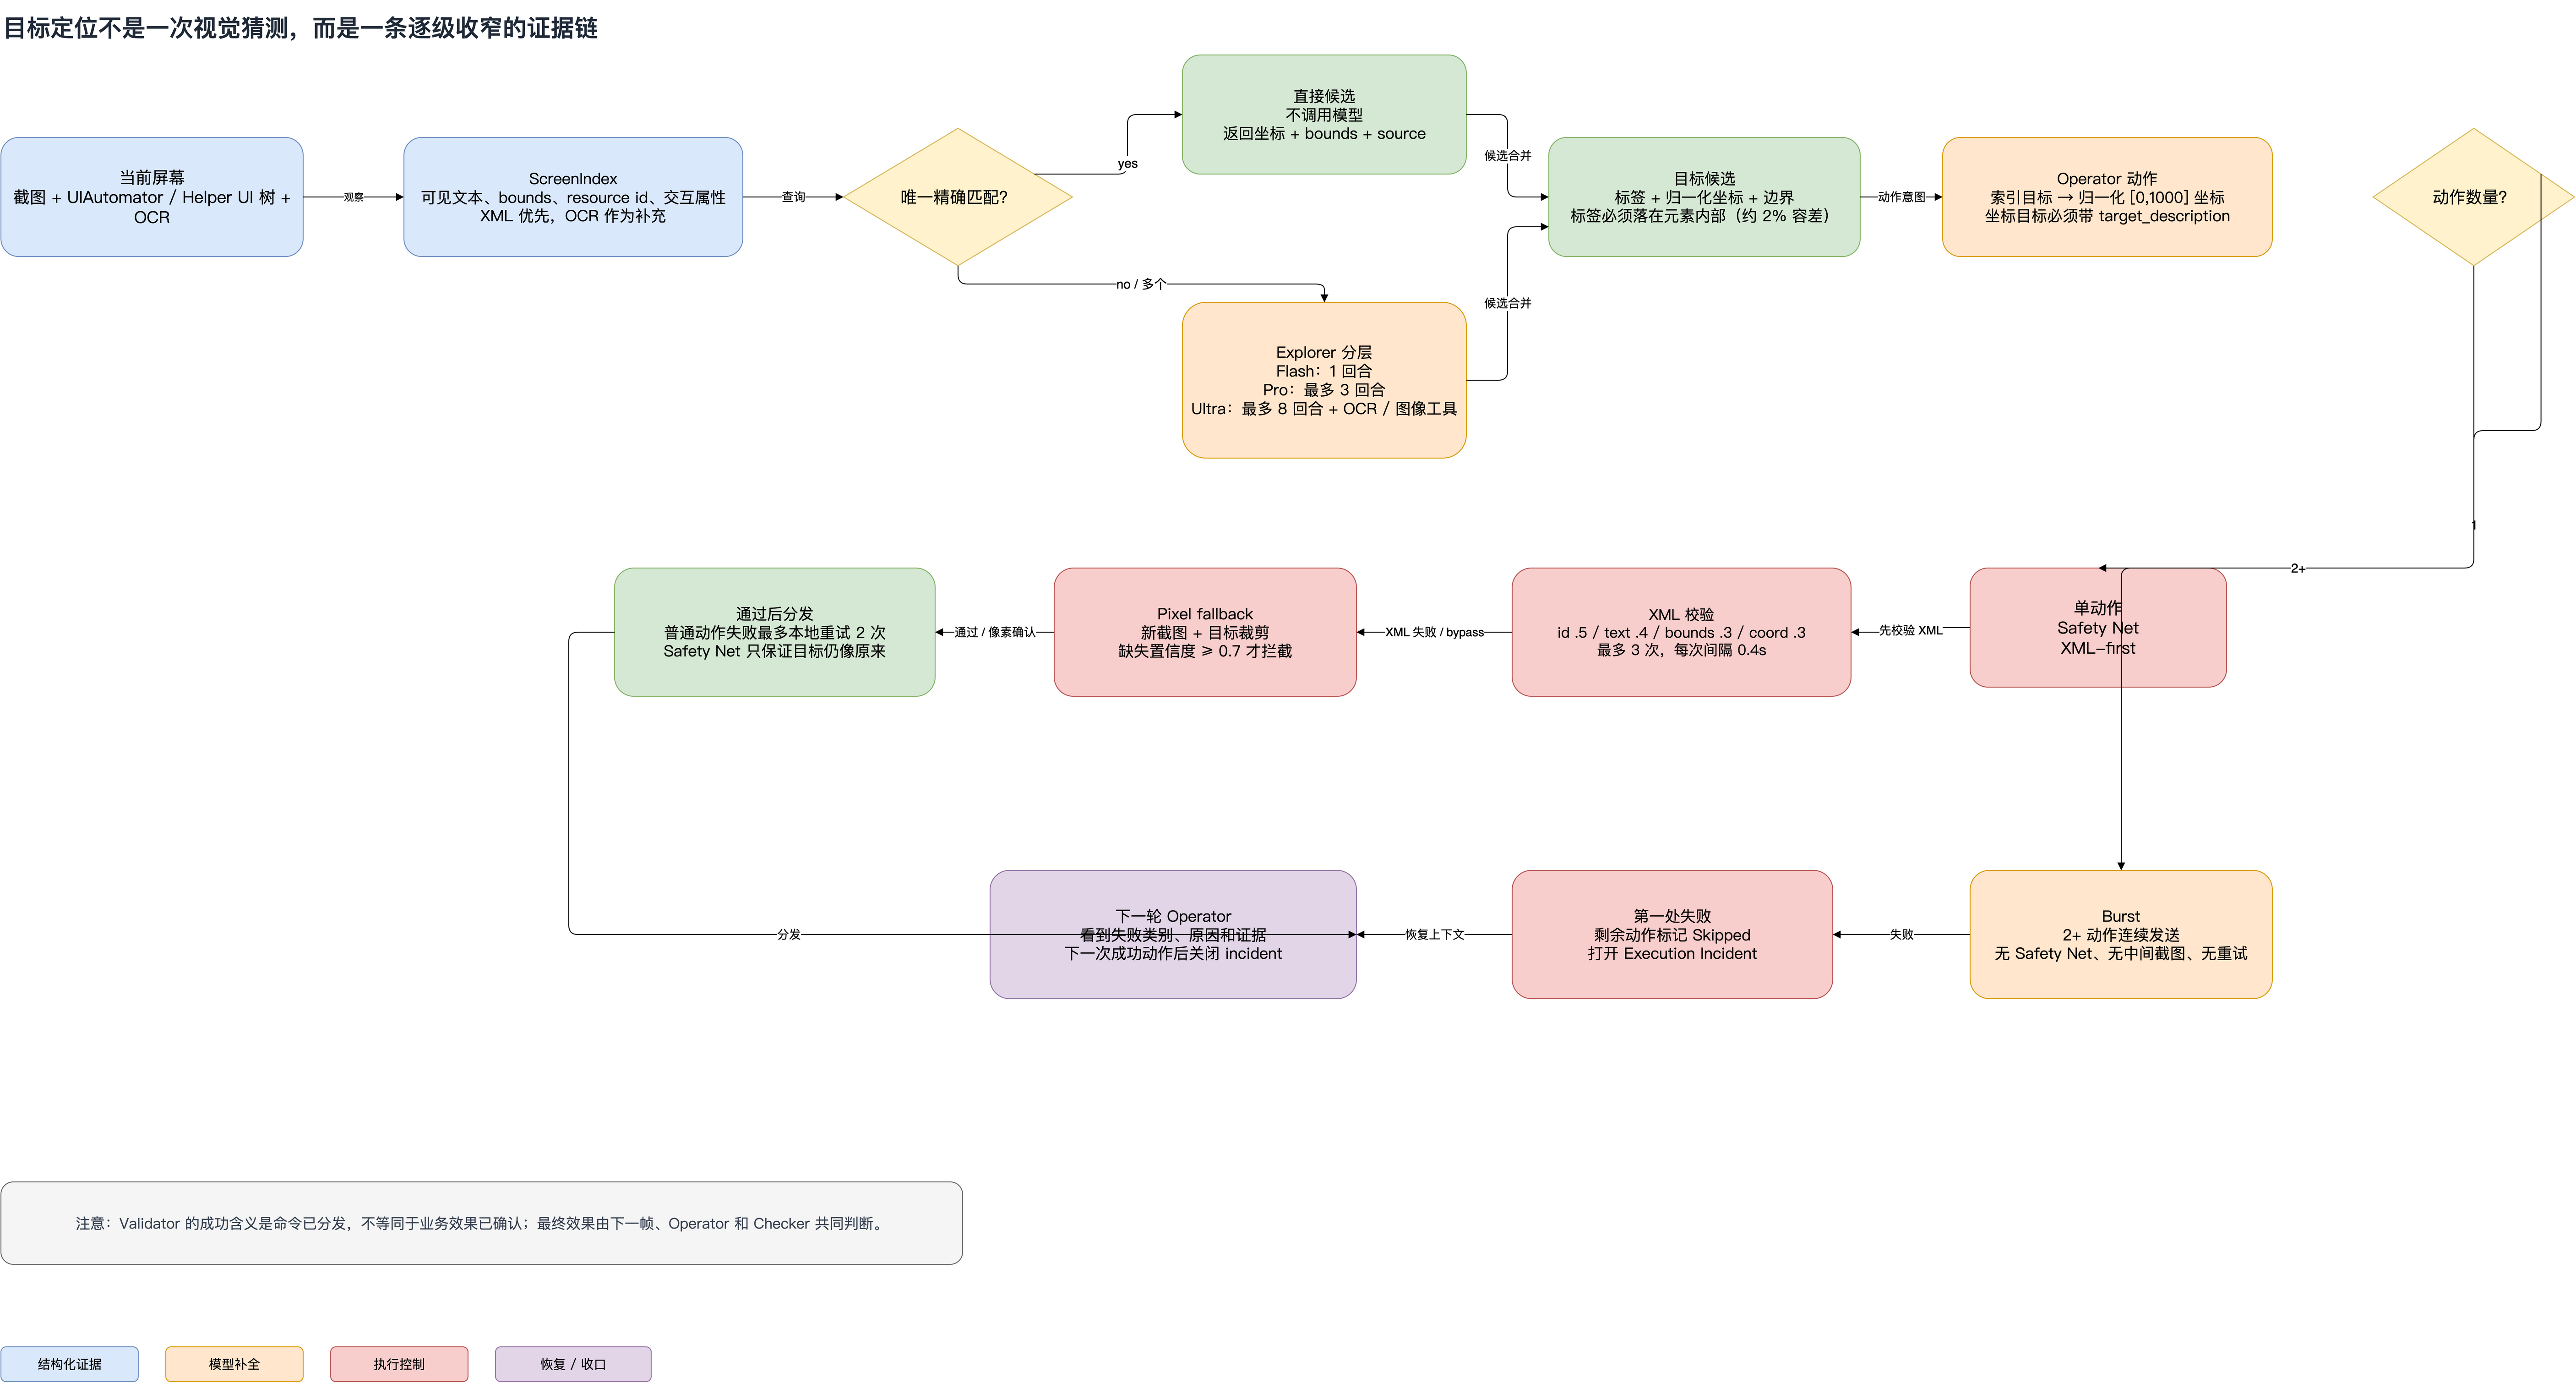
当界面上的目标可以通过 [1]..[N] 索引直接点击时,McpActionExecutor._resolve_index() 直接查表取出中心坐标并附上 target_text / target_bounds / target_resource_id 元数据,耗时为 0。
但当目标是没有无障碍文本的图标、自绘 Canvas 控件,或者 Operator 主动调用 ask_explorer 寻找复杂目标时,artemis/agents/explorer/explorer.py 设计了如图 5 第二层所示的三级渐进式定位(Progressive Grounding):
4.1 Level 0:ScreenIndex 结构化精确预检(0 Token,亚毫秒级返回)
每次进入 Explorer.run(),系统先根据当前帧融合后的 XML/OCR 树构建内存索引 ScreenIndex。在真正发起任何 LLM/VLM 网络请求前,run_setup.py 先对查询词(支持以 | 分隔多个目标)跑一次 _structural_prepass():
for part in parts:
    hits = self.screen_index.exact_matches(part)
    if len(hits) != 1:
        unresolved.append(part)
        continue
    element = hits[0]
    ...
exact_matches() 会把大小写和空白归一化后相等的候选捞出来,按“XML 节点优先于 OCR 节点、小面积优先于大面积”排序,并将重叠度 的同位置重复项折叠为一。只要某个查询词在当前屏幕上唯一精确命中,代码直接算出 [0, 1000] 归一化坐标与 bounds 返回;如果所有查询词都唯一命中(if prepass and not unresolved),整个 Explorer 调用直接以 0 次模型调用 结束。官方架构图指出,这一层本地 OCR-XML 预检接管了 85% 以上的常规动作定位。
4.2 Level 1:为什么 flash 档必须绑定 gemini-robotics-er-2-preview?
对于 Level 0 未命中或存在多个同名按钮需要消歧的查询,才进入视觉模型。这里翻看 artemis.jsonc 的第 73–83 行注释,会发现一个非常关键的模型选型经验:
// 👁️ Object Detector & Explorer (Flash Mode): Visual coordinates grounding and bounding boxes
// CRITICAL REQUIREMENT: Standard LLMs (including standard Gemini Flash, GPT-4o, Claude 3.7)
// lack sub-pixel spatial coordinate fine-tuning. To achieve accurate [x, y] point and
// bounding box localization, this node MUST use specialized Gemini ER (Embodied Reasoning
// / Robotics) models: e.g., "gemini-robotics-er-2-preview".
通用对话大模型擅长语义推理,但直接让它报屏幕上的 [x, y] 像素坐标往往会有几十像素的 системати偏差。因此 ARTEMIS 把推理(Operator 用 gemini-3.8-flash / gpt-4o)和空间打点(object_detector 专用具身推理模型 gemini-robotics-er-2-preview)彻底解耦。
不仅如此,即使视觉模型返回了候选坐标和标签 label,Explorer._enrich_candidates() 也绝不盲信标签,而是用屏幕宽高的 2%(LABEL_TOLERANCE_RATIO = 0.02) 作为容差框,检验模型报出的 [x, y] 是否真的落在该注册元素的 bounds 内部——只有点在框内,才允许继承该元素的结构化边界。
4.3 Level 2 & 3:pro(3 轮)与 ultra(8 轮 + 显式缓存)感知循环
如果用户将 Explorer 档位配为 pro 或 ultra(见 tiers.py),Explorer 会进入多轮 ReAct 循环,开放模糊文本搜索(search_ui_tree)、坐标反向碰撞审计(inspect_coordinates,只汇报最内层可交互节点而非外层大框)、局部裁剪放大与像素级图像处理;在 ultra 档位下还默认开启 Gemini Explicit Context Caching(caching=True),避免 8 轮循环重复计费同一张高清大图。
5. 快且准的设计四:动作前 Safety Net、200px 坐标自愈与 Fast-Action Burst
这是整套源码里最精彩的部分。
试想一个真实场景:Operator 在 时刻看到屏幕上的“确认支付”按钮位于 (540, 1800),经过 6 秒钟的模型思考,在 时刻下发 tap(540, 1800)。但就在这 6 秒内:
- 情况 A(微幅位移):上方异步加载出了一行运费说明,“确认支付”按钮往下挤了 80 像素,到了
(540, 1880); - 情况 B(弹窗遮挡):系统突然弹出了一个权限请求框或促销弹窗,正好盖在
(540, 1800)上; - 情况 C(瞬态控件):你要点的是视频播放器上点击一下才出现的“全屏”图标,2 秒不点就会自动淡出消失。
如果所有动作都无脑发给 ADB,情况 A 和 B 会立刻点错;如果所有动作都在中间截图再问一遍大模型,情况 C 永远点不到。
ARTEMIS 在 artemis/agents/validator/execution_loop.py 里用按动作数量分流的双轨机制同时解决了这三种情况(对应图 5 第三层):
5.1 单动作轨道:XML 四信号加权 + 200px 原地坐标自愈 + 像素兜底
当 Operator 本轮只输出 1 个终结动作时,自动进入 Vetted Single Action(受检单动作) 轨道:
第一步:拉取实时 XML 并支持转场短重试。 validate_action_precondition() 通过 session.ui_hierarchy() 抓取手机此刻的最新布局树。如果页面正处于转场动画导致匹配失败,它最多重试 3 次,每次间隔 0.4 秒。
第二步:四信号加权打分与巨型容器惩罚。 _score_element() 与 _combine_signals() 对实时树中的每个候选节点计算综合得分 score 和身份得分 identity_score:
- Resource ID 权重
W_ID = 0.5:完全匹配得+1.0,候选无 ID 得+0.3,ID 冲突直接重罚-0.5; - 文本相似度权重
W_TEXT = 0.4:归一化精确匹配得1.0,子串包含得0.8,否则取SequenceMatcher比例; - 边界交并比权重
W_BOUNDS = 0.3:计算决策时刻target_bounds与当前节点bounds的 IoU;同时检查宽高比例,若宽或高相差超过 2.5 倍(size_mismatch) 且 ID 不匹配,直接将文本、边界和坐标分清零,防止把小按钮误匹配到包含相同文字的外层大容器; - 坐标包含权重
W_COORD = 0.3:原计划点击坐标是否落在该节点矩形内; - 距离衰减:总分再乘以
decay = max(0.5, 1.0 - dist / 800.0)。当距离 时通过阈值为0.55,距离更远时要求阈值达到0.75(其中scale_factor按当前屏幕对角线相对1080 × 2400的比例缩放,保证跨分辨率一致)。
第三步:不超过 200px 的漂移,原地坐标自愈(Coordinate Self-Healing)! 看 precondition_xml.py 的 _handle_match_success():
def _handle_match_success(
    action_item: dict, best: dict, target_text, scale_factor: float
) -> tuple[bool, ValidationErrorCategory, str]:
    """Handles a passing match: self-heals coordinates for moderate drifts."""
    if best["distance"] <= 200 * scale_factor:
        new_coords = best["center"]
        old_coords = action_item.get("coordinates")
        if old_coords != new_coords:
            action_item["coordinates"] = new_coords
            action_item.pop("normalized_coordinates", None)
    return True, ValidationErrorCategory.NONE, ""
这就是前面“情况 A”的答案:当目标按钮因为上方插入元素而下移了 80 像素时,XML Safety Net 认出它还是同一个按钮(ID 与文本匹配),且位移在 200 * scale_factor 像素以内,于是直接在毫秒级把 action_item["coordinates"] 修正成按钮的新中心点并立刻下发点击——既没点偏,又省掉了打回给 Operator 重新推理一轮的十几秒延迟!
第四步:Pixel VLM 兜底与 0.7 置信度非对称放行。 如果动作是纯坐标点击(无 XML 元数据)或 XML 校验未通过,precondition_pixel.py 会抓一张实时截图,把决策帧(Image 1)和实时帧(Image 2)在目标坐标处画上红点,交给轻量模型(默认 gemini-3.5-flash-lite)对比判断。这里有一个防死锁设计(第 210–235 行):如果模型判定 is_present=True,直接放行;如果判定 is_present=False,只有当模型给出的 confidence >= 0.7 时才真正拦截,低于 0.7 则记为 PIXEL_BYPASSED 放行,避免轻量视觉模型偶尔的模糊误判把正常流程卡死。
5.2 多动作轨道:Fast-Action Burst 抢占瞬态 UI 时间窗口
反过来,面对前面说的“情况 C”(一碰屏幕才出现、2 秒后自动消失的播放器控制条或连续菜单),Operator 可以在单回合里一次性输出 2~4 个动作(Flash 模式下对应 click_sequence)。
一旦检测到单轮动作数 ,execution_loop.py 自动切换到 burst=True 模式:
- 不做 Safety Net 预检;
- 动作之间不重新截图、不等待页面 settle;
- 每个动作只发一次(
max_local_retries = 1),背靠背极速连发; - 首错即停(Fail-Fast):一旦序列中第 个动作执行报错,立即中止后续动作,将剩余动作标记为
"Skipped (burst aborted)",并抓取失败现场截图转入事故恢复。
6. 快且准的设计五:无独立修复 Agent 的状态化 Execution Incident
很多多智能体框架在动作失败后会唤醒一个专门的 RepairAgent 或 ReflectorAgent。但这在工程上有两个弊端:第一,每次报错都要多花一次完整的大模型调用延迟和上下文交接成本;第二,修复 Agent 往往不知道 Operator 当时的完整上下文意图,容易“头疼医头”,修完一步又跟主计划脱节。
ARTEMIS 在 artemis/agents/validator/incidents.py 和 operator/prompts.py 中砍掉了独立的修复 Agent,改为状态化的执行事故单(Execution Incident)。
当 Safety Net 拦截动作时,_classify_failure() 会把现场证据归入三类精确诊断之一,并写入 state.open_incident:
target_shifted(目标大步位移):目标身份分很高(identity_score >= 0.85),但移动距离超过了自愈上限,直接在safety_net_evidence中附上目标的最新归一化坐标与新 bounds(告诉 Operator:“你要点的东西还在,但挪到新位置了”);target_occupied(目标被遮挡):_find_occupant()找出当前覆盖在原坐标上的最内层非全屏元素,直接在证据里写出遮挡物的文本和 Resource ID(例如弹窗按钮名);target_disappeared(目标已消失):自动回查历史步骤,找出该步骤之前的最后一次成功动作(_last_successful_action_before),提示 Operator:“如果消失的目标是由上一步动作召唤出来的瞬态菜单,你需要重新触发那一步”。
只要还没有任何一个终结动作成功执行,这张 --- Execution Incident (OPEN) --- 卡片就会带着累加的 consecutive_failures 置顶出现在 Operator 每轮观察尾部;一旦某个动作成功下发,下一轮会自动切换为一张单轮有效的 --- Execution Incident (CLOSED) --- 通知,强制 Operator 对照最新屏幕结算刚才受阻的原意图(已完成、仍待办、或已无需执行)。
7. 快且准的设计六:四区字节稳定账本(S+F+A+T)与双边缘无损压缩
长程任务跑到第 50~100 步时,如何同时保住低延迟(高 KV Cache 命中率)、小上下文(>70% Token 削减)和高准确率(不把历史旧元素索引 [3] 当成当前屏幕控件)?
答案全在 artemis/memory/transcript.py、context_compressor.py 和 chunking.py 组成的记忆系统里(对应图 6 左列):
memory/transcript.py、context_compressor.py、chunking.py、operator/prompts.py 和 graph/checkpoints.py 整理的长程记忆压缩、零模型死循环检测与异步验证机制。7.1 为什么把 Prompt 拆成 S + F + A + T 四个区域?——为了保住 Prefix KV Cache
大模型推理的首字延迟(TTFT)和费用很大程度上取决于**前缀缓存(Prefix KV Cache)**能不能命中。只要消息列表前部有任意一个字节发生变化,从变化点往后的所有 KV Cache 就会全部失效。
传统的 Agent 每走一步,都会更新 System Prompt 里的 Current Plan & History,或者把历史步骤的时间戳渲染成 "2 minutes ago"、"3 minutes ago"——这意味着每一轮请求的第 1 条消息都在变,前缀缓存命中率永远是 0%!
看看 transcript.py 和 prompts.py 的 M2 模板切分 是怎么做的:
S区(Stable Prefix,静态系统前缀):render_transcript_static_system()把原本位于 System Prompt 里的动态{{ plan_and_history }}替换成一段固定不变的静态指针说明,使得第 1 条SystemMessage在整场会话中字节级完全恒定(Byte-identical)。F区(Frozen History,冻结历史区):存放已压缩的 L2 分块与 L3 周期(Era),仅在发生分块折叠时追加或更新;且账本内所有时间戳一律使用相对会话起点的固定偏移T+mm:ss(如T+01:25),绝不使用随时间流逝而改变的"ago"表达。A区(Active Window,活动窗口):仅追加(Append-only)已提交的近期轮次消息,绝不删除或重排消息顺序,保证AIMessage(tool_calls)与ToolMessage配对结构永不破坏。T区(Current Tail,当前轮尾部):每轮新鲜构建,包含当前截图、当前可见 UI 元素列表、复诵的最新任务计划(--- Task Plan (recited) ---)以及标记为ephemeral=True的单轮提示。
7.2 ScrubEdgeCompressor 双边缘单向擦除:为什么模型绝不会点错旧索引?
当本轮结束、消息从 T 区提交进 A 区后,ScrubEdgeCompressor 会在 A 区上维护两条单向推进、不可逆的擦除边:
- 第一条边:浅文本擦除边(
xml_scrub_depth = 1)。只要有一帧更新的观察进入上下文(即旧消息深度 ),压缩器立刻原地切掉旧消息里的--- Visible UI Elements ---列表、--- Task Plan (recited) ---以及所有登记在additional_kwargs["ephemeral_blocks"]下的临时提示块(如上一轮的 Incident 卡片、推理提醒、验证反馈)。这保证了在整个上下文窗口里,永远只有最新一帧T区携带[1]..[N]元素索引,模型在物理上就不可能看到或误引上一页残留的旧[3]索引! - 第二条边:自适应图片擦除边(
image_scrub_depth = 6 -> 3)。每一步完成后,后台并发(max_concurrency=2)调用轻量模型gemini-3.5-flash-lite为该步生成客观视觉转移摘要。当 Operator 实测上下文占用率低于start_ratio(35%,对应 80,000 Token 预算的 28,000 Token)时,窗口保留最近 6 张原图;一旦达到 35%,擦除边收紧至 3 张,更早的截图被后台准备好的--- Historical Visual Transition ---文字摘要原位替换。一旦替换完成,该消息即进入frozen集合,后续永不重扫或回填。
7.3 L2 三带分块、L3 Era 折叠与差分分词率校准
当活跃轮次继续增长,HistoryChunkManager 会在里程碑完成、步数达到 3~12 步或触及上下文软/硬水位(70% / 90%)时,将旧轮次压缩进 F 区的 L2 SegmentChunk。每个 Chunk 严格保留三个频带(Three Bands):
- Band ①(概要与效果) + Band ②(区间摘要):由单次
StepCapsuleLens生成,且必须通过validate_interval_coverage()的机器校验——区间并集必须严丝合缝覆盖[start_step, end_step],不准漏步或重叠; - Band ③(1:1 机械动作账本):由确定性代码
build_action_ledger()逐行生成(如- Step 4 (T+00:18): tap "Settings" -> dispatched),且用户中途注入的指令行在任何压缩层级下永不驱逐(Never Evict)。如果 Chunk 数量超过 8 个或触及 90% 硬上限,旧 Chunk 会进一步单向折叠为 L3 Era(周期段落 + 极简步号索引),需要细节时再由模型按需调用search_history或replay_steps。
这里还有一个针对多语言场景的精妙设计——差分分词率校准(TranscriptLedger.record_prompt_tokens())。固定按 len(text) // 4 估算 Token 在英文下尚可,但在中文界面下(约 1 字符/Token)会低估近 4 倍,而且每次请求还包含工具 Schema 和大图切片(约 1100~1800 Token)等固定常数项。因此,TranscriptLedger 记录相邻两次图片数量相同且文本增长超过 2000 字符的实测请求,用差分比值 将固定常数项精确相消,动态校准当前会话的 chars_per_token(限制在 [1.0, 6.0] 之间)。
8. 快且准的设计七:零模型死循环检测与“动作分发 目标达成”的独立终审
最后看图 6 右列:如何防止 Agent 在同一个死胡同里反复横跳,以及如何防止 Agent 自己宣布“任务圆满完成”其实页面根本没提交成功?
8.1 零模型开销的双层屏幕状态感知(近距像素比对 + 远距 64-bit dHash)
在组装每轮观察尾部时,operator/prompts.py 串联了两个互不干扰、完全不调大模型的本地图像检测器:
- 近距 3 步像素级防卡死(
ScreenshotSimilarityPromptComponent):将当前截图在内存中做一次与历史落盘格式对称的 JPEG(quality=75)重编码以消除压缩噪点差异,然后与最近 3 步的动作后截图逐像素比对(单通道容差8)。一旦差异像素超过3个立刻break提前退出(耗时仅数毫秒);若发现画面完全未变,立即在尾部注入一行Note: the screen is unchanged since step X (pixel-identical).,提醒模型刚才的点击可能没生效。 - 远距 500 步感知哈希重访提示(
HistoricalStateHintPromptComponent+image_hash.py):每一步落盘时,系统都会用img.draft("L", (64, 64))快速解码并缩放到9 × 8灰度网格,计算出 64 位差分感知哈希(dHash,16 位十六进制字符串) 存入extra_metadata["post_image_dhash"]。每轮开始时,只要近 3 步没有触发相同画面,它就用整数异或汉明距离(bin(a ^ b).count("1"))以 扫描过去最多 500 步(包括早已折叠进 L2/L3 的历史步骤)。根据在 460 个真机步骤上标定的阈值(同屏汉明距离 ,不同屏 ,配置默认阈值5),一旦命中历史页面,立刻注入:Historical state hint: current screen closely resembles the post-action screen from Step 12. Use search_history / replay_steps only if its details are needed.
近距靠像素比对抓“原地卡死”,远距靠 64 位 dHash 抓“绕圈回到老页面”,全流程 0 Token、毫秒级完成。
8.2 活体计划账本守卫、乐观异步中途检查与退出终审(Checker)
在 Pro 模式下,ARTEMIS 严格区分了三个层面的事实:
- Validator 返回
Dispatched:只代表 ADB/设备接受了这条点击指令,代码注释明确写道:No effect polling: "dispatched" only says the device accepted the command; - Operator 把计划子目标改成
[x]:只代表执行者自己认为这一步做完了; - Checker 出具
passed裁决:才代表目标经过只读验证器的独立核实。
这套约束通过三步落地(见 prompts.py、checkpoints.py 与 checker.py):
- 活体计划账本本地打回(
render_plan_ledger_bounce()):如果 Operator 下发动作时,task_plan里没有任何里程碑处于进行中[/],或者同一个叶节点子目标连续多轮动作都没更新状态(stale_turns),框架会在本地直接打回该动作,强制它先用update_note维护好计划账本再执行。 - 乐观异步中途检查(Optimistic Async Midway Checkpoints):当开启
midway_checks且某个带有verify:或assert:的子目标被标为[x]时,execution_check_node会抓取完成那一刻的证据锚点EvidenceAnchor(anchor_step_id, trigger_ts, plan_text),在后台启动最多 3 个并发的asyncio.Task运行Checker.run_checkpoint_check(),完全不阻塞 Operator 继续往下走下一步。如果后台 Checker 判定verify失败,下一轮到达execution_check_node收获结果时,会自动把该子目标从[x]翻转回[/],并把[verify failed]原因注入operator_feedback。 - 退出收口与只读终审(
exit_settlement+run_final_check()):当所有顶层子目标都标为完成时,convergence_gate()不会直接结束图循环,而是路由到exit_settlement节点:先等待所有在途的后台检查点结算完毕,随后默认触发run_final_check()——重新抓取手机的最终实时屏幕,连同原始用户目标、最终计划和历史裁决账本(check_ledger.jsonl)一起交给只读 Checker 做终审。如果终审发现遗漏,直接把未达成的子目标重新打开并弹回给 Operator 继续补救。
9. 核心机制总结:ARTEMIS 是如何打破“快”与“准”矛盾的?
把上面拆解的源码机制汇总到一张表里,可以清楚看到每一项设计省掉了什么开销、防住了什么错误,以及它的工程边界在哪里:
| 创新模块与源码位置 | 为什么“快”(省掉了什么) | 为什么“准”(防住了什么) | 适用边界与工程代价 |
|---|---|---|---|
端侧无障碍原子快照accessibility_client.py | 绕开 uiautomator dump 空闲等待,单次 /snapshot 毫秒级返回;30s 冷却回退防连环超时 | Android 11+ 同帧原子抓取 XML 与截图,消除图树时间差;不占 UiAutomation 单例 | 首次上机需安装 Helper APK(约 3s,可通过 artemis helper install 预装) |
五步 UI 树几何净化ui_filter.py / ocr_xml_fusion.py | 0 模型开销裁掉越界碎片、合并冗余父子与装饰节点,大幅缩短元素列表长度 | 切除底部导航栏上方 露头细条防误触;双频段融合 OCR;非同心重叠 自动注入遮挡警告 | 纯几何规则无法判断半透明蒙层背后的视觉语义,需配合截图观察 |
三级渐进式目标定位explorer.py / screen_index.py | ScreenIndex 唯一精确匹配直接走 0 Token 快路径(覆盖 85%+ 常规动作) | 模糊/自绘目标交由具身空间模型 gemini-robotics-er-2-preview + 2% 容差框吸附校验 | flash 档视觉打点强依赖具备空间微调能力的 ER 模型 |
Safety Net + 200px 坐标自愈precondition_xml.py / precondition_pixel.py | 目标微幅漂移()时直接原地修正坐标下发,省去打回重跑一轮大模型 | 动作落指前核对实时 XML 四信号与局部裁剪像素,拦截弹窗遮挡与页面跳变;像素置信度 放行防死锁 | 每个单动作增加一次实时 XML 读取(及必要时的轻量 VLM 局部比对) |
Fast-Action Burst 连发execution_loop.py | 单轮 2–4 个动作跳过 Safety Net、中间截图与重试,背靠背连发 | 赶在自动消失的播放器控制条、Toast、下拉菜单淡出前完成点击 | 放弃了中间步校验,首错即停(Skipped),仅限瞬态短序列使用 |
状态化 Execution Incidentincidents.py / prompts.py | 砍掉独立的黑盒 Repair Agent,省去跨 Agent 上下文交接与额外推理轮次 | 将失败精确归类为 SHIFTED(附新坐标)/ OCCUPIED(附遮挡物)/ DISAPPEARED,钉在尾部直至恢复并显式结算 | 恢复决策仍由下一轮 Operator 结合实时屏幕完成 |
S+F+A+T 四区账本与双边缘擦除transcript.py / context_compressor.py | 剥离动态计划、固定 T+mm:ss 时间戳保住 Prefix KV Cache;后台异步视觉摘要 + L2/L3 折叠削减 >70% Token | xml_scrub_depth=1 确保全上下文仅最新帧含 [1]..[N] 索引,根除陈旧索引误点;差分校准中英文分词比 | 极早期细节需通过 search_history / replay_steps 按需二次召回 |
零模型双层循环检测 + 异步 Checkerimage_hash.py / checkpoints.py | 近 3 步像素早退比对 + 远 500 步 64-bit dHash 扫描全程 0 Token;中途检查异步并发不阻塞主循环 | 及时点破“画面未变”与“绕回老页面”;退出时 exit_settlement 对照原始目标终审实时屏幕,杜绝假成功 | 开启 final_check(默认)或 checkpoints 会在收尾阶段增加只读复核耗时 |
10. 源码阅读索引
如果你想顺着本文拆解的脉络直接阅读代码,推荐按以下顺序打开文件:
- 调度入口与双轨分流:
artemis/interfaces/cli/commands/run.pyartemis/sdk/agent.py(重点看DeviceExecutionLock与 Flash/Pro 分流)artemis/resources/config/artemis.jsonc(全局默认参数与设计注释)。 - 端侧感知与进程内动作会话:
artemis/clients/accessibility_client.py(/snapshot原子抓取)artemis/clients/screen_client_factory.py(30s 冷却回退)artemis/mcp/action_session.pyartemis/mcp/observation.py。 - 五步 UI 树几何净化:
artemis/utils/ui_filter.py(祖先裁剪、顶底固定栏钳制、父子去重、兄弟合并)artemis/utils/ocr_xml_fusion.py(双频段融合与行聚类)artemis/utils/visualization.py(非同心互遮挡告警与Hint/Error格式化)。 - 三级渐进式定位:
artemis/agents/explorer/screen_index.pyartemis/agents/explorer/explorer.py(_structural_prepass与_enrich_candidates)artemis/agents/explorer/tiers.py。 - 动作前 Safety Net、坐标自愈与事故恢复:
artemis/agents/validator/execution_loop.pyartemis/agents/validator/precondition_xml.py(四信号打分、200px 坐标自愈、三类失败归因)artemis/agents/validator/precondition_pixel.pyartemis/agents/validator/incidents.py。 - 四区账本、双边缘压缩与死循环检测:
artemis/memory/transcript.py(S+F+A+T与差分分词校准)artemis/agents/flash/context_compressor.py(ScrubEdgeCompressor)artemis/memory/chunking.py(L2 三带与 L3 Era)artemis/utils/image_hash.py&artemis/agents/operator/prompts.py。 - Pro 状态图与独立 Checker:
artemis/graph/graph.pyartemis/graph/checkpoints.pyartemis/agents/checker/checker.py。
- 项目仓库:https://github.com/google/artemis(Apache-2.0 许可证,本文核查提交:
351ca84) - 本文机制图可编辑源文件(
.drawio):总体执行链路、几何净化与三级定位及 Safety Net、四区账本与死循环检测及 Checker。